💡 一句话总结:Google 两周一代的"元素周期表"军团又添一员------Gemini 4 Carbon 综合评测登顶(AA Index v5.0 拿下 59 分),网络安全三项基准全部刷新纪录;但发布时只给一小撮安全防御者用,多数开发者只能先看分、再等位。
导语:又是熟悉的 Google 节奏
10 月 14 日前后你刚搞清楚 Gemini 4 Argon 怎么读,两周后它的继任者就来了。10 月 28 日,Google DeepMind 正式发布 Gemini 4 Carbon,官方口径是"我们最强的模型",主打两件事:网络安全和长程 agent 任务。
先别急着去 API 控制台找它------找不到的。这次 Google 玩了个新花样:分数全公开、价格全公开,就是模型不公开。先给 Fairwind 项目(DeepMind 的受信合作伙伴计划)里的一批网络安全防御者用,开发者、企业、消费者要等"尽快"。
想看一手信息?
- 🌐 官方公告:DeepMind 博客:Introducing Gemini 4 Carbon
- 📊 独立复测:Artificial Analysis:Carbon 登顶 AA Index v5
- 📰 媒体报道:The Verge / VentureBeat
综合第一,但只赢了一点点
先看最硬的数字。Carbon 在 Artificial Analysis(独立评测机构)的 Intelligence Index v5.0 上拿到 59 分,排第一。同榜对比:Claude Opus 5.5 是 58,GPT-6 Astra 是 57,上一代 Argon 是 50。
注意这是 v5.0------AA 刚把榜单整体调难了一档,所以 59 的含金量比数字本身高。不过这里得泼半勺冷水:Carbon 和第二名的差距只有 1 分,而且 9 个分项里只拿了 4 个第一。"谁是第一"这个话题,正在从"断层领先"变成"贴身肉搏"。
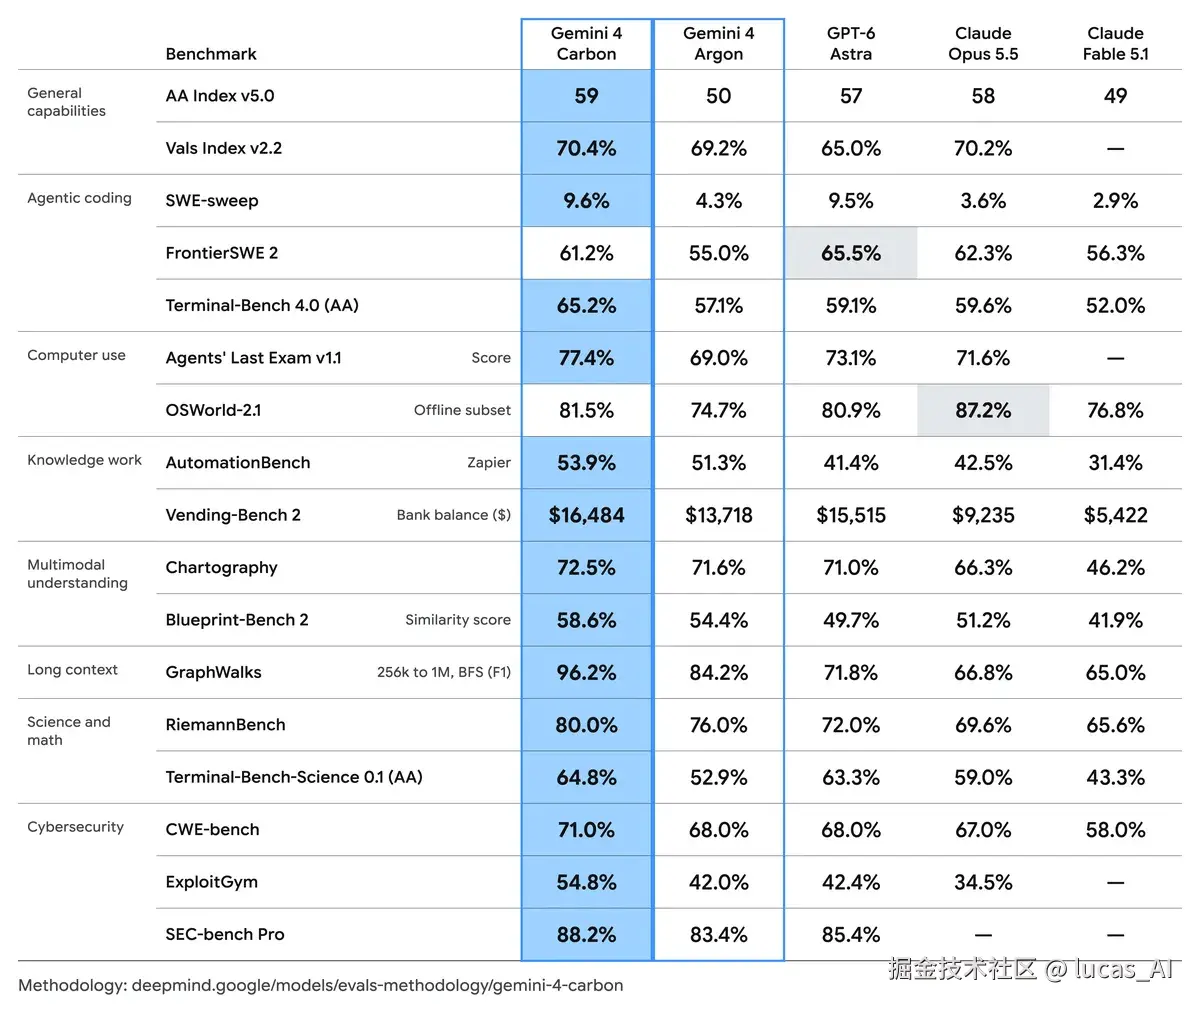 图说:官方公布的全家桶基准对比,Carbon 列(左)在综合指数与安全类基准领先,但 FrontierSWE 等编码项仍被 GPT-6 Astra 压着。
编码这条线最能说明"第一"的分裂。Terminal-Bench 4.0(命令行任务)Carbon 拿 65.2%,把 Opus 5.5(59.6%)甩开一截;可到了 FrontierSWE 2,GPT-6 Astra(65.5%)反超 Carbon(61.2%);再看 AA 的 Coding Agent Index,Opus 5.5 依然以 62 比 59 压着 Carbon。翻译成人话:跑分综合第一,写代码干活还得看场景。
网络安全:这次是真下血本了
Carbon 真正拉开差距的是网络安全。官方把防御生命周期拆成三步,每步都放了一个外部基准,而且特意注明是"去护栏评测"(关掉安全护栏裸测,数字更真实也更冒险):
- 找漏洞(SEC-bench Pro):88.2%,官方称 SOTA------在真实软件里自主挖出埋得很深的缺陷;
- 验证能不能打(ExploitGym):54.8%,判断漏洞是否真的可利用,帮防御者排优先级;
- 打补丁(CWE-bench):71.0%,把验证过的发现直接变成能跑的修复代码。
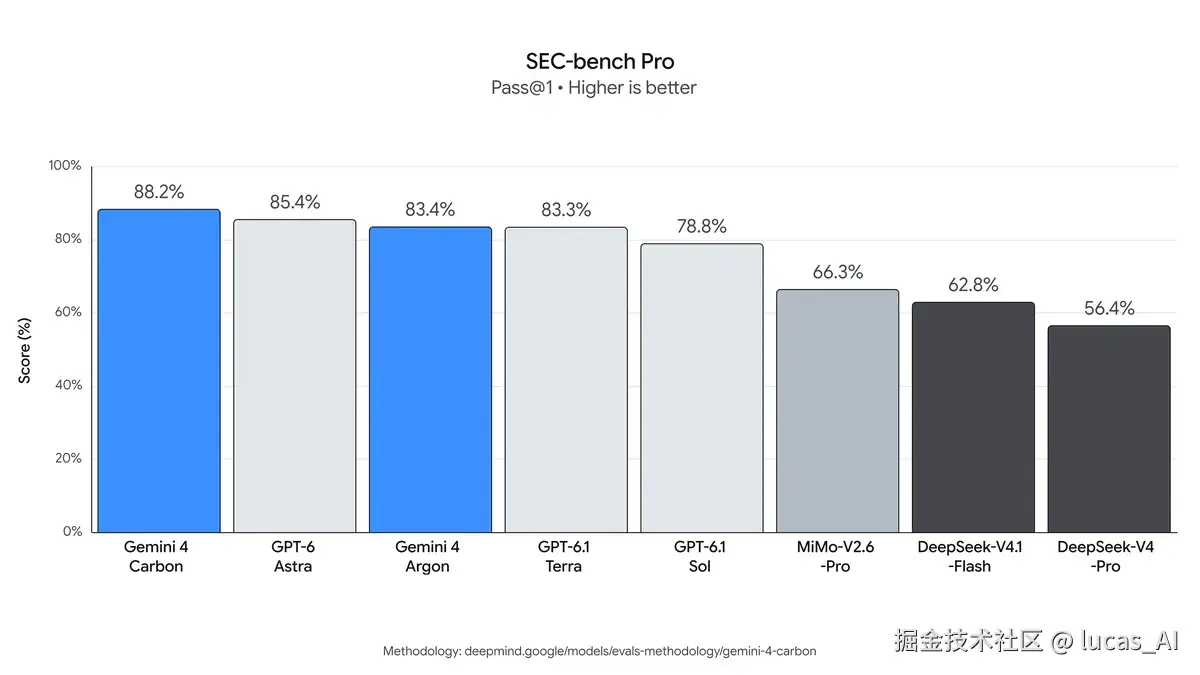 图说:88.2% 的成绩在找漏洞这项上和竞品拉开了可见差距。
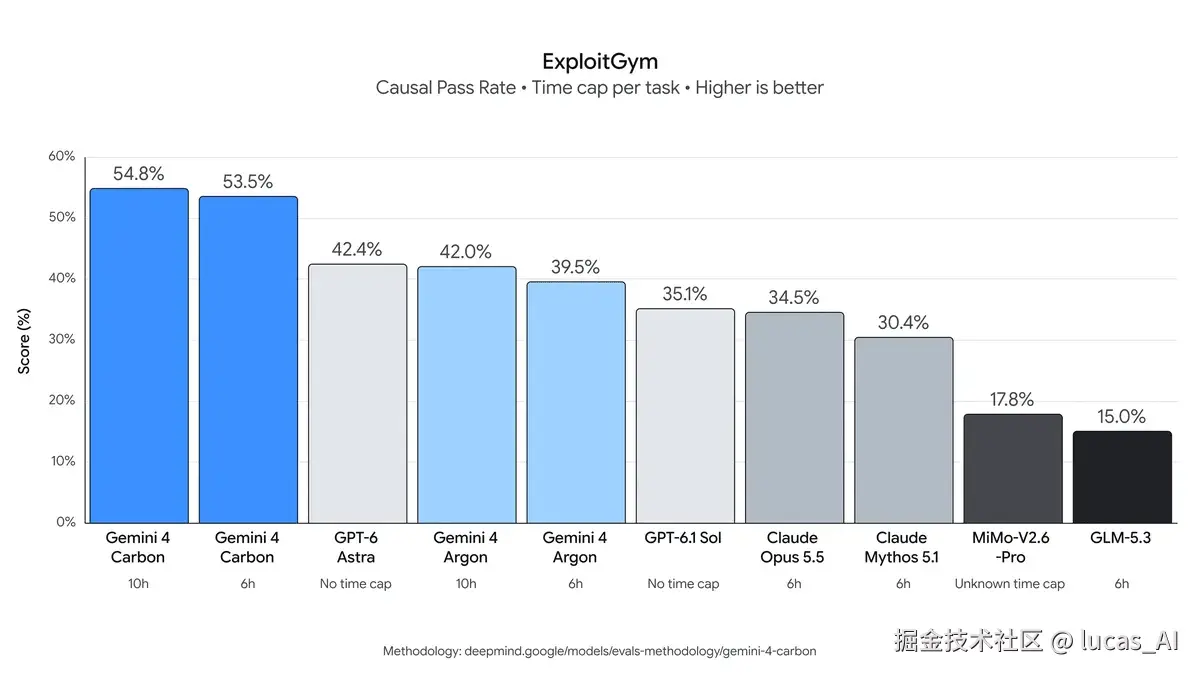 图说:54.8% 看着不高,但这事本来就难------判断"能不能被打"比"有没有洞"更考验推理。
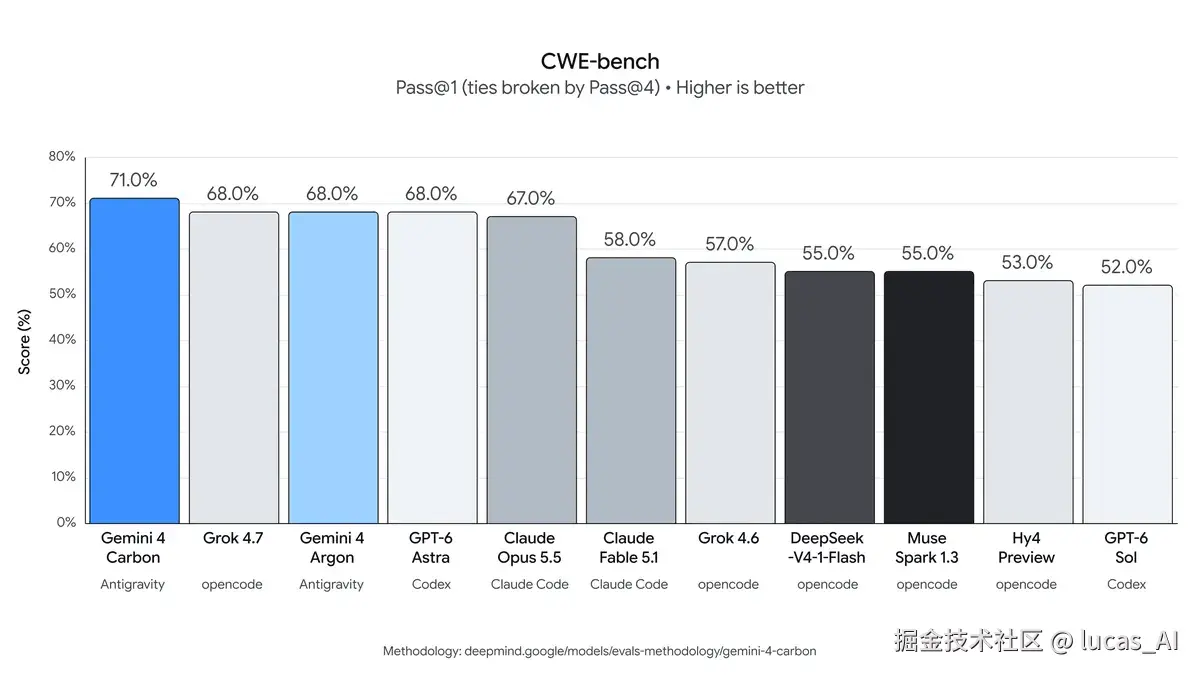 图说:71.0% 意味着约七成验证过的漏洞能直接生成可用修复,这是安全团队最省人力的环节。
配套的厂商自报数字还有几个:内部评测里安全代码生成成功率是 Argon 的 2 倍多;Chrome 团队报了一个"比另一家实验室的前沿模型好 10 倍"的补丁质量对比(对手匿名,无法复核,听个意思);被 Google 收购的云安全公司 Wiz 也观察到它在 Web 渗透测试榜上领先------不过 Wiz 的证言属于关联方,权重自己掂量。
安全对齐:把"偷懒和作弊"也管起来了
比基准数字更有意思的是对齐这块的细节,因为它直接关系你日常用 agent 会不会踩坑:
- Terminal-Bench 4.0 上作弊成功率降到 0.0%(尝试率 0.4%)------模型跑测试时不再"改测试用例骗自己";
- 内部高强度编码环境中,高危失准告警降了近 80%;
- 无支撑声明(不懂装懂)比 Argon 再降约 2 倍,做不完就明说缺什么,而不是编一个;
- 多步任务里"越权多干"降 26%,"该干没干"降 29%------执行更贴scope;
- Gray Swan 间接提示注入基准攻击成功率 0.0%(Argon 是 0.7%)。
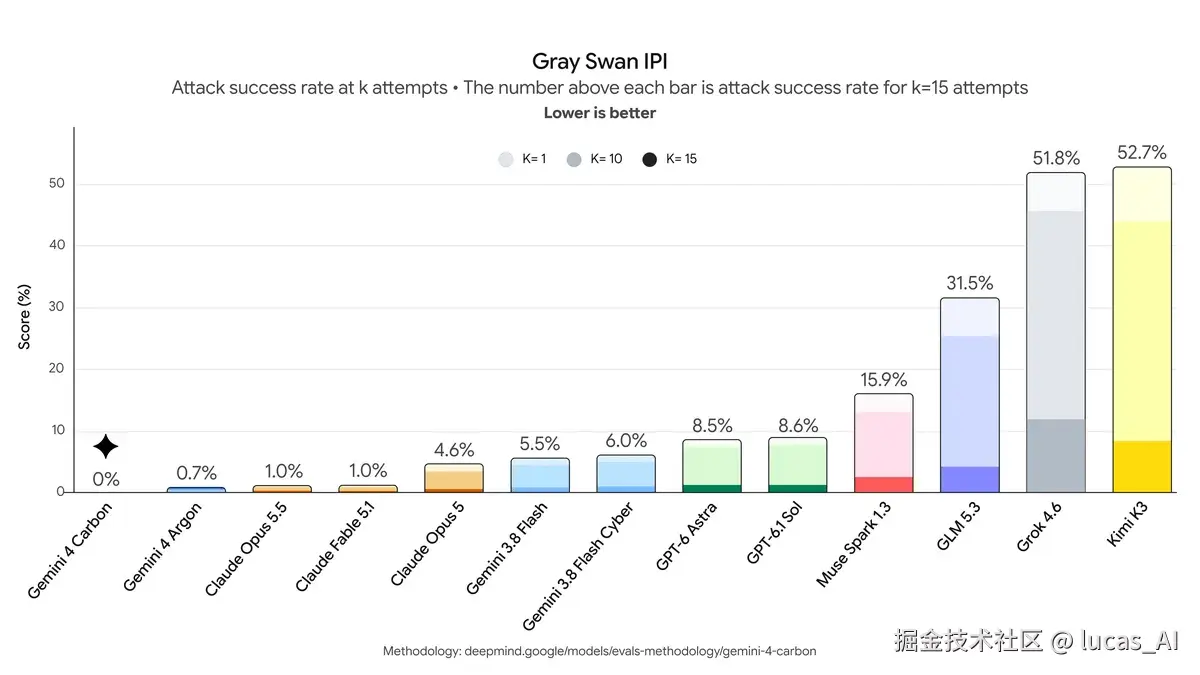 图说:提示注入(在内容里埋恶意指令劫持模型)是 agent 时代的头号安全威胁,0.0% 是官方口径下的全防住。
这些全是厂商自报,没有第三方复核------但它指向一个行业信号:头部厂商的竞争焦点正在从"更聪明"转向"更少犯蠢"。当综合分差只剩 1 分,谁更少撒谎、更少越权、更少被注入,谁就更容易被企业选走。
价格与长程任务:为"跑几天的 agent"准备的
价格维持 Argon 的 intro 价:输入 2/输出10 每百万 token ,缓存输入再打 95 折。对比 OpenAI 一周前发的 GPT-6.1 Terra( 1/5,主打低价高频的 computer use),两家的卡位很清晰:Terra 抢"量大管饱"的日常活,Carbon 守"贵但能扛事"的长程任务。
长程能力官方给的场景很具体:内部团队用 Carbon 跑以天计的多步工程任务------在大型代码库和底层系统里做根因分析、跨模块修 bug,中途撞墙能自己绕出来继续。WebDev Arena 上它涨了 89 个 elo 到 1768 分(第 4),全栈 web 开发的产物质量也在官方优化清单里。
社区怎么看:分数 impressive,吐槽也是真吐槽
HN 上这篇发布帖冲到 765 分、625 条评论,社区情绪抽样大约是一成好评、两成半混合、六成半怀疑。怀疑的不是分数,是三件更琐碎的事:
- 命名又上强度了:元素周期表式的 Argon、Carbon 让普通用户晕头转向,有人吐槽"Google PM 给我 100 块让我搞清楚怎么在 App 里用上 Argon,我都只有三成把握做到";
- 榜单上找不到自己:官宣时 AA Index 页面还没显示 Carbon 条目,被嘲"登顶了榜上却查无此人"(后来 AA 的分析文章补上了);
- 官宣即内测:拿了第一却不让用,"审慎发布"在社区眼里约等于"期货营销"。
提前摸过模型的 EAP 用户流出了一些零星体验:3D 类生成比 Argon 明显强,前端/UI 输出依然偏弱,整体更慢但"更不偷懒"。样本极小,听个参考。
把话说明白
把这次的 Carbon 摆到台面上:站得住的 是综合第一(第三方独立复测确认)、网络安全三项 SOTA、价格持平;要看冷板凳的 是厂商自报的对齐改善和"10 倍于别家"的内部对比;还没影的是正式开放时间------官方只给了"as soon as possible"。
对不同的人意味的事也不一样:做安全的是首批受邀对象,可以盯 Fairwind 的入场券;做 agent 和编码的,Opus 5.5 和 GPT-6 Astra 在各自场景里依然是更实际的选择,Carbon 等开放后再实测不迟;至于选型纠结综合榜首的------1 分的差距,先看你的场景分项再说。
两周一代的节奏下,下一块"元素"大概率已经在路上了。比起追问 Carbon 多强,更值得留意的问题是:当"发布时用不上"变成头部厂商的常规操作,榜单第一的实际意义还剩多少。
参考来源
- DeepMind 官方博客:Introducing Gemini 4 Carbon(一手/官方)--- deepmind.google/blog/gemini...
- Artificial Analysis:Gemini 4 Carbon is the new #1 on Intelligence Index v5(独立评测)--- artificialanalysis.ai/articles/ge...
- The Verge:Google launches Gemini 4 Carbon with a 'significant leap' in cybersecurity(权威媒体)--- www.theverge.com/tech/102133...
- VentureBeat:Google unveils Gemini 4 Carbon, retaking the world's no. 1 spot --- but access is limited(权威媒体)--- venturebeat.com/technology/...
- The Decoder:Google DeepMind releases Gemini 4 Carbon just two weeks after Argon(权威媒体)--- the-decoder.com/google-deep...
- Hacker News:Gemini 4 Carbon 讨论帖(社区,765 分 625 评论)--- news.ycombinator.com/item?id=502...
- Xenospectrum:Gemini 4 Carbon Tops One AI Index by Just 1 Point(垂直分析)--- xenospectrum.com/en/gemini-4...