一张盲文照片,对不熟悉盲文的人来说,往往是一组组不容易分辨的小凸点。
想把这些点阵整理进电脑,需要先找到每个盲文单元,辨认哪些位置有点,再处理行序、空格和可能的错误。照片上的光线、阴影、纸张弯曲,又会给这个过程增加难度。
这次,我用 C# 做了一个 Windows 桌面小工具:盲文照片识别与校对工坊。
它的流程是:
导入照片 → 识别点阵 → 逐格校对 → 保存工程或导出结果。
软件会先给出候选结果。你可以对照局部照片改点,给漏掉的位置补框,再逐格确认,留下可继续编辑的校对工程。
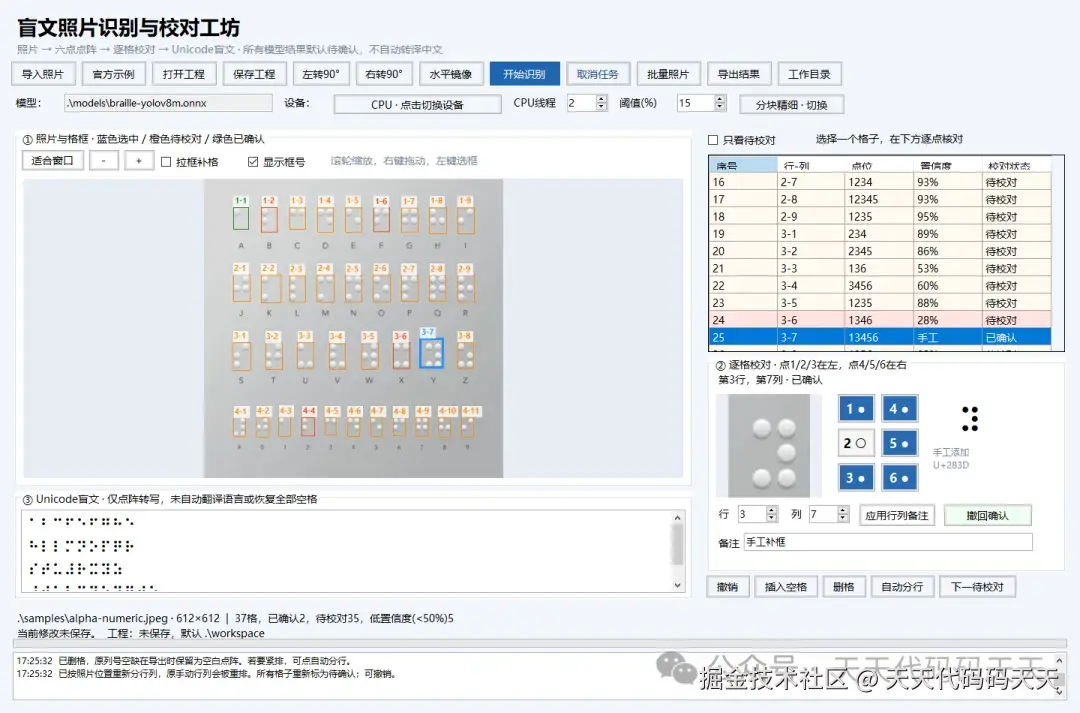
盲文照片识别与校对工坊界面,右侧正在校对一个手工补入的格子
截图为实际软件界面。其中37格由模型检出的36格,加上人工补入的1格组成;当时只确认了2格,其余仍待校对。
先说清楚:这一版识别的是盲文点阵
软件目前面向六点盲文照片,把识别和校对后的图形输出为 Unicode 盲文字符。
盲文的语言规则还涉及上下文、标志、缩写等内容。识别出一组点,并不等于已经理解了它在某种语言中的含义。
因此,当前版本没有把结果自动翻译成中文。它先把照片点阵整理成可以查看、修改、保存的数据,为后续处理提供基础。
所有模型结果默认都是"待校对",高置信度也不会自动替你确认。
可以先用内置示例试一遍
打开软件,点击"官方示例",就能载入下面这张照片。
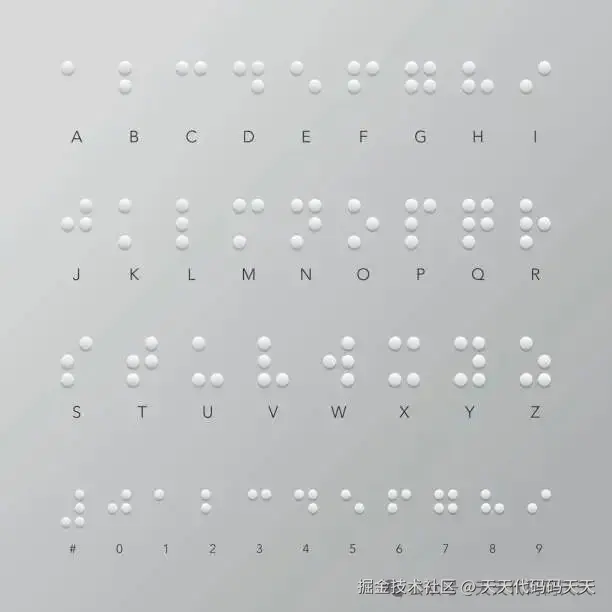
DotNeuralNet提供的字母与数字盲文示例照片
图片来自 DotNeuralNet 的公开示例,印刷字母便于目视对照。软件当前没有自动把点阵转成图中的英文字母。
点击"开始识别"后,左侧照片上会出现格框,右侧列表显示行列、点位、置信度和校对状态。
在这张示例上,当前模型检出了36格,但仍有错点和漏格。这个结果也让"校对"有了很具体的用途:发现漏掉的格子后,可以直接补进去;发现点阵不对,可以逐点修改。
识别结果与照片放在一起,比只给出一段难以回查的文字更方便核对。
选中一个格子,就能逐点修改
点击照片上的框,或者右侧列表中的一行,下方会显示该位置的局部放大图。
六点编号按下面的方式排列:
1 4
2 5
3 6
左边是1、2、3,右边是4、5、6。
点亮的按钮表示有点,空心表示无点。对照照片点击按钮,就能调整这一格的点阵,Unicode字符也会同步更新。
模型最初识别的点位和置信度会保留,人工修改后的值另行记录。看清楚并修改完成后,再点"确认本格"。
照片上的框也用颜色区分状态:橙色待校对,绿色已确认,蓝色表示当前选中。低置信度的格子还会单独标色,方便优先查看。
这里的置信度是模型分数,不能直接理解成"正确率"。高分也可能认错,仍然要结合原图判断。
漏格、误框、空格,都留了人工入口
模型漏掉某个单元时,可以勾选"拉框补格",在照片上把完整单元框出来,再设置六个点。
前面界面图中选中的那一格,就是演示时手工补入的。它被标记为"手工",方便和自动检测结果区分。
遇到误框,可以删格;操作有误,可以撤销。当前支持20步格子编辑撤销。
行列也能调整。照片倾斜、点阵大小不一致时,自动分行可能需要修正。软件允许编辑行号、列号和备注;同一位置出现重复行列时,会提示冲突并拦截导出,避免某一格被悄悄覆盖。
空白格通常没有明显凸点,不能指望模型把所有空格都找出来。因此,也提供了"插入空格"。列号之间保留的空缺,会在输出中表示为盲文空白字符。
需要重新按照片位置排列时,可以点"自动分行"。重排会撤回原来的确认状态,让新的阅读顺序再经过一遍核对。
图片可以放大,结果可以慢慢核对
照片支持滚轮缩放、右键拖动和"适合窗口"恢复。框号挡住细节时,可以临时关掉,直接看原图。
右侧可以切换为"只看待校对",也可以用"下一待校对"继续查找。
逐格操作较多时,还有两个快捷键:
- Ctrl+Enter:确认当前格,并跳到下一待校对格。
- Ctrl+Z:撤销格子编辑。
没核对完,可以先保存工程,下次继续。
工程自带图片,换台电脑也能接着做
保存出来的文件扩展名是 .braille。
里面包含工作图片、格框位置、模型原始点位、当前校对值、备注和确认状态。把工程移动到另一台电脑后,不需要再去寻找原照片路径。
导出时,软件会生成几种文件:
- Unicode盲文TXT:按行列输出点阵字符,便于复制到其他工具继续处理。
- 逐格校对CSV:查看点位、原始值、置信度、行列、备注等信息。
- 标注PNG:保存照片上的格框位置,便于交流和回查。
- 校对说明:记录总格数、已确认数和待校对数。
待校对结果也能导出,说明文件会明确标出数量,方便区分草稿与已逐格确认的内容。
一张张处理,也支持文件夹批量
软件提供CPU和DirectML GPU两种推理方式。
CPU默认使用2个线程,可以自行调整;有兼容显卡时,可以切换GPU。识别在后台执行,任务可以取消。
处理方式也有两种:整图快速模式适合点阵较大的图片;分块精细模式会把大图切成有重叠的区域,分别检测后再合并去重,尽量保留小点阵的细节。
文件较多时,可以选择文件夹批量处理。本层支持1~500张照片,任务中复用同一个模型会话,逐张生成结果。
批量输出全部是待校对草稿。 后续打开对应工程,仍然可以继续改点、补格和确认。
技术上,它是怎样工作的?
识别核心采用 DotNeuralNet(github.com/snoop2head/... 提供的YOLOv8m权重,在开发阶段导出为ONNX,由C#通过ONNX Runtime执行。
模型检测每个盲文单元,并给出六点图形类别。六个位置各有"有点"和"无点"两种状态,一共对应64种组合。
程序再把点位组合转换成Unicode盲文字符,完成候选框去重、分行、排序,交给校对界面。
这次有一个值得记录的细节:模型类别中的六位编码,按点1到点6排列。
例如 100000 表示只有点1,应生成 ⠁。如果直接把这串字符当普通二进制整数使用,点位就会对应错误。
所以,模型能运行只是第一步,类别与点序的映射、坐标缩放、分行和导出,也都需要核对。
目前已完成CPU、DirectML与参考输出的数值对照,以及64种点阵映射、工程保存、批量和界面校对流程检查。这些检查用于验证实现的一致性,不代表已经完成各种真实纸张上的准确率评估。
对C#开发者,也提供完整源码
项目使用 WinForms + .NET Framework 4.8 ,提供完整的 VS2022解决方案。
窗体保留 .Designer.cs 和 .resx,方便在设计器中调整布局。普通编译使用包内的模型和依赖,不要求先搭建Python环境,也不依赖相邻的旧项目。
当前部署压缩包约 98.53 MiB ,完整源码压缩包约 145.89 MiB 。运行需要Windows 10/11 x64和.NET Framework 4.8;完整解压后,双击 Braille.Workshop.exe 即可。
原模型、导出记录、依赖和许可证随包保留。本演示工程按AGPL-3.0提供对应源码,具体组件分别遵循包内声明,源码学习和再分发时请一并查看。
先把识别、修正和记录连起来
我希望这个工具能用于盲文照片的点阵整理、辅助校对和算法学习。它把原图、候选结果和人工修改放在同一个流程里,方便逐格检查,也方便保存过程。
当前版本面向六点横排照片。中文盲文语法转译、八点盲文、语音朗读、曲面展开和双面凸凹点分离,暂时还没有加入。
使用自己的照片时,建议先选清楚、平整的一小块区域试试,再决定怎样调整拍摄和校对流程。
想交流软件使用、源码学习和后续改进,欢迎加入:
QQ群:天天代码码天天
群号:264292622
也欢迎分享你在盲文素材整理中遇到的具体问题,帮助我们找到下一步值得打磨的地方。