全文约 3500 字,脚本 400 行,可直接拿走用。适合手上有 10 台以上 Linux 的兄弟。
一、凌晨三点,我在 18 个 SSH 窗口里迷路了
先说个真事。
去年冬天一次线上告警,磁盘写满导致服务雪崩。我爬起来连上 VPN,开了十几个终端 tab,一台一台 df -h 看过去。看到第 11 台的时候,我已经分不清哪台看过、哪台没看------因为每台机器的输出长得一模一样。
更尴尬的是事后复盘时,leader 问我:"这台机器上周磁盘是多少?"
我答不上来。
那次之后我想明白一件事:巡检不是"看一眼",巡检是一份可对比、可回溯的数据。 靠人肉 SSH 得到的只是"感觉",不是"数据"。
于是我开始把这些检查固化成一个脚本。迭代到今天,它变成了一份 400 行、9 个检查大类、输出机器可读的巡检工具。这篇文章把它完整拆开讲给你,包括我踩过的坑和几个容易写错的地方。
提前交代一句工具背景:我现在整套流程跑在**极目Linux桌面(GMSSH)**里------一个把 SSH 会话、命令库、批量执行塞进同一个窗口的桌面客户端。脚本负责"查什么",它负责"在哪跑"和"跑完怎么看",两边是配合关系。具体操作路径在第五节,脚本原文在文末附录,只想要代码的可以直接翻到底。
二、先想清楚:巡检到底该查什么
写脚本之前,我先列了张表。这张表比代码重要得多------没有判读标准的巡检,只是一堆输出的堆砌。
| 检查项 | 具体指标 | 判读标准 | 为什么查它 |
|---|---|---|---|
| 基本信息 | 发行版、内核、运行时长 | 连续运行 >180 天提示重启 | 内核漏洞修补必须重启才生效 |
| CPU 负载 | load1 / 核数 | >1.5 倍告警,>3 倍严重 | 单看 load 绝对值没意义,10 核 8.0 很正常 |
| CPU 分布 | iowait、steal | iowait >20% 告警 | 一个是磁盘瓶颈,一个是宿主机超卖 |
| 内存 | MemAvailable / MemTotal | 可用 <10% 告警,<5% 严重 | free 的 free 字段会把缓存算成"已用",误判率极高 |
| Swap | 使用率 | >50% 告警 | 长期吃 swap 说明内存规划不足 |
| 磁盘 | 各挂载点使用率 | >85% 告警,>92% 严重 | 最经典的故障源 |
| inode | IUse% | >85% 告警 | 磁盘还有空间但创建不了文件,排查时最容易懵 |
| 连接 | ESTABLISHED、TIME_WAIT | EST >20000 告警 | 高并发下 fd 和端口耗尽 |
| 内核事件 | OOM、failed unit、僵尸进程 | 出现即严重 | OOM kill 是"静默杀手",进程死了日志里啥也没有 |
| 安全 | SSH 失败次数、登录会话 | 单日 >50 次告警 | 暴力破解几乎每天都在发生 |
这张表定完,脚本的骨架就有了。
三、三个设计原则(决定了它能不能用在生产上)
- 全程非交互 。不能有
read、不能等yes/no、不能跑top这种全屏程序。因为我要把它丢进"批量执行"里,对几十台机器同时下发------任何一处卡住等待输入,整个批量任务就会挂到超时。 - 输出必须分级 。每一条检查要么
OK、要么WARN、要么FAIL,最后汇总成结论。不然几十台机器、每台几十行输出,人眼看不出重点。 - 末行必须是单行摘要。这点后面单独讲,它是批量巡检的"灵魂"。
四、核心实现拆解
4.1 负载:一定要除以核数
这是新手最常写错的地方。uptime 显示 load 8.0,在 2 核机器上是灾难,在 16 核机器上很清闲。
bash
CORES=$(nproc 2>/dev/null || getconf _NPROCESSORS_ONLN 2>/dev/null || echo 1)
read -r L1 L5 L15 _ < /proc/loadavg

# 告警线 = 核数 × 1.5,严重线 = 核数 × 3
LOAD_WARN=$(awk -v c="$CORES" -v f="$LOAD_WARN_FACTOR" 'BEGIN{printf "%.2f", c*f}')
LOAD_CRIT=$(awk -v c="$CORES" 'BEGIN{printf "%.2f", c*3}')

if ge "$L1" "$LOAD_CRIT"; then
  crit "1 分钟负载 ${L1} 超过核数 3 倍(${LOAD_CRIT}),疑似资源打满"
elif ge "$L1" "$LOAD_WARN"; then
  warn "1 分钟负载 ${L1} 超过告警线 ${LOAD_WARN}(核数 × ${LOAD_WARN_FACTOR})"
else
  pass "负载正常(1m ${L1} < ${LOAD_WARN})"
fi
其中 ge 是浮点比较的封装------bash 的 [ 只支持整数比较,load 有小数,必须借 awk:
bash
ge() { awk -v a="$1" -v b="$2" 'BEGIN{exit !(a+0 >= b+0)}'; }这个小函数整个脚本用了十几次,比引入 bc 更省依赖。
4.2 内存:看 MemAvailable,别看 free 字段
free -m 里那个 free 会把 page cache 排除在外,跑满 IO 的机器上它常年是个位数,但内存其实很充裕。真正该看的是 MemAvailable------内核估算的"应用还能要到多少"。
bash
MEM_TOTAL_KB=$(awk '/^MemTotal:/{print $2}' /proc/meminfo)
MEM_AVAIL_KB=$(awk '/^MemAvailable:/{print $2}' /proc/meminfo)
# 老内核(<3.14)没有 MemAvailable,退化到 MemFree
[ -z "${MEM_AVAIL_KB:-}" ] && MEM_AVAIL_KB=$(awk '/^MemFree:/{print $2}' /proc/meminfo)

AVAIL_PCT=$(awk -v a="$MEM_AVAIL_KB" -v t="$MEM_TOTAL_KB" 'BEGIN{printf "%.1f", a*100/t}')这段代码有个细节:CentOS 7 早期内核没有 MemAvailable 。线上跑的时候如果没做兜底,AVAIL_PCT 会变成空值,后面的比较全部静默失效------你会得到一个永远"内存正常"的巡检,这比报错危险得多。
4.3 磁盘:inode 和只读挂载是两个坑
磁盘检查的第一版,我犯了个蠢错:把 tmpfs 也算进去了。结果每台机器都报 /dev/shm 使用率超高------那是内存盘,压根不该按磁盘判读。
第二版又发现:光查容量不够 。有个服务日志疯狂写小文件,磁盘还剩 40%,inode 已经用到 99%,写入直接失败。这种问题只看 df -h 永远发现不了。
第三版是被误报逼出来的:一堆只读挂载(容器镜像层、挂载的 ISO)使用率天生 100%,每次巡检都刷一屏红色,很快就没人看报告了。
最终版本:
bash
# 1) 过滤虚拟文件系统
DF_OUT=$(df -PT | awk 'NR>1 && $2 !~ /^(tmpfs|devtmpfs|overlay|squashfs|iso9660|autofs|proc|sysfs|cgroup|cgroup2|nsfs|ramfs|fuse\..*|none)$/ {print $7"|"$6"|"$1}')

# 2) 找出只读挂载点,跳过使用率判定
RO_MOUNTS=$(awk '$4 ~ /(^|,)ro($|,)/{print $2}' /proc/mounts)

while IFS='|' read -r mnt cap dev; do
  [ -z "$mnt" ] && continue
  pct=${cap%\%}
  # 3) 只读挂载不参与判定:ro 盘 100% 满属正常行为
  if printf '%s\n' "$RO_MOUNTS" | grep -Fxq "$mnt"; then
    info "挂载点 ${mnt} 为只读挂载,跳过使用率判定"
    continue
  fi
  if   ge "$pct" "$DISK_FAIL"; then crit "${mnt} 使用率 ${pct}%,已超 ${DISK_FAIL}%"
  elif ge "$pct" "$DISK_WARN"; then warn "${mnt} 使用率 ${pct}%,超过 ${DISK_WARN}%"
  else                              pass "${mnt} 使用率 ${pct}%"
  fi
done <<< "$DF_OUT"
巡检脚本的可用性 = 信噪比。 误报刷屏到了一定程度,这个脚本就死了------没人会看一个每次都报 50 条红的报告。这是我花了最多时间打磨的地方。
4.4 静默杀手:OOM、failed unit、僵尸进程
这一类检查的价值在于:它们出问题时,服务通常是直接消失,应用日志里一句错误都不会留。
bash
# OOM:进程被内核干掉,日志里往往只有一行 kernel 记录
OOM_N=$(journalctl -k --since "-24 hours" --no-pager | grep -ci 'out of memory\|oom-kill')

# failed 单元:很多时候是"上次重启就没起来",一直没人发现
FAILED_UNITS=$(systemctl list-units --state=failed --no-legend --plain | awk '{print $1}')

# 僵尸进程:父进程没回收子进程,进程表会慢慢被撑爆
ZOMBIE_N=$(ps -eo stat= | grep -c '^[[:space:]]*Z')僵尸进程那行有个小坑:ps -eo stat= 的输出可能带前导空格,直接 grep '^Z' 会漏。要写成 '^[[:space:]]*Z'。我第一版就是这么漏了一堆。
4.5 iowait 和 steal:判断"慢"到底慢在哪
负载高有两种完全不同的原因,处理方式也完全不同:
- iowait 高 → 磁盘是瓶颈,去看 IO、看慢查询、看日志刷盘
- steal 高 → 你的 CPU 被别的虚拟机抢走了,这是云厂商的事,你优化代码没用
bash
VM_LINE=$(vmstat 1 2 | tail -1)
WAIT_PCT=$(echo "$VM_LINE" | awk '{print $16}')
STEAL_PCT=$(echo "$VM_LINE" | awk '{print $17}')
vmstat 1 2 取第二行,是因为第一行是开机以来的平均值,没有参考意义。这个细节很多人不知道。
4.6 灵魂:末行那条 SUMMARY
前面说的第三条设计原则,具体就是这行输出:
bash
printf 'SUMMARY host=%s verdict=%s ok=%d warn=%d fail=%d duration=%ds\n' \
  "$HOSTNAME_S" "$VERDICT" "$OK_C" "$WARN_C" "$FAIL_C" "$DUR"
跑出来长这样:
ini
SUMMARY host=web-03 verdict=WARN ok=18 warn=1 fail=0 duration=3s中间的正文长这样(节选):
css
▶ 4. 磁盘与 inode
  [ OK ] 挂载点 / 使用率 42%
  [WARN] 挂载点 /data(/dev/vdb1)使用率 88%,超过告警线 85%
  [ OK ] 挂载点 /var/lib/docker 使用率 61%
  [ OK ] 挂载点 /boot 使用率 23%
一眼就能看出是 /data 快满了,而不是再去翻 300 行输出。
为什么这行最重要?因为批量执行的输出是纵向堆叠的------几十台机器的报告全刷在一个结果列表里,你要找出"哪台有问题",靠肉眼翻 2000 行输出是不可能的。
而有这一行之后,你只需要在结果里搜 verdict=FAIL,问题机器立刻就浮出来了。脚本还配套了退出码(0 通过 / 1 告警 / 2 严重),将来接自动化平台时可以直接拿退出码做判断。
五、落地:在极目Linux桌面里把脚本跑起来
先交代工具,不然下面说"点哪里"你会找不到。我日常用的客户端是极目Linux桌面(GMSSH),左侧四个导航入口,各管一摊:
| 入口 | 干什么用 |
|---|---|
| 我的桌面 | 管机器和分组,双击直接开 SSH 会话 |
| 快捷命令 | 命令库,沉淀一次到处能用 |
| 批量执行 | 一条命令或脚本下发到多台机器,有执行记录 ← 本文用的就是这个 |
| AI 偏好 | 模型相关设置,跟本文无关 |
它走的是标准 SSH,不需要在服务器上装任何 agent------这点对我很重要,有些老机器连 root 都不给你装东西。
下面是完整操作路径,四步。
第 1 步:把巡检固化成一条任务
点左侧「批量执行」,进来就是这个任务列表。
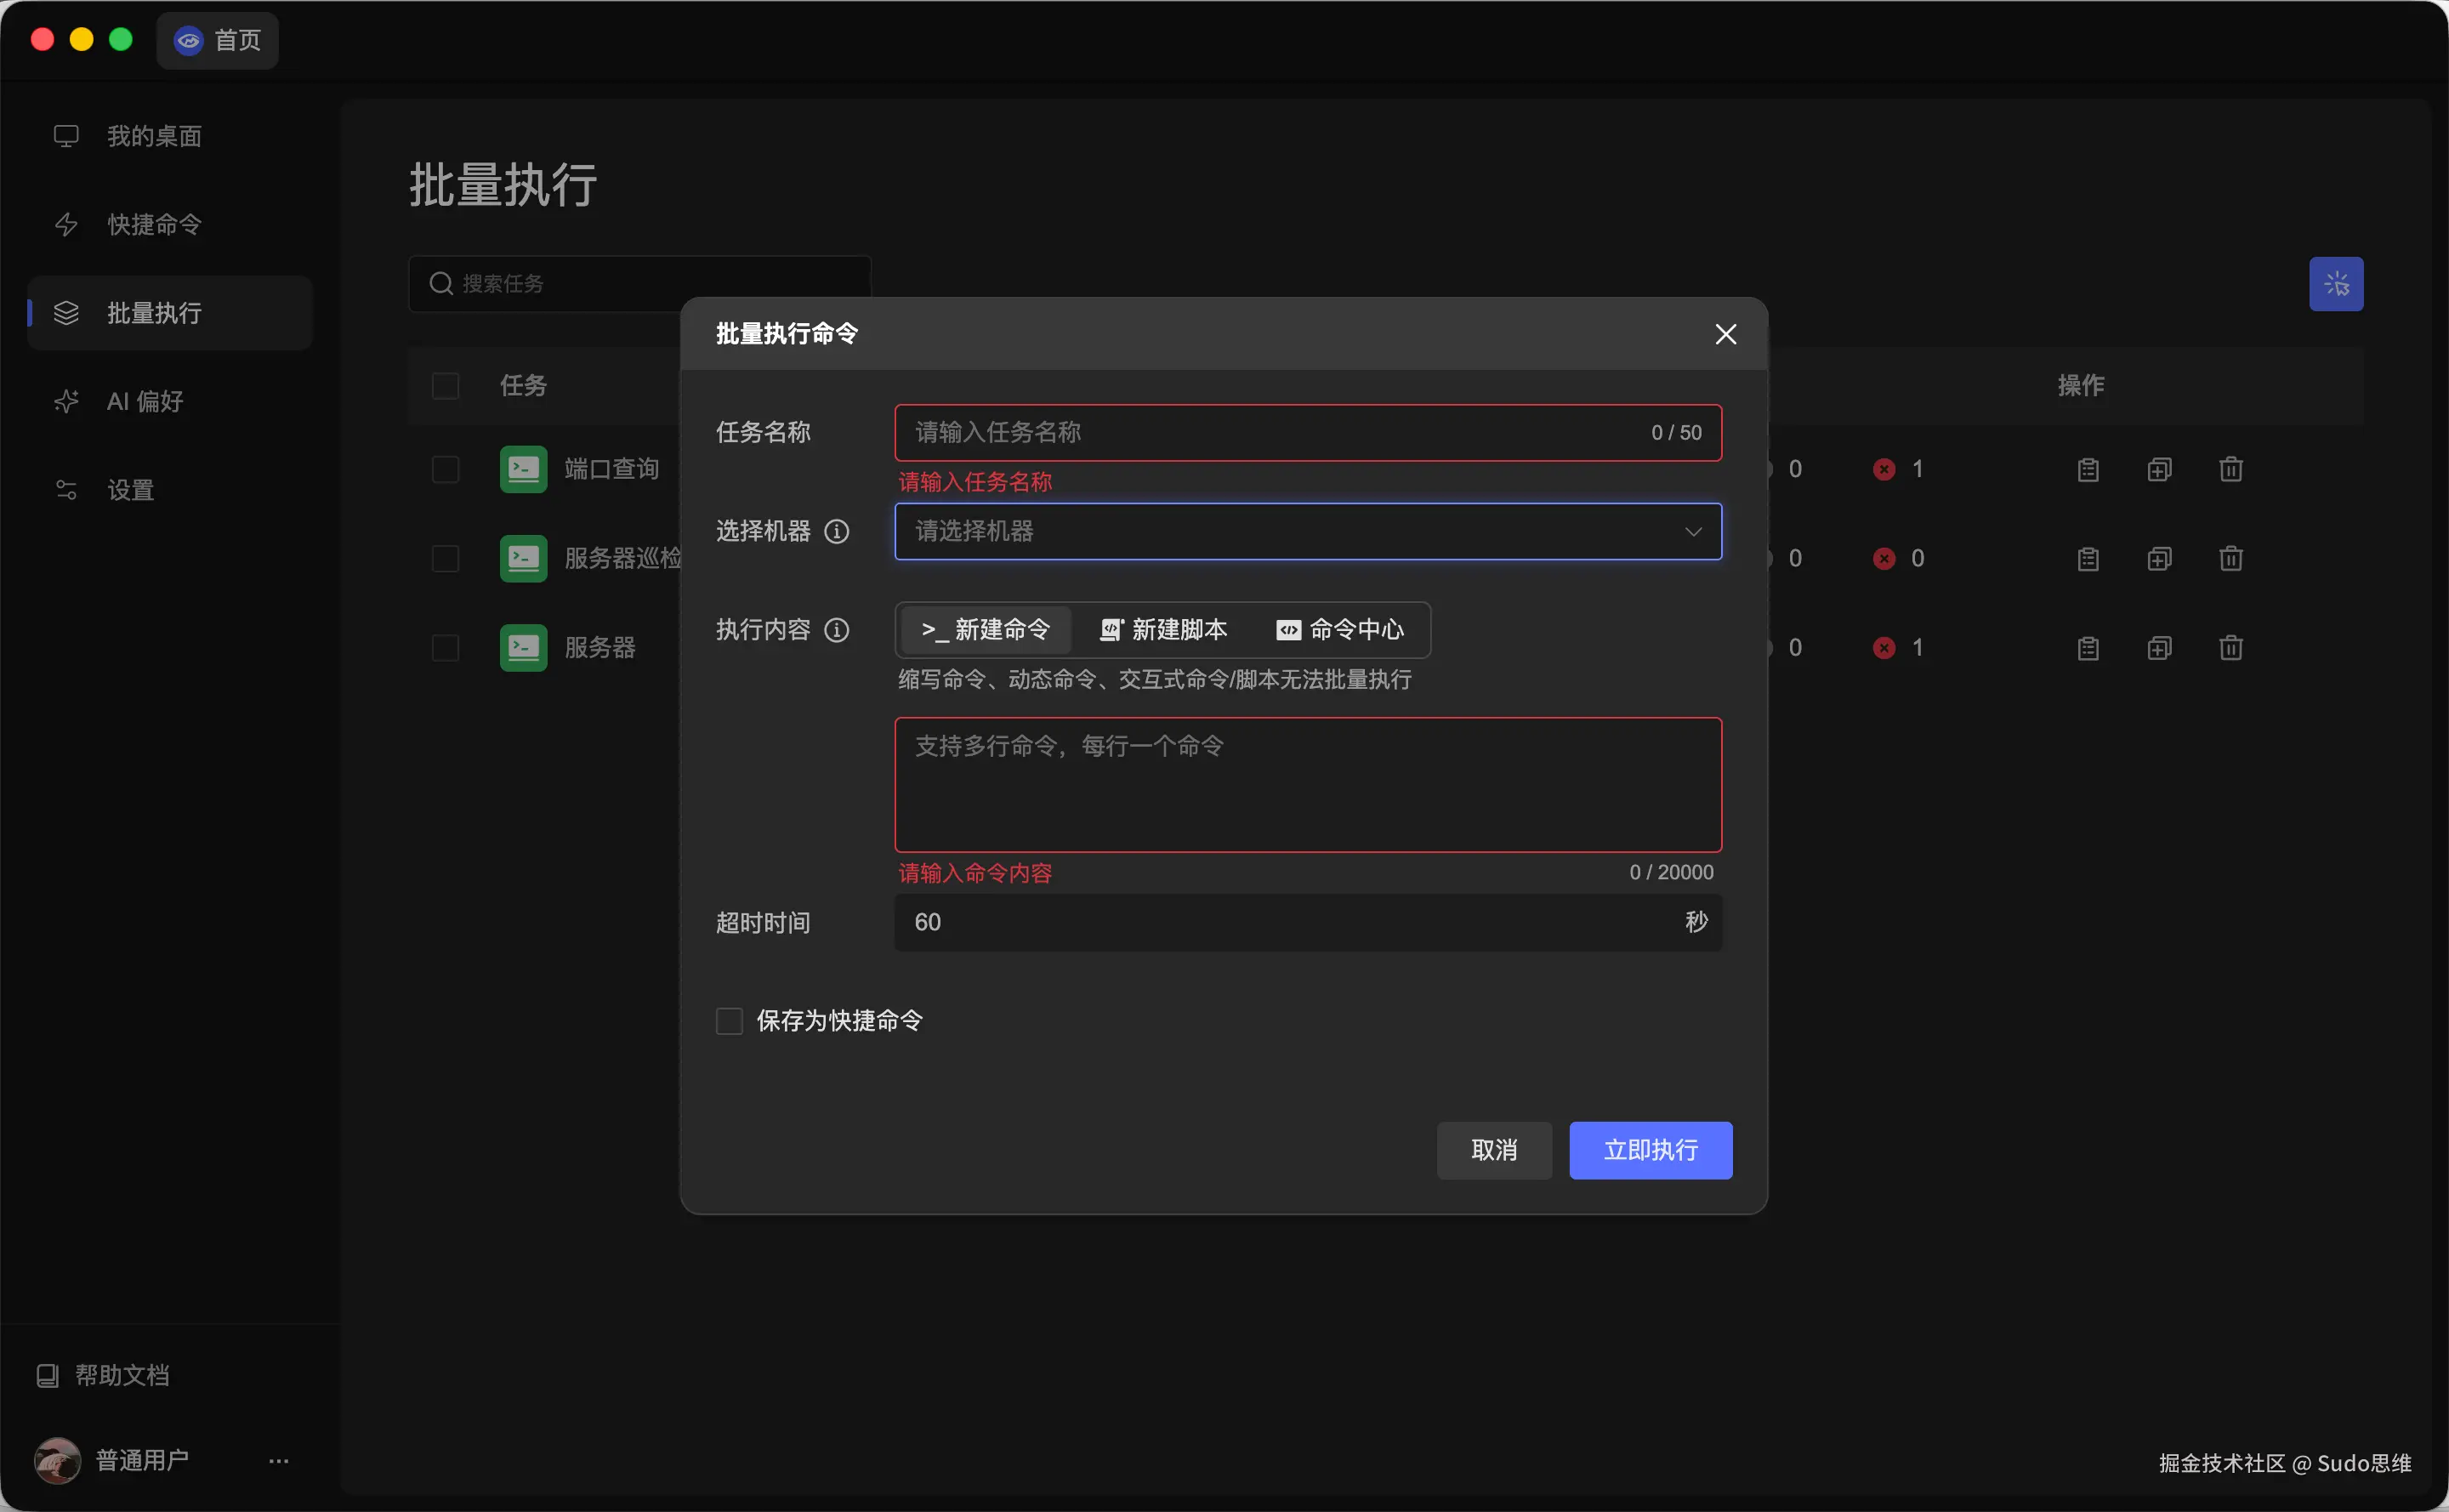
列表的列是:任务 / 任务开始时间 / 状态 / 结果 / 操作。重点看「结果」这一列------绿色数字是通过数,灰色是跳过或 0 项,红色是失败数。我这张截图里,中间那条「服务器巡检」三个数字全绿,另外两条各挂着一个红点,说明那批机器里各有一台执行失败,得点进去看是哪台。
我这三条任务是:端口查询、服务器巡检(就是本文这个脚本)、还有一条临时任务,名字随手起的「服务器」。任务名建议带上用途和频率,比如「服务器巡检-每日」,一眼知道它是干什么的。
第 2 步:新建任务,先定机器范围
点右上角的 + 新建,弹出「批量执行命令」窗口。第一件事填任务名称(上限 50 字),第二件事是选择机器。
点开「选择机器」的下拉,是这样:
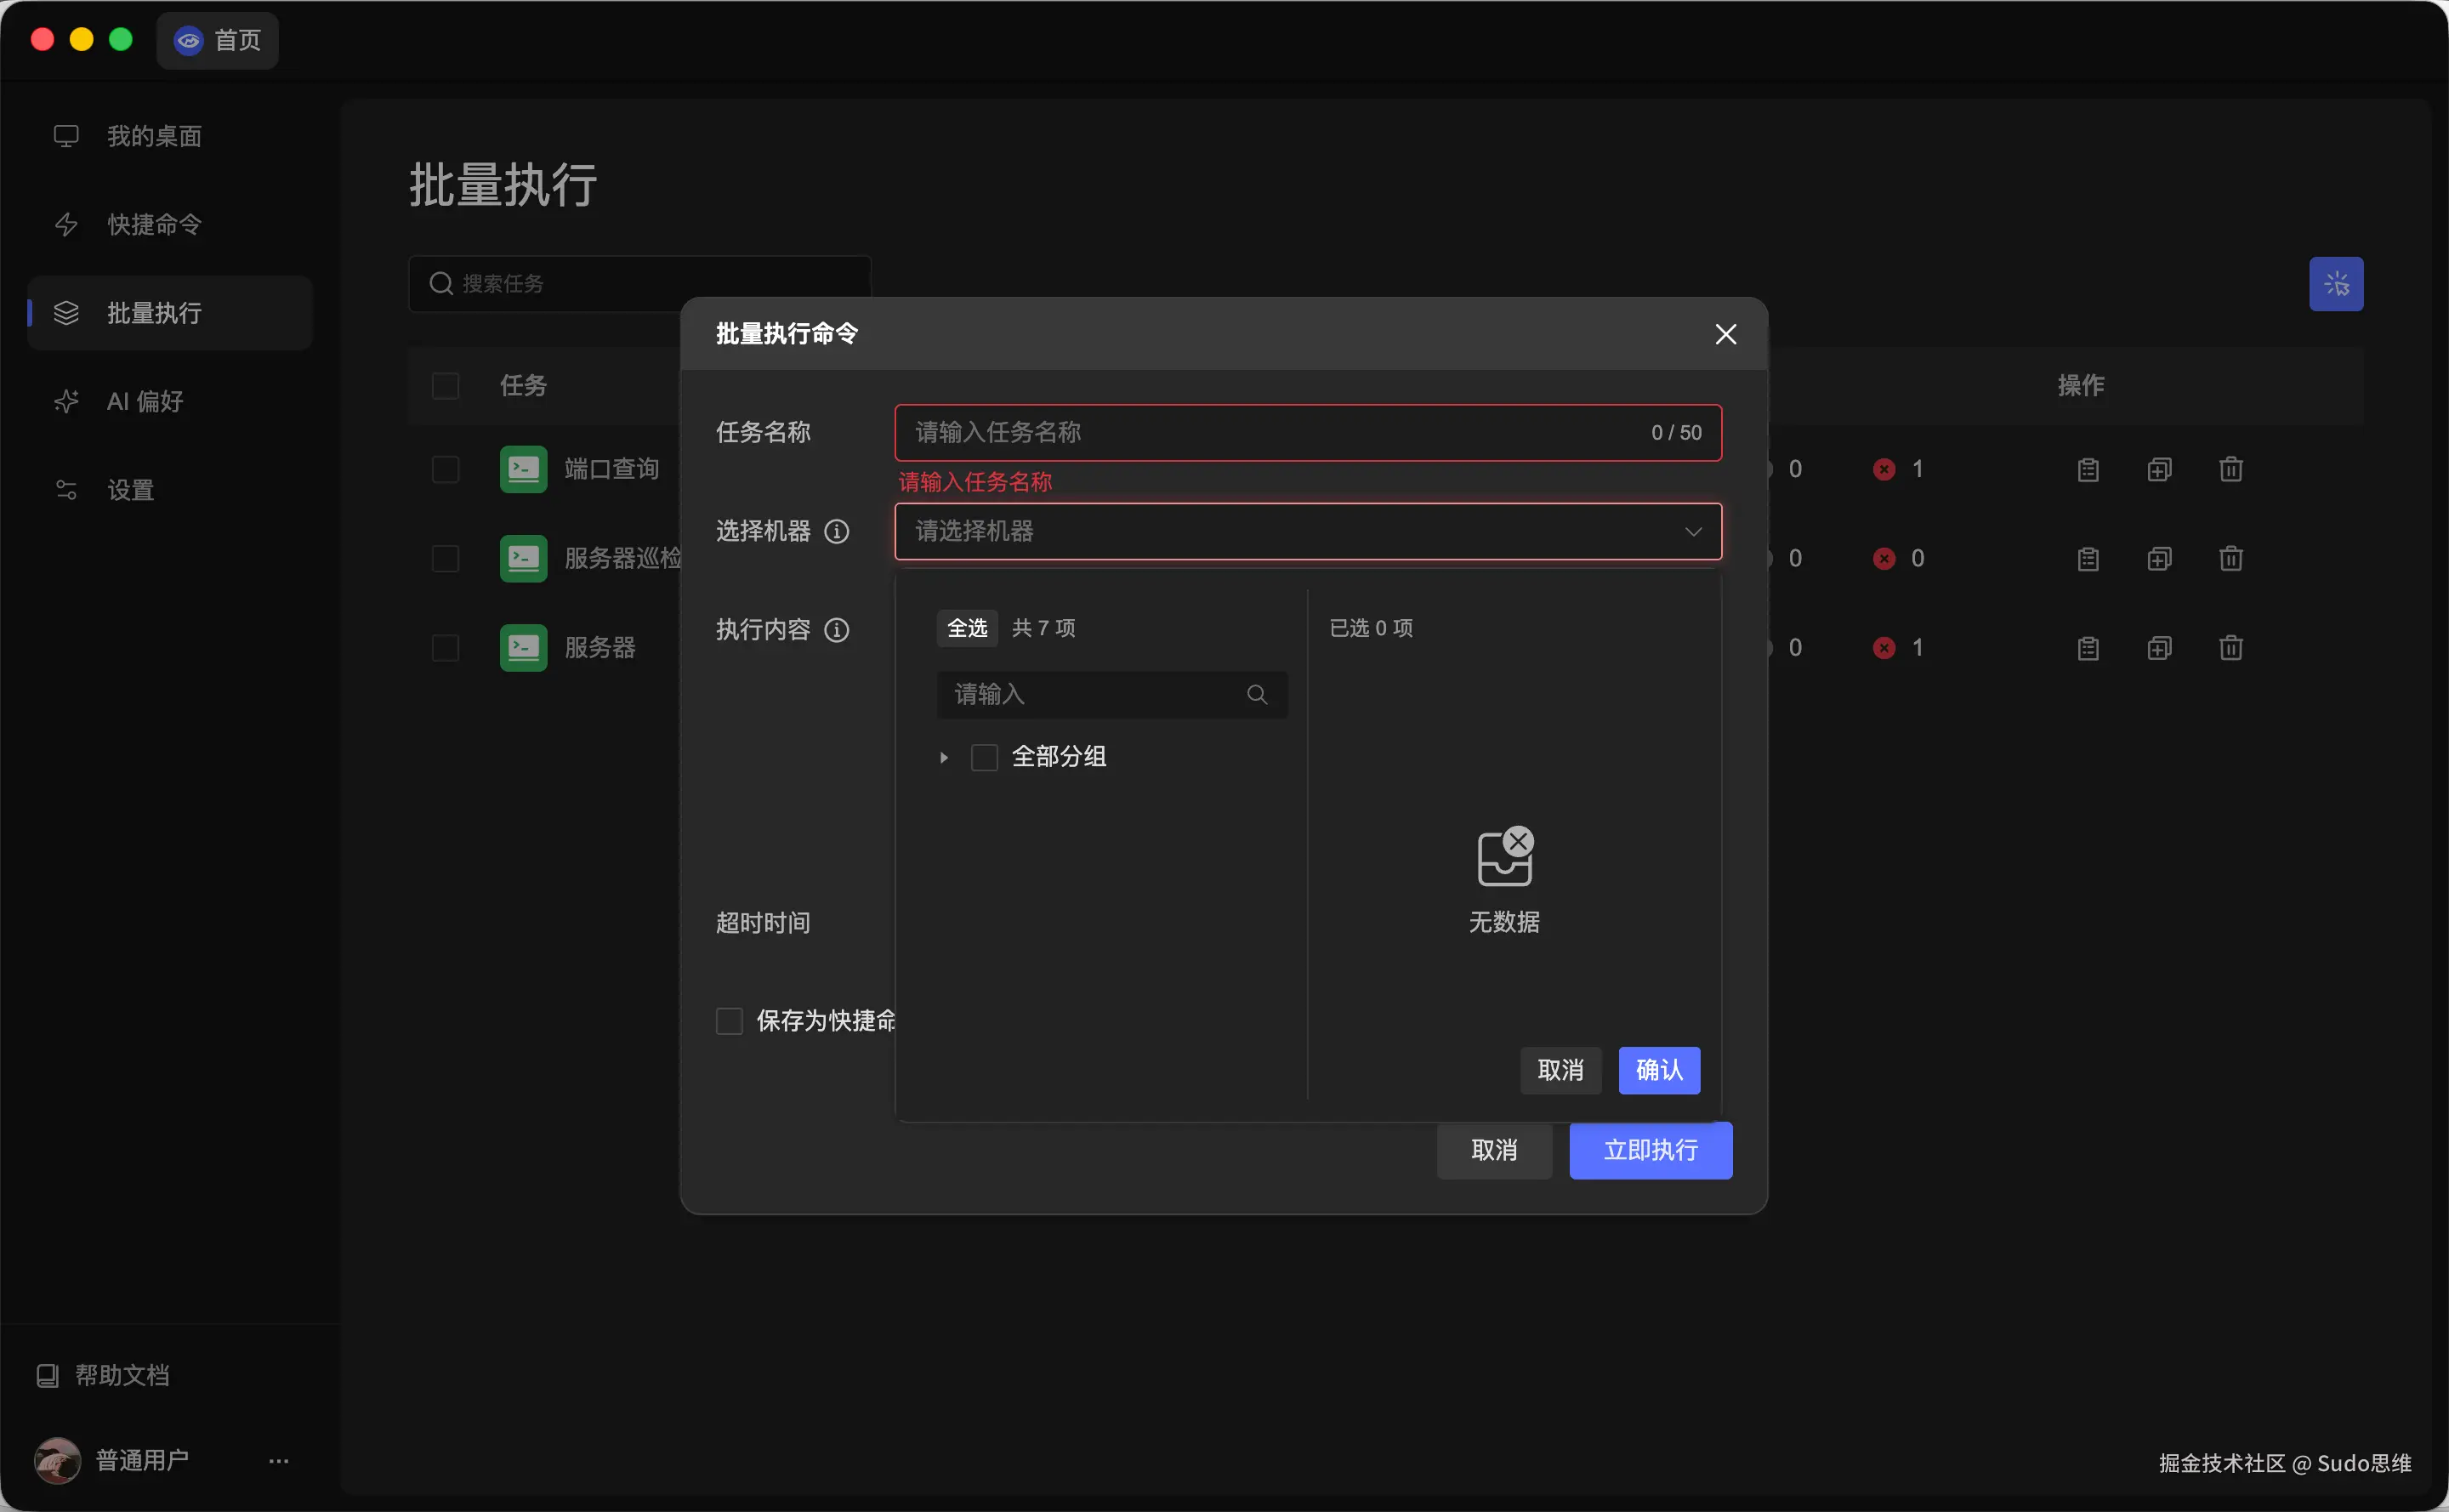
这是全文我最想强调的一个设计:按分组选,而不是手填 IP。
我以前维护一个 iplist.txt,新机器上线忘了加进去,巡检就成了"选择性失明"------而事故往往就出在漏掉的那台上。分组树是跟着机器资产走的:前端 / 个人(TencentCloud、BeAnCloud)/ 企业,勾「全部分组」就是全量,勾一个子分组就是那一批。左上角会显示当前分组下的机器总数和已选数量,选了几台一目了然。
补一句:第一次对陌生分组批量执行时,别全选,先只勾 1~2 台测试机。我截图里这次就只勾了一台(演示方便),实际巡检我会整组勾上。
第 3 步:填脚本、设超时
回到窗口下半部分「执行内容」。这里有三个入口:新建命令、新建脚本、命令中心。区别是:
- 新建脚本:把本文文末的脚本直接粘进去(我日常用这条)
- 命令中心:挑一条已经存好的脚本,就是截图里"已选择:服务器巡检"那种状态
这个窗口里有两个点必须讲清楚:
- 输入框下面那行小字------「填写命令、动态命令、交互式命令/脚本无法批量执行 」。所以脚本里不能有
read、不能等yes/no确认。这也是我前面说"第一条设计原则是非交互"的由来,不是我洁癖,是环境不允许。 - 超时时间 默认 60 秒。这个脚本在普通配置机器上 2~4 秒跑完,60 秒足够;但如果你的脚本里有
yum update、镜像下载这类重活,一定要往上调,不然会出现"跑一半被掐断"的假失败------而且现象看起来像脚本有 bug,特别容易误判。
顺手把下面的「保存为快捷命令」勾上,下次在「快捷命令」里能直接取用,不用再翻脚本。
第 4 步:立即执行,回来收结果
点「立即执行」,窗口关掉,列表里会多一条任务记录,状态从"执行中"变"已完成",结果列更新成 绿/灰/红 三个数字。
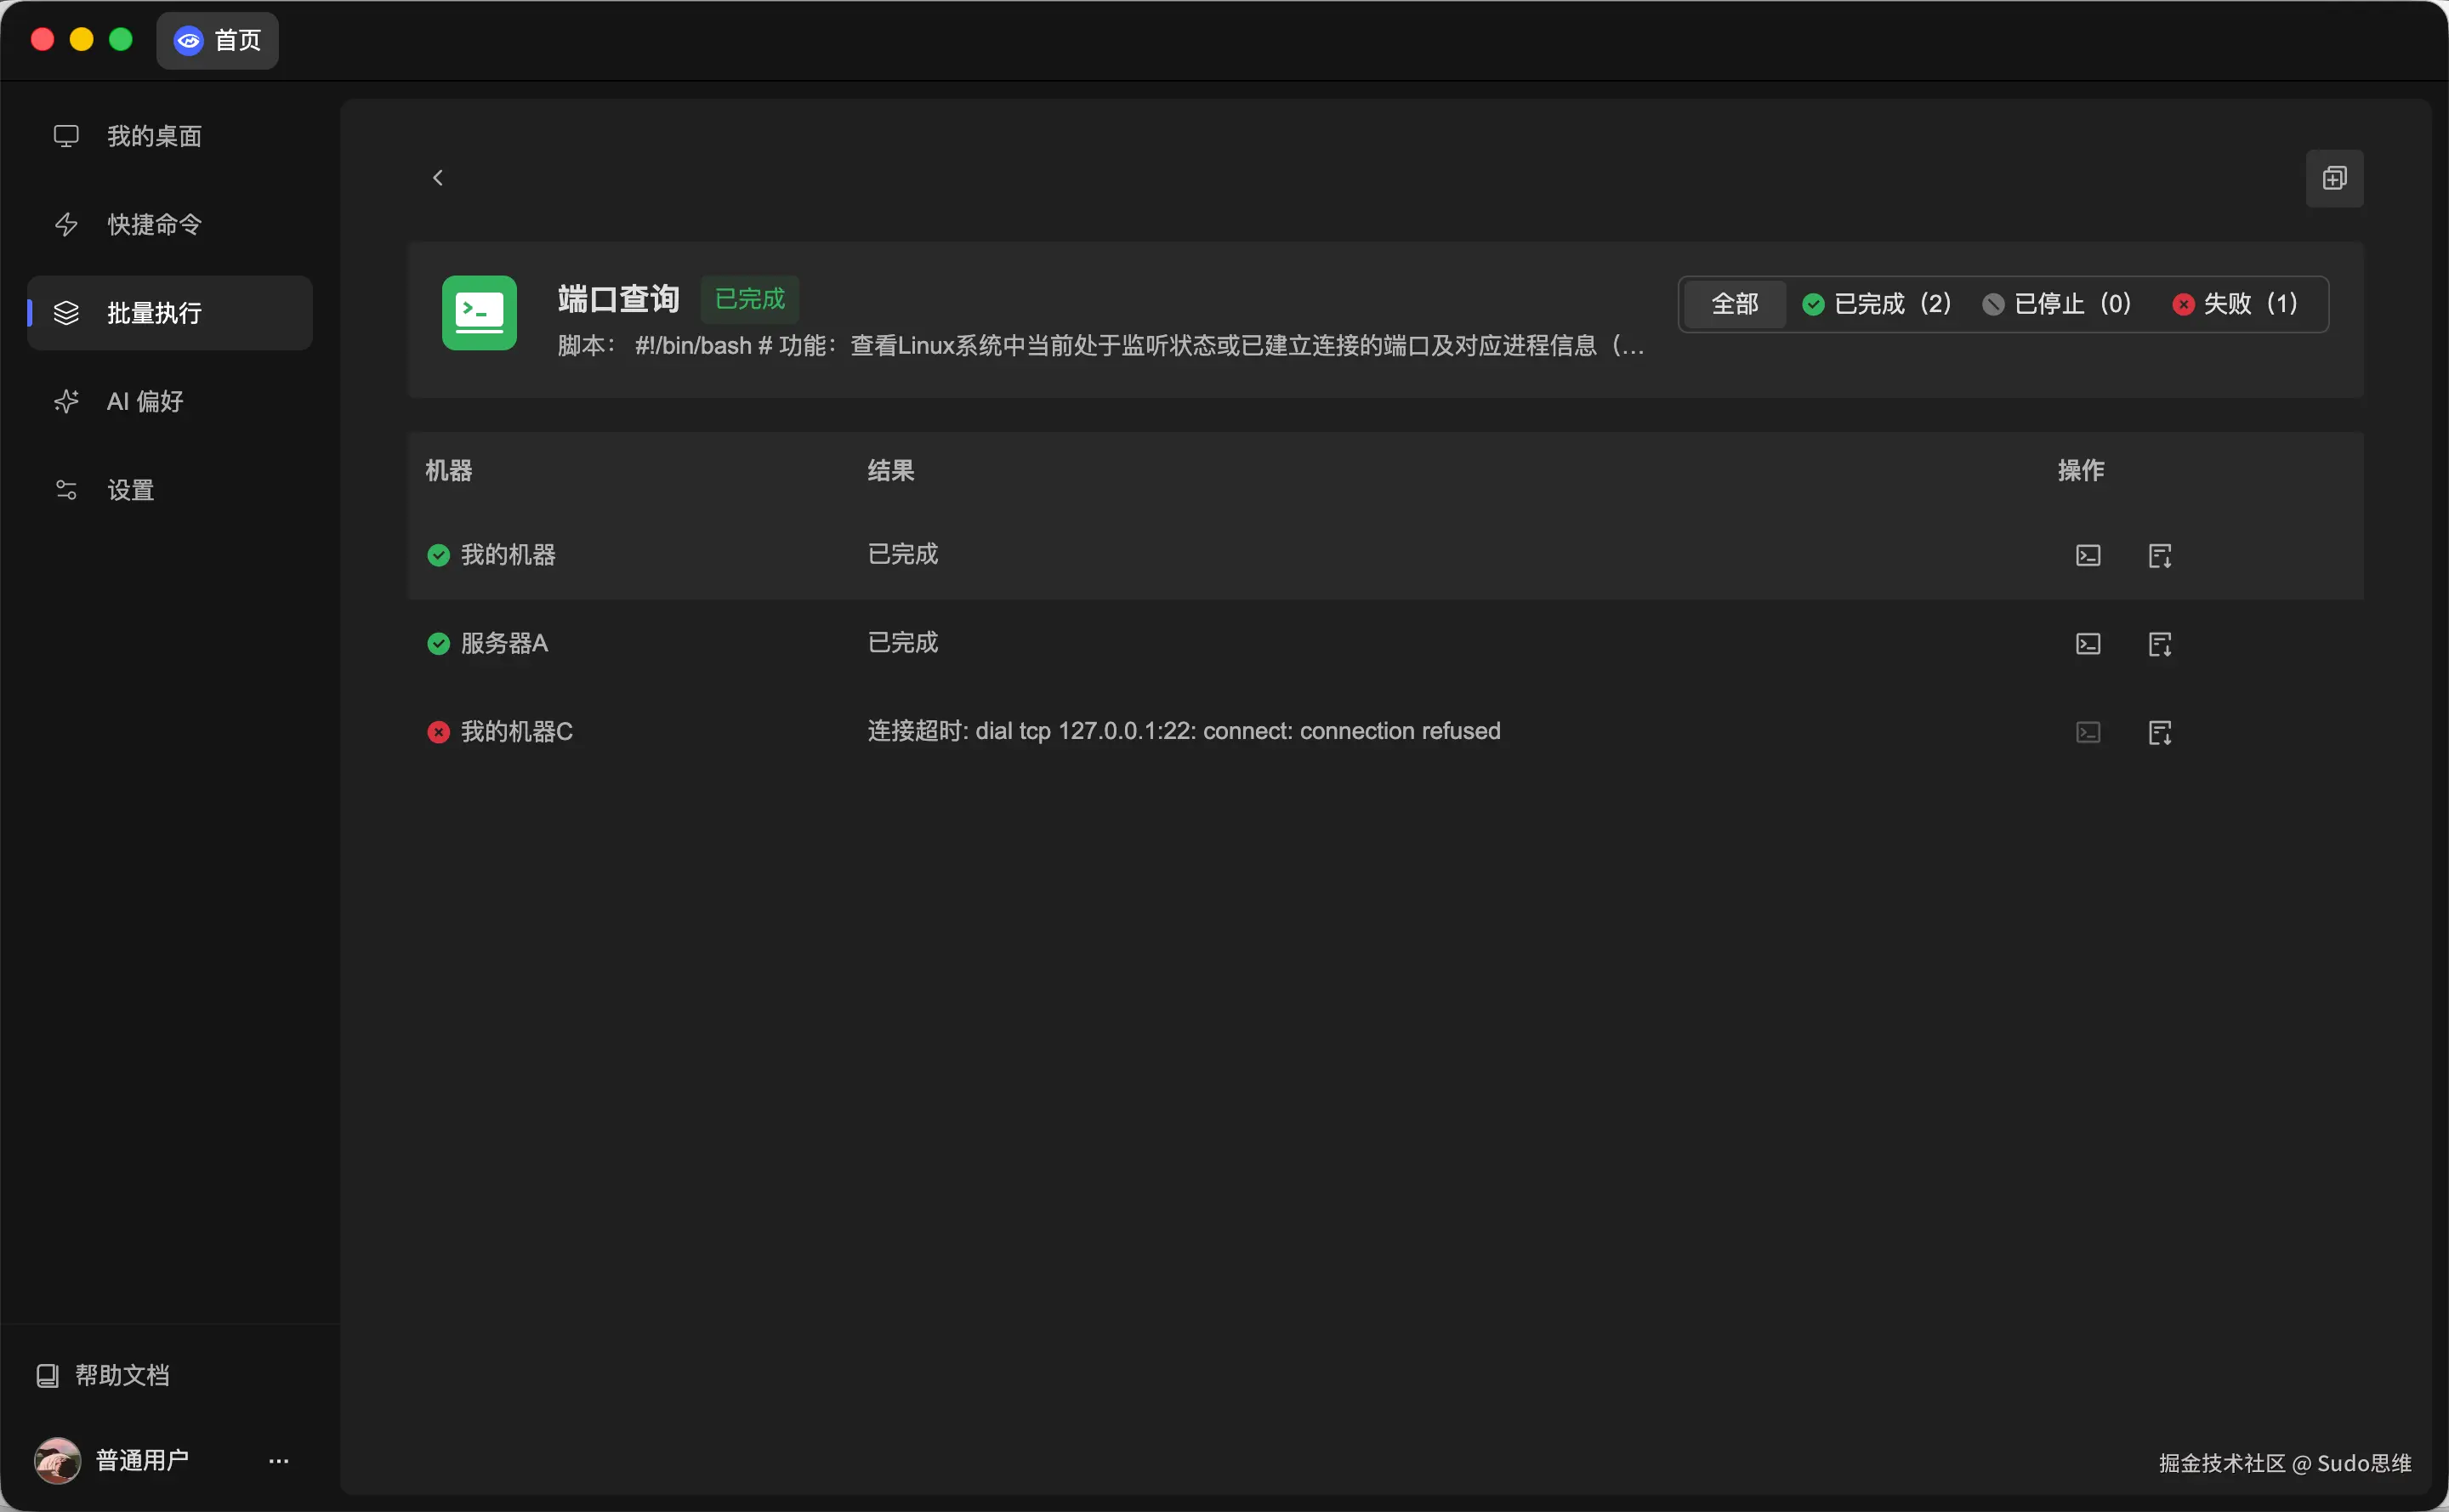
点每条任务的操作区,能下钻看到每台机器的完整输出------一台一份报告,末行就是那条 SUMMARY。所以真正查问题的动作是:进列表,看红色数字,点进去,搜 verdict=FAIL。
我现在固定三条任务,每周一早上点一遍,几十台机器的状态十分钟内到手。任务不需要重建,脚本也没必要每次重贴------这才是"沉淀"和"临时敲一遍"的区别。
六、阈值不要拍脑袋,用基线倒推
脚本里所有阈值都能用环境变量覆盖,不用改代码:
bash
# 大盘磁盘普遍紧张的业务,告警线可以放宽到 90
DISK_WARN=90 DISK_FAIL=96 bash server-inspect.sh

# 内存型应用,可用内存告警线该抬高
MEM_AVAIL_WARN=20 bash server-inspect.sh但更重要的原则是:阈值要从你自己的历史数据倒推,而不是抄别人的 85%。
我的做法是先用 --alerts-only 模式(只输出异常项)跑两周,什么都不改,观察报出来的东西:
- 如果某个告警每周都出现、但从来没出过事 → 阈值定低了,或这项不该告警;
- 如果某个指标从来没告过警,但你出过事 → 阈值定高了,或者根本没检查。
两周之后你会得到一套属于你自己业务的阈值。这一步没有捷径,但它决定了这个脚本是"真能用"还是"跑了没人看"。
七、三个真实的坑
坑 1:别一上来就全量执行。
我第一次对 30 台机器批量跑一个改配置的脚本,其中一条 sed 命令少了个转义,30 台机器同时改坏。所以现在的习惯是:先勾 1~2 台测试机,确认行为正确,再全量推。一条错误命令 × 机器数 = 一场事故。
坑 2:交互式命令不能批量。
vim、需要输 yes/no 的命令、需要读 stdin 的脚本,都不能批量执行------「执行内容」框下面那行小字写得很明白:"填写命令、动态命令、交互式命令/脚本无法批量执行"。这不是限制,是保护:批量场景下一条卡住的命令会拖死整批任务,所以请确保脚本能无人值守跑完。
坑 3:超时设置要跟脚本耗时匹配。
批量执行默认超时 60 秒。如果你的脚本里有 yum update、镜像下载这类重活,务必把超时调大,否则会出现"执行了一半被掐断"的假失败------而且失败原因看起来像脚本有 bug,很容易误判。
八、写在最后
我把这套东西沉淀下来的最大收获,不是"省了多少时间",而是服务器状态终于变成了可以对比的数据。
以前我判断一台机器健康与否靠感觉,现在我看 verdict=WARN 那几个字,再看是哪一项 WARN,三十秒内就能定位。上周磁盘告警之所以能提前两天处理掉,就是因为巡检报告里那个 df 使用率从 78% 一路涨到 88%------趋势比阈值更早说话。
脚本在文末,400 行,没有花哨的东西,依赖只有 bash + coreutils + procps,CentOS 7 到 Ubuntu 22 都能跑。拿去改,改成你自己的阈值和检查项,比抄我的更有价值。
另外说清楚一点:这个脚本不依赖任何客户端 ,纯 bash 就能跑,scp 上去执行也行。我只是把它挂在极目Linux桌面的批量执行上,省去每次手贴、以及"到底哪些机器跑过了"的糊涂账。工具是顺手的,方法是自己的。
如果有更好的检查项(比如证书到期检测、内核参数基线),欢迎评论区补充,我持续往里加。
附录:完整脚本
保存为 server-inspect.sh,chmod +x 后可直接执行。
bash
#!/usr/bin/env bash
#
# server-inspect.sh --- Linux 服务器巡检脚本
#
# 特点:
#   - 全程非交互, 适合在"批量执行"里对多台机器一次性下发
#   - 超时可控, 默认 60 秒内跑完(不含大目录扫描)
#   - 分级判读 OK / WARN / FAIL, 末行输出单行 SUMMARY, 便于批量执行后聚合
#   - 阈值全部可用环境变量覆盖, 不用改脚本
#
# 用法:
#   bash server-inspect.sh                    # 完整报告
#   bash server-inspect.sh --alerts-only      # 只输出异常项(批量执行推荐)
#   DISK_WARN=80 MEM_AVAIL_WARN=15 bash server-inspect.sh
#   bash server-inspect.sh --help
#
# 退出码: 0=全部通过  1=存在 WARN  2=存在 FAIL  3=脚本自身错误
#
# 兼容: CentOS/RHEL 7+、Ubuntu 16.04+、Debian 9+(bash 4+,procps、coreutils)

set -uo pipefail

VERSION="1.2.0"
HOSTNAME_S="$(hostname 2>/dev/null || echo unknown)"
ALERTS_ONLY=0

for arg in "$@"; do
  case "$arg" in
    --alerts-only|-q) ALERTS_ONLY=1 ;;
    --help|-h)        sed -n '2,22p' "$0"; exit 0 ;;
    --version|-V)     echo "server-inspect $VERSION"; exit 0 ;;
    *)                echo "未知参数: $arg(--help 查看用法)" >&2; exit 3 ;;
  esac
done

# ---------- 阈值(可用环境变量覆盖)----------
DISK_WARN="${DISK_WARN:-85}"              # 磁盘使用率告警线 %
DISK_FAIL="${DISK_FAIL:-92}"              # 磁盘使用率严重线 %
INODE_WARN="${INODE_WARN:-85}"            # inode 使用率告警线 %
INODE_FAIL="${INODE_FAIL:-95}"            # inode 使用率严重线 %
LOAD_WARN_FACTOR="${LOAD_WARN_FACTOR:-1.5}"   # 1 分钟负载 / 核数 告警倍数
MEM_AVAIL_WARN="${MEM_AVAIL_WARN:-10}"    # 可用内存低于该百分比告警
SWAP_USED_WARN="${SWAP_USED_WARN:-50}"    # swap 使用率告警线 %
IOWAIT_WARN="${IOWAIT_WARN:-20}"          # iowait 占比告警线 %
SSH_FAIL_WARN="${SSH_FAIL_WARN:-50}"      # 当日 SSH 失败登录次数告警线
JOURNAL_HOURS="${JOURNAL_HOURS:-24}"      # 回顾多久的日志
TOP_N="${TOP_N:-5}"

# ---------- 输出控制 ----------
if [ -t 1 ]; then
  C_DIM=$'\033[2m'; C_B=$'\033[1m'; C_R=$'\033[31m'; C_Y=$'\033[33m'; C_G=$'\033[32m'; C_0=$'\033[0m'
else
  C_DIM=''; C_B=''; C_R=''; C_Y=''; C_G=''; C_0=''
fi

OK_C=0; WARN_C=0; FAIL_C=0
START_TS=$(date +%s)

hdr()  { [ "$ALERTS_ONLY" = 1 ] && return 0; printf '\n%s\n' "${C_B}▶ $*${C_0}"; }
info() { [ "$ALERTS_ONLY" = 1 ] && return 0; printf '  %s %s\n' "${C_DIM}[INFO]${C_0}" "$*"; }
raw()  { [ "$ALERTS_ONLY" = 1 ] && return 0; printf '%s\n' "$*"; }
pass() { OK_C=$((OK_C+1));   [ "$ALERTS_ONLY" = 1 ] && return 0; printf '  %s %s\n' "${C_G}[ OK ]${C_0}" "$*"; }
warn() { WARN_C=$((WARN_C+1)); printf '  %s %s\n' "${C_Y}[WARN]${C_0}" "$*"; }
crit() { FAIL_C=$((FAIL_C+1)); printf '  %s %s\n' "${C_R}[FAIL]${C_0}" "$*"; }

# a >= b(浮点安全比较)
ge() { awk -v a="$1" -v b="$2" 'BEGIN{exit !(a+0 >= b+0)}'; }

have() { command -v "$1" >/dev/null 2>&1; }

echo "============================================================"
echo " 服务器巡检报告  v${VERSION}"
echo " 主机: ${HOSTNAME_S}"
echo " 时间: $(date '+%Y-%m-%d %H:%M:%S %Z')"
echo "============================================================"

# ---------- 1. 基本信息 ----------
hdr "1. 基本信息"
OS_NAME=$(. /etc/os-release 2>/dev/null && echo "${PRETTY_NAME:-unknown}" || uname -s)
OS_NAME=${OS_NAME:-unknown}
KERNEL=$(uname -r)
ARCH=$(uname -m)
CPU_MODEL=$(awk -F': ' '/model name/{print $2; exit}' /proc/cpuinfo 2>/dev/null)
IP_FIRST=$(hostname -I 2>/dev/null | awk '{print $1}')
UP_SEC=$(cut -d. -f1 /proc/uptime 2>/dev/null || echo 0)
UP_DAYS=$((UP_SEC / 86400))
BOOT_AT=$(uptime -s 2>/dev/null || echo 'n/a')

info "系统    : ${OS_NAME}"
info "内核    : ${KERNEL} (${ARCH})"
info "CPU     : ${CPU_MODEL:-unknown}"
info "IP      : ${IP_FIRST:-unknown}"
info "运行时长: ${UP_DAYS} 天(启动于 ${BOOT_AT})"

if [ "$UP_DAYS" -ge 180 ]; then
  warn "已连续运行 ${UP_DAYS} 天,建议排期重启以应用内核/安全更新"
else
  pass "运行时长正常(${UP_DAYS} 天)"
fi

if [ -f /var/run/reboot-required ]; then
  warn "系统存在待重启事项(/var/run/reboot-required),内核或关键库已更新"
elif have needs-restarting && ! needs-restarting -r >/dev/null 2>&1; then
  warn "needs-restarting 提示存在需要重启才能生效的更新"
else
  pass "无需重启的待办更新"
fi

# ---------- 2. CPU 与负载 ----------
hdr "2. CPU 与负载"
CORES=$(nproc 2>/dev/null || getconf _NPROCESSORS_ONLN 2>/dev/null || echo 1)
if [ -r /proc/loadavg ]; then
  read -r L1 L5 L15 _ < /proc/loadavg
else
  # 兜底:部分精简容器/非 Linux 环境无 /proc/loadavg
  set -- $(uptime 2>/dev/null | sed 's/.*load average[s]*: *//' | tr -d ',')
  L1=${1:-0}; L5=${2:-0}; L15=${3:-0}
fi
PER_CORE=$(awk -v a="$L1" -v c="$CORES" 'BEGIN{printf "%.2f", a/c}')
info "核数 ${CORES}|load 1m/5m/15m = ${L1} / ${L5} / ${L15}|单核负载 ${PER_CORE}"

LOAD_WARN=$(awk -v c="$CORES" -v f="$LOAD_WARN_FACTOR" 'BEGIN{printf "%.2f", c*f}')
LOAD_CRIT=$(awk -v c="$CORES" 'BEGIN{printf "%.2f", c*3}')

if ge "$L1" "$LOAD_CRIT"; then
  crit "1 分钟负载 ${L1} 超过核数 3 倍(${LOAD_CRIT}),疑似资源打满"
elif ge "$L1" "$LOAD_WARN"; then
  warn "1 分钟负载 ${L1} 超过告警线 ${LOAD_WARN}(核数 × ${LOAD_WARN_FACTOR})"
else
  pass "负载正常(1m ${L1} < ${LOAD_WARN})"
fi

WAIT_PCT=""; STEAL_PCT=""
if have vmstat; then
  VM_LINE=$(vmstat 1 2 2>/dev/null | tail -1)
  if [ -n "$VM_LINE" ]; then
    WAIT_PCT=$(echo "$VM_LINE" | awk '{print $16}')
    STEAL_PCT=$(echo "$VM_LINE" | awk '{print $17}')
  fi
fi
if [ -n "$WAIT_PCT" ]; then
  info "CPU 分布: user $(echo "$VM_LINE" | awk '{print $13}')% / sys $(echo "$VM_LINE" | awk '{print $14}')% / idle $(echo "$VM_LINE" | awk '{print $15}')% / iowait ${WAIT_PCT}% / steal ${STEAL_PCT}%"
  if ge "$WAIT_PCT" "$IOWAIT_WARN"; then
    warn "iowait ${WAIT_PCT}% 偏高(>${IOWAIT_WARN}%),排查磁盘 IO"
  else
    pass "iowait 正常(${WAIT_PCT}%)"
  fi
  if ge "$STEAL_PCT" 5; then
    warn "steal ${STEAL_PCT}% 偏高,宿主机资源被争抢(云主机超卖迹象)"
  fi
fi

if [ "$ALERTS_ONLY" = 0 ] && have ps; then
  raw "  ${C_DIM}CPU 占用 TOP ${TOP_N}:${C_0}"
  ps -eo pcpu,pmem,rss,comm --sort=-pcpu 2>/dev/null | head -n $((TOP_N + 1)) | tail -n +2 |
    awk '{printf "    %6.1f%%  %5.1f%%  %6.0fMB  %s\n", $1, $2, $3/1024, $4}'
fi

# ---------- 3. 内存与 Swap ----------
hdr "3. 内存与 Swap"
MEM_TOTAL_KB=$(awk '/^MemTotal:/{print $2}' /proc/meminfo 2>/dev/null || echo 0)
MEM_AVAIL_KB=$(awk '/^MemAvailable:/{print $2}' /proc/meminfo 2>/dev/null || echo 0)
[ -z "${MEM_AVAIL_KB:-}" ] || [ "${MEM_AVAIL_KB:-0}" -eq 0 ] && MEM_AVAIL_KB=$(awk '/^MemFree:/{print $2}' /proc/meminfo 2>/dev/null || echo 0)
SWAP_TOTAL_KB=$(awk '/^SwapTotal:/{print $2}' /proc/meminfo 2>/dev/null || echo 0)
SWAP_FREE_KB=$(awk '/^SwapFree:/{print $2}' /proc/meminfo 2>/dev/null || echo 0)
MEM_TOTAL_KB=${MEM_TOTAL_KB:-0}; MEM_AVAIL_KB=${MEM_AVAIL_KB:-0}
SWAP_TOTAL_KB=${SWAP_TOTAL_KB:-0}; SWAP_FREE_KB=${SWAP_FREE_KB:-0}

if [ -n "${MEM_TOTAL_KB:-}" ] && [ "$MEM_TOTAL_KB" -gt 0 ]; then
  AVAIL_PCT=$(awk -v a="$MEM_AVAIL_KB" -v t="$MEM_TOTAL_KB" 'BEGIN{printf "%.1f", a*100/t}')
  USED_GB=$(awk -v t="$MEM_TOTAL_KB" -v a="$MEM_AVAIL_KB" 'BEGIN{printf "%.1f", (t-a)/1048576}')
  TOTAL_GB=$(awk -v t="$MEM_TOTAL_KB" 'BEGIN{printf "%.1f", t/1048576}')
  info "内存 ${USED_GB}G / ${TOTAL_GB}G 已用|可用 ${AVAIL_PCT}%"

  if ge 5 "$AVAIL_PCT"; then
    crit "可用内存仅 ${AVAIL_PCT}%,随时可能触发 OOM"
  elif ge "$MEM_AVAIL_WARN" "$AVAIL_PCT"; then
    warn "可用内存 ${AVAIL_PCT}% 低于告警线 ${MEM_AVAIL_WARN}%"
  else
    pass "可用内存充足(${AVAIL_PCT}%)"
  fi
else
  info "无法读取 /proc/meminfo,跳过内存检查"
fi

if [ "${SWAP_TOTAL_KB:-0}" -gt 0 ]; then
  SWAP_USED_PCT=$(awk -v t="$SWAP_TOTAL_KB" -v f="$SWAP_FREE_KB" 'BEGIN{printf "%.1f", (t-f)*100/t}')
  SWAP_GB=$(awk -v t="$SWAP_TOTAL_KB" 'BEGIN{printf "%.1f", t/1048576}')
  info "Swap ${SWAP_GB}G|已用 ${SWAP_USED_PCT}%"
  if ge "$SWAP_USED_PCT" "$SWAP_USED_WARN"; then
    warn "Swap 使用 ${SWAP_USED_PCT}% 超过 ${SWAP_USED_WARN}%,内存可能长期吃紧"
  else
    pass "Swap 使用正常(${SWAP_USED_PCT}%)"
  fi
else
  info "未启用 Swap(云主机常见,属正常配置)"
fi

if [ "$ALERTS_ONLY" = 0 ] && have ps; then
  raw "  ${C_DIM}内存占用 TOP ${TOP_N}:${C_0}"
  ps -eo pmem,rss,comm --sort=-pmem 2>/dev/null | head -n $((TOP_N + 1)) | tail -n +2 |
    awk '{printf "    %5.1f%%  %6.0fMB  %s\n", $1, $2/1024, $3}'
fi

# ---------- 4. 磁盘与 inode ----------
hdr "4. 磁盘与 inode"
if have df; then
  DF_OUT=$(df -PT 2>/dev/null | awk 'NR>1 && $2 !~ /^(tmpfs|devtmpfs|devfs|overlay|squashfs|iso9660|autofs|proc|sysfs|cgroup|cgroup2|nsfs|ramfs|fuse\..*|none)$/ {print $7"|"$6"|"$1}')
  # 只读挂载不参与使用率判定(ro 盘 100% 满属正常,避免误报刷屏)
  RO_MOUNTS=$(awk '$4 ~ /(^|,)ro($|,)/{print $2}' /proc/mounts 2>/dev/null || true)
  if [ -z "$DF_OUT" ]; then
    # 兜底:df 不支持 -T 的老环境
    DF_OUT=$(df -P 2>/dev/null | awk 'NR>1 {print $6"|"$5"|"$1}')
  fi
  CHECKED=0
  if [ -n "$DF_OUT" ]; then
    while IFS='|' read -r mnt cap dev; do
      [ -z "$mnt" ] && continue
      pct=${cap%\%}
      CHECKED=$((CHECKED+1))
      if [ -n "${RO_MOUNTS:-}" ] && printf '%s\n' "$RO_MOUNTS" | grep -Fxq "$mnt"; then
        info "挂载点 ${mnt} 为只读挂载,跳过使用率判定"
        continue
      fi
      if ge "$pct" "$DISK_FAIL"; then
        crit "挂载点 ${mnt}(${dev})使用率 ${pct}%,已超严重线 ${DISK_FAIL}%"
      elif ge "$pct" "$DISK_WARN"; then
        warn "挂载点 ${mnt}(${dev})使用率 ${pct}%,超过告警线 ${DISK_WARN}%"
      else
        pass "挂载点 ${mnt} 使用率 ${pct}%"
      fi
    done <<< "$DF_OUT"
  fi
  [ "$CHECKED" -eq 0 ] && info "未发现需要检查的本地磁盘挂载点"

  INODE_OUT=$(df -Pi 2>/dev/null | awk 'NR>1 && $1 !~ /^(tmpfs|devtmpfs|overlay|squashfs|proc|sysfs)$/ {print $6"|"$5}' | sort -u)
  if [ -n "$INODE_OUT" ]; then
    while IFS='|' read -r mnt ipct; do
      [ -z "$mnt" ] || [ "$ipct" = "-" ] && continue
      ipct=${ipct%\%}
      if ge "$ipct" "$INODE_FAIL"; then
        crit "inode 使用率 ${ipct}%(${mnt}),已无法创建新文件"
      elif ge "$ipct" "$INODE_WARN"; then
        warn "inode 使用率 ${ipct}%(${mnt})超过 ${INODE_WARN}%,注意小文件堆积"
      fi
    done <<< "$INODE_OUT"
  fi
else
  info "未找到 df,跳过磁盘检查"
fi

# ---------- 5. 网络与连接 ----------
hdr "5. 网络与连接"
if have ss; then
  LISTEN_N=$(ss -lntH 2>/dev/null | wc -l | tr -d ' ')
  EST_N=$(ss -antH state established 2>/dev/null | wc -l | tr -d ' ')
  TW_N=$(ss -antH state time-wait 2>/dev/null | wc -l | tr -d ' ')
  info "监听端口 ${LISTEN_N} 个|ESTABLISHED ${EST_N}|TIME_WAIT ${TW_N}"
  if [ "$EST_N" -gt 20000 ]; then
    warn "并发连接 ${EST_N},注意文件描述符与端口耗尽风险"
  else
    pass "连接数正常(${EST_N})"
  fi
  if ge "$TW_N" 20000; then
    warn "TIME_WAIT ${TW_N} 偏多,可检查 tcp_tw_reuse 与短连接使用方式"
  fi
  if [ "$ALERTS_ONLY" = 0 ]; then
    raw "  ${C_DIM}对端 TOP 3(ESTABLISHED):${C_0}"
    ss -antH state established 2>/dev/null | awk '{split($4,a,":"); print a[1]}' |
      sort | uniq -c | sort -rn | head -3 | awk '{printf "    %5d 来自 %s\n", $1, $2}'
  fi
else
  info "未找到 ss(iproute2),跳过连接统计"
fi

if [ -r /proc/net/snmp ]; then
  RETRANS=$(awk '/^Tcp:/ && $2=="RetransSegs"{print $3; exit}' /proc/net/snmp 2>/dev/null || echo '')
  [ -n "$RETRANS" ] && info "累计 TCP 重传段数 ${RETRANS}(绝对值参考,需对比历史趋势)"
fi

# ---------- 6. 服务与内核事件 ----------
hdr "6. 服务与内核事件"

ZOMBIE_N=$(ps -eo stat= 2>/dev/null | grep -c '^[[:space:]]*Z' || true)
if [ "${ZOMBIE_N:-0}" -gt 0 ]; then
  warn "存在 ${ZOMBIE_N} 个僵尸进程,检查父进程是否正确回收子进程"
else
  pass "无僵尸进程"
fi

if have systemctl; then
  FAILED_UNITS=$(systemctl list-units --state=failed --no-legend --plain 2>/dev/null | awk '{print $1}')
  FAILED_N=$(printf '%s\n' "$FAILED_UNITS" | grep -c . || true)
  if [ "${FAILED_N:-0}" -gt 0 ]; then
    crit "存在 ${FAILED_N} 个 failed 状态的 systemd 单元"
    printf '%s\n' "$FAILED_UNITS" | head -5 | while IFS= read -r u; do [ -n "$u" ] && raw "        - ${u}"; done
  else
    pass "systemd 无 failed 单元"
  fi
fi

OOM_N=0
if have journalctl; then
  OOM_N=$(journalctl -k --since "-${JOURNAL_HOURS} hours" --no-pager 2>/dev/null | grep -ci 'out of memory\|oom-kill' || true)
elif have dmesg; then
  OOM_N=$(dmesg 2>/dev/null | grep -ci 'out of memory\|oom-kill' || true)
fi
if [ "${OOM_N:-0}" -gt 0 ]; then
  crit "近 ${JOURNAL_HOURS} 小时出现 ${OOM_N} 次 OOM 记录,进程曾被内核杀死"
else
  pass "近 ${JOURNAL_HOURS} 小时无 OOM 记录"
fi

if have journalctl; then
  ERR_N=$(journalctl -p err --since "-${JOURNAL_HOURS} hours" --no-pager 2>/dev/null | grep -v '^-- ' | grep -c . || true)
  info "近 ${JOURNAL_HOURS} 小时 error 级别日志 ${ERR_N} 条"
  if [ "$ALERTS_ONLY" = 0 ] && [ "$ERR_N" -gt 0 ]; then
    journalctl -p err --since "-${JOURNAL_HOURS} hours" --no-pager 2>/dev/null | grep -v '^-- ' | tail -3 |
      awk '{printf "    %s\n", substr($0, 1, 150)}'
  fi
fi

# ---------- 7. 安全基线 ----------
hdr "7. 安全基线"
WHO_N=$(who 2>/dev/null | wc -l | tr -d ' ')
info "当前登录会话 ${WHO_N} 个"
if [ "$WHO_N" -gt 0 ] && [ "$ALERTS_ONLY" = 0 ]; then
  who 2>/dev/null | head -5 | awk '{printf "    %s  %s  %s\n", $1, $2, $3}'
fi

SSH_FAIL=0
if have journalctl; then
  for unit in sshd ssh; do
    n=$(journalctl -u "$unit" --since today --no-pager 2>/dev/null | grep -c 'Failed password' || true)
    if [ "${n:-0}" -gt "$SSH_FAIL" ]; then SSH_FAIL=$n; fi
  done
  if [ "$SSH_FAIL" -gt 0 ]; then
    if ge "$SSH_FAIL" "$SSH_FAIL_WARN"; then
      warn "今日 SSH 密码登录失败 ${SSH_FAIL} 次,疑似暴力破解,建议改密钥登录 + fail2ban"
    else
      info "今日 SSH 失败登录 ${SSH_FAIL} 次(零星失败属正常噪声)"
    fi
  else
    pass "今日无 SSH 失败登录记录"
  fi
fi

ROOT_LOGIN=$(awk -F: '$3>=1000 && $7 !~ /(nologin|false|sync|shutdown|halt)$/ {print $1}' /etc/passwd 2>/dev/null | wc -l | tr -d ' ')
info "可登录的普通用户 ${ROOT_LOGIN} 个(uid>=1000)"

if have getenforce; then
  SE=$(getenforce 2>/dev/null || echo 'unknown')
  info "SELinux: ${SE}"
elif have aa-status; then
  info "AppArmor: $(aa-status --enabled 2>/dev/null && echo enabled || echo disabled)"
fi

# ---------- 8. 时间同步 ----------
hdr "8. 时间同步"
SYNCED=''
if have timedatectl; then
  SYNCED=$(timedatectl show -p NTPSynchronized --value 2>/dev/null || true)
fi
if [ "$SYNCED" = "yes" ]; then
  pass "NTP 已同步($(timedatectl show -p NTP --value 2>/dev/null))"
elif [ -n "$SYNCED" ]; then
  warn "NTP 未同步,时间漂移会导致证书校验、分布式事务、日志排序异常"
elif have chronyc; then
  if chronyc tracking >/dev/null 2>&1; then
    pass "chrony 正常($(chronyc tracking 2>/dev/null | awk '/Leap status/{print $4, $5}'))"
  else
    warn "chrony 存在但未正常跟踪时间源"
  fi
else
  info "无法判断时间同步状态(无 timedatectl / chronyc)"
fi

# ---------- 9. 容器(可选)----------
if have docker; then
  hdr "9. 容器状态"
  RUNNING=$(docker ps -q 2>/dev/null | wc -l | tr -d ' ')
  ALL=$(docker ps -aq 2>/dev/null | wc -l | tr -d ' ')
  UNHEALTHY=$(docker ps --filter health=unhealthy -q 2>/dev/null | wc -l | tr -d ' ')
  STOPPED=$((ALL - RUNNING))
  info "容器 运行 ${RUNNING} / 停止 ${STOPPED} / 共 ${ALL}"
  if [ "${UNHEALTHY:-0}" -gt 0 ]; then
    crit "存在 ${UNHEALTHY} 个 unhealthy 容器"
    docker ps --filter health=unhealthy --format '        - {{.Names}} ({{.Status}})' 2>/dev/null | head -5
  else
    pass "无 unhealthy 容器"
  fi
  if [ "${STOPPED:-0}" -gt 3 ]; then
    warn "存在 ${STOPPED} 个已停止容器,注意磁盘与端口占用残留"
  fi
fi

# ---------- 汇总 ----------
END_TS=$(date +%s)
DUR=$((END_TS - START_TS))
VERDICT="OK"
[ "$WARN_C" -gt 0 ] && VERDICT="WARN"
[ "$FAIL_C" -gt 0 ] && VERDICT="FAIL"

echo
echo "============================================================"
printf ' 结论: %s  | 通过 %d  告警 %d  严重 %d  | 耗时 %ds\n' "$VERDICT" "$OK_C" "$WARN_C" "$FAIL_C" "$DUR"
echo "============================================================"
# 单行摘要:批量执行多台机器时,只靠这一行就能横向对比
printf 'SUMMARY host=%s verdict=%s ok=%d warn=%d fail=%d duration=%ds\n' \
  "$HOSTNAME_S" "$VERDICT" "$OK_C" "$WARN_C" "$FAIL_C" "$DUR"

case "$VERDICT" in
  OK)   exit 0 ;;
  WARN) exit 1 ;;
  FAIL) exit 2 ;;
esac
用法速查
bash
bash server-inspect.sh                    # 完整报告,人看
bash server-inspect.sh --alerts-only      # 只输出异常,批量执行推荐
DISK_WARN=90 MEM_AVAIL_WARN=20 bash server-inspect.sh   # 自定义阈值
bash server-inspect.sh --help # 参数说明退出码:0 全部通过 / 1 存在 WARN / 2 存在 FAIL / 3 脚本自身错误。