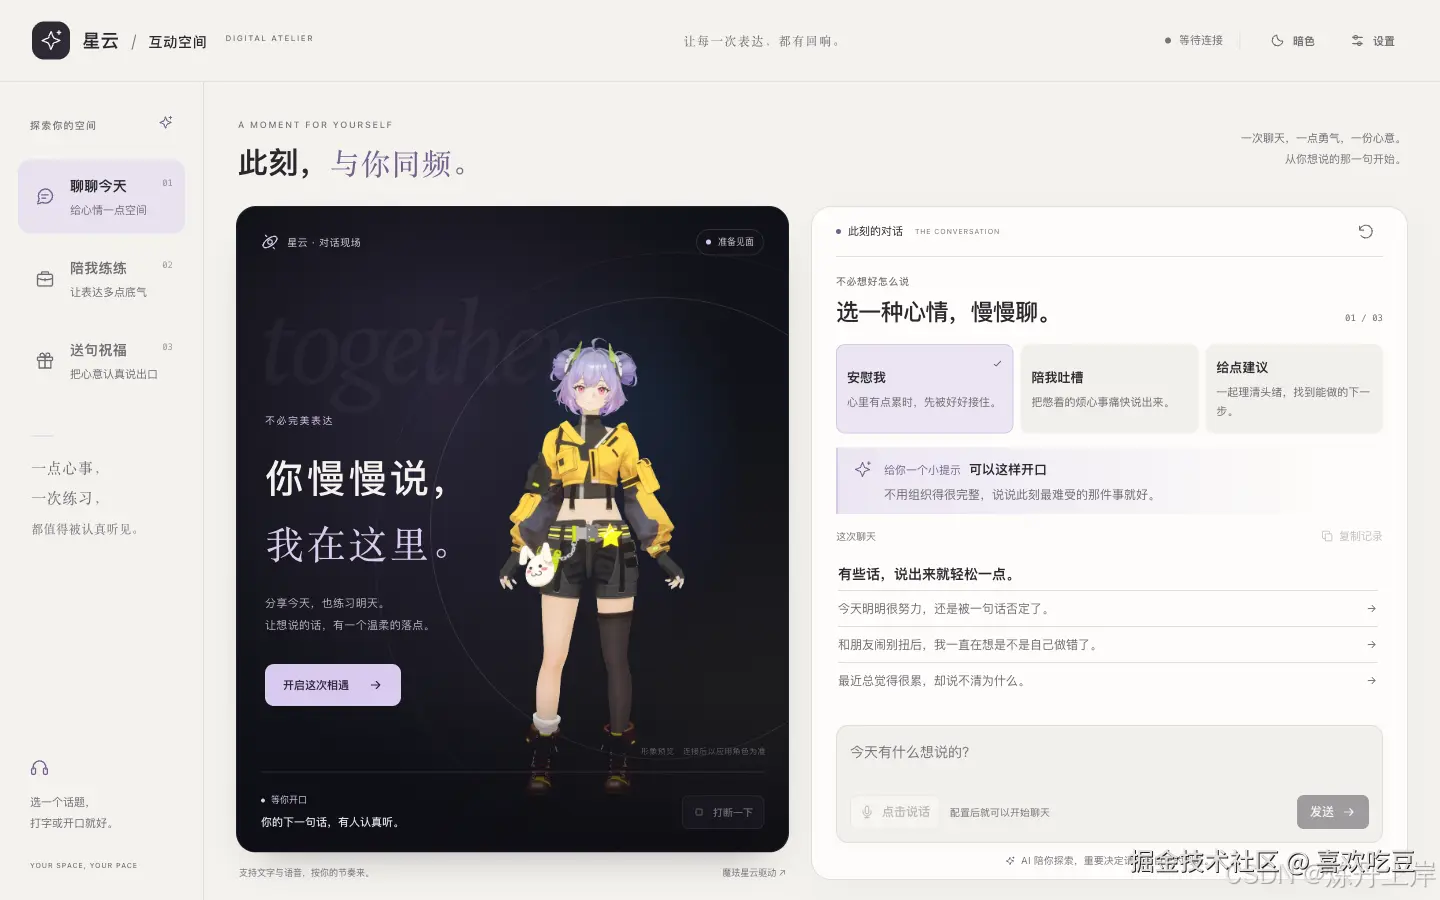
前段时间,我开源了一个数字人项目 xingyun3D。
最初的版本更像一个「数字人表演控制台」:输入一段文字,让数字人播报;点击按钮,让它打招呼、执行动作;也可以用预设脚本串起一段自动演示。它解决的是一个很具体的问题:怎样把数字人 SDK 接进网页,并把播报、动作和状态控制这些基础能力用起来。
但这次,我想把项目往前推进一步。
不再只是让数字人把准备好的内容说出来,而是让用户带着自己的问题,和它完成一次有来有回的互动。
所以,最近这轮更新把 xingyun3D 从「表演控制台」升级成了「数字人互动工作室」:接入新版 Agent SDK,增加文字与语音聊天、三轮情景对练和祝福创作,也重新整理了界面和会话控制逻辑。
这篇文章既介绍新版能玩什么,也拆开讲讲:一个看起来只是「聊天框加数字人」的页面,背后到底需要处理哪些工程问题。
项目地址:
https://github.com/likebeans/xingyun3D在线页面:
https://likebeans.github.io/xingyun3D/本文对应 2026 年 10 月 29 日更新。项目需要星云应用配置与可用额度,真实云端链路的验收进度见文末。
一、这次不是换个皮肤,而是换了一种使用方式
旧版的交互围绕「数字人有什么能力」展开,新版则围绕「用户想做什么」展开。
| 维度 | 上一版 | 这一版 |
|---|---|---|
| 主要用途 | 播报、动作和 SDK 能力演示 | 聊天、练习与祝福创作 |
| 内容来源 | 用户输入台词、预设脚本 | 用户请求与 Brain 生成的回答 |
| 输入方式 | 以文字和控制按钮为主 | 文字输入与麦克风语音输入 |
| 对话组织 | 表演脚本与播放控制 | 场景设定、轮次、点评及打断恢复 |
| 页面重心 | 舞台与开发者控制项 | 玩法导航、数字人舞台与对话工作台 |
这次最主要的变化,不是多加几个控制按钮,而是开始围绕具体场景组织输入、对话过程和结果。
聊聊今天:给用户一个容易开口的入口
新版提供「安慰我」「陪我吐槽」「给点建议」三个聊天入口,可以点选示例话题,也可以自由输入,或通过麦克风说话。
这三个入口的区别,不只是换一个标题,而是对回应方式提出不同要求。
安慰场景强调先回应感受;吐槽场景希望语气轻松,但不煽动攻击;建议场景则通过简短追问了解目标与限制,再给出可执行的下一步。
它们有一个共同的设计倾向:**回复尽量简短,一次只追问一个问题。**这些要求写在场景提示中,是对模型的引导,不是对回答效果的强制保证。
相比把一大段书面答案直接交给数字人朗读,我更希望这里的交流保留一点「轮到你说了」的空间。
陪我练练:让聊天有起点,也有终点
第二种玩法是三轮情景对练,内置「模拟面试」「练习提涨薪」「自我介绍」。
以提涨薪为例,页面依次给出三类表达提示:先摆出成果,再讲清诉求,最后留出协商空间。数字人通过场景指令扮演主管,围绕用户的回答继续交流。三轮结束后,用户主动点击「生成点评」,让它总结一个具体亮点和一个改进建议。
这里不追求生成一份看起来专业、却缺乏依据的百分制评分,而是先把练习过程做完整:知道自己在练什么,知道已经进行到哪一轮,最后能带走一条可以落实的建议。
面试和自我介绍也采用相同的组织方式,只是场景指令与提示内容不同。模型的具体追问可能变化,页面中的轮次与结束入口则由程序管理。
送句祝福:把内容生成与数字人表达接起来
第三种玩法是祝福创作,支持生日祝福、节日问候和加油鼓励。
例如,可以输入这样的请求:
给妈妈写一段生日祝福,感谢她一直支持我,语气自然一点,不要太像群发消息。
这是一个使用示例,不是实际云端对话记录。页面会把用户请求交给 Agent,接收生成的内容,并通过数字人播报链路呈现;用户还可以继续要求修改、复制完整正文,或者按原文重新播放。
其中,「重新播放」和「重新生成」是明确分开的。
重播使用已经完成的文本,不再请求模型改写,也不额外插入一条重复消息。这样,用户听到的才是刚刚认可的那一版内容,而不是模型又重新写了一份。
二、界面也从控制台变成了工作室
随着交互重心变化,页面重新组织成了三个区域:左侧选择玩法,中间展示数字人,右侧完成对话。
场景入口、当前目标、消息记录和输入框集中在对话工作台里。开始交流后,部分场景说明会自动收起,把空间留给真正发生的对话。
音量、积分查询、自定义播报和角色支持的动作等操作仍然保留,但收进了次级设置区域。用户不必先理解 SDK 的各种控制项,才能开始体验。
另外一个容易忽略的细节是未连接状态。
新版会展示静态人物预览和欢迎提示,只有真正初始化 SDK 后,才进入资源加载和连接流程。人物预览不等于真实数字人已经接通。
当前版本主要面向桌面浏览器,仓库记录了 1280×800、1440×900 和 1920×1080 的布局检查,保留亮暗主题和减少动态效果的适配。手机和平板布局不属于这一轮的完成范围。
三、底层改了什么:从驱动播报到接入 Agent
新版使用魔珐星云 Agent SDK 2.4.1 ,核心实例是 XingyunAvatarAgent。
在这个项目里,Brain 承接模型对话,ASR 处理语音识别,TTS 与数字人相关能力负责表达。前端通过 SDK 发起提问、管理收音、接收回答与播放事件,不在自己的 Node 服务里重新实现整套语音对话链路。
理解架构时,可以把它分成三层:
text
浏览器:xingyun3D
┌─────────────────────────────────────────────┐
│ scenes.js                                   │
│ 场景、开场指令、练习提示、点评要求            │
│                     ↓                       │
│ main.js                                     │
│ 消息、轮次、按钮状态、打断与恢复              │
│                     ↓                       │
│ sdk-agent.js                                │
│ 实例生命周期、调用封装、回调转发              │
│                     ↓                       │
│ XingyunAvatarAgent SDK 2.4.1                 │
└─────────────────────┬───────────────────────┘
                      │ 网络连接
                      ▼
            星云侧 Agent 与关联服务
             ASR / Brain / TTS / 数字人

可选的本地 Node 服务
└─ 静态文件 + /api/config + /api/consume
   不承担本项目的模型推理与语音生成
项目把场景、页面交互和 SDK 接入分开,但没有为此引入复杂的框架。
sdk-agent.js 是一层很薄的封装:管理实例,提供 ask()、speak()、startASR()、stopASR()、interrupt() 和 destroy(),再把必要事件交回页面。
这几个接口对应不同意图。ask() 用于请 Agent 生成回答;speak() 用于播报已经确定的内容;ASR 接口负责采集与识别的控制;destroy() 负责释放旧实例。祝福重播、固定开场和自由问答,不应该全部走同一条「重新生成」路径。
前端仍使用原生 HTML、CSS、JavaScript,Node 服务也只用内置模块,没有第三方 npm 运行依赖。
但需要区分:**没有 npm 依赖,不等于没有外部依赖,更不等于离线可用。**浏览器仍会加载星云 CDN 上的 SDK,对话、识别和数字人能力也依赖云端服务。
四、场景靠配置,流程靠程序,不把所有事情都交给模型
聊天、面试和祝福看起来是三类产品功能,但它们没有各自维护一套 SDK 接入代码。
场景定义集中在 public/scenes.js 中,包括场景标识、标题、开场指令、示例输入、练习提示和点评要求。页面选择场景后,再把对应指令交给 Agent。
真正重要的是:
模型负责怎么说,程序负责现在能做什么。
以三轮练习为例,模型被要求每次只问一个问题,并在第三次回答后收尾。但前端并不会通过解析模型说出的「这是第三题」来判断进度,而是根据用户提交的回答推进轮次。开场指令和点评请求,不算作用户的三轮回答。
文本发送失败时,代码还保留了回滚用户草稿、消息与轮次的处理,避免「请求没成功,进度却已经走了一轮」。这些状态变化不能只依赖模型记住规则。
这里的场景设定也是普通对话指令,不是某个强约束的 systemPrompt 接口。模型可能偏离预期,页面仍然需要维护清楚的完成条件和操作入口。
练习开场还接入了一个轻量的内容联动:固定播报中的 <uievent> 触发 show_text 提示卡。后续轮次提示直接由前端更新,不要求模型不断输出特殊标签。
这让项目保留了扩展空间:可以沿用现有结构配置新的三轮练习,但增加多轮动态流程、复杂评分或业务工具调用时,仍然需要相应开发,不能简单理解成「改一句提示词就什么都支持」。
五、真正费心的,是一轮对话的生命周期
SDK 初始化只是接入的起点。
实际交互更需要处理的是:事件什么时候到达,用户什么时候可以继续输入,失败和打断以后哪些状态还有效。
1. 模型生成完,不等于数字人说完
对于生成式对话,前端至少要区分三个节点:提问调用返回、LLM 文本生成完成、数字人播报完成。
它们不是同一件事,文本与音频相关事件也不能简单假定始终按照某一个固定顺序到达。因此,项目为当前轮次分别记录 llmDone 和 speechEnded。
下面是从现有实现提炼的状态逻辑,省略了界面更新和错误处理,不是独立运行示例:
javascript
// 开始一轮生成式对话时。
turn.llmDone = false;
turn.speechEnded = false;

// onLLMResponse 收到 done 时。
turn.llmDone = true;
if (turn.llmDone && turn.speechEnded) {
  finishTurn();
}

// onSpeakStateChange 收到 speak_end 时。
turn.speechEnded = true;
if (turn.llmDone && turn.speechEnded) {
  finishTurn();
}
它表达的是一个汇合条件,而不是要求「生成结束之后才开始播报」:
text
同一轮生成式对话
      │
      ├─ 文本事件:chunk ... done ───────→ llmDone
      │
      └─ 播放事件:start ... speak_end ──→ speechEnded
                                            │
                                     两个条件均满足
                                            ↓
                                       正常结束本轮
固定开场、自定义播报和原文重播不需要等待 LLM,自然采用不同的完成分支。异常和手动打断则走单独的清理与恢复路径。
祝福结果也按这个原则保存:只有收到 LLM 的 done 才更新最近一份完整祝福;如果 done 没有附带全文,就使用此前累计的分块内容。不能因为听到了播报结束,就把一段未完成文本当成最终作品。
2. 一段语音,只应该产生一次提交
正常连接中,项目开启 SDK 的 auto_send_asr_to_llm。语音最终识别结果由 SDK 自动送往对话链路,前端回调主要负责更新输入、记录消息和推进轮次,不再重复调用 ask()。
打断后的恢复会话有所不同:需要把前端保存的语境附到下一次请求中,因此关闭自动送问,改由前端提交最终识别结果。两种方式二选一,而不是同时生效。
实际代码中的关键分支是:
javascript
// 常规会话由 SDK 自动送问。
// 恢复会话改由前端携带语境提交。
if (!autoSendASR) {
  void askInContext(result.text.trim(), activeTurn);
}
否则,看起来只是「收到识别结果后顺手调用一下模型」,就可能让用户说一句话,却收到两次回答。
此外,「结束监听」不等于「最终识别已经返回」。页面会进入等待最终结果的状态,暂时阻止下一次输入;10 秒未收到最终结果时,再通过重建连接结束这次等待。麦克风启动操作也使用 attempt 标识,避免旧异步操作的失败误伤新操作。
3. 打断不是把 busy 改成 false
用户点击「打断一下」,希望的是当前声音停止,并且接下来能正常继续。
但从程序角度看,停止播放不代表云端生成已经取消,也不代表旧回调不会继续回来。如果直接把页面恢复为可输入,前一轮迟到的回答或结束事件,就可能污染下一轮。
当前版本采用保守的恢复策略:锁定输入,停止播放和必要的收音,销毁旧实例,再创建新实例。页面记录、练习进度和最近一份完整祝福会保留。
为了隔离旧回调,SDK 封装层在转发时核对实例归属。下面这段来自 sdk-agent.js:
javascript
const forward = (name, ...args) => {
  if (instance !== this.agent) return;

  const callback = this.callbacks[name];
  if (typeof callback === 'function') {
    callback(...args);
  }
};
销毁时先让旧实例失效,再等待清理完成:
javascript
const instance = this.agent;
if (!instance) return;

this.agent = null;
await instance.destroy();
这个顺序意味着:即使旧实例在异步销毁过程中还有回调到达,也不会继续被转发到页面。
页面层还使用 sessionGeneration 检查部分生命周期回调的代次,并在异步提问的成功或失败处理里核对会话与轮次。这些检查共同限制旧任务对新交互状态的影响,而不是只靠一个全局 busy 标志处理所有情况。
4. 重建的是连接,恢复的是语境
新实例并不天然继承旧实例的云端上下文。
项目会根据当前场景、保留的消息、练习进度和完整祝福组织一段恢复语境,在用户下一次真正提交时一起送出,而不是额外请求模型播报一段「正在为你恢复」。
这是一种应用层的语境补充,不是服务端会话的无损恢复,更不是持久化记忆。打断也不能保证取消已经开始的云端生成;重建会增加一次连接,实际延迟和额度消耗仍需要真实平台验证。
另外,切换场景与打断恢复的语义不同。切换场景或重新开始会清空本次记录并重建实例,避免把上一场面试的语境带进下一场祝福创作。
六、怎样把新版跑起来
项目当前建议使用 Node.js 24,要求 Node.js 22 或更高版本。开始前,需要准备支持新版 Agent 的星云应用,选择角色和音色,配置 Brain、ASR、TTS,并确认有可用额度。
本地启动不复杂:
bash
git clone https://github.com/likebeans/xingyun3D.git
cd xingyun3D
cp .env.example .env
编辑 .env,填写自己的应用凭证:
dotenv
XMOV_APP_ID=your_app_id
XMOV_APP_SECRET=your_app_secret
然后运行:
bash
npm start打开 http://localhost:3000。因为没有第三方 npm 依赖,不需要先执行 npm install;也可以先启动页面,再从设置面板填写凭证。
已有旧版配置的用户,要留意网关从 /user/v1/ttsa/session 切换到了 /user/v1/ttsa_v2/session。代码对已知旧默认地址做了兼容迁移,但自己的配置文件也应同步更新。
准备好 .env 后,也可以通过容器运行:
bash
docker compose up -d --buildGitHub Pages 则提供纯静态页面,访问者可以使用自己的演示凭证。静态部署不包含 Node 服务,因此没有本地服务提供的积分查询代理。
一个必须说明的凭证边界
当前项目在浏览器中初始化 SDK,因此实际用于会话的凭证最终会进入浏览器。
把凭证放进 .env,再通过 /api/config 返回页面,并不等于对访问者隐藏了凭证;将值构建进静态 config.js,也一样会公开。
公开演示应使用独立的受限应用,不要直接使用生产凭证。这里的「部署简单」,不应该被理解为已经具备生产级身份认证、租户隔离和密钥保护。
七、代码已更新,验证范围也要说清楚
这一轮不仅更新了玩法,还整理了仓库的检查与发布流程。当前 CI 配置覆盖 Node.js 22 和 24,本地可以运行:
bash
npm run check
npm test
检查内容包括脚本语法、Pages 配置构建、无凭证与假凭证的本地服务启动、配置接口、静态资源和预期错误响应。这些测试不会向星云发起真实云端会话。
仓库的开发记录还包含基于模拟 Agent 的浏览器验证:三轮练习与点评、祝福修改与原文重播、ASR 最终结果去重、打断重建,以及旧实例回调隔离等。
但这些不等于真实云端链路已经全部验收。
截至本次更新的仓库记录,真实网关请求仍受到账号积分不足的阻塞。Brain 的实际回答质量、真实麦克风识别与自动送问、TTS 和数字人播放,以及目标应用的真实并发表现,仍需要在额度可用后继续验证。
当前也没有把登录、历史会话持久化、长期记忆、自动语音抢话、录屏导出和云端分享算作已完成功能。它是一个逐步完善的桌面交互示例,不是已经打磨成熟的数字人 SaaS。
写在最后:比「让数字人动起来」更进一步
这次更新,我最想推进的不是给控制台多加几个按钮,而是让数字人围绕一个具体目的参与交互。
聊天需要给对方留出表达空间,练习需要进度和反馈,祝福创作需要修改、保存与重播。落到代码里,就会遇到生成与播放的完成条件、语音提交去重、旧回调隔离,以及打断之后的状态恢复。
这些部分没有数字人形象那么显眼,却决定了页面能否从「展示能力」向「完成一次互动」迈进。
xingyun3D 这次提供的,就是这样一份尽量轻量、也把实现细节摊开的参考。
对数字人 Web 接入、语音 Agent 或场景化对练感兴趣的开发者,可以从 scenes.js、sdk-agent.js 和 main.js 开始阅读:先看场景如何配置,再看 SDK 如何接入,最后看一次交互如何开始、结束,以及被打断。
项目地址:https://github.com/likebeans/xingyun3D
在线页面:https://likebeans.github.io/xingyun3D/
欢迎 Star、提交 Issue,或把你希望尝试的场景带进来一起完善。