一、引言
传统大数据体系通常把数据分析拆成多层链路:业务数据进入消息队列,经 Flink、Spark、Hive、湖仓或数仓加工,再由报表系统查询。这个架构适合离线批处理和复杂数据治理,但当业务希望"秒级看到结果"时,链路延迟、查询延迟和运维复杂度都会变成问题。
OLAP 查询和 OLTP 查询的访问模式差异很大。OLTP 查询通常读写少量行,追求事务一致性和毫秒级单点读写;OLAP 查询则经常扫描数亿、数十亿甚至更多行,执行过滤、聚合、分组、排序、窗口函数等复杂计算。
ClickHouse 的出现,正是为了在"数据规模很大、查询需要很快、写入持续发生、分析维度灵活"的场景中,提供一个专门面向分析负载的数据库系统。ClickHouse 定义为用于 OLAP 的高性能列式 SQL DBMS,实时分析查询场景下常常对数十亿行执行亚秒级查询。
sql
             +------------------+
             |   业务系统日志    |
             |  App / Web / API |
             +---------+--------+
                       |
                       v
             +------------------+
             | Kafka / Pulsar   |
             | 实时数据总线      |
             +---------+--------+
                       |
             +---------+----------+
             |                    |
             v                    v
       +-------------+      +-------------+
       | Flink/Spark |      | Batch ETL   |
       | 实时清洗聚合 |      | 离线加工     |
       +------+------+      +------+------+
              |                    |
              +---------+----------+
                        v
               +----------------+
               |  ClickHouse    |
               | 实时 OLAP 存储  |
               +-------+--------+
                       |
        +--------------+--------------+
        |                             |
        v                             v
  BI 报表 / Dashboard           Ad-hoc SQL 分析
  用户画像 / 漏斗分析            日志检索 / 指标分析
二、核心架构原理
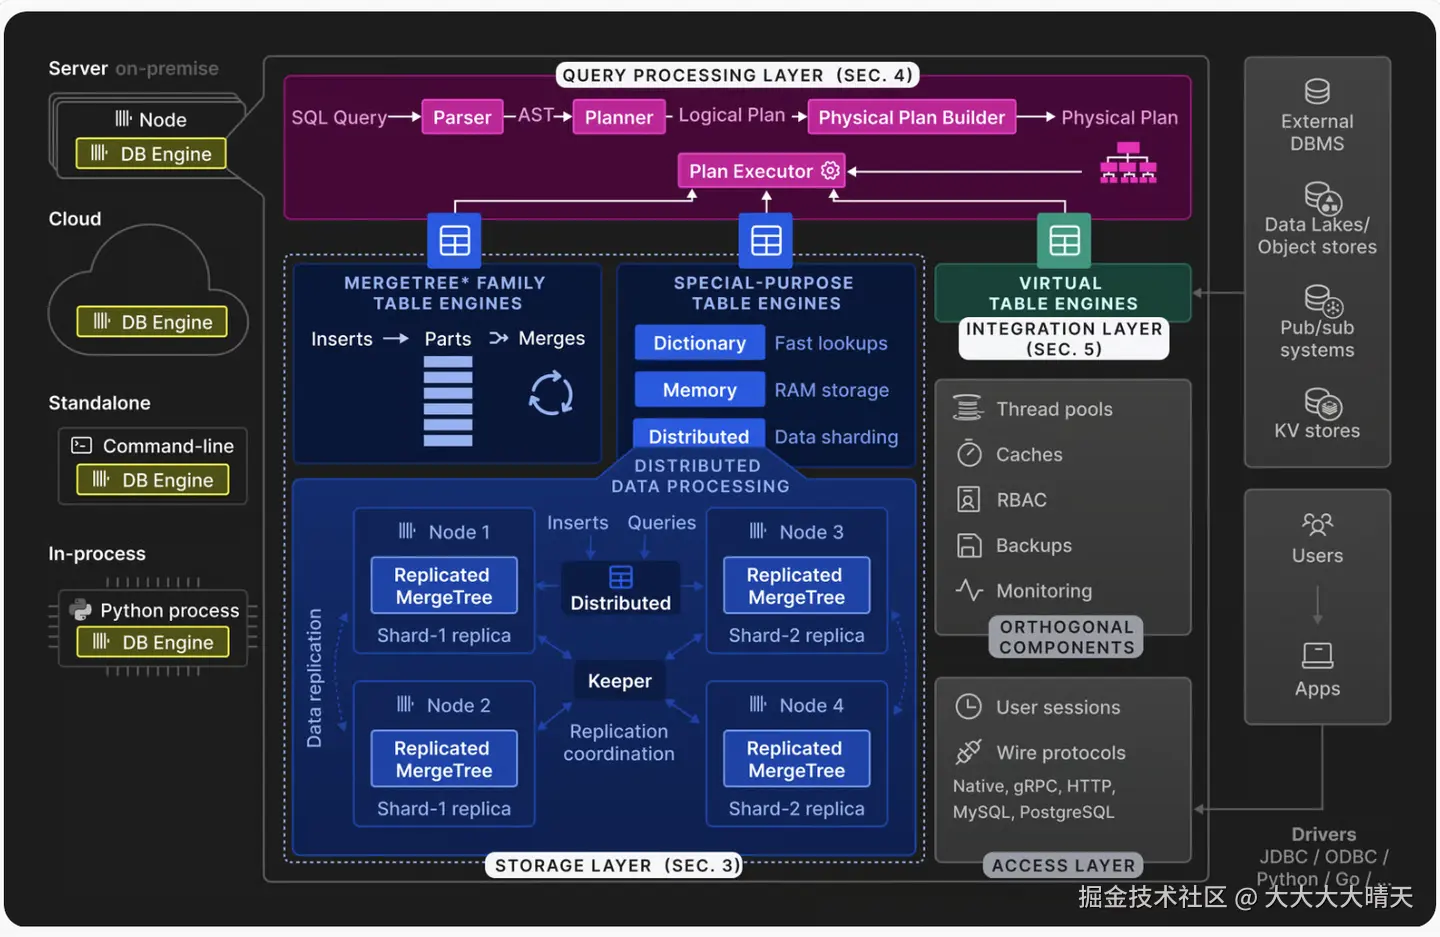
ClickHouse 的第一性原理是:面向分析负载优化,而不是面向事务负载优化。它把数据按列组织,查询执行时以数据块和列向量为单位处理,尽量减少无关数据读取,并充分利用 CPU、内存和磁盘吞吐。
ClickHouse 是"真正的面向列 DBMS",数据按列存储,并在执行过程中以数组、向量或数据块形式处理;只要可能,操作会分派到数组上,而不是逐行处理,这被称为向量化查询执行。
1.列式存储
行式数据库把一行的多个字段连续存储,适合"按主键查一整行"。列式数据库把同一列的数据连续存储,适合"只读少量列并做聚合"。列式布局会让恢复单行变得更困难,但过滤、聚合等列操作比行式数据库快得多。
sql
行式存储 Row Store
+------------------------------------------------+
| row1: uid, time, city, device, amount, status |
| row2: uid, time, city, device, amount, status |
| row3: uid, time, city, device, amount, status |
+------------------------------------------------+
适合:按 uid 查询完整订单、事务写入、点查点改

列式存储 Column Store
+---------+---------+----------+----------+----------+
| uid 列  | time 列 | city 列  | amount列 | status列 |
+---------+---------+----------+----------+----------+
适合:WHERE city = '上海' GROUP BY device SUM(amount)
假设一张宽表有 100 列,而查询只需要city 、device 、amount 三列。行式存储往往需要读入大量无关字段;列式存储只读取查询涉及的列,磁盘 I/O、内存拷贝和 CPU 解码成本都会下降。ClickHouse 官方示例显示,一个查询从超过 100 个现有列中选择并过滤少数列,能在毫秒级处理 1 亿行数据;当然,官方示例属于演示环境结果,实际性能会受机器、数据分布、压缩编码和查询条件影响。
2.向量化执行
很多数据库系统早期以"逐行解释执行"为主,一次处理一行数据。ClickHouse 更倾向于一次处理一批数据,也就是Block 。Block 是内存中表的一个子集,本质上是一组三元组:列数据、数据类型和列名;查询执行时以Block为单位处理。
ini
传统逐行思路
for row in rows:
    if row.city == '上海':
        sum += row.amount

ClickHouse 更接近批量列处理
city_vector   = [北京, 上海, 上海, 深圳, ...]
amount_vector = [  10,   20,   15,   30, ...]
mask          = city_vector == '上海'
sum           = aggregate(amount_vector filtered by mask)
向量化执行的优势在于减少函数调用和解释开销,并更容易利用 CPU 缓存和 SIMD 能力。向量化查询执行更容易利用 CPU 的 SIMD 能力,ClickHouse 使用向量化查询执行,并对运行时代码生成提供有限支持。
3.MergeTree 引擎
如果说列式存储解决"读哪些列"的问题,MergeTree 解决的则是"数据如何组织、索引、写入和合并"的问题。MergeTree 家族是 ClickHouse 中最常用、最稳健的表引擎,专为高写入速率和海量数据而设计;插入会创建表 parts,后台进程再把 parts 与其他 parts 合并。
sql
INSERT 批量写入
      |
      v
+------------+    +------------+    +------------+
| Part_001   |    | Part_002   |    | Part_003   |
| 按主键排序  |    | 按主键排序  |    | 按主键排序  |
+-----+------+    +-----+------+    +-----+------+
      \                 |                 /
       \                |                /
        v               v               v
          +---------------------------+
          | 后台 Merge 合并更大 Part   |
          +-------------+-------------+
                        |
                        v
          +---------------------------+
          | 查询按分区、主键、索引裁剪 |
          +---------------------------+
MergeTree 的几个核心点值得记住:
| 机制 | 作用 |
|---|---|
| ORDER BY 排序键 | 决定每个 part 内部的数据排序方式 |
| 主键稀疏索引 | 索引不是指向单行,而是指向粒度块,默认粒度常见为 8192 行 |
| 分区 | 通过分区表达式组织数据,查询条件满足时可裁剪分区 |
| 后台合并 | 小 part 合并成大 part,提高查询和存储效率 |
| 数据跳过索引 | 为某些表达式存储统计信息,查询时跳过不可能命中的数据块 |
MergeTree 的主键并不是引用单独的行,而是引用由 8192 行组成、称为粒度的块;这种设计让海量数据集的主键足够小,通常可以加载在主存中,同时仍能快速访问磁盘数据。
4.分布式架构
ClickHouse 可以部署成单机,也可以部署成集群。集群通常由多个 shard 组成,每个 shard 可以有多个 replica。分片用于水平扩展容量和计算能力,副本用于高可用和故障恢复。
sql
ClickHouse Cluster
+--------------------------------------------------+
|                    Distributed Table             |
|              查询入口 / 逻辑分发表               |
+------------------------+-------------------------+
                         |
       +-----------------+------------------+
       |                                    |
       v                                    v
+--------------+                    +--------------+
| Shard 1      |                    | Shard 2      |
| +----------+ |                    | +----------+ |
| | Replica1 | |                    | | Replica1 | |
| +----------+ |                    | +----------+ |
| +----------+ |                    | +----------+ |
| | Replica2 | |                    | | Replica2 | |
| +----------+ |                    | +----------+ |
+--------------+                    +--------------+
需要注意,ClickHouse 集群并不是自动弹性再平衡的系统。ClickHouse 集群由独立 shards 组成,每个 shard 又由多个副本组成;添加新 shard 后,数据不会在 shards 之间自动重新平衡,通常需要接受集群负载不均衡,或自行规划迁移策略。这对生产容量规划很重要:分片数、分片键、历史数据迁移和冷热数据策略要提前设计。
三、功能特性
| 特性 | 说明 | 适合解决的问题 |
|---|---|---|
| 列式存储 | 同一列连续存储,只读查询需要的列 | 宽表聚合、指标统计、扫描分析 |
| 向量化执行 | 以数据块和列向量为单位执行 | 降低逐行处理开销,提高 CPU 利用率 |
| MergeTree | 高吞吐写入、后台合并、稀疏索引 | 海量明细数据存储与分析 |
| 分区裁剪 | 按时间或业务维度分区 | 降低历史数据扫描范围 |
| 数据压缩 | 同列数据类型相似,压缩比通常较好 | 降低存储成本和 I/O |
| SQL 支持 | 支持常见 SQL 子句、JOIN、窗口函数等 | 降低工程使用门槛 |
| 近似计算 | 提供近似去重、分位数等能力 | 在性能和精度间做取舍 |
| 分布式查询 | 多节点并行处理 | 水平扩展存储和查询能力 |
ClickHouse 支持基于 SQL 的声明式查询语言,很多情况下与 ANSI SQL 标准相同,并支持GROUP BY 、ORDER BY、子查询、JOIN 、IN 、窗口函数和标量子查询等能力。ClickHouse 提供近似计算能力,例如近似 distinct、中位数和分位数,以及对样本数据运行查询以快速得到近似结果。
四、为什么 ClickHouse 快
ClickHouse 的性能优势可以概括为一句话:它把 OLAP 查询中不必要的数据读取、不必要的逐行处理、不必要的磁盘 I/O 和不必要的网络传输尽量减少。
yaml
一次典型 ClickHouse 查询的加速路径

SQL
 |
 v
解析 AST
 |
 v
查询分析与优化
 |
 v
根据分区键 / 主键 / 跳过索引裁剪数据
 |
 v
只读取需要的列
 |
 v
按 Block 做向量化计算
 |
 v
局部聚合 / 远端预处理
 |
 v
合并结果并返回
举一个行为日志表的例子:
vbnet
SELECT
    event_name,
    count() AS pv,
    uniqExact(user_id) AS uv
FROM events
WHERE event_date >= '2026-09-01'
  AND event_date <  '2026-10-01'
  AND app_id = 1001
GROUP BY event_name
ORDER BY pv DESC
LIMIT 20;如果表按月份分区,并以(app_id, event_date, event_name) 作为排序键,ClickHouse 可以先跳过无关月份分区,再利用主键范围减少读取范围,最后只读取event_name 、user_id 、event_date 、app_id 这些必要列。这个过程和行式数据库全量读取宽行再过滤的方式有本质差异。
但这里也有一个容易误解的点:ClickHouse 快,并不等于任何 SQL 都快。排序键设计不合理、分区过细、查询条件无法命中主键前缀、JOIN 数据量过大、单条查询占用内存过多、写入小批次过多,都会让性能下降。
五、适用场景
ClickHouse 最适合的场景通常有几个共同特征:数据量大、写多读多、更新少、查询以过滤聚合为主、结果集相对较小、对延迟敏感。
| 场景 | 典型数据 | 为什么适合 |
|---|---|---|
| 实时数据看板 | PV、UV、GMV、订单量、转化率 | 持续写入,按时间窗口聚合 |
| 用户行为分析 | 点击、曝光、停留、搜索、支付事件 | 明细量大,查询维度多 |
| 日志分析 | 服务日志、Nginx 日志、审计日志 | 追加写入,按条件过滤检索 |
| 可观测性 | Metrics、Logs、Traces | 高吞吐写入,按时间和标签聚合 |
| 广告分析 | 展示、点击、消耗、转化 | 多维聚合和报表分析 |
| IoT 时序分析 | 设备指标、传感器数据 | 时间序列追加写入,聚合多 |
| 数仓加速层 | Hive/Iceberg/湖仓明细加速 | 面向报表和交互式分析 |
ClickHouse 既可以作为主数据存储,可以作为分析层,也可以对持续更新的事件流读取数据,并对数十亿行执行亚秒级查询。
六、不适用场景
| 不建议场景 | 原因 |
|---|---|
| 高频单行更新 | ClickHouse 更适合追加写入和批量变更 |
| 强事务业务主库 | OLTP 的事务、锁、约束和点写不是它的核心优势 |
| 小数据低并发系统 | 复杂度可能高于收益 |
| 大量随机点查 | 列式 OLAP 不以单行低延迟点查为核心目标 |
| 复杂多表强一致事务 | 设计目标与事务型数据库不同 |
| 任意全文检索 | 可做部分日志检索,但不等于专用搜索引擎 |
如果业务主要是"按订单号查一条记录并频繁更新状态",优先考虑 OLTP 数据库。如果业务主要是"按天、地区、渠道、设备聚合最近 90 天指标",ClickHouse 才更匹配。
七、部署与使用
ClickHouse 支持多种部署方式:本地包安装、Docker、自建集群、Kubernetes Operator、ClickHouse Cloud 等。入门体验推荐用 Docker,生产环境则要结合数据规模、SLA、运维能力和团队经验选择。
bash
docker pull clickhouse/clickhouse-server

docker run -d \
  --name clickhouse-demo \
  -p 18123:8123 \
  -p 19000:9000 \
  -e CLICKHOUSE_PASSWORD=changeme \
  --ulimit nofile=262144:262144 \
  clickhouse/clickhouse-server

//连接客户端
docker exec -it some-clickhouse-server clickhouse-client

//使用 HTTP 接口
echo "SELECT 'Hello, ClickHouse!'" | \
curl 'http://localhost:8123/?query=' -s --data-binary @-
ClickHouse 的表设计通常比 SQL 语法更关键。一个糟糕的排序键可能让查询退化成大范围扫描;一个过细的分区策略可能制造大量 part,增加后台合并压力。
- 排序键设计:排序键优先考虑查询中的高频过滤条件,而不是机械地把所有字段塞进去。一般经验是:租户、应用、业务线、时间、核心维度字段可以进入排序键,但顺序要结合查询模式。
vbnet
查询模式:
WHERE app_id = ?
  AND event_date BETWEEN ? AND ?
  AND event_name = ?

推荐排序键:
ORDER BY (app_id, event_date, event_name, user_id)

不推荐:
ORDER BY (user_id, city, amount)
因为它无法优先帮助 app_id + event_date 的范围裁剪
ClickHouse 会按主键排序数据,因此数据一致性越高,压缩效果越好;较长主键会对插入性能和内存消耗产生负面影响,但主键中的额外列不会影响 ClickHouse 在SELECT 查询期间的性能这一点需要结合上下文理解,它指的是额外列本身不会降低查询性能,但排序键设计仍会影响数据读取范围。
- 分区设计:分区常见选择是按月、按天或按业务大类加时间。大多数日志、事件、指标数据可以从按月或按天开始,数据量特别大时再细化。不要把用户 ID、订单 ID、设备 ID 这类高基数字段直接作为分区键。
sql
较合理:
PARTITION BY toYYYYMM(event_date)

高数据量场景可考虑:
PARTITION BY (toYYYYMM(event_date), app_id)

通常不推荐:
PARTITION BY user_id
PARTITION BY order_id
PARTITION BY city + user_id分区不会加速查询,这一点不同于ORDER BY 表达式;不要使用粒度过细的分区方式,也不要按客户端标识符或名称分区,而应将这类字段作为ORDER BY 表达式中的第一列。
- 写入方式:ClickHouse 更喜欢批量写入。大量小批次 INSERT 会产生很多小 part,增加后台 merge 压力,进而影响查询和写入稳定性。实际生产中,常见方式是通过 Kafka、Flink、Spark、DataX、Airbyte 或自研同步程序批量写入。
yaml
业务埋点 / 日志
      |
      v
 Kafka Topic
      |
      v
 Flink 清洗维表关联
      |
      v
 批量写入 ClickHouse
      |
      v
 MergeTree parts 后台合并
写入端要重点关注批大小、失败重试、幂等策略、去重需求、乱序数据、字段类型变更和延迟容忍度。ClickHouse 可以通过 ReplacingMergeTree 等引擎处理部分去重或最终替换语义,但这不是传统事务数据库的实时 upsert 语义。
八、常见问题
- ClickHouse 能不能替代 Hive 或湖仓
不能简单替代。Hive、Iceberg、Hudi、Delta Lake 更偏数据湖、离线数仓、开放存储格式和批处理生态;ClickHouse 更偏交互式 OLAP 查询和实时分析服务。更常见的做法是湖仓保存全量明细和长期历史,ClickHouse 承接热数据、宽表、聚合加速和查询服务层。
- 为什么查询没有预期快
最常见原因不是 ClickHouse 不快,而是数据组织和查询模式没有对齐。比如查询条件没有命中排序键前缀、分区过细或过粗、扫描列太多、聚合基数太高、JOIN 右表太大、并发过高、磁盘 I/O 成为瓶颈。
markdown
1. WHERE 条件是否包含分区键
2. WHERE 条件是否命中 ORDER BY 前缀
3. SELECT 是否读取了过多大字段
4. GROUP BY 基数是否过高
5. 是否存在大量小 part
6. 是否发生内存溢出或外部排序
7. 是否是分布式查询导致网络瓶颈- ClickHouse 主键是不是唯一约束
不是。MergeTree 的主键主要用于排序和稀疏索引,不是传统关系数据库里的唯一约束。ClickHouse 不要求主键唯一,可以插入多行具有相同主键的数据。
- 为什么不建议过细分区
过细分区会产生大量目录、part 和元数据,后台合并压力上升,查询规划和维护成本增加。ClickHouse 的查询加速主要依赖排序键、稀疏索引、数据跳过索引和列裁剪,而不是把分区切得越碎越好。大多数情况下不需要分区键;即使需要分区,分区键通常也无需细于按月分区。
- ClickHouse 是否支持高可用
支持,但需要理解它的粒度。ClickHouse 使用异步多主复制方案;写入任何可用副本后,其他副本会在后台获取其副本,系统在不同副本间保持相同数据,多数故障后的恢复是自动的,复杂情况下为半自动。
在生产环境中,高可用通常不只是建 ReplicatedMergeTree,还包括 Keeper/ZooKeeper 规划、分片副本拓扑、负载均衡、备份恢复、监控告警、磁盘容量和故障演练。
九、小结
sql
+------------------------------------------------------+
|                    ClickHouse                        |
+------------------------------------------------------+
| 定位                                                 |
|   高性能列式 SQL OLAP 数据库                         |
+------------------------------------------------------+
| 核心机制                                             |
|   列式存储 + 向量化执行 + MergeTree + 稀疏索引        |
+------------------------------------------------------+
| 数据组织                                             |
|   Partition -> Part -> Granule -> Column Files        |
+------------------------------------------------------+
| 查询优化                                             |
|   分区裁剪 -> 主键范围 -> 跳过索引 -> 列裁剪 -> 聚合   |
+------------------------------------------------------+
| 部署形态                                             |
|   单机 / 分片 / 副本 / 分布式表 / 云服务              |
+------------------------------------------------------+
| 适用场景                                             |
|   实时分析 / 日志分析 / 可观测性 / 用户行为 / 报表    |
+------------------------------------------------------+
| 不适合                                               |
|   高频单行更新 / 强事务主库 / 大量随机点查             |
+------------------------------------------------------+