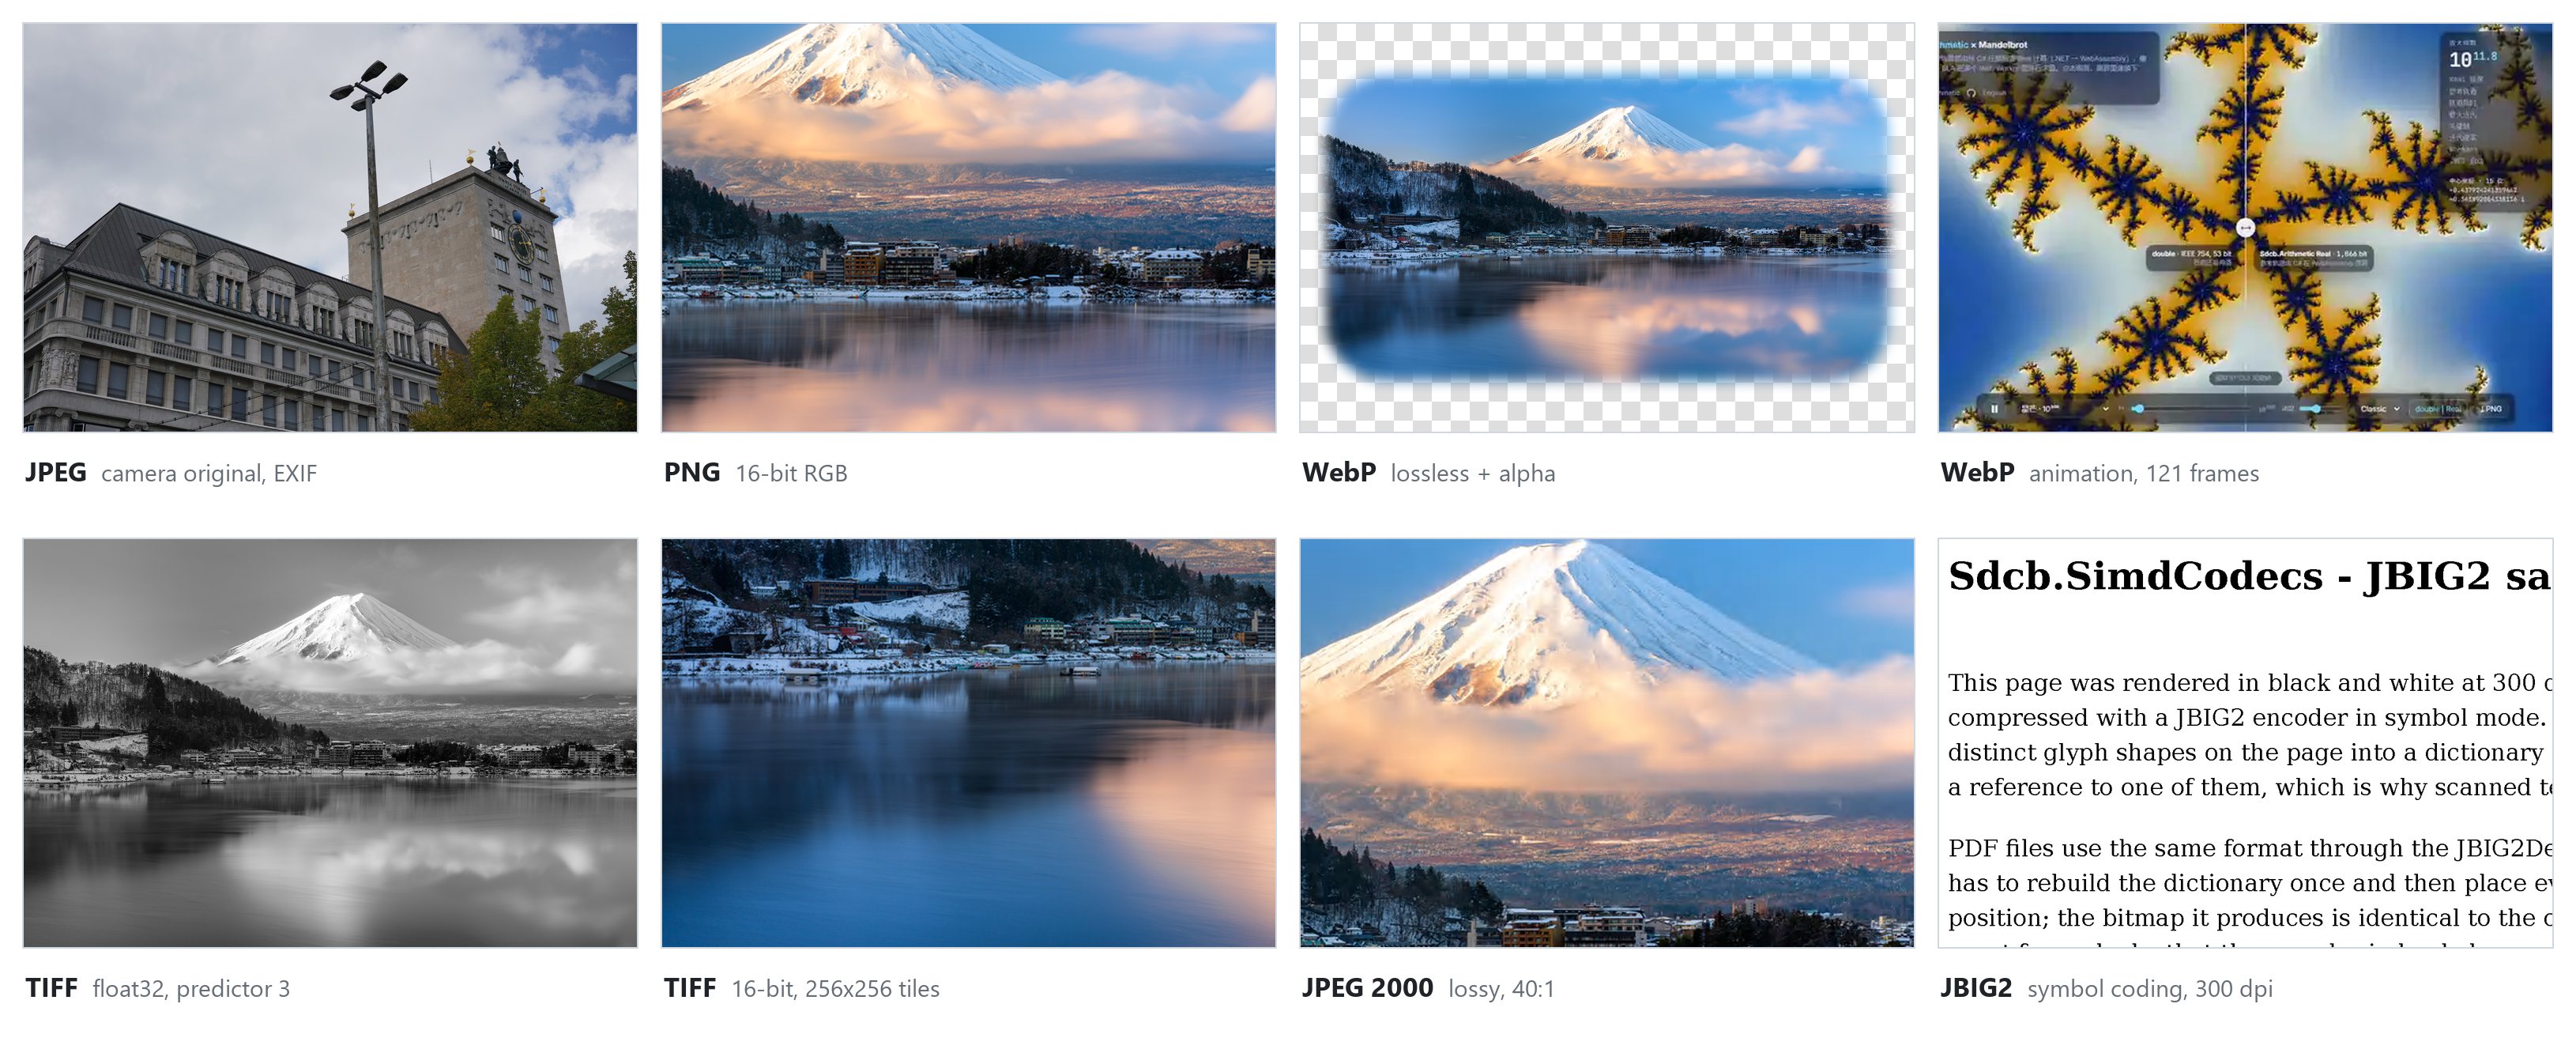
上面这张拼图里的每一格,都是我刚开源的新项目 Sdcb.SimdCodecs 解码出来的:JPEG、PNG、WebP、TIFF、JPEG 2000、JBIG2,一个原生库都没用,纯 C#。
先说结论:在 446 张 JPEG 上,它的解码耗时是 libjpeg-turbo 的 0.82 倍 ,每次解码的托管内存分配是 0 字节;JPEG 编码、PNG 编解码、WebP 解码,也都追平或超过了对应的原生库。MIT 协议,能 NativeAOT,也能编译成 WebAssembly 在浏览器里跑。

bash
dotnet add package Sdcb.SimdCodecs一个包,十种格式
| 格式 | 解码 | 编码 | 说明 |
|---|---|---|---|
| JPEG | ✅ | ✅ | baseline / progressive、CMYK、1/2--1/8 缩放解码;编码支持优化 Huffman 和 progressive |
| Ultra HDR JPEG | ✅ | ✅ | 增益图读取、组装和 HDR 重建 |
| PNG | ✅ | ✅ | 1--16 位全部位深、调色板、Adam7、HDR 标记 |
| WebP | ✅ | --- | 有损、无损、alpha、动画,输出与 libwebp 逐字节一致 |
| GIF | ✅ | ✅ | 动画及跳转;编码支持 Wu 量化 + 抖动(相比上游新增) |
| TIFF | ✅ | ✅ | 多页、8/16/32 位整数和浮点、CCITT G3/G4 传真 |
| JPEG 2000 / JBIG2 | ✅ | --- | PDF 里的 /JPXDecode 和 /JBIG2Decode |
| EXIF / ICC | ✅ | ✅ | 读写 EXIF;读取和写入 ICC 配置文件 |
其中不少格式,浏览器自己都打不开。比如下面这张只有 4.3 KB 的 JBIG2 扫描页,你的浏览器显示不了,SimdCodecs 编译成 WebAssembly 之后,在浏览器里 49 ms 就解出来了:

用法上,门面类 SimdCodecs 根据文件头自动识别格式:
csharp
using Sdcb.SimdCodecs;
using Sdcb.SimdCodecs.Abstractions;
using Sdcb.SimdCodecs.Jpeg;

byte[] file = File.ReadAllBytes("photo.webp");   // JPEG、PNG、TIFF、WebP、GIF、JPEG 2000 或 JBIG2

// 识别格式,解码到你自己的缓冲区(R G B A)
if (!SimdCodecs.TryReadInfo(file, out ImageInfo info)) throw new InvalidDataException("Not a supported image");
byte[] rgba = new byte[info.Width * info.Height * 4];
SimdCodecs.TryDecodeIntoRgba8(file, rgba);

// 编码成 JPEG
byte[] jpeg = JpegEncoder.Encode(rgba, info.Width, info.Height, channels: 4, new JpegEncodeOptions { Quality = 90 });
File.WriteAllBytes("photo.jpg", jpeg);
我个人最喜欢的是 TryDecodeInto(file, buffer, stride, format):它可以按任意行跨度,直接把像素写成 BGRA(WPF、SkiaSharp)、BGR(OpenCV)或者灰度(OCR)。JPEG 和 PNG 是在解码过程中直接输出这些布局的,不需要先解出一整帧 RGBA 再转换;彩色 JPEG 要灰度,直接给的就是它的 Y 平面。
为什么又要造一个轮子
在 .NET 里读一张图,选择其实不多:
System.Drawing:只能在 Windows 上用;- SkiaSharp、OpenCvSharp:好用,但都带原生库,换个平台、上 NativeAOT 或者 WebAssembly,就得折腾一番;
- ImageSharp:纯托管,跨平台,这几年几乎是"纯 .NET 处理图片"的唯一答案。
看到这里,肯定有人要问:都有 ImageSharp 了,为什么还要 SimdCodecs?
这个问题我必须正面回答,因为 ImageSharp 恰恰是我做 SimdCodecs 的起因之一。
先说清楚,我一直挺佩服 ImageSharp 的。一个纯 C# 的图像库,能做到格式全、API 好用、多年持续维护,非常不容易。Six Labors 后来改用需要授权的许可证,我也理解:开源项目要活下去,总得有收入。
问题出在我自己的处境上。这段时间我连着做了 SimdPaddleOCR 和 SimdGcDrNet,它们最大的卖点就是"纯 .NET、不带原生库"。可模型总得先读图、预处理,要保持"纯 .NET",ImageSharp 就是绕不开的那个依赖。
license 其实不难申请,我也能申请到。但我写的是开源库:我申请了,用我库的人打开项目一编译,ImageSharp 3.2.0 和 4.x 照样要他们自己的 license key,否则编译不过。一个开源库,让下游每个用户都先去申请一份授权,这就很尴尬。
所以我只能一直卡在最后一个不需要 license key 的版本:3.1.12。偏偏就是这个版本,现在 dotnet list package --vulnerable 一跑,会报出 6 条安全公告,其中 4 条是高危;而修复它们的新版本,都要 license。

这就是我想要 SimdCodecs 的原因:纯托管、MIT、而且要快。不是"能用就行"的快,而是敢拿出来和 libjpeg-turbo、libpng、libwebp 正面比的快。
也要说清楚 SimdCodecs 不是什么:它只做编解码,不做缩放、裁剪、画字、滤镜这些图像处理,这些 ImageSharp 依然做得很好。如果你的项目本来就在用 ImageSharp,并且 license 不是问题,完全没必要换。SimdCodecs 解决的,是"只想把图读进来、写出去,而且要快、要干净"的那部分需求。
站在谁的肩膀上
SimdCodecs 不是从零开始的,它派生自 SharpAstro/Codecs。这个项目以 Unlicense 发布,JPEG 部分是从 stb_image 移植过来的,格式覆盖面不错,在这里先感谢一下原作者。
不过它的定位是"能跑"。以 JPEG 为例,接手时它的解码耗时差不多是 libjpeg-turbo 的 3 倍,编码速度只有后者的九分之一左右。我想把它推到"世界级",第一件事却不是优化,而是清点来源。
上游还带着 JPEG XR、JPEG XL 和 OpenEXR 三种格式,但它们是从 jxrlib 和 jxl-oxide 移植过来的,不满足我对 clean room 的要求,所以我把它们整个删掉了。另外说一句:这几个格式我实测过,支持得其实很不全面,就算不管许可证"拿"过来,也没有多少实用价值,相当于白白踩坑。如果你也在找这几种格式的托管实现,建议别在这上面花时间。

SimdCodecs 给自己定的规则写在 AGENTS.md 里,不能商量:
- libjpeg-turbo、libpng、libwebp、ImageSharp 这些竞品,只能当黑盒二进制用:拿来跑分、对拍输出、生成测试数据,绝不阅读、反编译或转述它们的源码;
- 算法只来自 ITU-T / ISO 规范(T.81、T.88、T.800 等)、PNG 规范、RFC 6386 / RFC 9649 的正文、学术论文和 CPU 厂商手册;
- 来源不明的东西,代码、注释、测试图片,一律不进仓库。
正因为每个文件都是第一方写的,SimdCodecs 才能干干净净地用 MIT 协议发布,你拿去商用,不需要附带任何第三方声明。
顺便一提,SimdCodecs 里的 WebP 解码器,最早是我用 Devin 写出来的,已经以 PR #31 合并回了上游。
下面挨个说说调优过的四个格式。所有数据都是单线程、AMD Ryzen 7 5800X、.NET 10,测量代码和原始结果都在仓库的 benchmarks 目录下,可以自己复现。
JPEG 解码:105 美元,从 2.96 倍到 0.82 倍
JPEG 解码用 Claude Opus 5.5 花了 105 美元,是几个里单笔花费最多的。
接手时的基线:在 446 张 JPEG(各种采样方式、质量、尺寸,加上 6 张相机直出原图)上,解码耗时是 libjpeg-turbo 的 2.96 倍,连 ImageSharp(1.79 倍)都比它快。
优化之后:
| JPEG 解码到 RGBA,446 个文件 | 耗时 | 每次解码的托管内存分配 |
|---|---|---|
| libjpeg-turbo 3.2.0(原生) | 1.00× | --- |
| Sdcb.SimdCodecs | 0.82× | 0 B |
| ImageSharp 3.1.12 | 1.77× | 约 16 KiB,另加它自己分配的图像 |
要知道,libjpeg-turbo 是 C 写的,而它在 x86 上最核心的 SIMD 部分(IDCT、色彩转换、上采样)更是用 NASM 手写的汇编,是这个领域公认的天花板之一。一个纯 C# 的实现能跑到它的 0.82 倍耗时,这在几年前我是不敢想的。
快,但不是靠牺牲精度换来的。我先把 stb 移植过来的整数流水线换成了按 T.81 / T.871 定义的单精度浮点运算,然后才开始优化。结果:
- Y / CbCr 分量平面与双精度参考 IDCT 100% 一致(libjpeg-turbo 是 98.60% / 99.31%);
- 4:2:0 图片的 RGB PSNR 是 53.55 dB,libjpeg-turbo 是 52.37 dB;
- AVX2、SSE、ARM 的 AdvSimd、纯标量和 NativeAOT 下,输出逐位一致。

优化过程中踩的坑,全都记在 benchmarks/README.md 的 Lessons 一节里。挑两个 .NET 味最重的说说:
① Vector256.Min 没你想的那么便宜。 从 .NET 9 开始,Vector128/256.Min/Max 在浮点上遵循 IEEE 754-2019(要正确处理 NaN 和 ±0),ConvertToInt32 会做饱和转换,每一个都会展开成十条左右的比较加混合指令。输入不可能是 NaN 的地方,换成 MinNative、MaxNative、ConvertToInt32Native,就是一条指令。
② 一个 out 参数,拖慢了整个 Huffman 解码。 慢路径辅助函数用 out len 返回长度,结果调用方的局部变量在整个方法里都被钉在了栈上,Huffman 解码的关键依赖链上平白多了一次存储和重新加载。改成把多个值打包进返回值就好了。
这类问题都是靠 DOTNET_JitDisasm 直接看 JIT 生成的汇编找出来的,每个都值 5% 到 18% 的端到端提升。
JPEG 编码:57 美元,从九分之一到反超
编码这边起点更惨。上游用的是 stb_image_write 的移植,纯标量,q75 4:2:0 下大约 59 MP/s ;同样条件下 libjpeg-turbo 是 563 MP/s,差不多是它的 9.5 倍。
这一部分花了 57 美元 。我按 T.81、T.871 和 AAN 论文重写了整个编码器:浮点 AAN 正向 DCT 把量化折进缩放系数,8×8 块在 Vector256 寄存器里完成转置,每个块变换完马上熵编码,熵编码用 TZCNT 遍历非零系数的位掩码。
现在的成绩(MP/s,越大越快):
| 配置 | Sdcb.SimdCodecs | libjpeg-turbo | ImageSharp |
|---|---|---|---|
| q75 4:2:0 | 585 | 561 | 289 |
| q90 4:2:0 | 507 | 479 | 224 |
| q95 4:2:0 | 438 | 412 | 181 |
| q95 4:4:4 | 266 | 262 | 139 |
基础模式略快于 libjpeg-turbo;打开优化 Huffman 表之后,大约是它的 1.5 倍 ;progressive 模式是它的 1.15 到 1.4 倍。而且在相同质量参数下,文件小 0.2% 到 2.3% ,PSNR-Y 还高 0.004 到 0.09 dB。CI 里有一道门槛:PSNR-Y 不低于 libjpeg-turbo、体积不超过它的 1%,否则直接失败。

WebP 解码:投入最大、也最曲折的一个
WebP 比 JPEG 难得多:有损是 VP8 视频的帧内编码,无损是另一套完全不同的算法,再加上 alpha 和动画。所以它其实才是四个里我投入最大的。
故事是这样的。一开始,Devin 的 SWE-2 模型可以免费用,我就拿它从零开始撸,撸了很久。正确性没问题,输出和 libwebp 逐字节一致,但性能怎么也打不过 libwebp。
后来我换成 Claude Opus 5.5 接着撸,终于"打过"了 libwebp,这个版本也就是合回上游的那个 PR。正高兴着,却发现我拿来对比的 libwebp 来自 NuGet 上的一个原生包,里面的 libwebp.dll 跑的居然是标量代码 ,速度和官方 dwebp -noasm 差不多。拿它当对手,我们"快"了 15% 到 40%,其实是在欺负一个没开 SIMD 的对手。
于是重来:这次的对手,是我用官方 1.6.0 源码包、按发行版的方式(SSE2 / SSE4.1 运行时分派)编译的 libwebp,并且和官方 Windows 版的 dwebp 交叉核对过。面对开了 SIMD 的 libwebp,我们其实还慢一截。我又让 Opus 5.5 撸了 100 美元,这才真正赢了下来。
基线 vs 最终结果,1920×1080 解码到 RGBA,以 libwebp 1.6.0(开启 SIMD)为 1.00:
| 有损 | 有损 + alpha | 无损 | |
|---|---|---|---|
| 优化前 | 2.04× | 1.50× | 1.09× |
| 优化后 | 0.88× | 0.53× | 0.72× |
上表的"优化前",就是那个"打过了标量 libwebp"的版本。输出依然与 dwebp 逐字节一致。也要实话实说:在更接近照片内容、不带 alpha 的有损文件上,两者基本持平(0.87 到 1.13 倍)。
这件事给我的教训是:跑分之前,先确认对手是不是满血的。要赢,就赢带 SIMD 的那个。

PNG 编解码:投入最少的一个
PNG 是四个里花钱最少的,只用了 37 美元:格式本身简单,起点也没那么差,难度确实小一些。
接手时,解码耗时是 libpng 1.6 的 1.35 倍(照片类)和 1.14 倍(截图类),而且解码到 RGBA 的路径还不支持 Adam7 隔行图。Adam7 就是"隔行扫描"的 PNG:网速慢的年代,这种图在网页上会先出一个模糊的整体,再一遍遍变清晰。现在不常见了,但老网站、老素材里还有不少,读不了就是个实打实的缺口。这次把它补上了,而且比 libpng 快得多。现在:
| PNG 解码到 RGBA,1920×1080 | 优化前 ÷ libpng | 优化后 ÷ libpng |
|---|---|---|
| 照片类 | 1.35× | 0.61× |
| 截图类 | 1.14× | 0.25× |
| Adam7 隔行 | 不支持 | 0.11--0.64× |
编码在 optimal 档(zlib 级别 6),耗时是 libpng 的 0.29 到 0.99 倍,同时每个输出都会解码回来逐样本比对。
PNG 也有一个很典型的故事。第一版逐像素向量化的反滤波,对 3 字节一个像素的 RGB 图,每次写 4 字节(第 4 个字节原样写回)。结果下一个像素的 4 字节读取,正好从上一次写入的中间开始,CPU 的 store-to-load forwarding 失败,RGB 反而比标量代码更慢 了(9.9 → 12.5 ms),而读写对齐的 RGBA 快了 4 倍。改成每个像素只写它自己的 3 字节之后:2.5 ms。
还有一点要说清楚:PNG 的解压用的是 BCL 自带的 ZLibStream(底层是 zlib-ng),照片类 PNG 的大部分时间都花在解压上,这部分已经不是我们能调的了。

在浏览器里玩一下
同一套 C# 代码编译成 WebAssembly 之后,我做了一个 在线实验台,所有解码都在你的浏览器里完成,没有服务器参与。
浏览器打不开的。 多页 TIFF 加 G4 传真、32 位浮点 TIFF、JPEG 2000、只有 4 KB 的 JBIG2 A4 页面,浏览器自己都不认识,在这里都能直接看(截图见前文)。
图片里藏了什么。 相机 JPEG 的 EXIF、GIF 动画、带 alpha 的无损 WebP,文件里写着什么,一目了然:

JPEG 编码台。 调质量、切 4:2:0 / 4:4:4、切基线 / 优化 Huffman / 渐进,还能看放大 8 倍的误差图:

项目主页在 sdcb.ai/simdcodecs。
账本
最后把账算一下:
| 部分 | 花费 | 优化前 | 优化后 | 对手 |
|---|---|---|---|---|
| JPEG 解码 | 105 美元 | 2.96× 耗时 | 0.82× 耗时 | libjpeg-turbo 3.2.0 |
| JPEG 编码 | 57 美元 | 约 1/9.5 速度 | 1.04× 速度(q75) | libjpeg-turbo 3.2.0 |
| WebP 解码 | Devin(免费)+ Opus 5.5 多轮,最后一轮 100 美元 | 2.04× 耗时(有损) | 0.88× 耗时 | libwebp 1.6.0(SIMD) |
| PNG 编解码 | 37 美元 | 1.35× 耗时(照片),不支持 Adam7 | 0.61× 耗时,支持 Adam7 | libpng 1.6 |
光是这几笔就是 299 美元的 token(WebP 前期 Devin 和第一轮 Opus 的投入还不算在内),换来四个和原生库正面硬刚不落下风的编解码器。三年前,这得是一个团队好几个月的活。
还没做到的
也老实交代一下还没做到的地方(完整清单见 docs/known-gaps.md):
- TIFF、JPEG 2000、JBIG2、GIF 功能正确、有测试,但还没有调优,也还没有基准项目;
- 门面只管解码,编码请直接用各格式的包;门面也不提供 JPEG 缩放解码;
- 输入必须整个在内存里,暂时没有
Stream入口。
下一步,就是把剩下这几个格式也按同样的办法拉到原生库的水平:先建基准项目,再让数据说话。
再往后,我想挑战三个"硬骨头":HEIF、AVIF 和 JPEG XL。其中 HEIF 优先级最高,因为现在很多手机拍照默认就存成 HEIF,我自己的项目里,用户从安卓浏览器上传上来的图,就经常是这种格式。而目前在 .NET 里想读它,基本只能靠原生库。
不过这三个格式,每一个的复杂度都不比 JPEG、PNG、WebP 加起来低,这需要不少 token......

另外,许可证这关也要先过:AVIF 基于 AV1,是免版税的,规范也公开,最适合 clean room;JPEG XL 同样是免版税的,但 ISO 规范要花钱买;HEIF 最麻烦,HEIC 里的 HEVC 编码有专利池,就算代码全部自己写、用 MIT 发布,专利问题也绕不过去。具体怎么做,我还在研究。如果你在这方面有经验,欢迎在评论区指点。
最后
把 JPEG、PNG、WebP 这些"基础设施级"的编解码做到原生库的水平,以前是我不敢想的事。现在它是纯 C#、MIT 协议、能 AOT、能进浏览器,所有数据都摆在仓库里,欢迎来挑刺。
接下来,我会把 SimdPaddleOCR 和 SimdGcDrNet 里的图片读写都换成 SimdCodecs,彻底摆脱 ImageSharp。到那时,"纯 .NET"才算名副其实。
- GitHub:sdcb/SimdCodecs
- NuGet:
dotnet add package Sdcb.SimdCodecs - 在线实验台:sdcb.ai/simdcodecs/playground
交流
感谢阅读到这里,如果觉得 SimdCodecs 有用,欢迎去 GitHub 点个 Star ,也欢迎评论 和点赞,这是我持续创作的动力!

欢迎关注微信公众号 .NET骚操作 ,或者扫码加入 .NET骚操作 微信交流群:

(如果微信群二维码过期,请加入 .NET骚操作交流QQ群 :495782587 ;做图像和视觉相关开发的朋友,也欢迎加入 C#/.NET计算机视觉技术交流 QQ 群 :579060605)