前言
最近在排查一个服务内存缓慢泄漏的问题。上线观察内存曲线,发现进程的 RSS 一直在缓慢爬升,怎么看都不像是业务数据量涨上去的那种台阶式增长,而是那种"细水长流"的斜线,怎么等都不停,长时间跑下去眼看着就要顶到容器内存上限。
这个现象在监控上其实看得很明显,只是一直没有真的酿成大问题------因为业务迭代比较快,基本上每天都有部署上线,机器跟着重启,RSS 每次都被重置回基线,泄漏还没攒到顶就被重新拉回起点了。但这不代表问题不存在,把曲线往后画长一点结论很清楚:只要服务连续跑够长时间不重启,迟早会顶到容器内存上限,到时候不是 gunicorn 自己判定内存吃满开始杀 worker,就是被更底层的机制强杀------只是被频繁发版意外地往后拖延了而已。
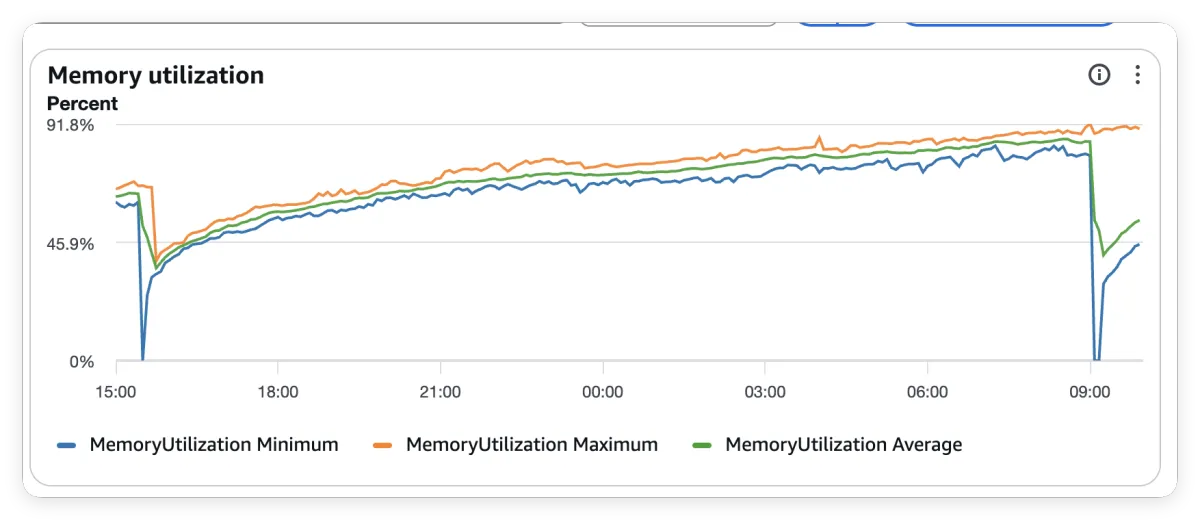
(配图占位:内存泄漏曲线图,RSS 随时间持续爬升、不收敛,长时间运行后逼近容器内存上限)
翻代码定位到是同事之前写的一段"素材富化"逻辑:用户上传一个素材,后台要调大模型做打标、分类,再算个 embedding 写进搜索索引。这块逻辑本身不快,又不想让它占用主线程的事件循环------毕竟主循环还要正常接请求,谁也不想因为一次大模型调用卡住整条服务,所以当时的思路是把这些活扔进一个专门的后台线程池去跑。这个思路本身没问题,问题出在线程池里具体怎么调用异步 SDK 这一层,埋了一个不容易被发现的坑。
记录一下这次排查、为什么这个客户端没法直接拿来复用,以及最后落地的方案。
一、原来的写法:线程池里再起一个事件循环
先看一下原来的代码长什么样,大概是这样的结构:
python
def submit_background_job(coro_func, *args, **kwargs):
    # 扔进线程池,不阻塞当前请求
    executor.submit(asyncio.run, coro_func(*args, **kwargs))

async def enrich_asset(asset_id: int):
    client = AsyncOpenAI(api_key=API_KEY, base_url=BASE_URL)
    resp = await client.chat.completions.create(...)
    ...
能想到这么写的理由也不难猜:主服务是个异步框架,但富化逻辑要调用外部大模型接口,又想继续用异步 SDK 的写法(重试、超时、流式都是 SDK 自带的,没必要自己再包一层同步版本)。于是选了一个很常见的组合:扔进线程池的每个线程里,用 asyncio.run() 单独跑一个事件循环,在这个循环里再去 await 异步 SDK。这样既不占用主服务的事件循环,又能继续用异步写法,看起来两头都占了。
二、代价:每次都要现造一个客户端
asyncio.run(coro) 干的事情是:新建一个事件循环,跑完这个协程,然后把这个循环销毁掉。也就是说,上面这段代码里,每调用一次 enrich_asset,就会经历一次"造一个全新循环 -> 用完就扔"的过程。
问题就出在 AsyncOpenAI(api_key=..., base_url=...) 这一行。这个客户端底层包了一个 httpx.AsyncClient,而 httpx.AsyncClient 内部维护的是一个真正的连接池 + SSL 握手上下文,这些东西是绑定在创建它时所在的那个事件循环上的。既然每次调用都是一个全新的循环,那这个客户端天然也就只能是一次性的------用完这次请求就没法再复用了,因为下次进来的请求,跑在的是另一个全新的循环上。于是代码里选择了一个"看起来最省心"的做法:每次现造一个就是了。
但 AsyncOpenAI 这个客户端只要构造出来,就会实打实地建立底层连接池(哪怕一次请求都没发出去)。每次现造一个、用完就丢给 GC,这个连接池和它占的 SSL 上下文理论上应该跟着这次事件循环一起被回收------但实测下来回收得并不干净。当时用 Datadog 拉了一次长周期(14 小时左右)的容器内存曲线做拟合,数据大概是这样:
| 指标 | 数值 |
|---|---|
| 14 小时整体内存增长斜率 | 约 393 MB/h |
| 14 小时累计净增内存 | 约 5.35 GB |
| 单实例峰值内存 | 约 13.4 GB(逼近 16GB 容器上限) |
跑了个简单的压测脚本反复调这条富化路径,内存曲线跟调用次数几乎是同步往上爬的,完全停不下来,跟业务数据量没有任何关系。这基本就实锤了:泄漏点就在这个"每次现造、从不复用"的客户端上,而且斜率算下来照这么跑下去,容器迟早要被这套逻辑自己吃满。
三、那为什么不直接复用这个客户端呢
看到"每次都现造一个客户端",肯定有人会问:那为什么不直接把这个客户端缓存起来,全局复用一份不就行了?
python
_client = AsyncOpenAI(api_key=API_KEY, base_url=BASE_URL)

async def enrich_asset(asset_id: int):
    resp = await _client.chat.completions.create(...)
...答案是:在现在这种调用方式下,它就是没法复用 。原因还是回到上一节那句话:AsyncOpenAI 内部的 httpx.AsyncClient 是绑定在构造它那一刻所在的事件循环上的。而这个服务里后台任务走的是 asyncio.run(),每调用一次 enrich_asset,跑的都是一个全新的、跟上次不是同一个的事件循环。哪怕把客户端存成一个全局变量,它也只能是在第一次调用那个循环上创建出来的------这个循环用完立刻就被销毁了,后面所有新开的循环,拿着这个"挂在一个已经死掉的循环上"的客户端去发请求,从底层机制上就是错的,不同事件循环之间的资源没法这样跨着用。
也就是说,"复用客户端"这件事的前提,是先有一个可以复用的事件循环。只要还是每次任务都现开一个用完就扔的循环,客户端就没有稳定的地方可以"挂",缓存不缓存都没有意义。
四、修复:不改业务代码,把线程池和事件循环绑死、长期复用
这次修复给自己定的前提是:不去动 enrich_asset 这段业务逻辑本身 ------它内部怎么调大模型、怎么处理结果都不改,只在它外面这一层"怎么被执行"上做文章。既然客户端要绑定在一个固定的事件循环上才能被安全复用,那思路就该倒过来:不要每次任务都造一个用完就扔的循环,而是给线程池里的每个线程分配一个长期存活的事件循环,所有派到这个线程上的任务,都跑在同一个循环里。
具体做法是用线程本地存储(threading.local)给每个 worker 线程保存一个持久化的 asyncio.Runner(Python 3.11+ 提供的持久化事件循环封装,效果等价于自己维护一个不销毁的 event loop):
python
import threading
import contextvars
from concurrent.futures import ThreadPoolExecutor

_state = threading.local()  # 每个线程自己的 .runner

def _get_runner() -> "asyncio.Runner":
    runner = getattr(_state, "runner", None)
    if runner is None:
        runner = _state.runner = asyncio.Runner()
    return runner

def _run_on_worker_loop(ctx, coro_fn, args, kwargs):
    return _get_runner().run(coro_fn(*args, **kwargs), context=ctx)

executor = ThreadPoolExecutor(max_workers=4, thread_name_prefix="bg-worker")

def submit(coro_fn, *args, **kwargs):
    ctx = contextvars.copy_context()
return executor.submit(_run_on_worker_loop, ctx, coro_fn, args, kwargs)这样一来,同一个线程上跑的每一次任务,用的都是同一个事件循环。有了这个前提,客户端缓存才真正立得住:
python
_clients = {}  # (id(loop), api_key, base_url) -> client

def get_client(api_key: str, base_url: str):
    loop = asyncio.get_running_loop()
    key = (id(loop), api_key, base_url)
    client = _clients.get(key)
    if client is None:
        client = AsyncOpenAI(api_key=api_key, base_url=base_url)
        _clients[key] = client
    return client
缓存 key 里带上 id(loop),本质是在说:"这个客户端只能在造它的那个循环上用,不同循环各自维护各自的一份"。因为线程池里的每个线程只有一个长期存活的循环,实际效果就是全进程只会存在跟线程池大小相等的客户端数量(比如 4 个线程就是 4 个客户端),而不是随调用次数无限增长。
进程退出或者线程池关闭时,记得在每个线程自己的循环上 把这个客户端关掉(await client.close()),不能跨线程直接关别人的连接池,容易出一些很莫名其妙的报错。
这样就得出了这次修复的核心结论:"能不能复用一个异步客户端"本质上问的是"能不能复用它背后那个事件循环",两者是绑死的------先让事件循环长期存活、可复用,客户端缓存才有意义。
五、效果
上线之后,找了两次运行时长比较接近(都在 14 小时左右)的周期做了个对比:
| 指标维度 | 修复前 | 修复后 | 变化 |
|---|---|---|---|
| 14 小时增长斜率 | 约 393 MB/h | 约 210 MB/h | 下降约 47% |
| 14 小时累计净增内存 | 约 5.35 GB | 约 2.99 GB | 净增量减少约 44% |
| 单实例峰值内存(14h) | 约 13.4 GB(逼近 16GB 上限) | 约 9.4 GB | 留出约 6.5 GB 安全余量 |
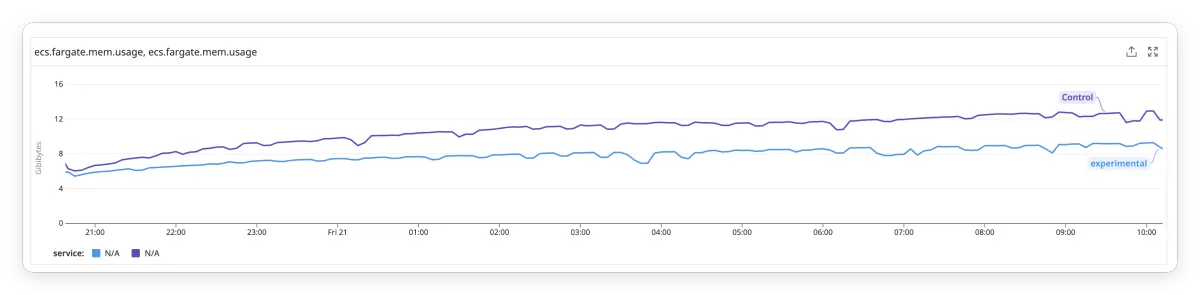
(配图占位:修复前后同时长周期的内存曲线叠加对比图,斜率明显放缓)
增长斜率打了将近一半的折扣,峰值也彻底离开了容器上限的危险区,算是把最大头的问题遏制住了。
总结
这次事情说到底就一句话:"能不能复用一个异步客户端"这件事,本质上问的是"能不能复用它背后那个事件循环",两者是绑死的,不能只解决表面那一层。
几个值得记一下的点:
asyncio.run()每次都会造一个全新的事件循环,图省事直接套在每个后台任务外面很常见,但如果任务里要用到跟事件循环绑定的资源(连接池、SSL 上下文),这种"一次性循环"的模式会让这些资源没法被安全复用,只能每次现造,代价就是连接池泄漏。- 反过来,单纯把客户端改成全局单例也不一定管用------如果事件循环本身还是一次性的,全局单例反而会绑死在第一次调用时那个已经死掉的循环上,直接用不了。
- 正确的顺序应该是先让事件循环能长期存活、可复用(比如给线程池里的每个线程绑一个持久化循环),再在这个前提下去缓存跟循环绑定的资源,这样才是治本的方案。
- 修复上线之后也没有把这事想得太理想化:增长斜率打了对折,但曲线并没有完全变成一条水平线,还残留了每小时约 200MB 左右的小幅增长,大概率是另外几个小模块各自的一些小问题,跟这次的主因不是一回事。这不是一次"药到病除"的修复,只是把最大的那个漏洞堵住了,剩下的小尾巴还得慢慢刮。
- 排查这类"缓慢泄漏",压测脚本 + 内存曲线是最直接的定性手段,看曲线是不是跟着调用次数同步往上涨,基本就能快速把嫌疑范围收窄到"哪个东西没有被正确复用/关闭"上。
最后再多说一句。这段业务代码本身的写法,其实不算是最佳实践------把一个又慢又重的大模型调用直接扔进 web 服务自己的线程池里跑,终归是有代价的。但代码已经这样写、在生产上跑了很久,业务侧也没有必须去动它的理由,所以这次修复给自己定的原则是业务代码零改动,只在"这段逻辑怎么被执行"这一层做文章,把改动范围和风险都锁在最小范围内------效果也确实达到了预期。
后言
但如果是从头设计,更好的做法应该是别在 web 容器里跑这种重任务,把它挪到离线的机器上,或者用类似 Lambda 这样的离线计算资源去处理。理由主要两点:
- 隔离:这种又吃 CPU 又吃 IO 的重任务,跟 web 服务混在同一个进程里,天然会互相干扰。而 web 服务本身对"稳定、低延迟"的要求高得多,被干扰的代价也大得多------让一个没那么敏感的离线任务去扛这个风险,比让 web 服务陪着一起抖动划算得多。
- 成本:web 服务的内存通常比离线计算资源贵得多。这种一次性加载模型请求、处理大对象的重逻辑,哪怕最终都能被 GC 正常回收,运行过程中也免不了制造出内存尖峰;一旦稍有不慎(就像这次),还会有一部分永远赖在堆里出不去,变成实打实的泄漏。把这种大内存操作放在便宜的离线资源上做,才是更划算的架构选择。