我们团队最近一直在迭代 JitWord 协同 AI 文档和 JitKnow AI 知识库。在大量用户反馈的驱动下,我们把知识库的底层检索体系做了一次重要升级:从"纯向量检索"升级为"本体驱动 + 知识图谱增强"。这篇文章记录一下技术思路和踩过的坑,给做企业知识库、RAG 落地的同行做个参考。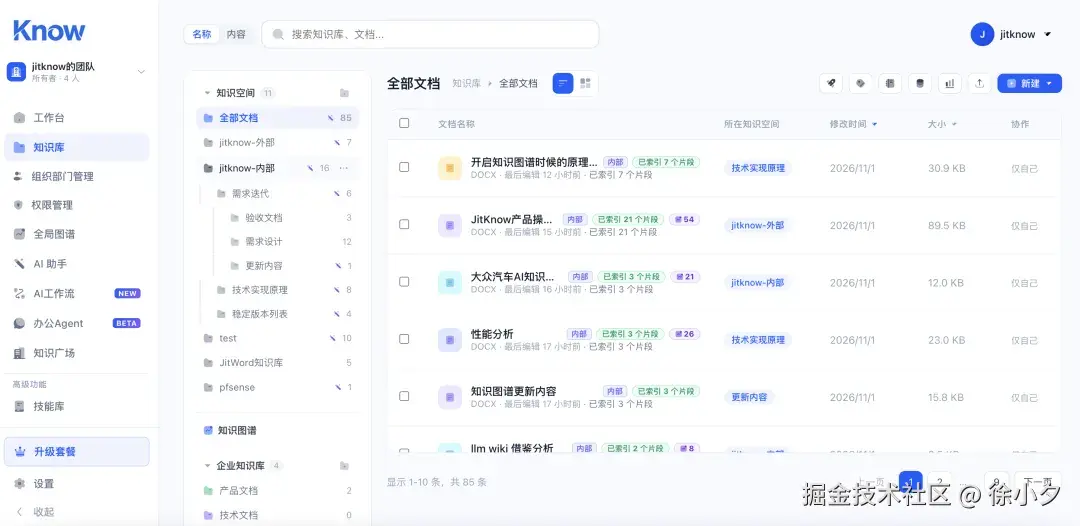
一、先说说痛点:传统 RAG 为什么容易"张冠李戴"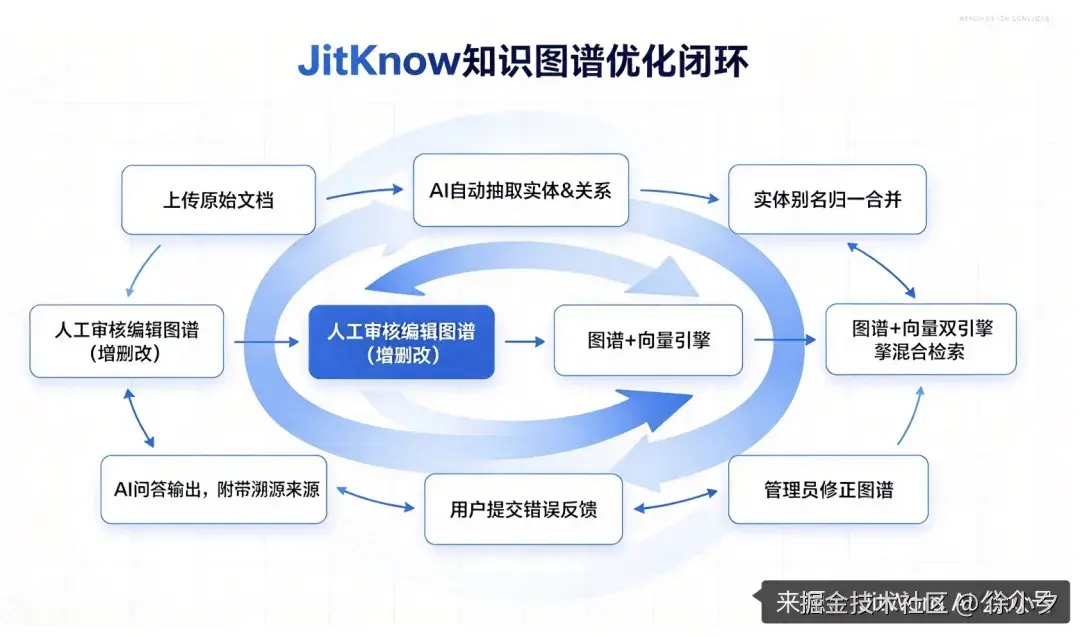
很多人在用 AI 知识库时会遇到一个很头疼的问题:明明文档里写得清清楚楚,AI 回答却经常出错、张冠李戴;同一个东西,文档里一会儿叫 A、一会儿叫 B,AI 就当成了两个完全不同的内容;问到两件事之间有什么关联,AI 要么答不上来,要么凭空编造关系。
我们复盘了一下,传统 RAG 知识库本质是"关键词 + 向量检索":你提问,AI 找到几段相似文字直接拼起来回答。它不理解文字里的实体和关系,只是看文字"长得像不像"。这就好比一个人只看过一堆零散纸条,分不清谁是谁、事情之间有什么联系,自然容易说错话。
这是所有 RAG 落地绕不开的通病,也是我们这次升级要解决的核心问题。
二、知识图谱是什么:用大白话讲清楚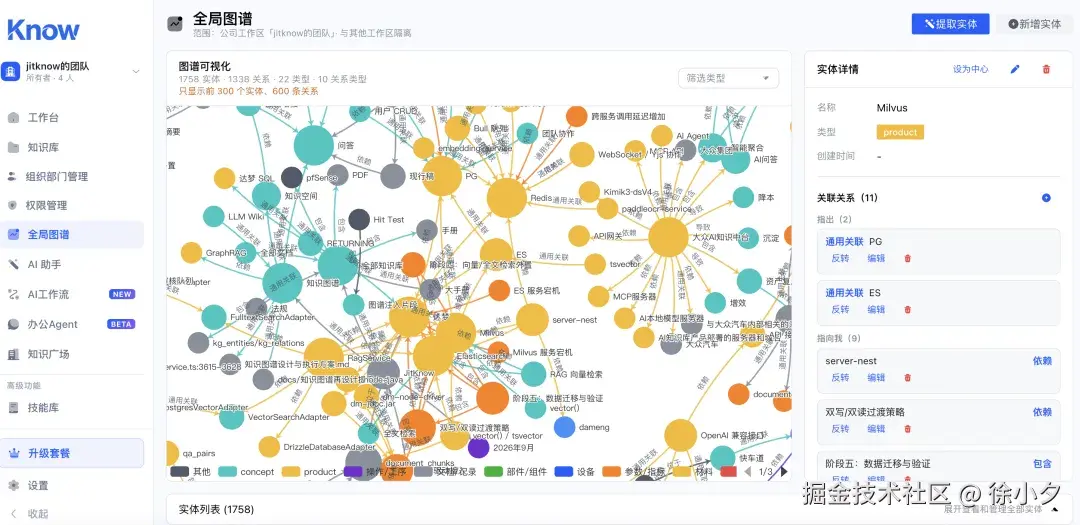
很多朋友第一次听到"知识图谱"会觉得很高深。简单说,知识图谱就是把文档里的信息拆成【实体】和【关系】。实体就是人、部门、产品、项目、文件、指标这类"对象";关系就是谁属于谁、谁和谁关联、谁负责什么。比如"市场部负责公众号运营"------市场部、公众号运营是实体,"负责"是两者的关系。
图谱就像一张网状地图,AI 不再只读零散段落,而是能看懂这张信息网。这是我们这次升级的底层思路。
三、我们这次做的四件事
这次升级不是简单加一个图谱展示面板,而是从实体归一、可控抽取、溯源反馈到混合检索的一整套闭环。下面分四点讲。
第一点:实体归一,解决"一物多名"混乱问题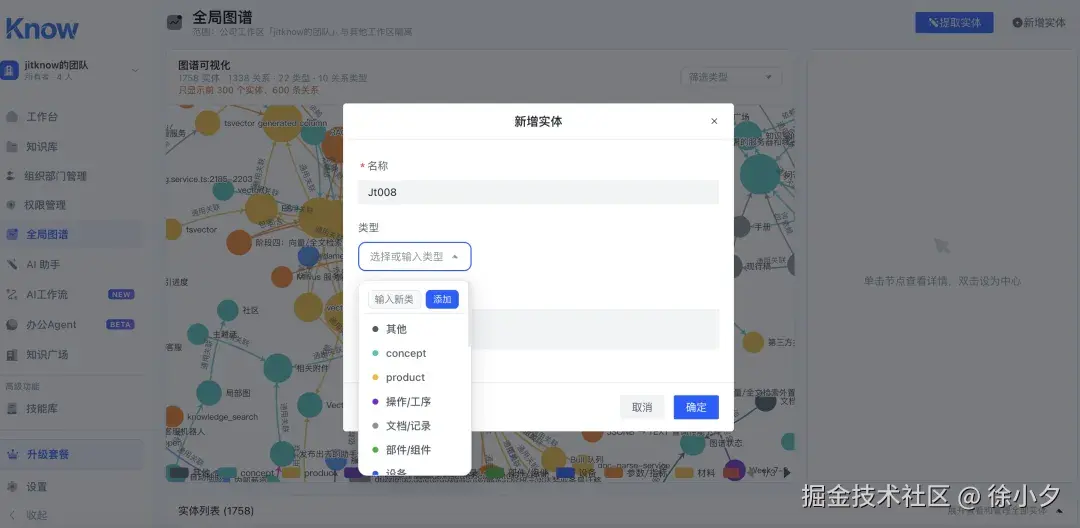
企业文档里,同一个东西有多个叫法是常态。比如产品 JitKnow,文档里可能叫"知识库""AI 知识库""JitKnow 知识库";一个项目,有人叫"一期项目",有人叫"V1 项目"。在老版本里,AI 会把它们当成三个不同东西,检索时信息割裂,回答自然不全甚至前后矛盾。
这次加入实体别名归一:AI 读取所有文档后,自动识别哪些名称指向同一个对象,合并成一个标准实体。管理员还可以手动修正标准名称、增删别名。这样无论用户用哪个俗称提问,AI 都会调取全部相关信息。这是图谱靠谱的基础------先把"名字"统一。
第二点:可控的实体 & 关系抽取,告别 AI 乱脑补
早期很多知识库的图谱抽取是完全黑盒:AI 自动识别实体、自动判断关系,抽出来是对是错用户无法干预。经常出现两个完全没关系的内容被 AI 强行拉出一条关联,或者重要的业务关系被漏掉。出错后只能重新上传文档,没有修改入口。
我们改成可审核、可编辑 的抽取链路: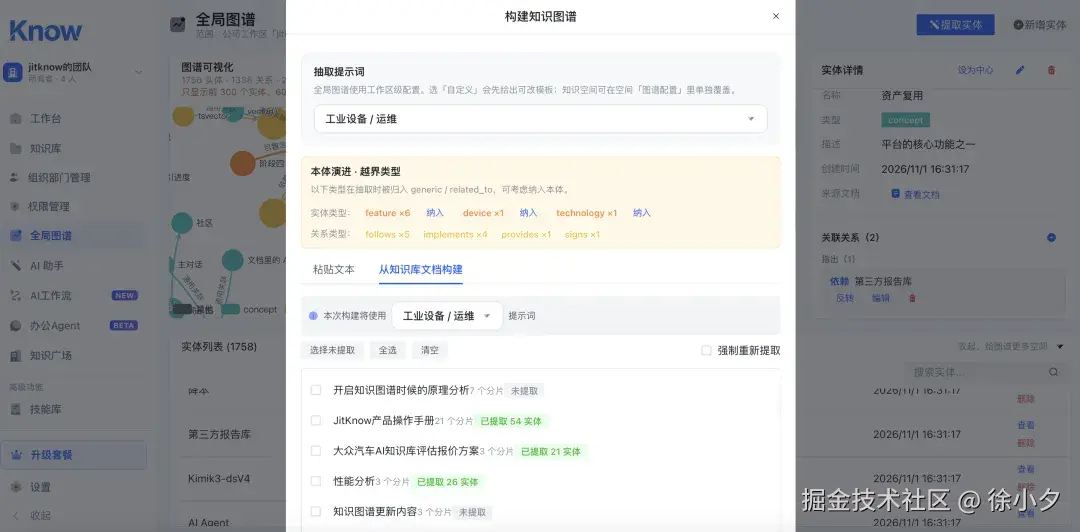
- AI 先自动从文档提取实体和关系,生成初稿图谱;
- 管理员可在后台逐条查看抽取结果------这条实体要不要保留、这个关系是否真实存在,都能手动删除、新增、修改;
- 支持配置抽取规则,优先抽取哪些类型的信息、哪些内容直接过滤。
相当于 AI 先干粗活整理草稿,人来把关校准,兼顾效率和准确性。
第三点:溯源链路和错误反馈机制,问题可追溯、可修复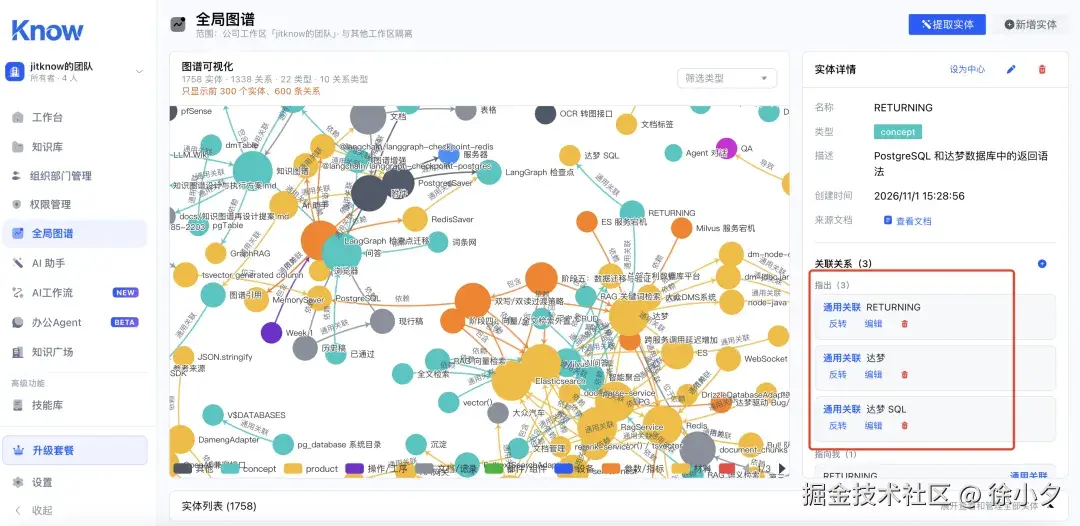
这是最贴合企业需求的点。很多企业管理层最怕 AI 出错后不知道它看了哪段文档、没法定位问题。这次升级给图谱里每一条实体、每一条关系都绑定了原始文档片段------只要觉得图谱里某条信息不对,点一下就能看到来源是哪份文档、哪句话。
同时内置反馈闭环:管理员或普通成员看到 AI 基于图谱给出错误回答、错误关联,都能提交反馈。反馈直达管理员后台,管理员找到对应图谱条目修正;修正之后,后续所有 AI 问答都会复用这份校准后的图谱,同一个错误不会反复出现。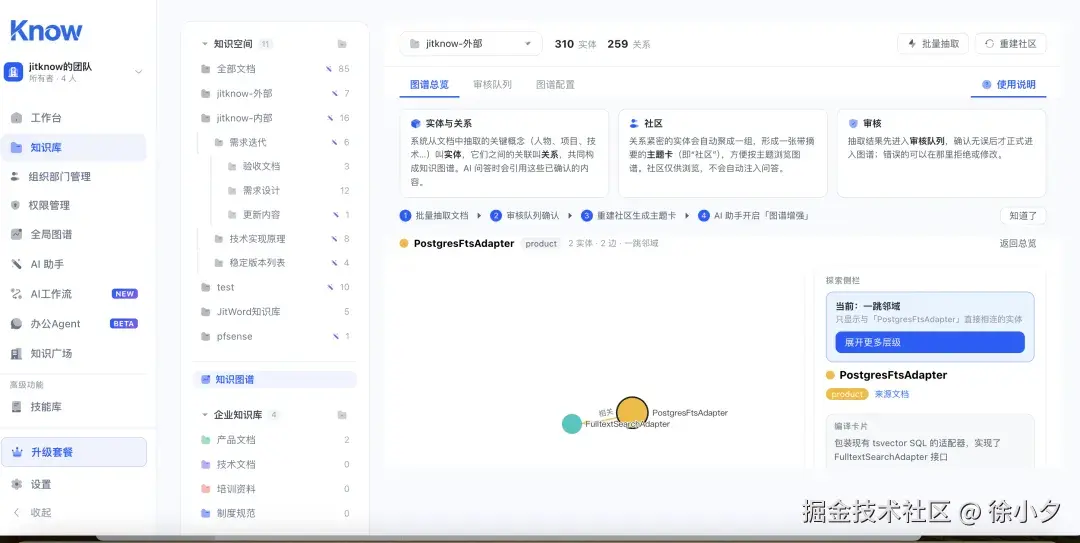
它不是一次性生成的静态图谱,而是可以持续迭代、越用越准的动态知识库。
第四点:图谱与原有检索体系融合,混合问答
这里要说明一点:JitKnow 不是抛弃原有的向量检索、文本检索换成纯知识图谱,而是图谱 + 传统 RAG 双引擎配合。
- 如果问题是事实类、关联类问题(如"哪些产品属于 JitWord 产品线?""这个故障对应的对接人是谁?"),系统优先调用知识图谱,直接读取确定的关系信息,回答精准稳定、不容易幻觉;
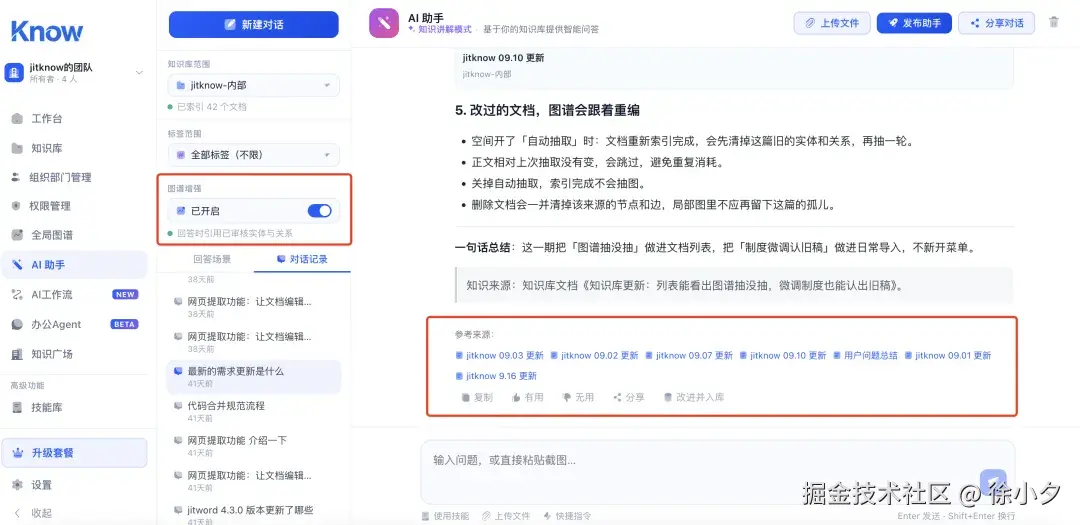
- 如果问题偏向方案解读、长文本总结、创意类内容,系统继续用向量检索调取原文段落做总结。
两套能力互补,既保留大模型擅长文本理解的优势,又用图谱约束 AI 减少编造。
四、落地场景(可复现的真实场景)
场景一:企业内部制度、人事、项目知识库 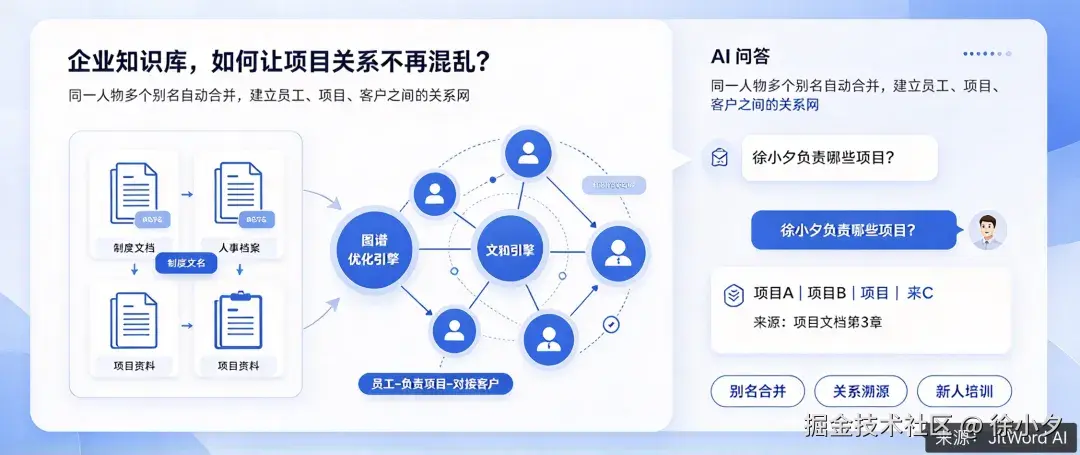
一家公司有几十个项目、上百份文档,同一对接人在不同文档里称呼不一。开启图谱优化后,系统自动把同一个人多个别名合并,建立【员工-负责项目-对接客户】的关系网。问"某同事负责哪些项目",AI 直接给出完整清单并可溯源到对应文档。
场景二:产品与售后客服知识库 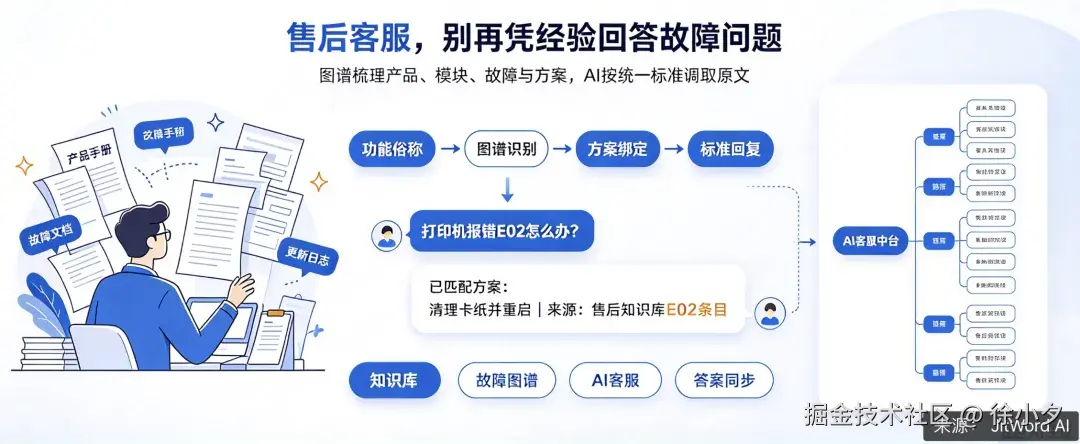
产品手册、更新日志、故障文档很多,同一功能有多个俗称。图谱建立【产品-模块-故障-解决方案】关系,客服不用翻几十份文档;客户问某个故障怎么处理,AI 先从图谱确认故障与方案的绑定关系,再调取原文细节,避免不同客服说法不一。方案有误可直接在图谱里改,全员同步更新。
场景三:研发技术文档库
接口、组件、版本、依赖关系散落在技术文档里。图谱建立【组件-版本-依赖-负责人】关系,开发问某个组件哪些项目在用、适配哪个版本,图谱直接给出关联关系,避免版本冲突踩坑。
场景四:合规、档案类知识库 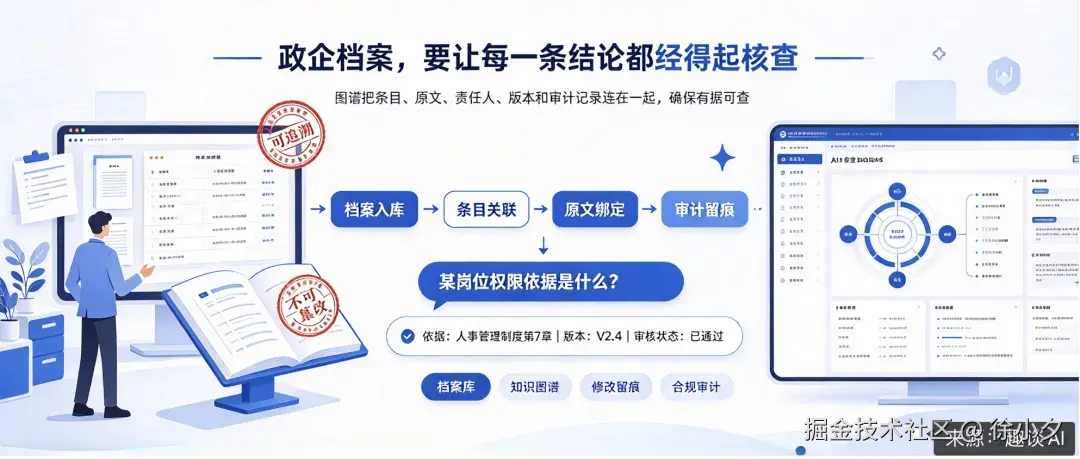
政企单位有大量档案文件,需要信息可追溯、不能随意篡改。图谱所有条目绑定原文来源、修改留痕,每一条结论都有据可查,满足审计核查要求。
五、说点实话:图谱不是万能神器
必须客观说明,知识图谱更擅长确定性、结构化、有关联的事实类问题。如果是开放性策划、文案创作、主观分析类问题,依旧依赖文本检索能力。两者搭配,才是完整的知识库。
另外,图谱抽取的质量高度依赖初始文档质量,抽取规则需要管理员前期配置;实体别名归一对明显歧义、少见的命名方式仍可能出现误判,需要人工复核。这些是我们目前仍在持续优化的边界。
六、复盘与思考
这次升级的核心思路一句话概括:不追求炫酷的可视化图表,而是解决企业知识库最痛的"AI 不可信"问题------从实体名字统一、AI 抽取可人工审核、错误可溯源反馈、图谱与检索融合这几个方面,搭建一套闭环的知识治理体系。
很多 AI 知识库产品把知识图谱当成一个展示噱头,生成一张好看的网络图就结束了,没法编辑、没法纠错、没法与问答联动。我们的重心放在工程落地:让图谱能用、好改、能持续迭代,真正服务日常问答。
对普通用户来说,不需要懂向量、实体抽取、RAG 原理,只需要记住一个感受:上传一堆文档之后,AI 分得清谁是谁、看得懂事物之间的关系、说错了能找到源头并修好、越用越靠谱。
后续我们还会继续扩展这套能力,支持更多类型实体识别、批量导入关系数据,进一步降低企业搭建可信 AI 知识库的门槛。如果大家在 RAG 落地、知识图谱增强检索上有踩过坑,或对这套方案有想交流的实现细节,欢迎一起探讨。