这个模型总共包含 816B 参数,但每个 token 仅激活其中 42B 参数。模型使用 top-8 路由机制,路由器根据 token 表示为每个 token 打分并选出 256 个专家中得分最高的 8 个进行计算,从而在保持大参数规模带来的表达能力的同时降低单次推理的计算量。模型配备了 1M token 的上下文窗口和 1.8B 参数的感知编码器,原生支持交错处理文本、图像、视频帧和音频输入。
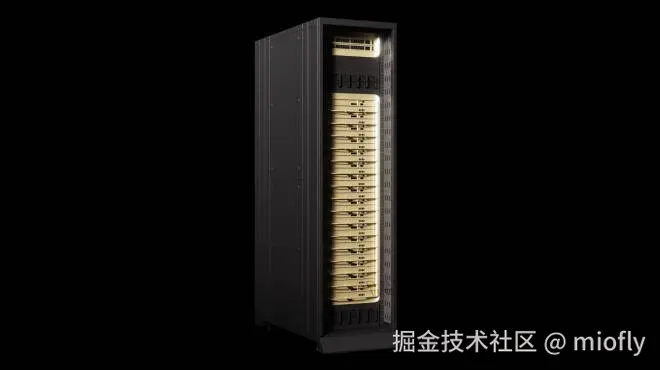
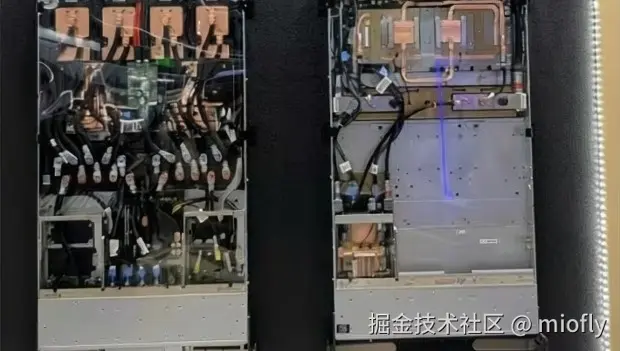
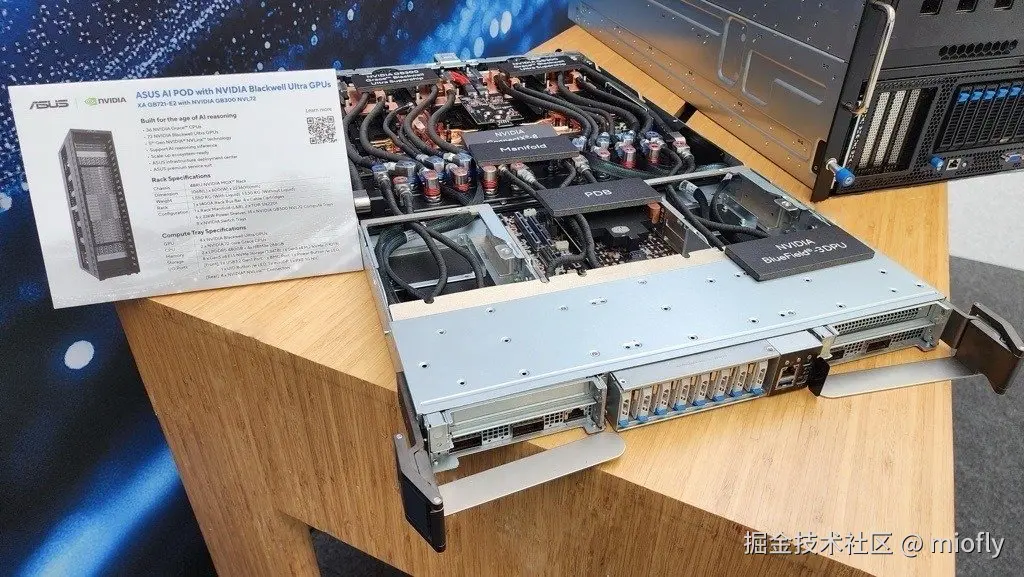
这个推理模型在 NVIDIA GB300 NVL72 Blackwell Ultra 硬件上完成训练。该硬件平台集成了 72 个 NVIDIA Blackwell Ultra GPU,通过机架规模架构和 NVIDIA NVLink 域实现 130 TB/s 的通信带宽。72-GPU 域的设计解决了混合专家模型推理时的专家调度和参数传输瓶颈:每个 token 需要从不同内存位置加载对应专家的参数,大规模 GPU 互联允许专家参数分布存储并快速访问。在更小的 GPU 配置上运行该模型会因带宽不足导致专家参数加载成为性能瓶颈。
性能表现与优化
Meta 为 NVIDIA Blackwell Ultra 生成了专用的 NVFP4 checkpoint。这个 checkpoint 针对 NVIDIA Blackwell Ultra 的 FP4 Tensor Core 进行了量化精度和内存布局优化,在四个 NVIDIA Blackwell GPU 上配合推测解码技术运行时,实现了每 GPU 超过 50K tokens 每秒的吞吐量,单个用户可获得超过 600 tokens 每秒的生成速度。
推测解码通过让较小的草稿模型先生成候选 token 序列,然后由主模型并行验证的方式,减少了主模型的前向传播次数。对于混合专家模型,每次前向传播需要协调路由决策、专家调度和跨 GPU 的参数加载,这些开销使得减少前向传播次数带来的收益更明显。
部署与定制
NVIDIA 支持多个推理堆栈运行该模型,包括 SGLang、vLLM 和 TensorRT LLM。Muse Spark Open 的 NVFP4 权重已经在 Hugging Face 上提供下载。
开发者可以使用 NVIDIA NeMo AutoModel 对 Muse Spark Open 进行后训练。这是一个 PyTorch 原生训练库,原生支持 Hugging Face checkpoint,开箱即用地支持完整的 SFT 和 LoRA 微调,允许开发者在特定领域数据集上调整模型。
架构特点
混合专家架构通过条件计算降低了推理时的实际计算量。Muse Spark Open 使用 top-8 路由意味着每个 token 会被发送到 256 个专家中选出的 8 个专家处理,因此虽然模型总参数达到 816B,但每次前向传播只需要激活 42B 参数,这个激活参数量与单体模型相当,但训练和表达能力受益于更大的总参数规模。
作为编码优化的推理模型,Muse Spark Open 的百万 token 上下文窗口可以容纳大型代码库的完整上下文。多模态感知能力则支持处理包含截图、架构图、视频演示和语音指令的开发场景,覆盖需要理解大量已有代码、文档和多媒体需求说明的代理编码工作流。
原文地址:tools.wflynn.cn/aitools/tre...
关注公众号「YourTools」,每天推送 GitHub 趋势与开源工具速报: