最近一直在创业做 AI 产品,也一直在账号里给大家分享高价值的 AI 开源项目。今天带大家深入了解一款主打极致降本的开源 AI Agent:DeepSeek-Reasonix。
 它不是泛通用型 Agent 框架,而是深度绑定 DeepSeek API、基于前缀缓存机制打造的终端编程智能体,解决长代码会话 Token 成本爆炸的痛点。
很多朋友在使用各类 AI 编码 Agent 时都会遇到同一个难题:随着项目对话越来越长,上下文持续膨胀,每一轮交互都要重复上传大量历史上下文,Token 开销居高不下。不少方案会用摘要、截断、压缩上下文的方式控制成本,但压缩会丢失细节,很容易造成代码逻辑出错、Agent 失忆。
 DeepSeek-Reasonix 的解法比较独特:不做上下文压缩,而是顺着 DeepSeek 原生 Prefix Cache 前缀缓存的特性,设计一套缓存优先(Cache-First)、只追加(Append-Only)的会话循环,把长会话缓存命中率拉高,直接压低持续编码的调用成本。
一、项目核心功能亮点
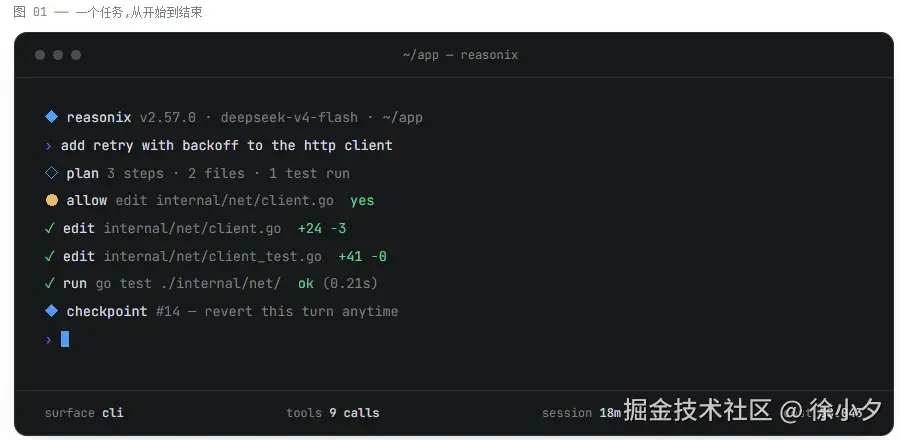 Reasonix 定位是运行在终端里的自主编程 Agent,拿到任务之后可以自主操作本地工程文件,而不是只返回代码片段。
- 完整的本地工程操作能力:读写源码文件、执行 Shell 命令、运行单元测试、Git 版本操作、代码审查,自主完成多步骤开发任务,每一步都留存执行证据,方便回溯问题。
- Append-Only 会话机制(核心亮点) :会话历史只追加、不修改、不重排、不删除,维持上下文前缀字节稳定,持续命中 DeepSeek 前缀缓存。社区实测长会话缓存命中率最高可达 99.82%,输入 Token 成本大幅下降。
- 原生支持 ACP 子 Agent 协议:可作为子模块接入 DeepSeek Harness,承接复杂大任务里拆分出来的编码子任务,实现多智能体协同调度。
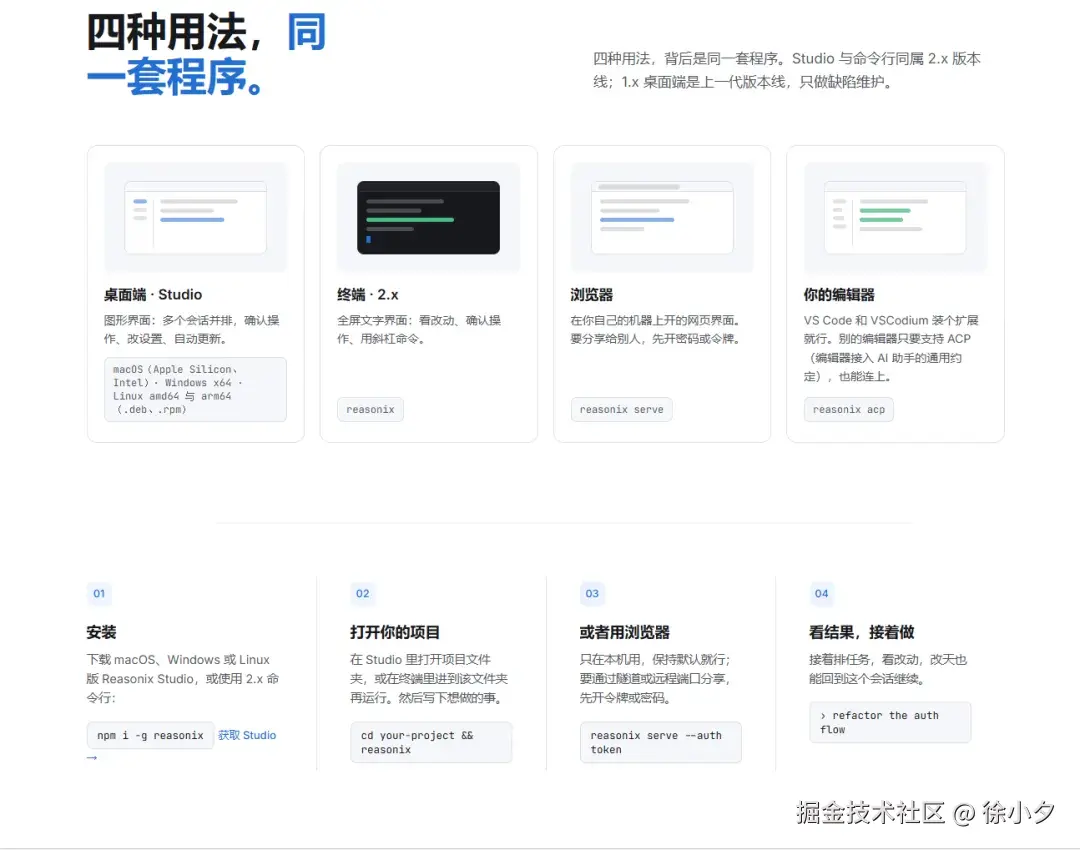
- MIT 协议开源,Node 驱动:Windows、MacOS、Linux 全平台支持,终端一键启动,上手门槛低;也提供桌面端版本。
- 会话全程可追溯:所有模型请求、工具调用、返回结果全部留存日志,支持回放、分叉会话,调试 Agent 行为非常友好。
Roadmap 八卦(未经官方证实,仅供吃瓜)社区流传的内部路线消息:团队下一阶段计划脱离仅 DeepSeek 单模型绑定,增加对兼容 Prefix Cache 协议的第三方推理服务适配;同时内置简易 Web UI,开放会话分享、团队协作功能。不过该计划没有在仓库正式文档公示,最终是否落地以官方 Release 为准。
三、技术架构深度拆解
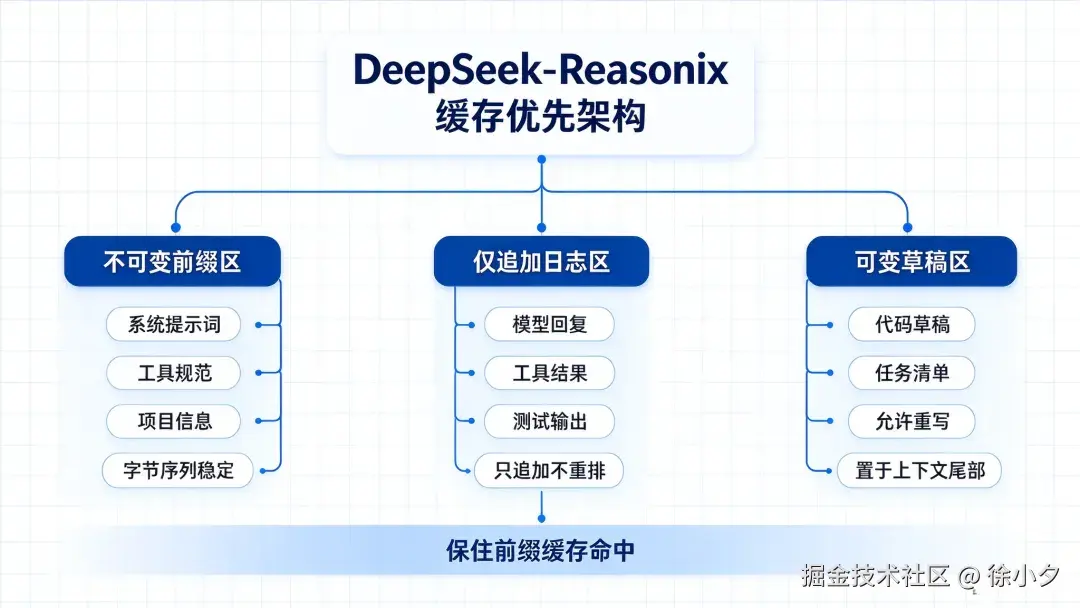 Reasonix 整套架构的核心思路一句话总结:把会话上下文分层隔离,用稳定不变的前缀去适配 DeepSeek 前缀缓存,用只追加的日志维持缓存持续命中,用独立可变草稿区承载迭代内容。
整个会话上下文被切分为三大区域:
1. 不可变前缀区 会话初始化阶段一次性构建,包含系统提示词、工具调用规范、Few-shot 示例、项目基础信息。会话生命周期内这部分字节序列固定不变,DeepSeek 服务端会对其计算指纹并缓存,后续每一轮请求都复用这个前缀缓存,不需要重复计费。这是整套方案成立的根基。
2. 仅追加日志区 所有模型回复、工具调用指令、命令返回结果、测试输出全部在日志末尾追加写入,不裁剪、不打乱顺序、不摘要改写。只要日志是追加写入,前面一大段字节序列就不会变动,前缀缓存就能持续命中。这也是它和绝大多数 Agent 框架最大的区别------很多框架为了控制长度会随时修改历史消息结构,缓存直接失效。
3. 可变草稿区 存放当前正在迭代的代码草稿、任务规划清单,允许修改、重写。它放在整个上下文的尾部,不会破坏前面固定前缀和追加日志的字节结构,修改草稿不会打断缓存链路。
基于三层上下文分区,运行循环流程为:启动会话 → 加载固定前缀区 → 接收用户开发需求 → 模型生成行动指令 → 调用本地工具读写文件 / 跑测试 → 工具结果追加写入日志区 → 更新草稿区内容 → 组装完整请求发给 DeepSeek API → 循环直到任务完成。
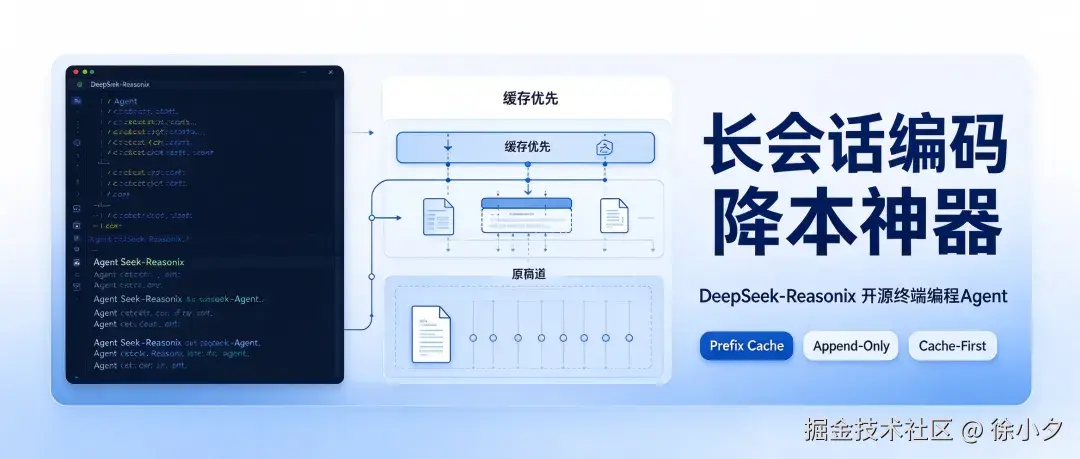 在这套架构里,缓存优先是第一设计原则,工具调用、任务规划都围绕"保住前缀缓存命中"这个目标服务。为了配合这套机制,项目内部实现了专门的序列化模块,保证每一次序列化输出的字节顺序稳定,避免不经意的字段顺序变动破坏缓存指纹。
四、应用场景(个人观点,仅供参考)
- 独立开发者长期工程迭代:持续几天的单项目开发、bug 修复、重构任务,长时间连续和 Agent 对话,最大化降低 API 开销;
- 技术团队内部自动化编码流水线:作为子 Agent 嵌入自研开发平台,批量生成、维护业务代码;
- 本地私有知识库配套代码生成:搭配知识库做项目脚手架、脚本工具开发;
- Agent 技术学习研究:学习前缀缓存、Append-Only 会话、工具调用智能体的工程落地思路;
- 离线私有化推理服务对接:对接支持 Prefix Cache 的自建推理集群,搭建低成本本地编码 Agent。
五、项目优缺点
结合自己的研究和实践,如实分享这个项目的优缺点:
优点
- 成本优势强,长周期编码场景收益明显,同样的开发任务对比普通 Agent 方案 Token 消耗可降低很多;
- 架构思想干净克制,没有堆砌复杂组件,核心逻辑围绕缓存机制展开,源码阅读门槛低,方便二次改造;
- 完整可追溯的会话日志,适合调试 Agent 行为,做 Agent 方向的学习、实验;
- MIT 宽松开源协议,商用友好,支持作为子 Agent 接入 Harness 生态;
- 终端优先、轻量化,不需要部署重型服务,本地电脑直接跑。
缺点
- 强绑定 DeepSeek 前缀缓存特性,迁移到其他不支持 Prefix Cache 或缓存机制不一样的大模型,核心优势直接消失;
- 不做上下文自动压缩,极端超长会话下整体上下文长度持续上涨,会受模型上下文窗口限制;
- 终端形态对非开发人员不友好,原生没有成熟可视化 UI,普通用户上手难度高;
- 依赖稳定的 Node 环境,Windows 环境下 Shell、文件权限问题需要自行处理;
- 能力聚焦在代码开发,通用文本、多模态任务不是它的设计目标,不适合拿来做通用 Agent。
六、复盘与思考
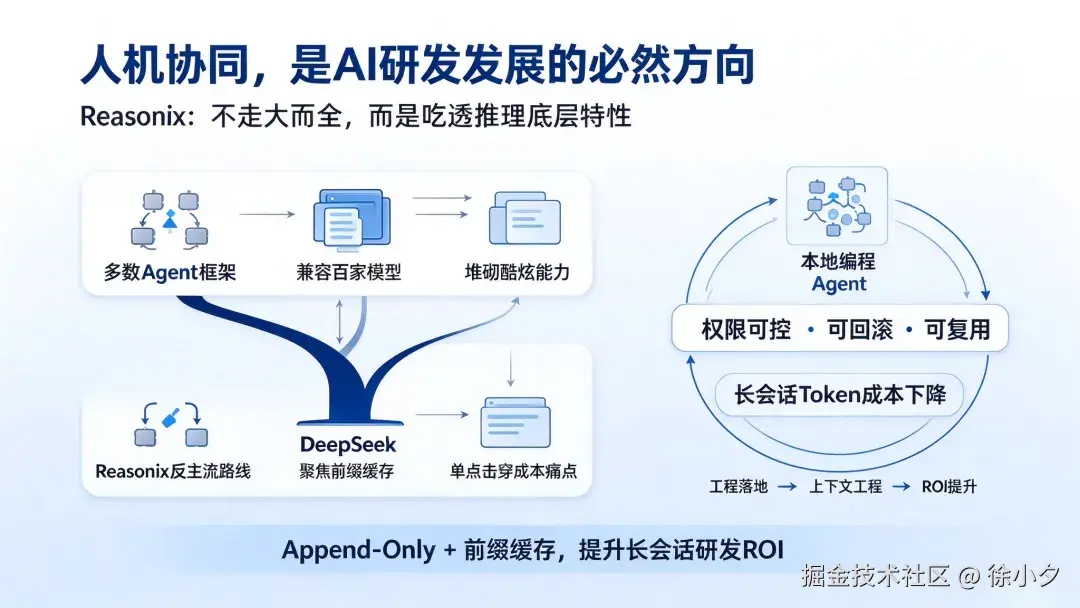
人机协同是 AI 研发发展的必然方向。从技术落地视角看,Reasonix 的长期价值在于它选了一条反主流路线:当很多 Agent 框架忙着兼容百家大模型、堆砌各类能力时,它聚焦 DeepSeek 前缀缓存特性,单点击穿长会话 Token 成本痛点。
绝大多数开发团队落地 AI 编码工具的困境,不是没有大模型可用,而是缺少一套适配真实工程、权限可控、适合长期迭代的 Agent 运行框架。Reasonix 的价值,是完成了从"代码问答工具"到"可自主执行任务的本地编程 Agent"的蜕变:Agent 不必追求大而全,吃透推理底层特性,依靠精巧的上下文工程设计,就能拿到可观的投入产出提升。
 它轻量化、多端形态、MIT 开源无厂商绑定、密钥自主持有,但并不是适合所有人的万能 Agent。如果只是偶尔写几行代码、短需求快速调试,它的优势很难发挥;但如果经常面临连续多轮、长时间的大型工程迭代,且主力使用 DeepSeek 系列模型,它会是很有特色的开源方案。
值得一提的是,这套 Append-Only + 前缀缓存 的设计思路,对长文档 / 长上下文 Agent 产品也有借鉴价值:长上下文场景下,降本不止摘要压缩这一条路。如果你在做 RAG、长文档 Agent、编码 Agent 相关方向,或有对这套缓存工程方案的疑问,欢迎一起交流。