最近一直在创业做 AI 产品,也一直在账号里给大家分享高价值的 AI 开源项目。今天带大家深入了解一款开源 AI Agent:Prime Agent。它是 Prime Intellect 开源的,围绕两大抽象做的一个长周期编程智能体:递归语言模型(RLM)+ 持续框架(Continual Harness)。
下面不整那些玄乎的词,就用大白话,带大家把它拆开看看,它到底凭什么能"自我进化"。 说真的,这个项目最值得关注的地方,不是它跑得多快,而是它第一次让我看到一个 Agent 能"越用越懂自己"。下面从最核心的自我进化机制,一路拆到怎么上手。
一、先说痛点:AI 编码 Agent 为什么"越干越乱"
用 AI 编码 Agent 的朋友,多少都有过这种感觉:单次对话它挺聪明,但一进长周期、多步骤的工程任务,它就慢慢"飘"了。上下文越拉越长、状态越堆越乱,跑着跑着就偏离目标;拆几个子任务没人协同,经验也沉淀不下来,每次都是从头再来。
尤其做工程的人体会最深:一个任务往往要改十几个文件、跑好多遍测试,中间还可能要在几个 Agent 之间来回切换。上下文一长,前面定的方案后面就忘了,改着改着跟最初的设计南辕北辙。这种"越干越乱"的体验,用久了确实劝退。
这就像你请了个很聪明的实习生,但实习生每次上班都忘光昨天学的,你不得不在旁边一遍遍交代。Agent 不是能力不够,是"记不住、长不大"。
Prime Agent 的解法不一样:它不让 Agent 用完即忘,而是让 Agent 本身变成一个可读、可写、能自己长进的对象------干过的活变成技能,踩过的坑变成记忆,下次直接复用。 市面上很多 Agent 也号称能"记忆",但大多是简单把聊天记录堆在一起,该分不清主次还是分不清。Prime Agent 不一样,它把记忆、技能、子 Agent 都当成真正可管理的"资产",干过的活能沉淀成下次直接复用的能力。
二、核心机制:Agent 会自我进化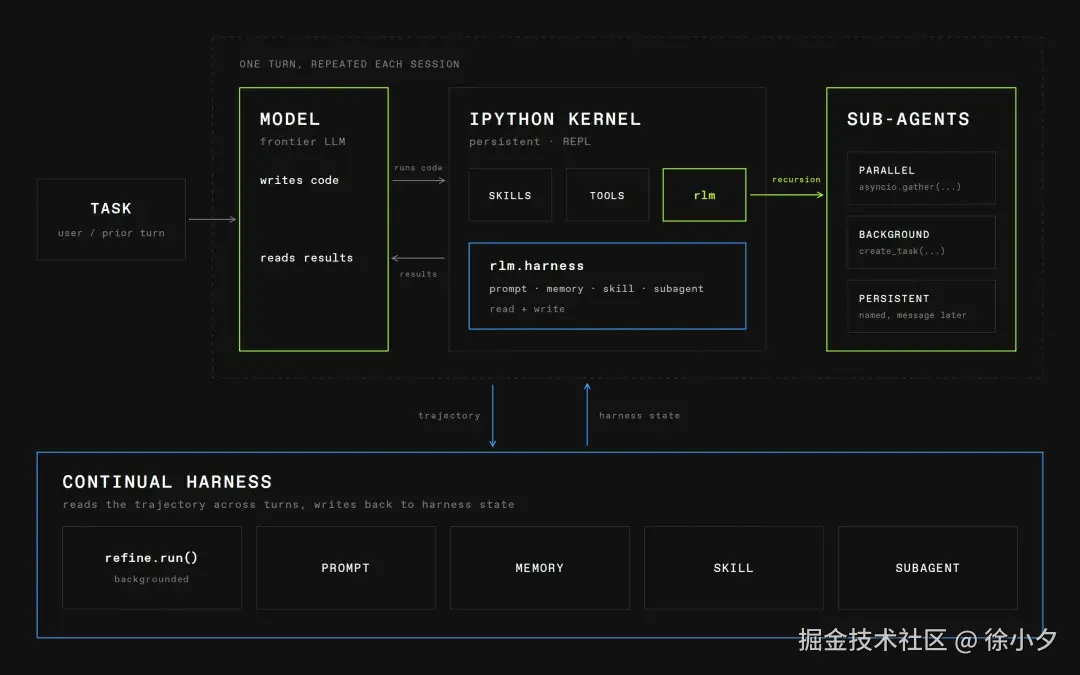
这是它敢叫"自我改进"的底气,核心是持续框架(Continual Harness)。它把提示词、记忆、技能、子 Agent 规范,全部抽象成能增、删、改、查的"状态"。Agent 跑完一段任务,可以把经验写成技能、把教训写成记忆、把一套协作套路固化成子 Agent 规范,存下来,下次直接用。
打个比方,普通 Agent 像个刚毕业、学得挺快但忘得也快的萌新;Prime Agent 更像个带工位和笔记的老手------每次复盘把要点写进自己的"工作手册",下次一开工,该注意的坑、该走的流程全在里面等着它。
模型权重一个字不用动,Agent 的行为却在悄悄变强。你可以理解为:它每干完一件事,都会把自己的"工作手册"更新一版,越用越顺手。
它把 Agent 的状态按可见性和持久度分成四层:模型权重、活动上下文、REPL 与子 Agent、磁盘上的历史记忆与技能。每一层用不同机制推进------微调改权重、压缩改上下文、Agent 自己增删 REPL 里的值、精炼去更新记忆和技能。理解这四层,就懂了它为什么能"自我进化"。
三、内核 + 万物皆插件的抽象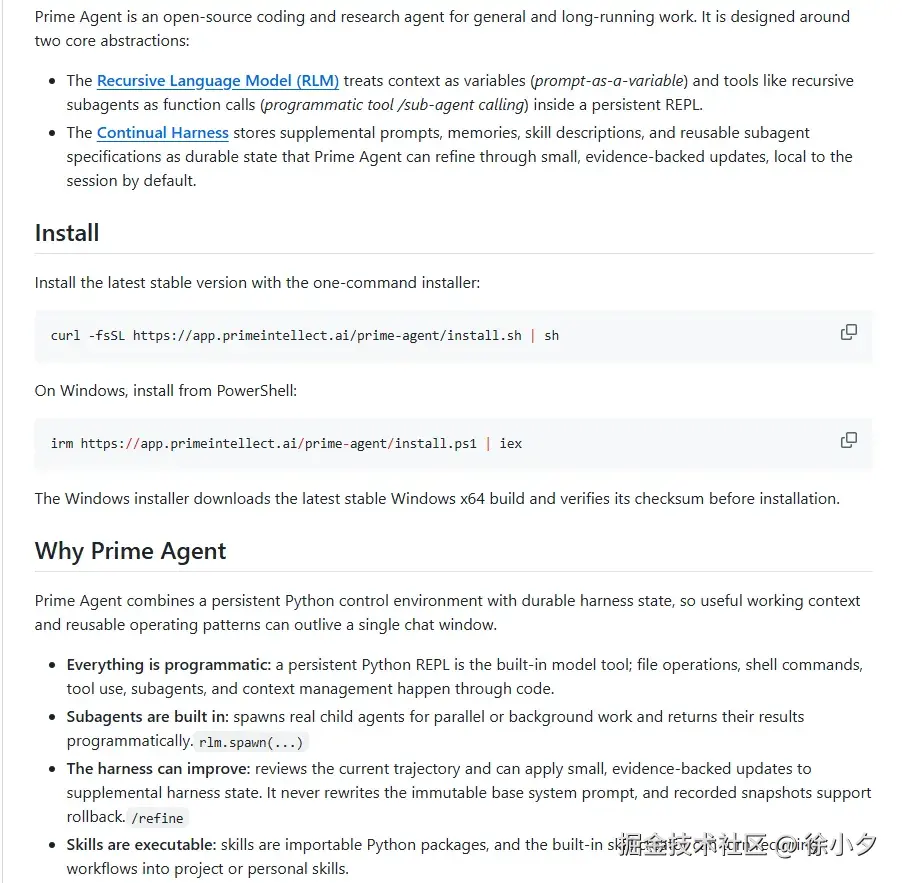
再往里拆,它的设计其实特别干净,就两条线。
为了让长会话不"爆内存",它有自己的压缩(compaction)机制:上下文接近阈值时,会启动一个专门的子 Agent 当"垃圾回收员",把历史里不重要的部分清掉、把关键信息精简出来。同时,会话以只追加的 JSONL 日志存盘,既能随时回溯、分叉,也能在进程崩溃后从快照原地恢复。
一条管"算力",靠 RLM(递归语言模型) 。模型用一个持久化的 IPython 交互内核当唯一工具,把派子 Agent当成一次函数调用,随时 await rlm("帮我把这个模块审一遍"),就能招一群子 Agent 并行干活。子 Agent 各有各的上下文、内核、历史和工作区,父 Agent 派完活立刻接着干自己的,结果通过消息队列异步传回来。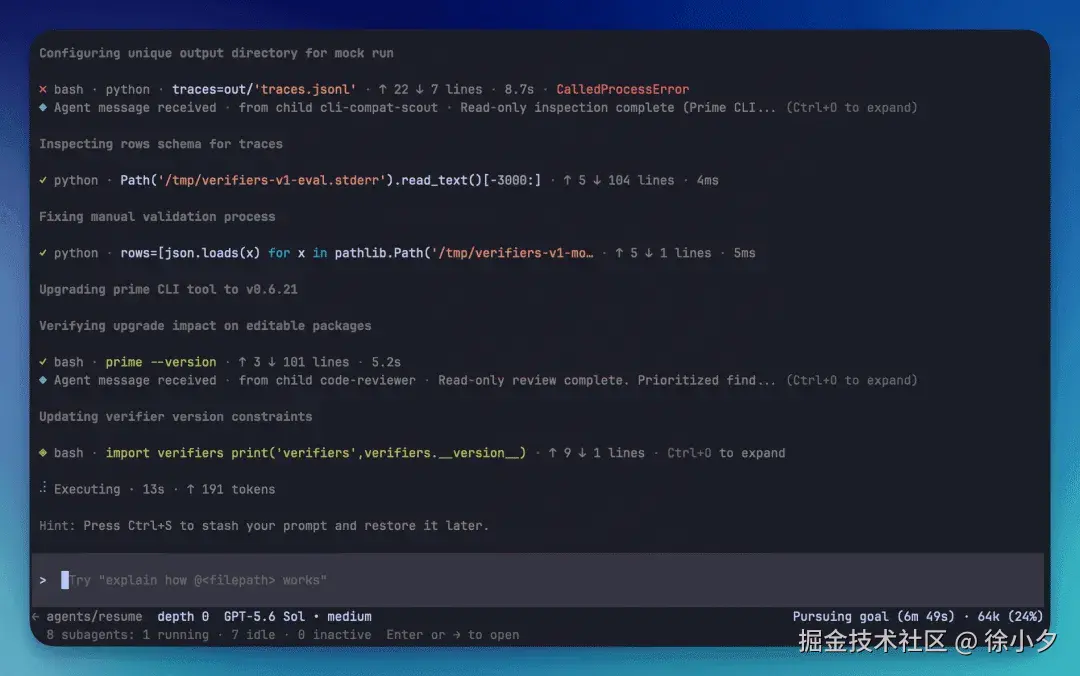 一条管"信息",靠持续框架跨回合读轨迹,把执行证据写回记忆和技能。整条运行循环就是:接收任务 → 在 REPL 里写代码、调工具、派子 Agent → 结果和轨迹记进历史 → 跨回合把经验沉淀成记忆和技能 → 再来一轮。跑得越久,它越懂你的项目。
这两条线合起来就是一句话:模型负责"想",框架负责"记",两边各干各的、又互相配合。想的部分交给 RLM,在 REPL 里写代码、派子 Agent;记的部分交给持续框架,把每一轮跑出来的经验跨回合写回状态。正因为把"算力"和"信息"分开管,它才能在长任务里既跑得快、又不丢东西。
四、怎么用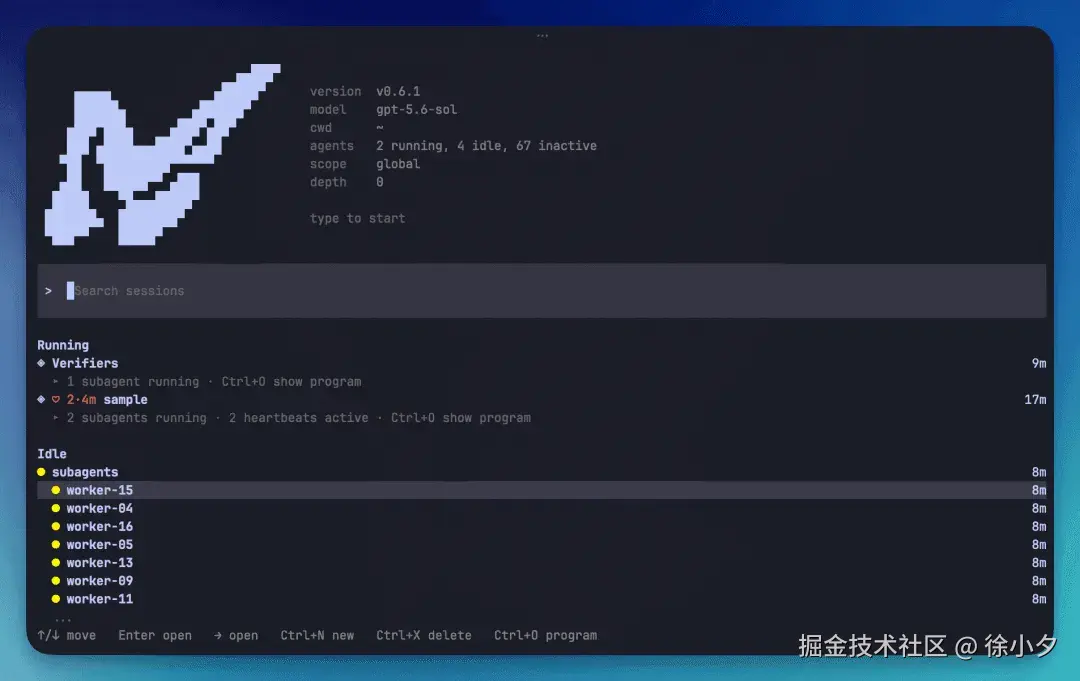
安装很简单,一行命令:
curl -fsSL https://app.primeintellect.ai/prime-agent/install.sh | sh
Windows 上也有 PowerShell 的一行安装,还能通过 homebrew 装,安装体积只有几十 MB。装完就是那个跑在终端里的智能体,不用装额外 SDK、也不用改它一行代码,直接把仓库地址丢给它就行。
你可以随时看它派了哪些子 Agent、当前在忙啥,还能直接钻进任意一层会话里盯着它干活、随时干预。所有会话由后台守护进程持有,可以随时挂起、重连,不打断它执行;万一它自己崩了,也能从快照恢复,接着原来的对话继续。
五、真实战绩:它把自己重写成了 Rust
硬数据更有说服力。项目发布两个月,下载量已超 30 万,累计处理超 8 万亿 token。最硬核的还是那次自我重写:官方用了 2000 多个子 Agent、跑在 10000 多个沙箱上,花了两周,把项目从 TypeScript 整体重写成了 Rust。期间代码是 Agent 自己写的、评审是 Agent 自己当的、校验也是 Agent 自己跑的,人类只负责定方向和审结果。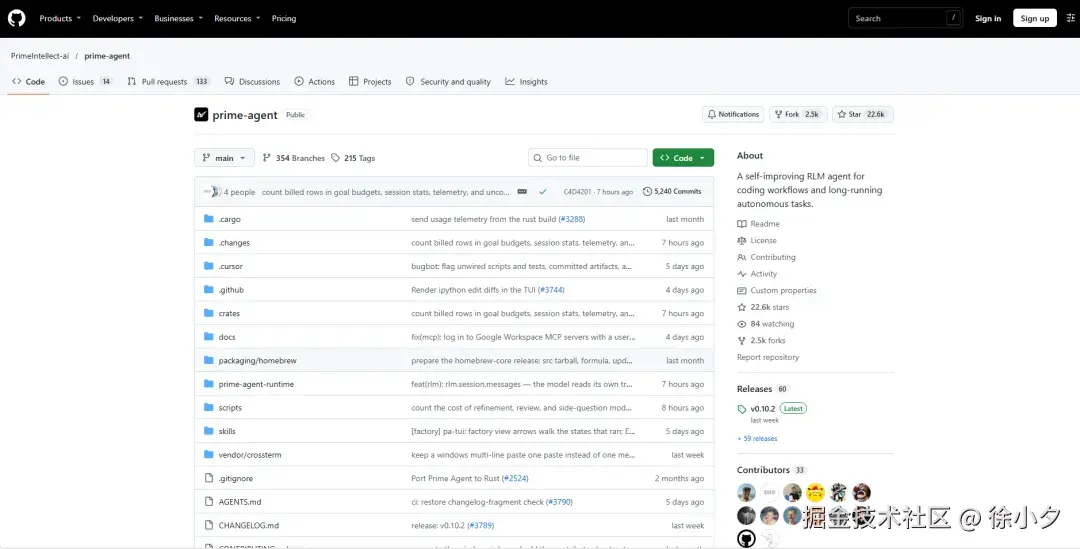 重写完之后:冷启动输入就绪延迟从约 736ms 压到 51.9ms(快了约 14 倍);启动后内存从约 1130MB 降到 237MB(省了八成)。论文里它在 ARC-AGI-3 上把得分从 30% 拉到 95.5%,在长上下文编码、GPU 内核生成、模拟器构建这些长程任务上,匹配或超过了 Claude Code、Codex、Pi。
更值得注意的是,这次自我重写不是一次性表演,而是被它打磨成了产品能力:官方把整个重写拆成一个个"有限状态机"式的任务,规划、实现、评审、校验各由一个 Agent 负责,生成和验证分开,写代码的和挑毛病的用不同模型、不同上下文,防止"自卖自夸"。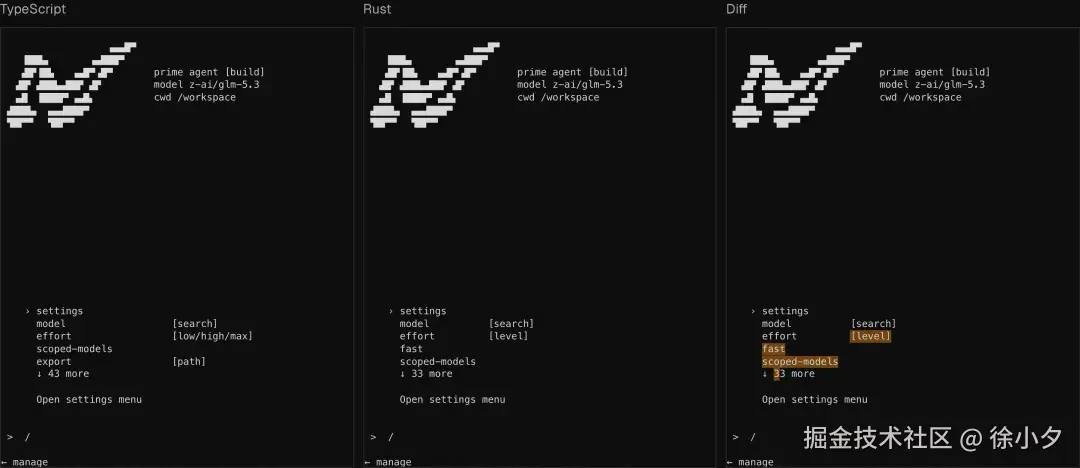
六、应用场景(个人观点,仅供参考)
它真正擅长的,是那种长周期、多步骤、需要 Agent 长期值守还不停沉淀经验的活:大规模代码重构与迁移、长时间运行的训练与基准测试、多 Agent 并行的复杂任务。对做 RAG、长文档 Agent、多智能体协同的产品团队来说,它这套"运行框架与模型策略解耦、状态可沉淀"的思路尤其有参考价值------降本和提效,从来不止摘要压缩这一条路。
拿我自己来说,最心动的是它跑长任务的"稳定感":不用时刻盯着,中途随时能钻进某个子会话看一眼、改一下,干完还能把经验留给下一个项目用。
但别指望它是万能:如果只是偶尔写几行代码、做短平快需求,它这套"自我进化"的优势根本发挥不出来,上手还有一点学习成本。更稳妥的说法是:它在"长程、协同、可沉淀"这类任务上非常有特色,值得长期关注。
七、复盘与思考
人机协同是 AI 研发的必然方向。现在很多 Agent 框架还在忙着兼容百家大模型、堆砌酷炫功能,Prime Agent 却把功夫花在"让 Agent 自己长本事"上------用一套可读、可写、可自我改进的框架,把大模型能力变成可管控、可回滚、可沉淀复用的研发生产力。
说到底,工具会变、模型会变,但"让 AI 沉淀经验、服务真实工作"这件事不会过时。如果你也在做 RAG、长文档 Agent、多智能体协同,建议去读一读它的源码和论文,它在架构边界、状态分层、自我进化闭环上讲得很清楚。
它给我们的启发是:判断一个 Agent 框架值不值得投入,别只看演示多炫,要看它能不能在真实长周期场景里稳得住状态、沉淀得了复用,并且让你随时能看、能改、能干预。这套"运行框架与模型策略解耦、状态可沉淀"的思路,对长文档 / 长上下文 Agent 的设计同样有借鉴意义。如果大家在 Agent 经验沉淀、多智能体协同上踩过坑,或有想交流的实现细节,欢迎一起探讨。