一句话理解:CLIP 并没有学习一个固定的"猫狗分类器",而是把类别写成文本,再判断当前图像与哪段文本最匹配。
上一篇《CLIP 的训练机制:从对比学习到图文对齐》介绍了 CLIP 的训练过程:图像经过 Image Encoder,文本经过 Text Encoder,模型通过对比学习把配对的图文拉近、把不匹配的图文推远。
但训练完成之后,这个模型究竟怎么用于分类?
传统分类模型通常需要预先确定类别,并为这些类别训练一个固定的分类头。CLIP 却可以只看类别名称,直接识别训练阶段没有专门标注过的新任务。这种能力被称为 Zero-shot Classification(零样本分类)。
这一篇,我们就从推理过程出发,看看一组普通的文本描述,是如何临时变成图像分类器的。
一、什么是零样本分类?
假设现在有一张图片,我们希望模型判断它属于下面哪个类别:
- cat
- dog
- car
对于普通的监督分类模型,我们通常要准备大量标注图片,例如:
bash
猫的图片 → cat
狗的图片 → dog
汽车图片 → car
然后用这些数据训练一个只能输出 cat / dog / car 的分类头。如果后来又增加了 airplane,往往还需要修改输出层并重新训练。 CLIP 的做法不同。它不直接把图片映射到固定的类别 ID,而是把每个类别写成一段自然语言:
css
a photo of a cat
a photo of a dog
a photo of a car
接着,CLIP 会分别计算图片与三段文本的相似度。哪段文本与图片最相似,模型就把对应的类别作为预测结果。 整个过程中,我们没有用这三个类别的标注图片继续训练模型,也没有更新任何参数。因此,这被称为"零样本"分类。 这里的"零样本"并不是说 CLIP 从来没见过猫或狗,而是说:面对当前分类任务时,我们没有再提供带标签的训练样本。
二、CLIP 为什么不需要传统分类头?
1. 传统分类器:类别被写死在参数里
传统图像分类器会先把图片编码为特征向量 v,再通过一个线性分类层得到各类别的分数:
ini
类别分数 y = 分类器权重 W × 图像特征 v + 偏置 b其中,分类器权重 W 的每一行都可以看作一个类别的"判别方向"。如果模型有 1000 个类别,W 就包含 1000 组需要从标注数据中学出来的权重。 这意味着类别集合通常在训练前就已经确定。改变类别,也就意味着改变分类头。
2. CLIP:用文本动态生成类别表示
CLIP 已经在训练阶段学会把图像和文本映射到同一个特征空间。因此,我们可以把候选类别交给 Text Encoder:
scss
类别文本向量 = Text Encoder(Prompt 模板 + 类别名称)这些文本向量承担了类似"分类器权重"的作用。类别不是被永久写在模型输出层中,而是在推理时通过自然语言动态构造出来。 所以,CLIP 的零样本分类也可以理解为:
先用文本生成一个临时分类器,再用图文相似度完成分类。
三、零样本分类的完整流程
下面把整个推理过程拆成六步。 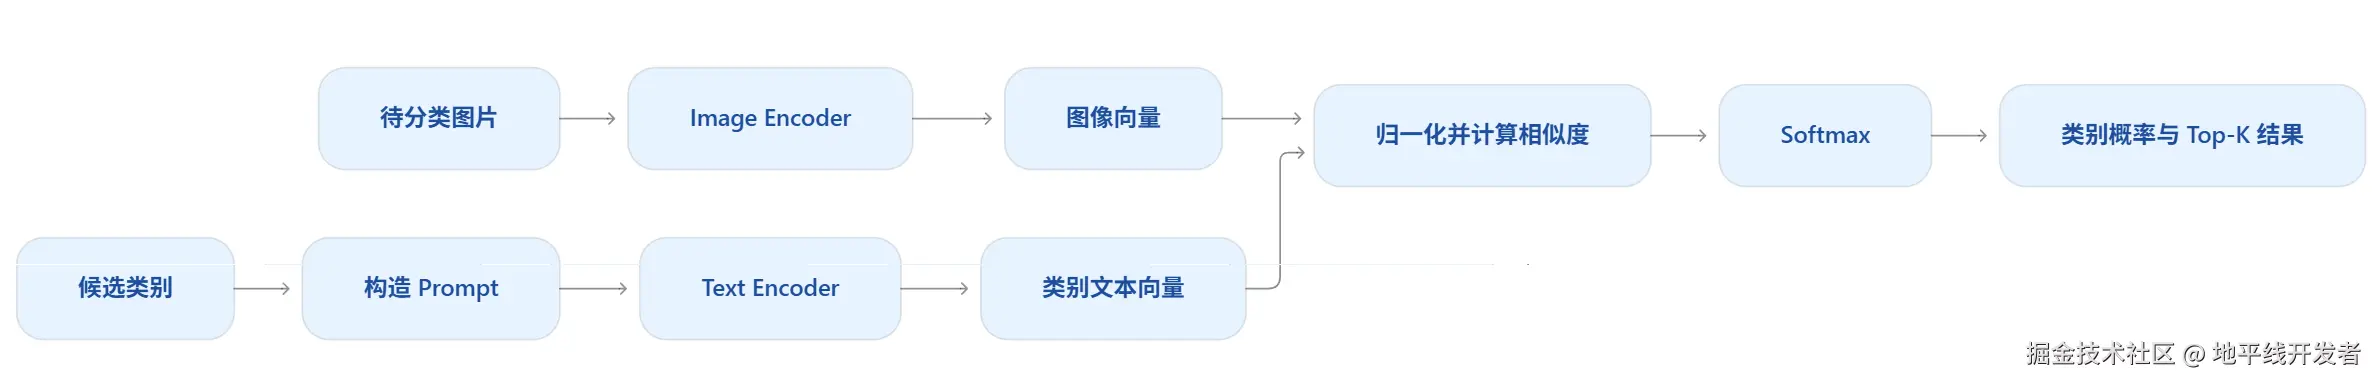
第 1 步:确定候选类别
CLIP 不会凭空输出任意类别。使用它做分类时,我们要先给出包含 K 个类别的候选集合:
ini
候选类别集合 C = {类别 1, 类别 2, ..., 类别 K}例如:
python
class_names = ["cat", "dog", "car"]这一点非常重要:零样本分类仍然是一个 闭集选择问题。如果真实内容不属于任何候选类别,模型通常也会被迫从现有选项中挑一个最相似的。
第 2 步:把类别放进 Prompt
相比孤立的类别名称,完整的自然语言描述通常更接近 CLIP 训练时见到的文本形式:
python
prompts = [f"a photo of a {name}" for name in class_names]于是我们得到:
css
a photo of a cat
a photo of a dog
a photo of a car
第 3 步:分别编码图像和文本
图片经过 Image Encoder,得到图像向量:
ini
图像向量 v = Image Encoder(输入图片 x)每条 Prompt 经过 Text Encoder,得到文本向量:
css
第 i 个文本向量 t_i = Text Encoder(第 i 个类别的 Prompt)图像编码器和文本编码器内部可以有完全不同的结构,但最终输出会被投影到同一维度,因此可以直接比较。
第 4 步:对特征做归一化
CLIP 比较的是向量方向,而不是向量长度。先对图像和文本特征做 L2 归一化:
归一化图像向量 = 图像向量 ÷ 图像向量的长度
归一化文本向量 = 文本向量 ÷ 文本向量的长度
归一化后,两个向量的点积就等于余弦相似度。
第 5 步:计算图文相似度
图像与第 i 个类别的相似度为:
css
第 i 个类别的相似度 = 归一化图像向量 · 第 i 个归一化文本向量相似度越大,说明图像与这段文本在联合特征空间中的方向越接近。 CLIP 还会使用一个训练得到的缩放系数。它也可以理解为温度参数的倒数:
缩放后的类别分数 = 相似度 ÷ 温度参数缩放不会改变类别分数的排序,但会影响 Softmax 分布的尖锐程度:温度越低,最高分对应的概率通常越集中。
第 6 步:通过 Softmax 得到相对概率
最后,对所有候选类别的分数做 Softmax:
c
某类别的相对概率
= exp(该类别分数)÷ 所有候选类别 exp(类别分数)之和
概率最大的候选类别就是最终预测:
预测结果 = 相对概率最高的候选类别假设结果为:
matlab
dog: 96.8%
cat:  2.7%
car:  0.5%
这并不等于模型有 96.8% 的把握认为世界中的真实对象一定是狗。更准确的解释是:在我们提供的三个候选文本中,a photo of a dog 与图片最匹配。 只要更改候选类别或 Prompt,Softmax 概率就可能明显变化。
四、从训练时的相似度矩阵,到推理时的类别分数
上一篇介绍过,CLIP 训练时会计算一批图像与一批文本之间的相似度矩阵。假设批次中有 N 对图文,矩阵大小就是 N × N:
css
矩阵第 i 行、第 j 列的值
= 第 i 张图片的归一化向量 · 第 j 条文本的归一化向量
训练目标是让正确配对的元素,也就是矩阵对角线上的分数更高。 零样本分类并没有引入一种全新的计算。推理时,我们只是把矩阵的一侧换成了候选类别的文本描述:
- 训练时:
N张图片与N条配对文本比较; - 分类时:一张或一批图片与
K个类别 Prompt 比较。 如果一次只输入一张图片,最终得到的就是一个1 × K的相似度向量:
arduino
                 cat       dog       car
image           0.21      0.34      0.08
因此,CLIP 的分类过程本质上仍然是一次跨模态检索:
给定一张图片,从候选文本中检索最匹配的一条。
五、Prompt 为什么会影响分类结果?
我们可能会觉得 dog 和 a photo of a dog 表达的是同一个类别,但对于文本编码器来说,它们是两组不同的 Token,也会产生不同的文本向量。 下面这些描述都包含 dog,侧重点却不完全相同:
css
dog
a photo of a dog
a close-up photo of a dog
a blurry photo of a dog
a sketch of a dog
如果输入图片是一幅素描,那么 a sketch of a dog 可能比 a photo of a dog 更贴近图片。如果任务是识别卫星影像、医学图像或商品图片,通用的 a photo of ... 也未必是最合适的模板。 这就是 Prompt Engineering 在 CLIP 中发挥作用的地方。
1. 避免只使用裸类别名
最简单的写法是:
bash
cat
dog
car
但单个词可能存在歧义。例如 crane 既可能表示鹤,也可能表示起重机。加入上下文能帮助文本编码器确定我们想表达的视觉概念:
css
a photo of a crane bird
a photo of a construction crane
2. Prompt 应该贴近任务场景
不同数据适合不同模板:
| 场景 | Prompt 示例 |
|---|---|
| 日常照片 | a photo of a {class} |
| 宠物品种 | a photo of a {class}, a type of pet |
| 食物识别 | a photo of {class}, a type of food |
| 卫星影像 | a satellite image of {class} |
| 素描识别 | a sketch of a {class} |
| 商品识别 | a product photo of a {class} |
| Prompt 并不是越长越好。无关修饰词会改变文本向量,甚至把模型注意力引向错误属性。更可靠的方法是根据图像来源和任务定义进行小规模验证。 |
3. 类别名称也需要消除歧义
只改模板还不够,类别本身也要清楚。例如,在细粒度任务中:
husky可以改成:
css
a photo of a Siberian husky dog通过加入上位概念 dog,模型更容易知道这是一个犬种,而不是人名、品牌或其他含义。
4. Prompt 的语言要与模型匹配
并非所有 CLIP 权重都具备相同的多语言能力。如果使用的是原始 OpenAI CLIP,可以先把类别映射为清晰的英文视觉描述;如果业务必须直接处理中文,则应该额外比较支持中文或多语言的模型,并在自己的数据上验证效果。 这不是简单的"中文一定不行"或"翻译成英文一定更好",关键在于当前模型的训练数据、Tokenizer 和实际任务。
六、用 Prompt Ensemble 提高稳定性
只使用一个模板,结果可能偶然偏向某种表达。一个常见方法是为每个类别准备多条 Prompt,再对它们的文本特征求平均。 例如,为 dog 构造:
css
a photo of a dog
a close-up photo of a dog
a clear photo of a dog
a photo of the dog
假设一个类别有 M 个 Prompt,我们先分别得到并归一化这 M 个文本特征,然后求平均:
类别平均特征
=(Prompt 1 特征 + Prompt 2 特征 + ... + Prompt M 特征)÷ M
然后再次归一化:
最终类别向量 = 类别平均特征 ÷ 类别平均特征的长度最终用这个经过再次归一化的向量代表整个类别。 这里有一个容易忽略的细节:每条 Prompt 的特征先归一化,平均之后还要再归一化一次。 Prompt Ensemble 可以减少模型对某个固定措辞的依赖,但它不是保证提升准确率的魔法。模板仍然应该与任务相关,并通过验证集比较。
七、用 OpenCLIP 实现零样本分类
下面用 OpenCLIP 完成一次端到端推理。代码会读取一张本地图片,并在给定的候选类别中输出 Top-K 结果。
1. 安装依赖
bash
pip install torch torchvision open_clip_torch pillow第一次运行时需要下载预训练权重。下载完成后,模型会缓存在本地。
2. 完整代码
把待分类图片保存为 test.jpg,然后运行:
python
from pathlib import Path

import open_clip
import torch
from PIL import Image

# --------------------------------------------------
# 1. 基本配置
# --------------------------------------------------
IMAGE_PATH = Path("test.jpg")
MODEL_NAME = "ViT-B-32"
PRETRAINED = "openai"

# 类别使用英文描述,输出时再映射回中文。
classes = [
    ("cat", "猫"),
    ("dog", "狗"),
    ("car", "汽车"),
    ("airplane", "飞机"),
]

device = "cuda" if torch.cuda.is_available() else "cpu"

# --------------------------------------------------
# 2. 加载模型、预处理和 Tokenizer
# --------------------------------------------------
model, _, preprocess = open_clip.create_model_and_transforms(
    MODEL_NAME,
    pretrained=PRETRAINED,
    device=device,
)
tokenizer = open_clip.get_tokenizer(MODEL_NAME)
model.eval()

# --------------------------------------------------
# 3. 准备图像和文本
# --------------------------------------------------
image = Image.open(IMAGE_PATH).convert("RGB")
image_tensor = preprocess(image).unsqueeze(0).to(device)

english_names = [english for english, _ in classes]
prompts = [f"a photo of a {name}" for name in english_names]
text_tokens = tokenizer(prompts).to(device)

# --------------------------------------------------
# 4. 提取特征并计算概率
# --------------------------------------------------
with torch.inference_mode():
    image_features = model.encode_image(image_tensor)
    text_features = model.encode_text(text_tokens)

    # L2 归一化,使点积等价于余弦相似度。
    image_features = image_features / image_features.norm(
        dim=-1, keepdim=True
    )
    text_features = text_features / text_features.norm(
        dim=-1, keepdim=True
    )

    # 使用模型学习到的缩放系数。
    logit_scale = model.logit_scale.exp()
    logits = logit_scale * image_features @ text_features.T
    probabilities = logits.softmax(dim=-1)[0]

# --------------------------------------------------
# 5. 输出 Top-K 结果
# --------------------------------------------------
top_k = min(3, len(classes))
top_probabilities, top_indices = probabilities.topk(top_k)

print(f"device: {device}")
print(f"image:  {IMAGE_PATH.resolve()}")
print("prediction:")

for probability, index in zip(top_probabilities, top_indices):
    english, chinese = classes[index.item()]
    print(
        f"  {chinese:<6} ({english:<10}) "
        f"{probability.item():.2%}"
    )
可能得到类似输出:
vbnet
device: cuda
image:  /path/to/test.jpg
prediction:
  狗     (dog       ) 96.81%
  猫     (cat       )  2.74%
  汽车   (car       )  0.31%
具体数值取决于输入图片、候选类别、Prompt、模型权重和运行环境。上面的结果只是输出格式示例,不代表固定的实验结果。
3. 代码与公式如何对应?
图像编码:
python
image_features = model.encode_image(image_tensor)文本编码:
python
text_features = model.encode_text(text_tokens)特征归一化:
python
image_features = image_features / image_features.norm(dim=-1, keepdim=True)
text_features = text_features / text_features.norm(dim=-1, keepdim=True)
计算缩放后的余弦相似度:
python
logits = model.logit_scale.exp() * image_features @ text_features.T在候选类别之间计算 Softmax:
python
probabilities = logits.softmax(dim=-1)可以看到,整个零样本分类过程没有反向传播、优化器或参数更新。模型只进行了一次前向推理。
八、把代码升级为 Prompt Ensemble
下面的函数可以为每个类别生成多条文本,并把它们合成为一个类别向量:
python
import torch
import torch.nn.functional as F

def build_zeroshot_classifier(
    model,
    tokenizer,
    class_names,
    templates,
    device,
):
    """为每个类别构造一个经过 Prompt Ensemble 的文本向量。"""
    class_features = []

    with torch.inference_mode():
        for class_name in class_names:
            prompts = [template.format(class_name) for template in templates]
            tokens = tokenizer(prompts).to(device)

            prompt_features = model.encode_text(tokens)
            prompt_features = F.normalize(prompt_features, dim=-1)

            # 多条 Prompt 的特征求平均,再归一化。
            class_feature = prompt_features.mean(dim=0)
            class_feature = F.normalize(class_feature, dim=0)
            class_features.append(class_feature)

    # [类别数, 特征维度]
    return torch.stack(class_features, dim=0)

templates = [
    "a photo of a {}",
    "a clear photo of a {}",
    "a close-up photo of a {}",
    "a photo of the {}",
]

english_names = ["cat", "dog", "car", "airplane"]

class_features = build_zeroshot_classifier(
    model=model,
    tokenizer=tokenizer,
    class_names=english_names,
    templates=templates,
    device=device,
)

with torch.inference_mode():
    image_features = model.encode_image(image_tensor)
    image_features = F.normalize(image_features, dim=-1)

    logits = model.logit_scale.exp() * image_features @ class_features.T
    probabilities = logits.softmax(dim=-1)[0]
如果需要对大量图片进行分类,类别文本特征只需要计算一次。之后可以缓存 class_features,每张新图片只运行图像编码器和相似度计算。
九、总结
CLIP 的零样本分类可以概括为下面五步:
- 先确定候选类别;
- 用 Prompt 把类别写成自然语言;
- 分别编码图片和文本;
- 在联合特征空间中计算余弦相似度;
- 在候选集合内选出最匹配的文本。
传统分类器把类别固化在分类头的参数中,CLIP 则用 Text Encoder 在推理时动态产生类别表示。正因为类别可以用自然语言定义,CLIP 才能在不针对每个任务重新训练的情况下,快速迁移到新的分类问题。 但这种灵活性也带来了新的问题:分类结果不再只由图片决定,还受到候选类别、类别命名和 Prompt 模板的影响。 所以,使用 CLIP 时,Prompt 不是一层无关紧要的包装,而是分类器本身的一部分。
参考资料
- Radford, A. et al. Learning Transferable Visual Models From Natural Language Supervision, 2021.
- OpenAI. CLIP: Connecting Text and Images.
- OpenAI. CLIP 官方代码仓库.
- ML Foundations. OpenCLIP 官方代码仓库.