我先说结论:把「写内容」和「排版」拆开,让模型只写内容、排版交给代码,是这次实验里收益最大的一条改动。
起因很朴素。我给模型提了个问题,让它直接给我一页 HTML 当回答。它写出来了,能用,但我数了一下 token 构成------模型生成的页面里只有 21% 是内容,剩下 79% 是 SVG 坐标、CSS 和标签。这意味着我花钱买的算力,大头花在了「把标题放在左边还是居中」这种问题上。
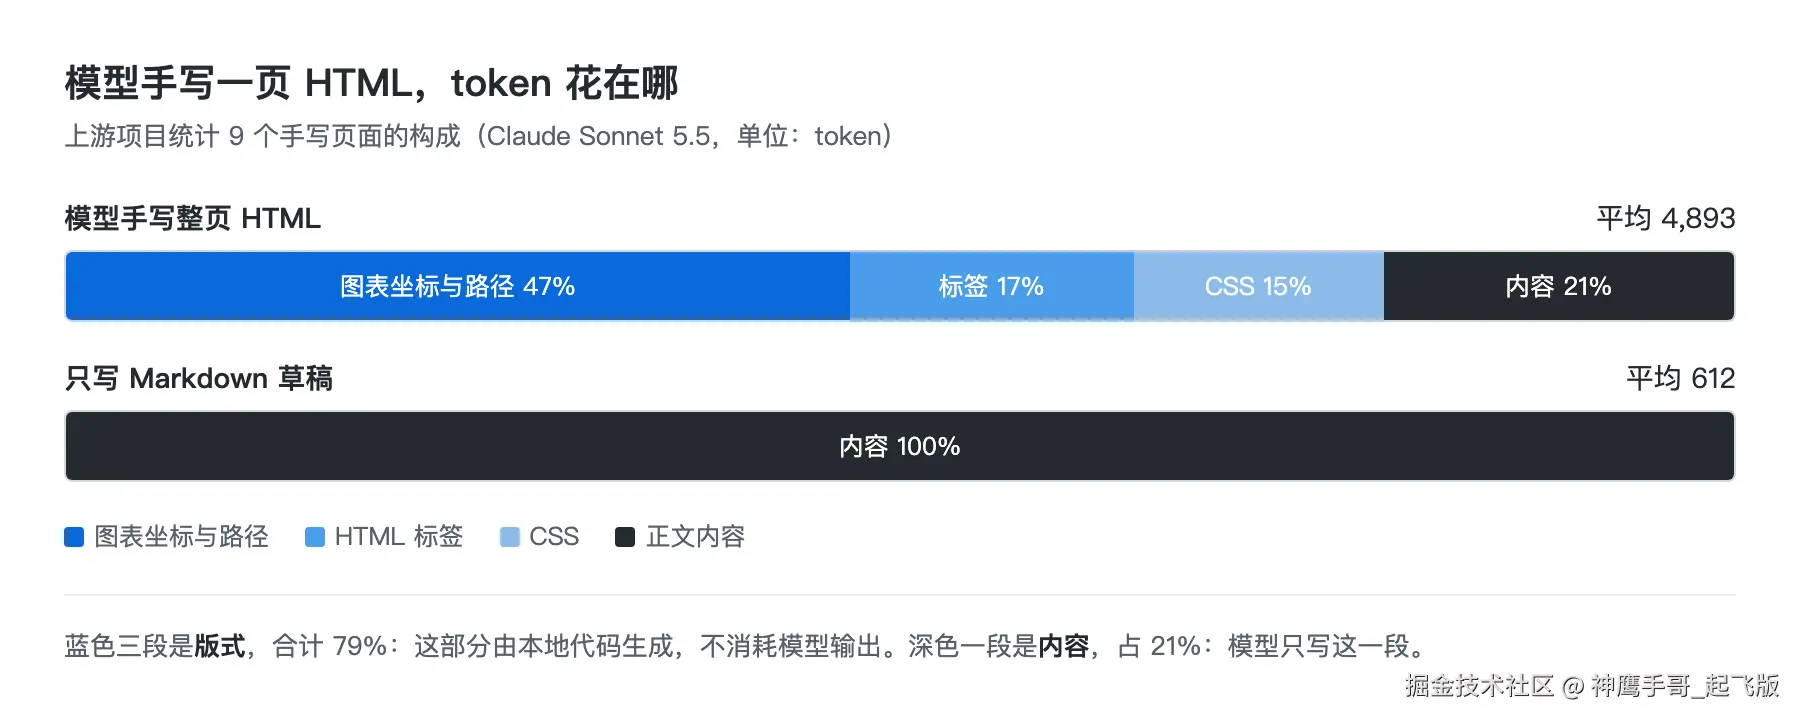
这张图把问题说清楚了:手写整页平均 4,893 token,其中图表坐标与路径占 47%、HTML 标签占 17%、CSS 占 15%,正文内容只占 21%。而走「只写 Markdown 草稿」这条路,平均 612 token,100% 是内容。
我的做法是把这两件事拆开:模型只写一份 Markdown 草稿,排版引擎在本地把它渲染成一页带图表、带主题、能直接发公众号的信息网页。 下面是我搭的这条流水线的机制和实测数据。
先看成品
同一个问题------「新手做小红书怎么起号」------模型只写了一份草稿,得到的是这一页:
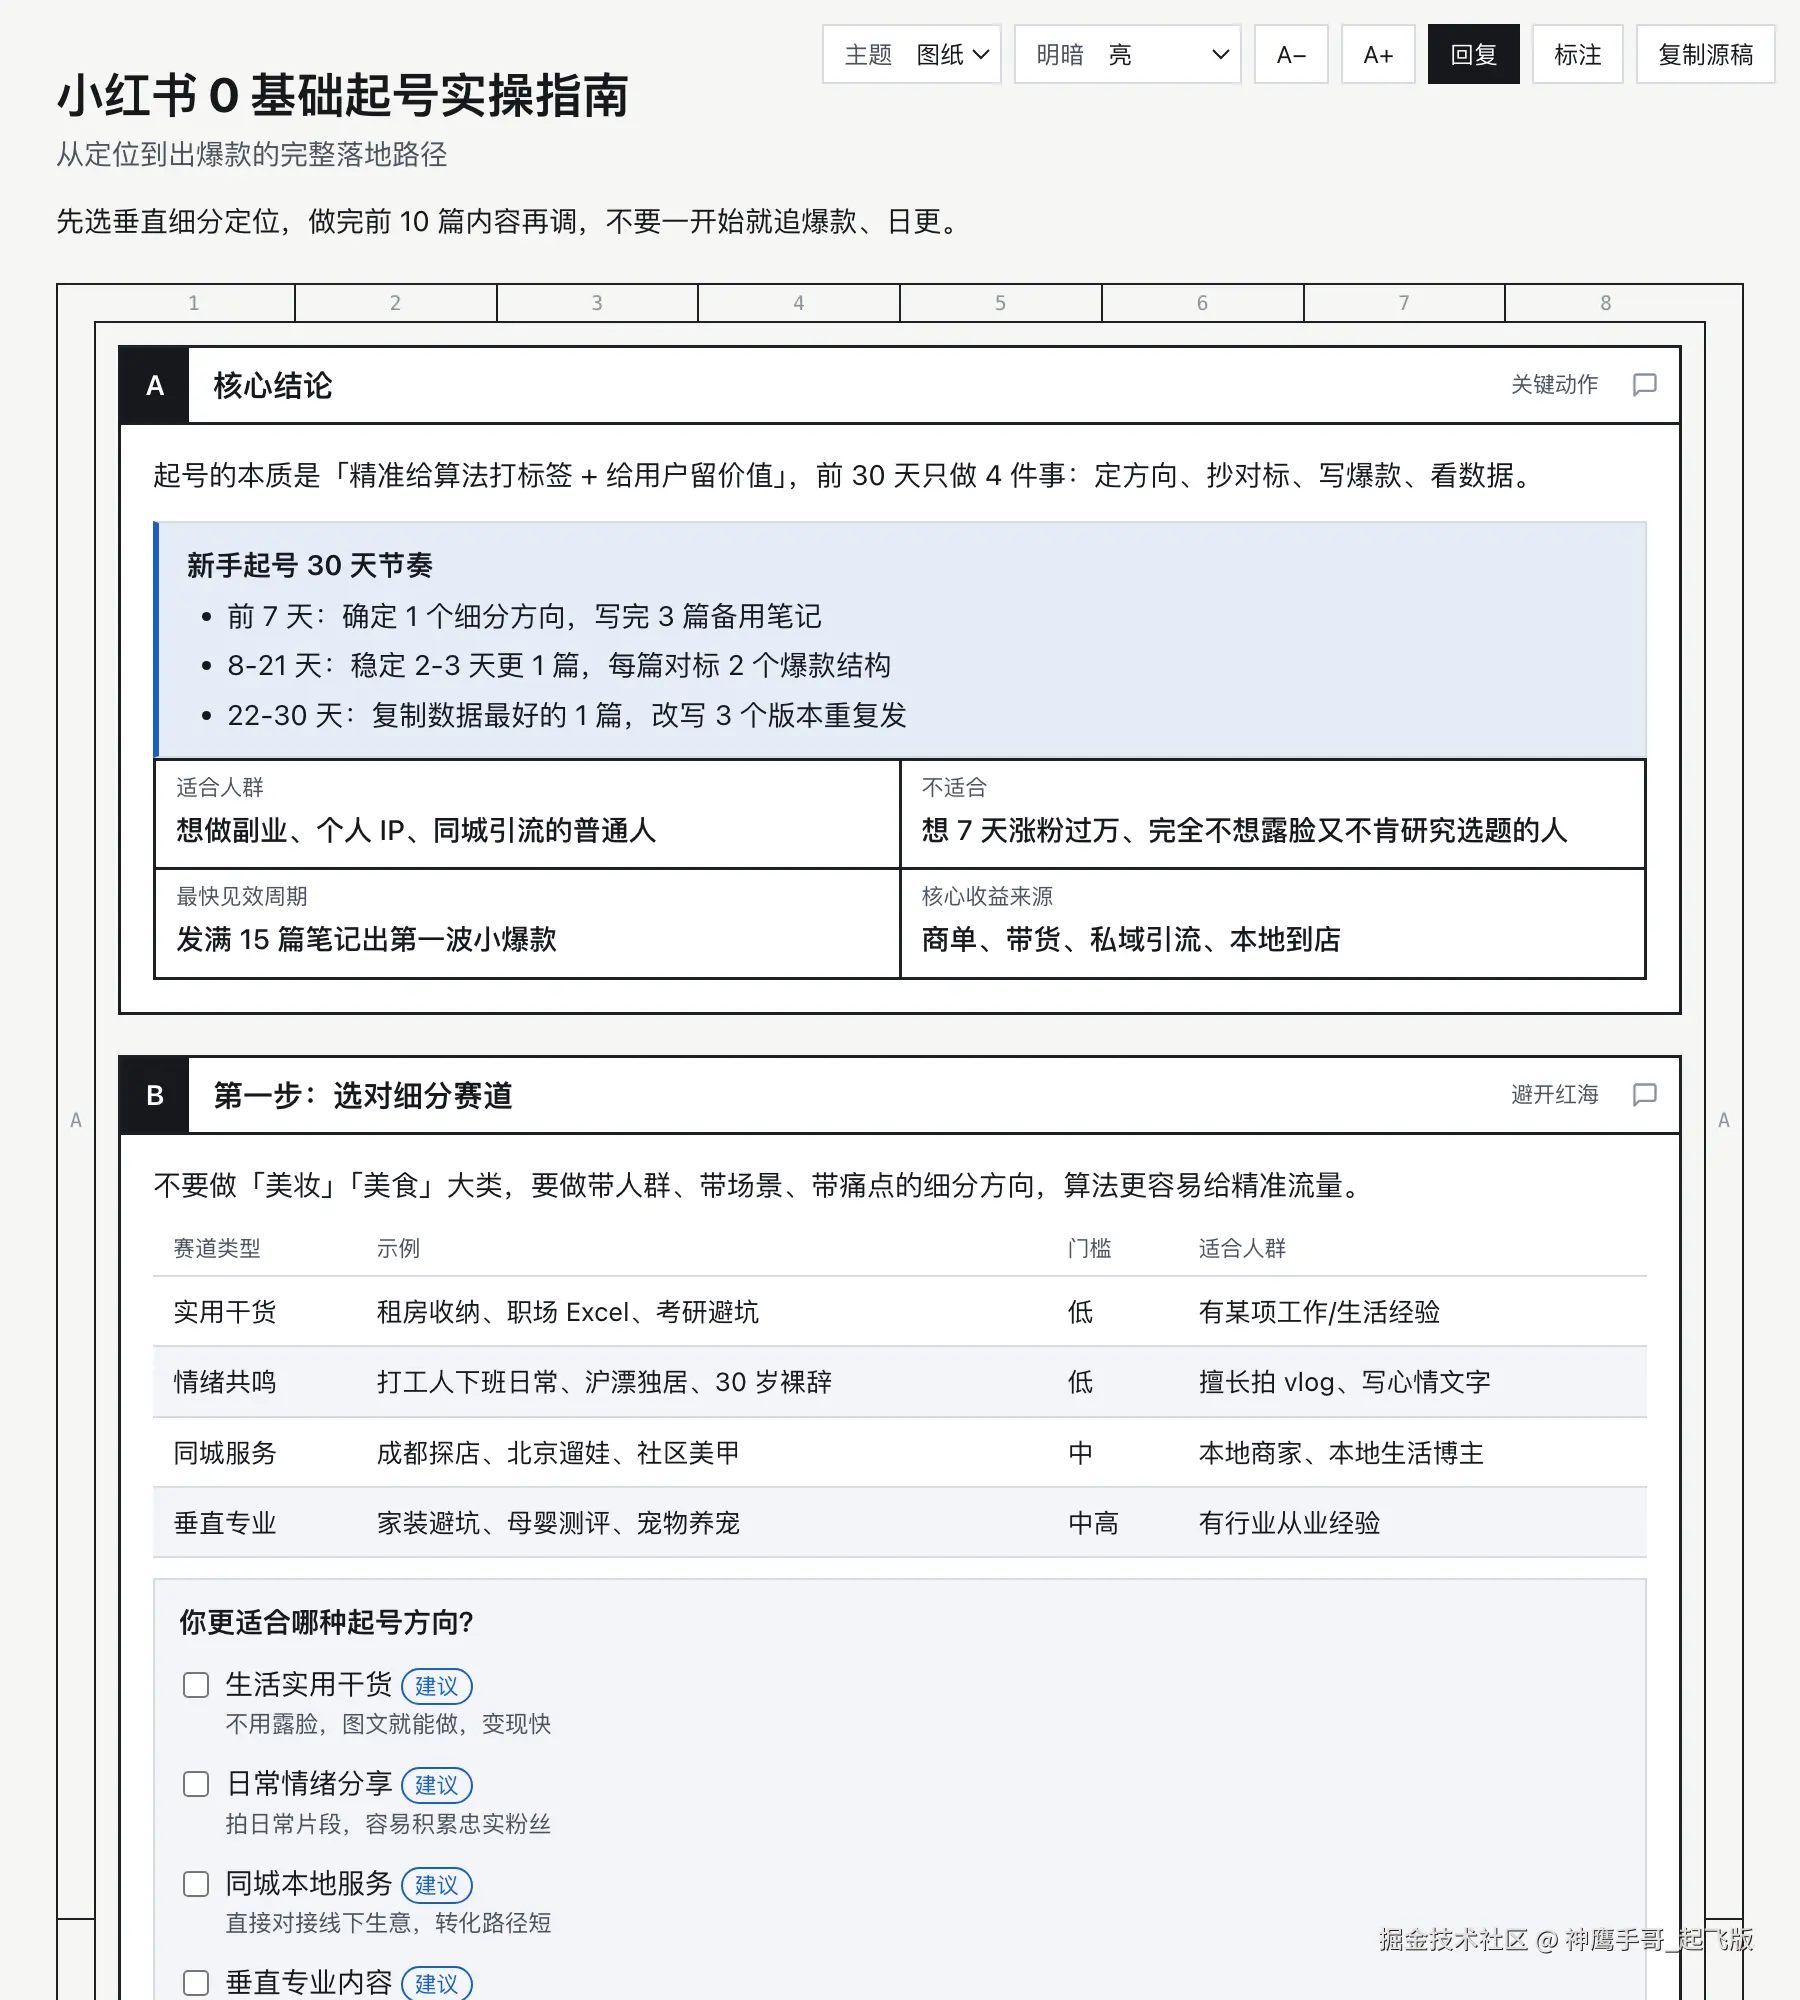
深色模式、三套主题、图表自动布局、右上角「主题 / 明暗 / 字号 / 回复 / 标注」控件,全在一个离线可开的单文件 HTML 里。模型没有写过一个 HTML 标签。
为什么模型手写 HTML 是笔糊涂账
上游项目统计了 9 个手写页面的 token 构成,模型写的东西里只有 21% 是内容:
| 页面构成 | 占比 | 这条流水线里谁写 |
|---|---|---|
| SVG 图表的坐标和路径 | 47% | 排版引擎 |
| CSS | 15% | 排版引擎 |
| HTML 标签 | 17% | 排版引擎 |
| 正文文字 | 21% | 模型(写成 Markdown) |
这 79% 的非内容 token 有三个代价:
- 慢:模型逐 token 吐坐标和标签,一个字一个字地写,比直接给内容慢得多。
- 贵:输出 token 单价通常是输入的 3 倍以上(方舟 Seed 2.1 lite 是 2.7 元 vs 0.8 元每百万),恰好浪费在最贵的那部分上。
- 质量下降:模型把注意力花在版式上,就没花在内容上。我实测的 lite 模型手写三页 HTML,三页里 0 个 SVG 图表,全是文字加表格;同题走流水线,每页自动布局的图有 4--5 个。
上游的官方基准(Claude Sonnet 5.5,3 题 × 3 轮中位数):手写整页平均 4,893 token、31 秒;走「只写草稿」这条路平均 612 token、12 秒。
流水线的机制
机制图也是这条流水线自己画的:
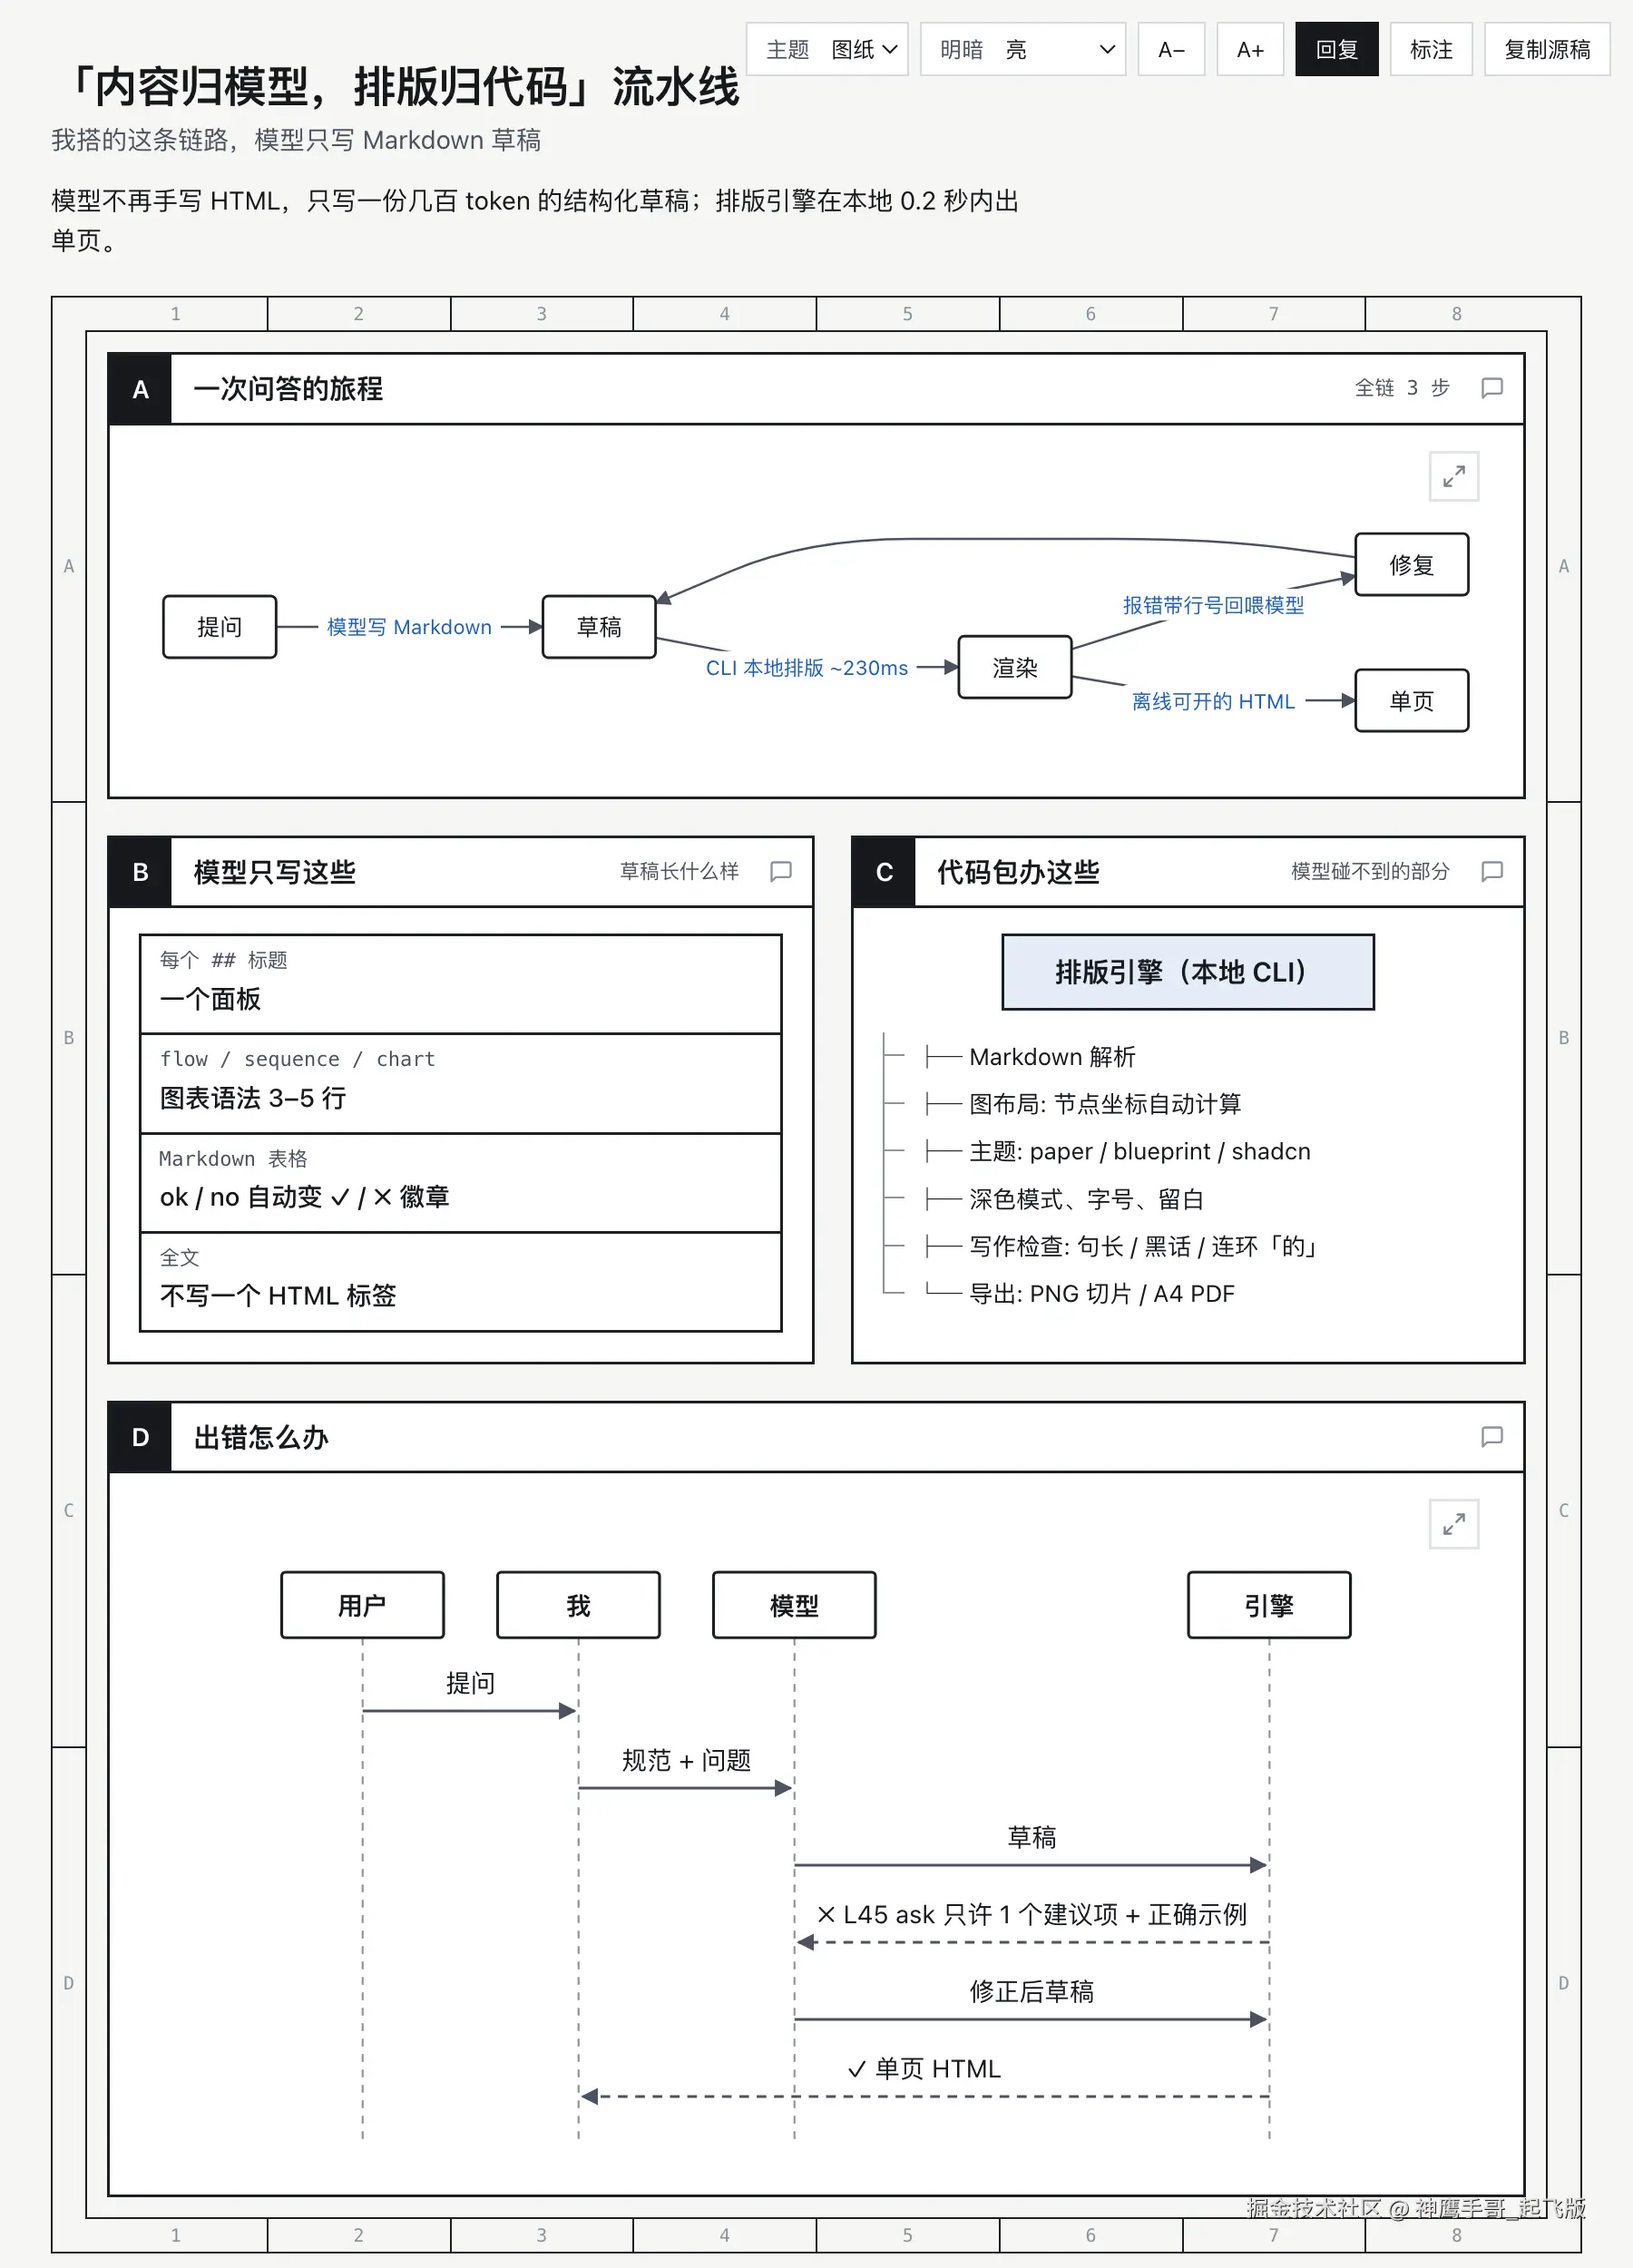
模型输出的草稿长这样,一个 ## 标题就是一个面板,图表用三五行 DSL 描述:
markdown
---
title: Redis 和 Memcached 选型指南
file: cache
---
绝大多数互联网后端缓存场景选 Redis。

## B 多维能力对比
| 维度 | Redis | Memcached |
|---|---|---|
| 数据类型 | String/Hash/List/Set/ZSet | 仅 String 键值对 |
| 持久化 | 支持 RDB/AOF 落盘 | 纯内存,重启即失 |

## C 适用场景判断
```ask
你的业务更接近哪类?
* 优先选 Redis | 需要分布式锁/排行榜/消息队列
- 仅选 Memcached | 纯简单 KV 缓存,无复杂业务逻辑
arduino
然后一条命令:

```bash
node am.mjs render 草稿.md -o 页面.html --no-open
0.2 秒后(实测 216--234ms),得到的就是上面那一页。排版引擎是一个单文件 CLI,运行时零依赖、没有 npm install 步骤,Node.js 20+ 直跑。
出错怎么办:引擎不是「渲染失败告诉你一声」,而是把错误连同行号和正确示例整份退回,让模型照着改:
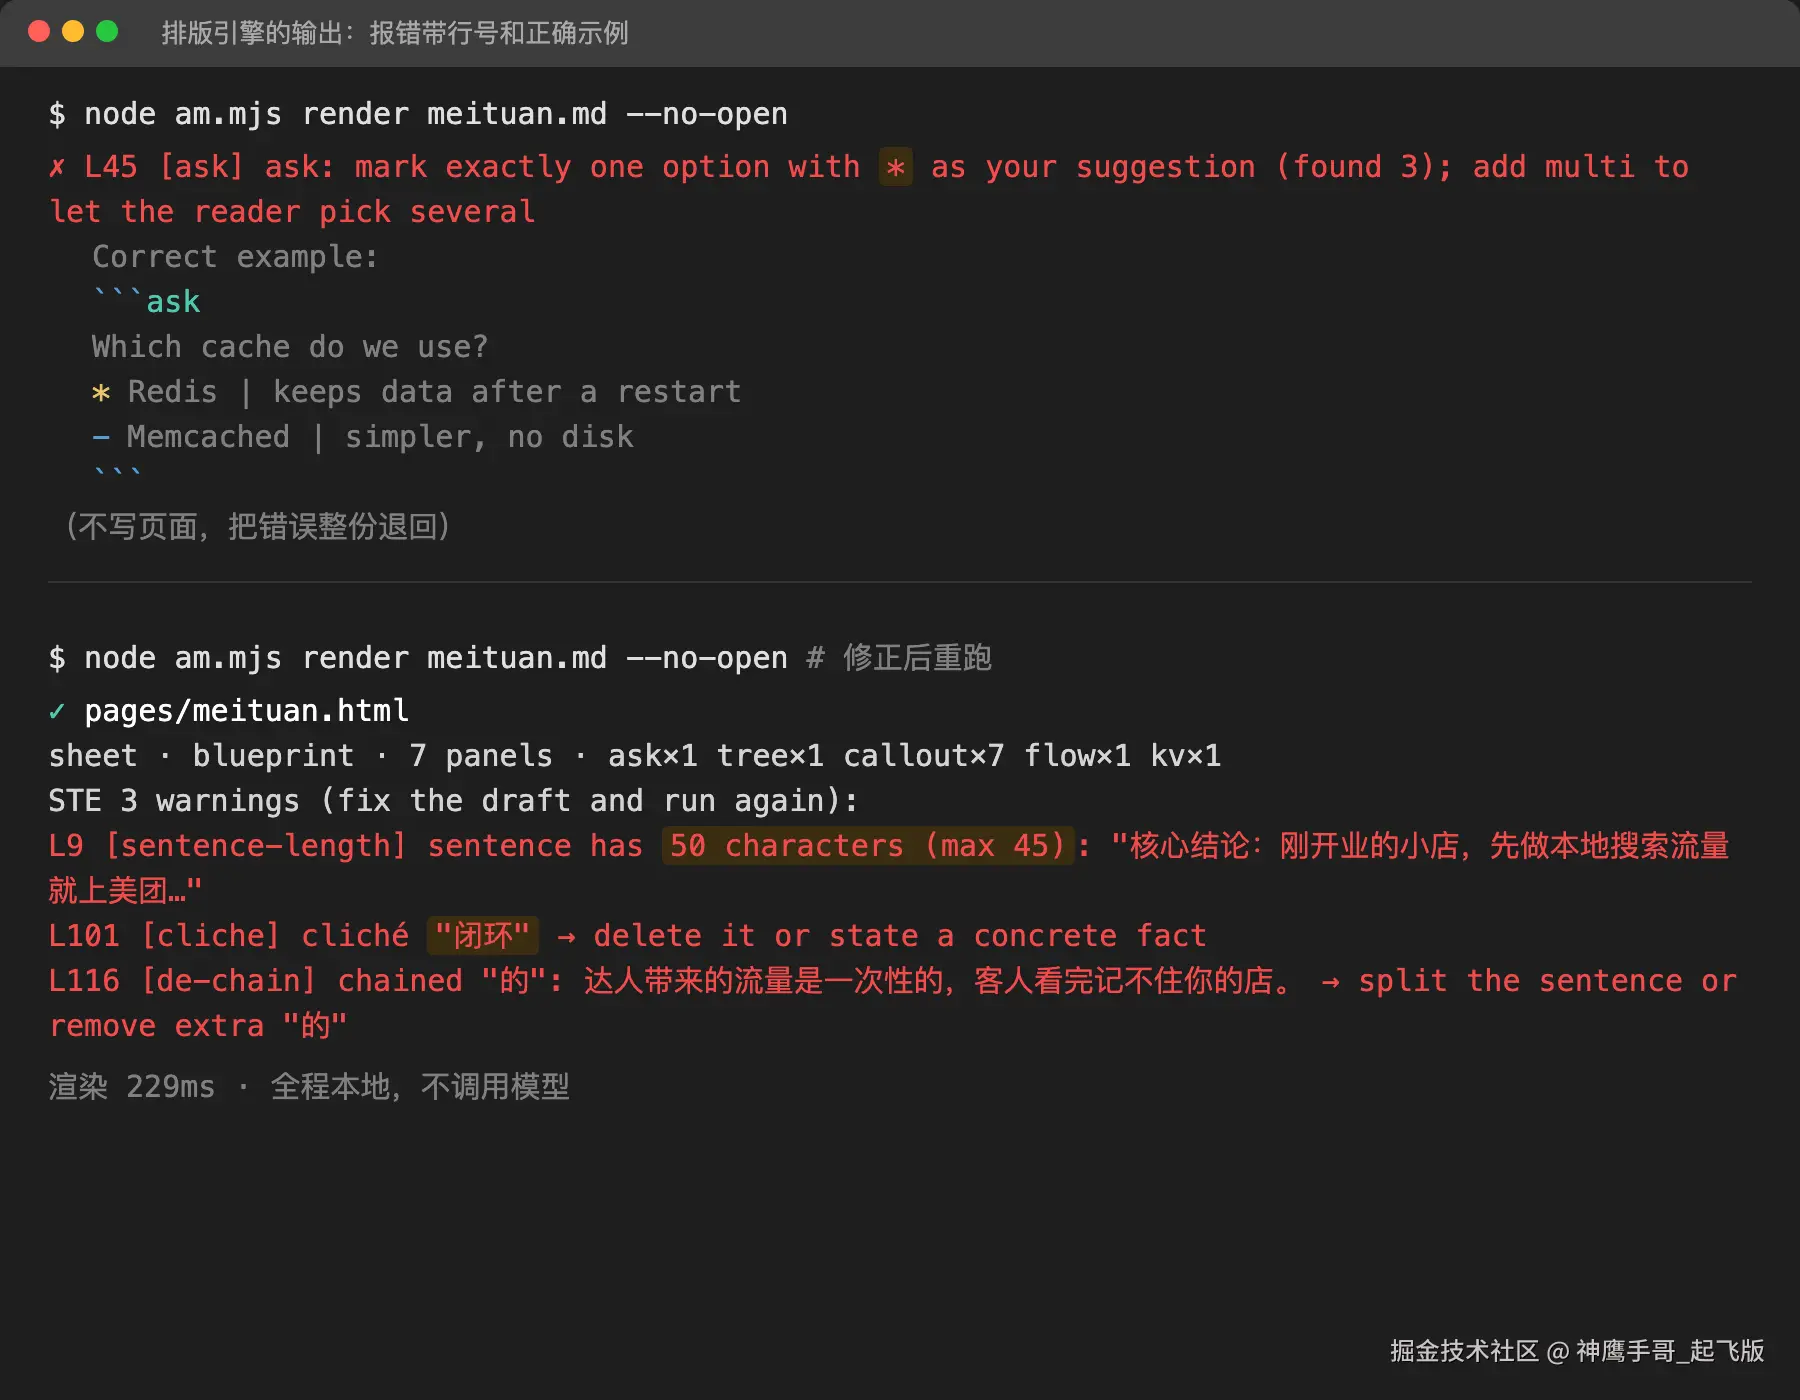
上面第一屏是硬错误(不写页面),第二屏是写作警告(页面照写,建议改)。这个闭环的价值不在「自动」,在可机器修复------不用人介入,模型自己就能过。
实测:3 个真实问题 × 2 条路线
我选了三个真会被人问的问题,跑方舟 Seed 2.1 lite(OpenAI 兼容端点,关思考),双臂对照:
- 手写臂:同一个模型直接写整页 HTML
- 流水线臂:模型只写草稿,本地渲染
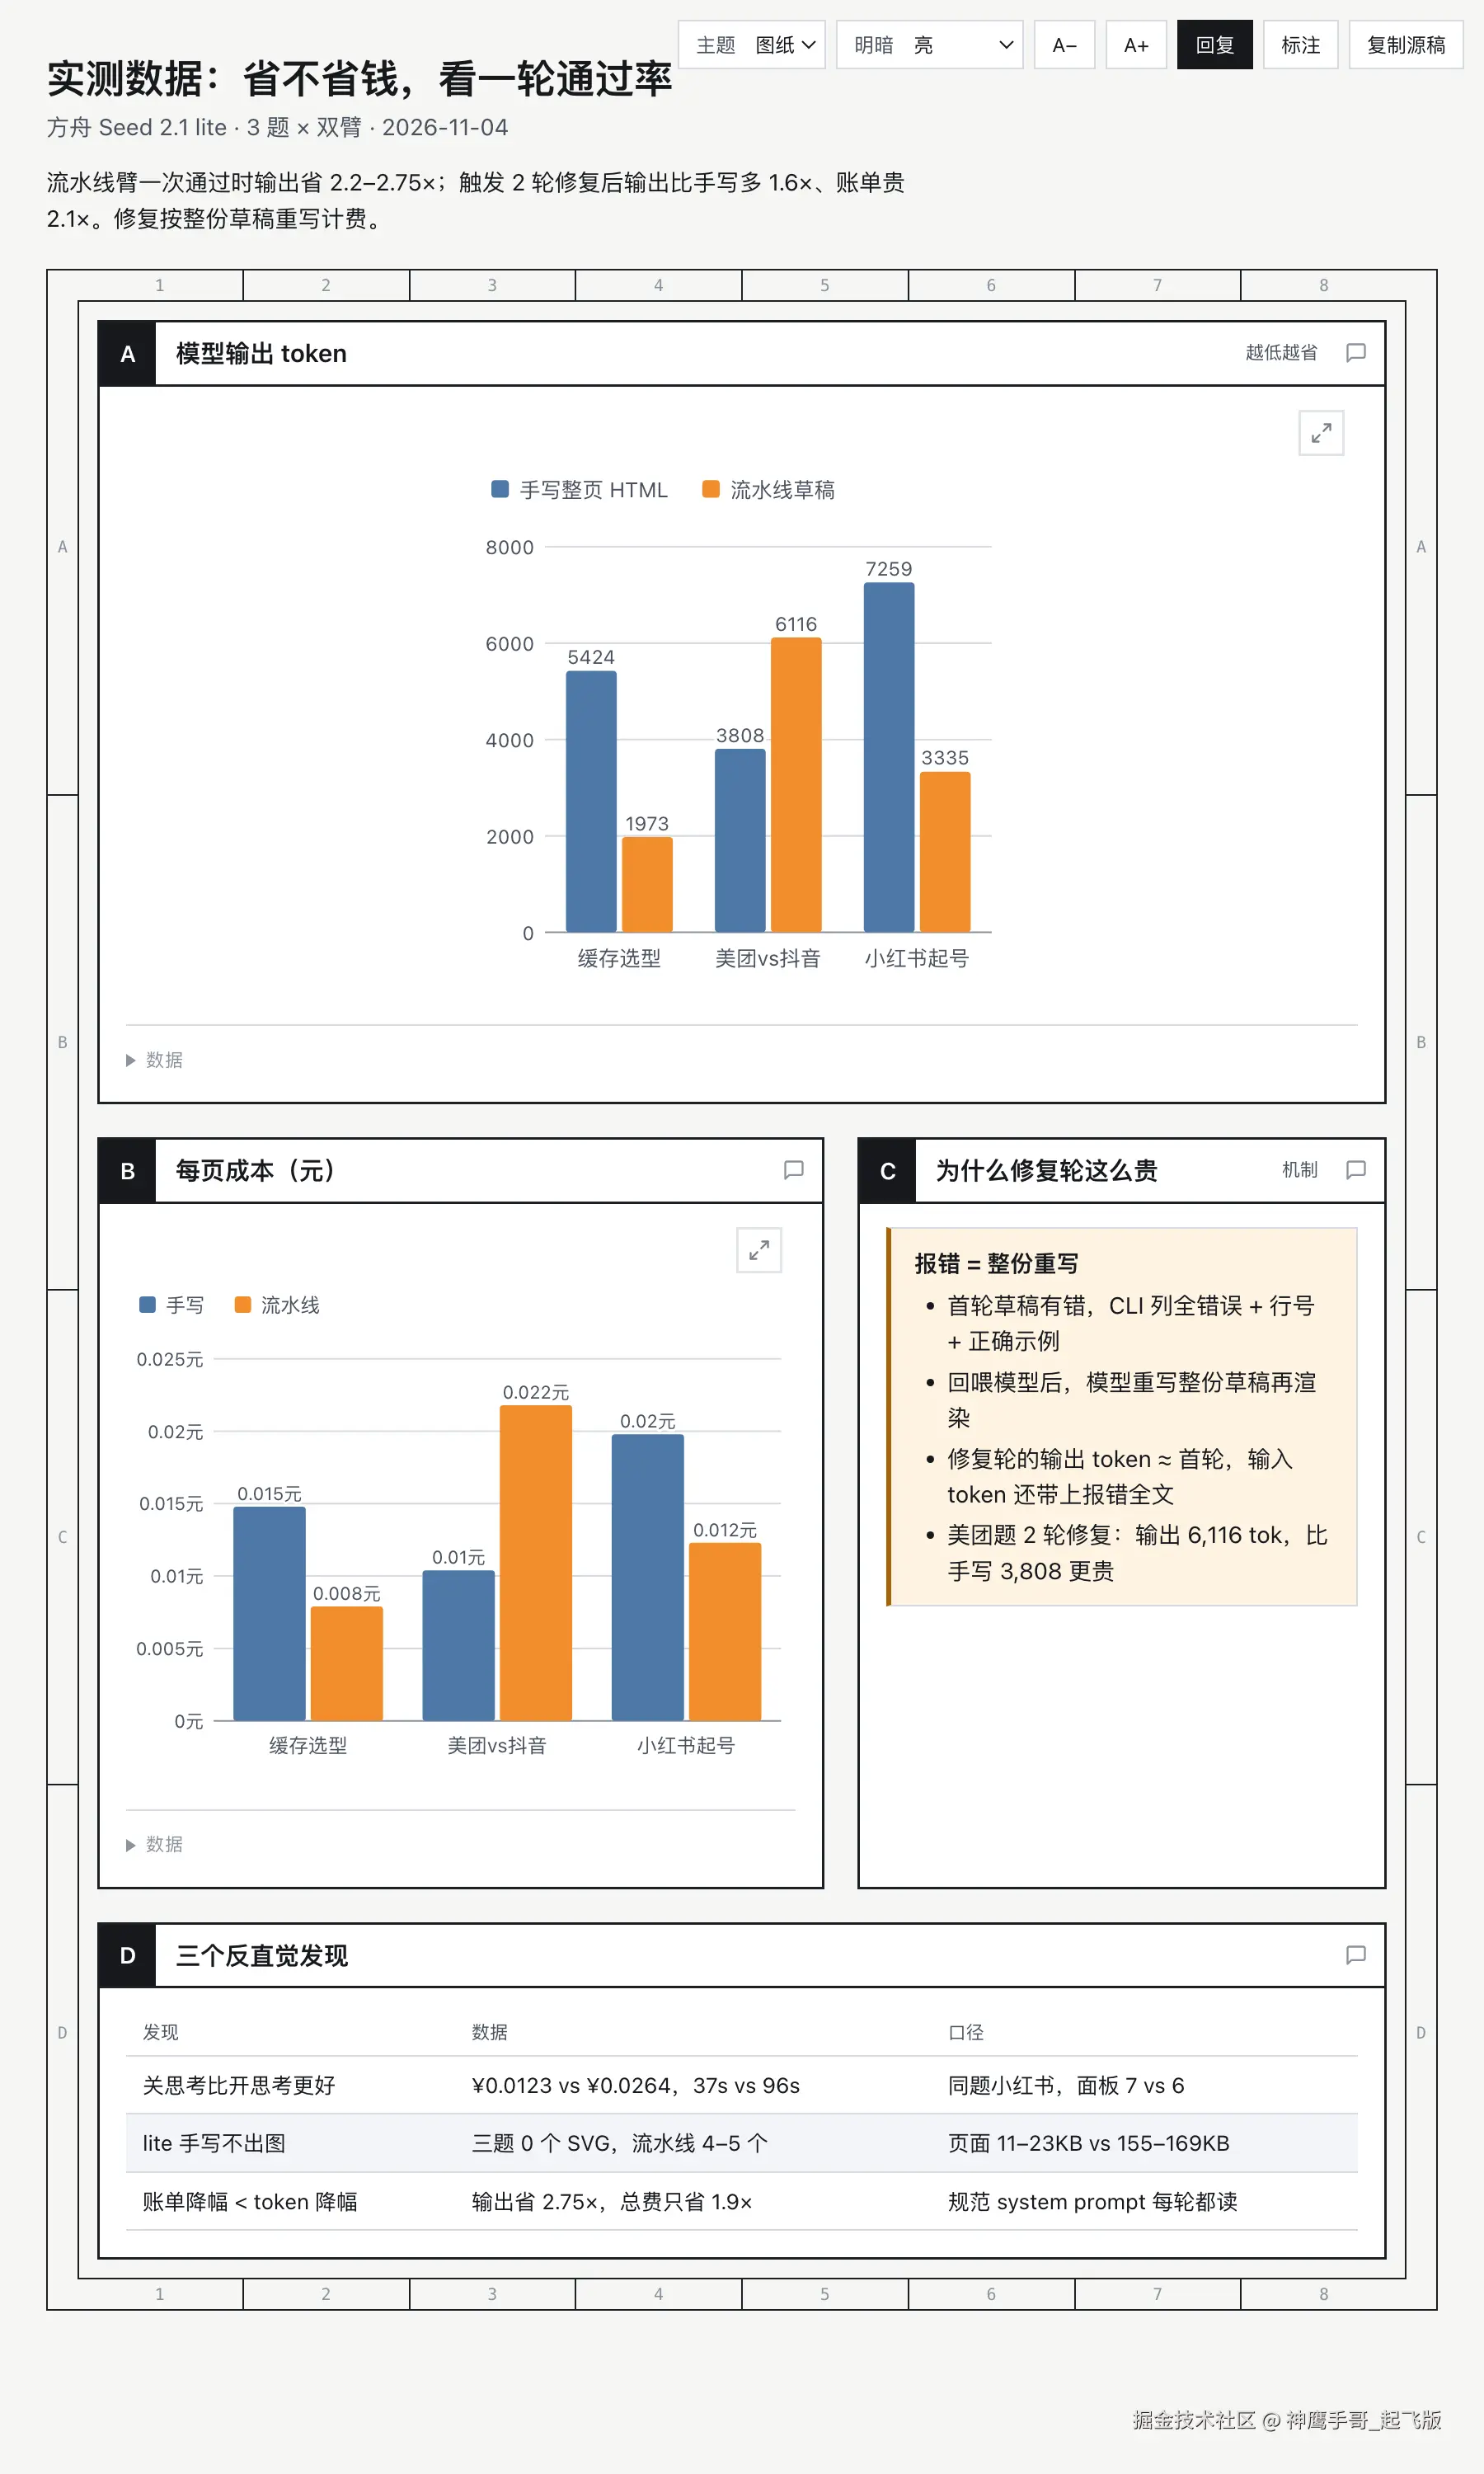
| 题 | 手写臂输出 | 流水线臂输出 | 手写成本 | 流水线成本 |
|---|---|---|---|---|
| Redis 还是 Memcached | 5,424 tok | 1,973 tok | 0.0148 元 | 0.0079 元 |
| 小店上美团还是抖音团购 | 3,808 tok | 6,116 tok ⚠️ | 0.0104 元 | 0.0218 元 ⚠️ |
| 新手做小红书怎么起号 | 7,259 tok | 3,335 tok | 0.0198 元 | 0.0123 元 |
成本按方舟官方价格页算(lite 输入 0.8 / 输出 2.7 元每百万 token)。黄色那行是流水线输了的题,原因见下面第一条。
发现一:省不省,看一轮通过率
缓存题和小红书题一次渲染通过,输出省 2.2--2.75 倍。美团题触发了两轮修复,输出比手写多 1.6 倍、账单贵 2.1 倍。
原因是修复的机制:CLI 报错后我把错误回喂给模型,模型重写整份草稿再渲染。修复轮的输出 token 跟首轮差不多,输入还多带一份报错全文。所以省钱的前提是「草稿规范写得足够严,让模型一次写对」。我第一版规范没写死 ask 组件的规则(单选只许标一个建议项),模型连错两轮;第二版把规则明确写进规范后,同题两轮内通过。
发现二:关思考比开思考更好
同一道小红书题:
| 开思考 | 关思考 | |
|---|---|---|
| 输出 token | 8,827(含 4,691 思考) | 3,335 |
| 耗时 | 96 秒 | 37 秒 |
| 成本 | 0.0264 元 | 0.0123 元 |
| 面板数 | 6 | 7 |
关思考版的面板反而更多、组件更丰富(多出图表和选择题)。写结构化草稿这件事不需要深思考,句长检查交给机器更靠谱。
发现三:账单降幅永远小于 token 降幅
缓存题输出省 2.75 倍,总费用只省 1.9 倍。因为输入端多了两笔:草稿规范约 1K token 每轮都要重读一遍,修复轮还要把上一版草稿和报错全文一起回喂(该题累计输入 3,228 token,美团题 3 次调用堆到 9,960)。
上游官方基准里同样的事:token 省 8 倍,账单只降 15%。省 token 是真的,别信「省 8 倍钱」。
质量:省 token 换来的是质量上升
这是最让我意外的一点。lite 手写臂的三页,字节数 11--23KB,通篇没有一个 SVG 图表;流水线臂 155--169KB,每页 4--5 个自动布局的流程图、时序图、柱状图。
同一个问题两个版本的首屏对比:
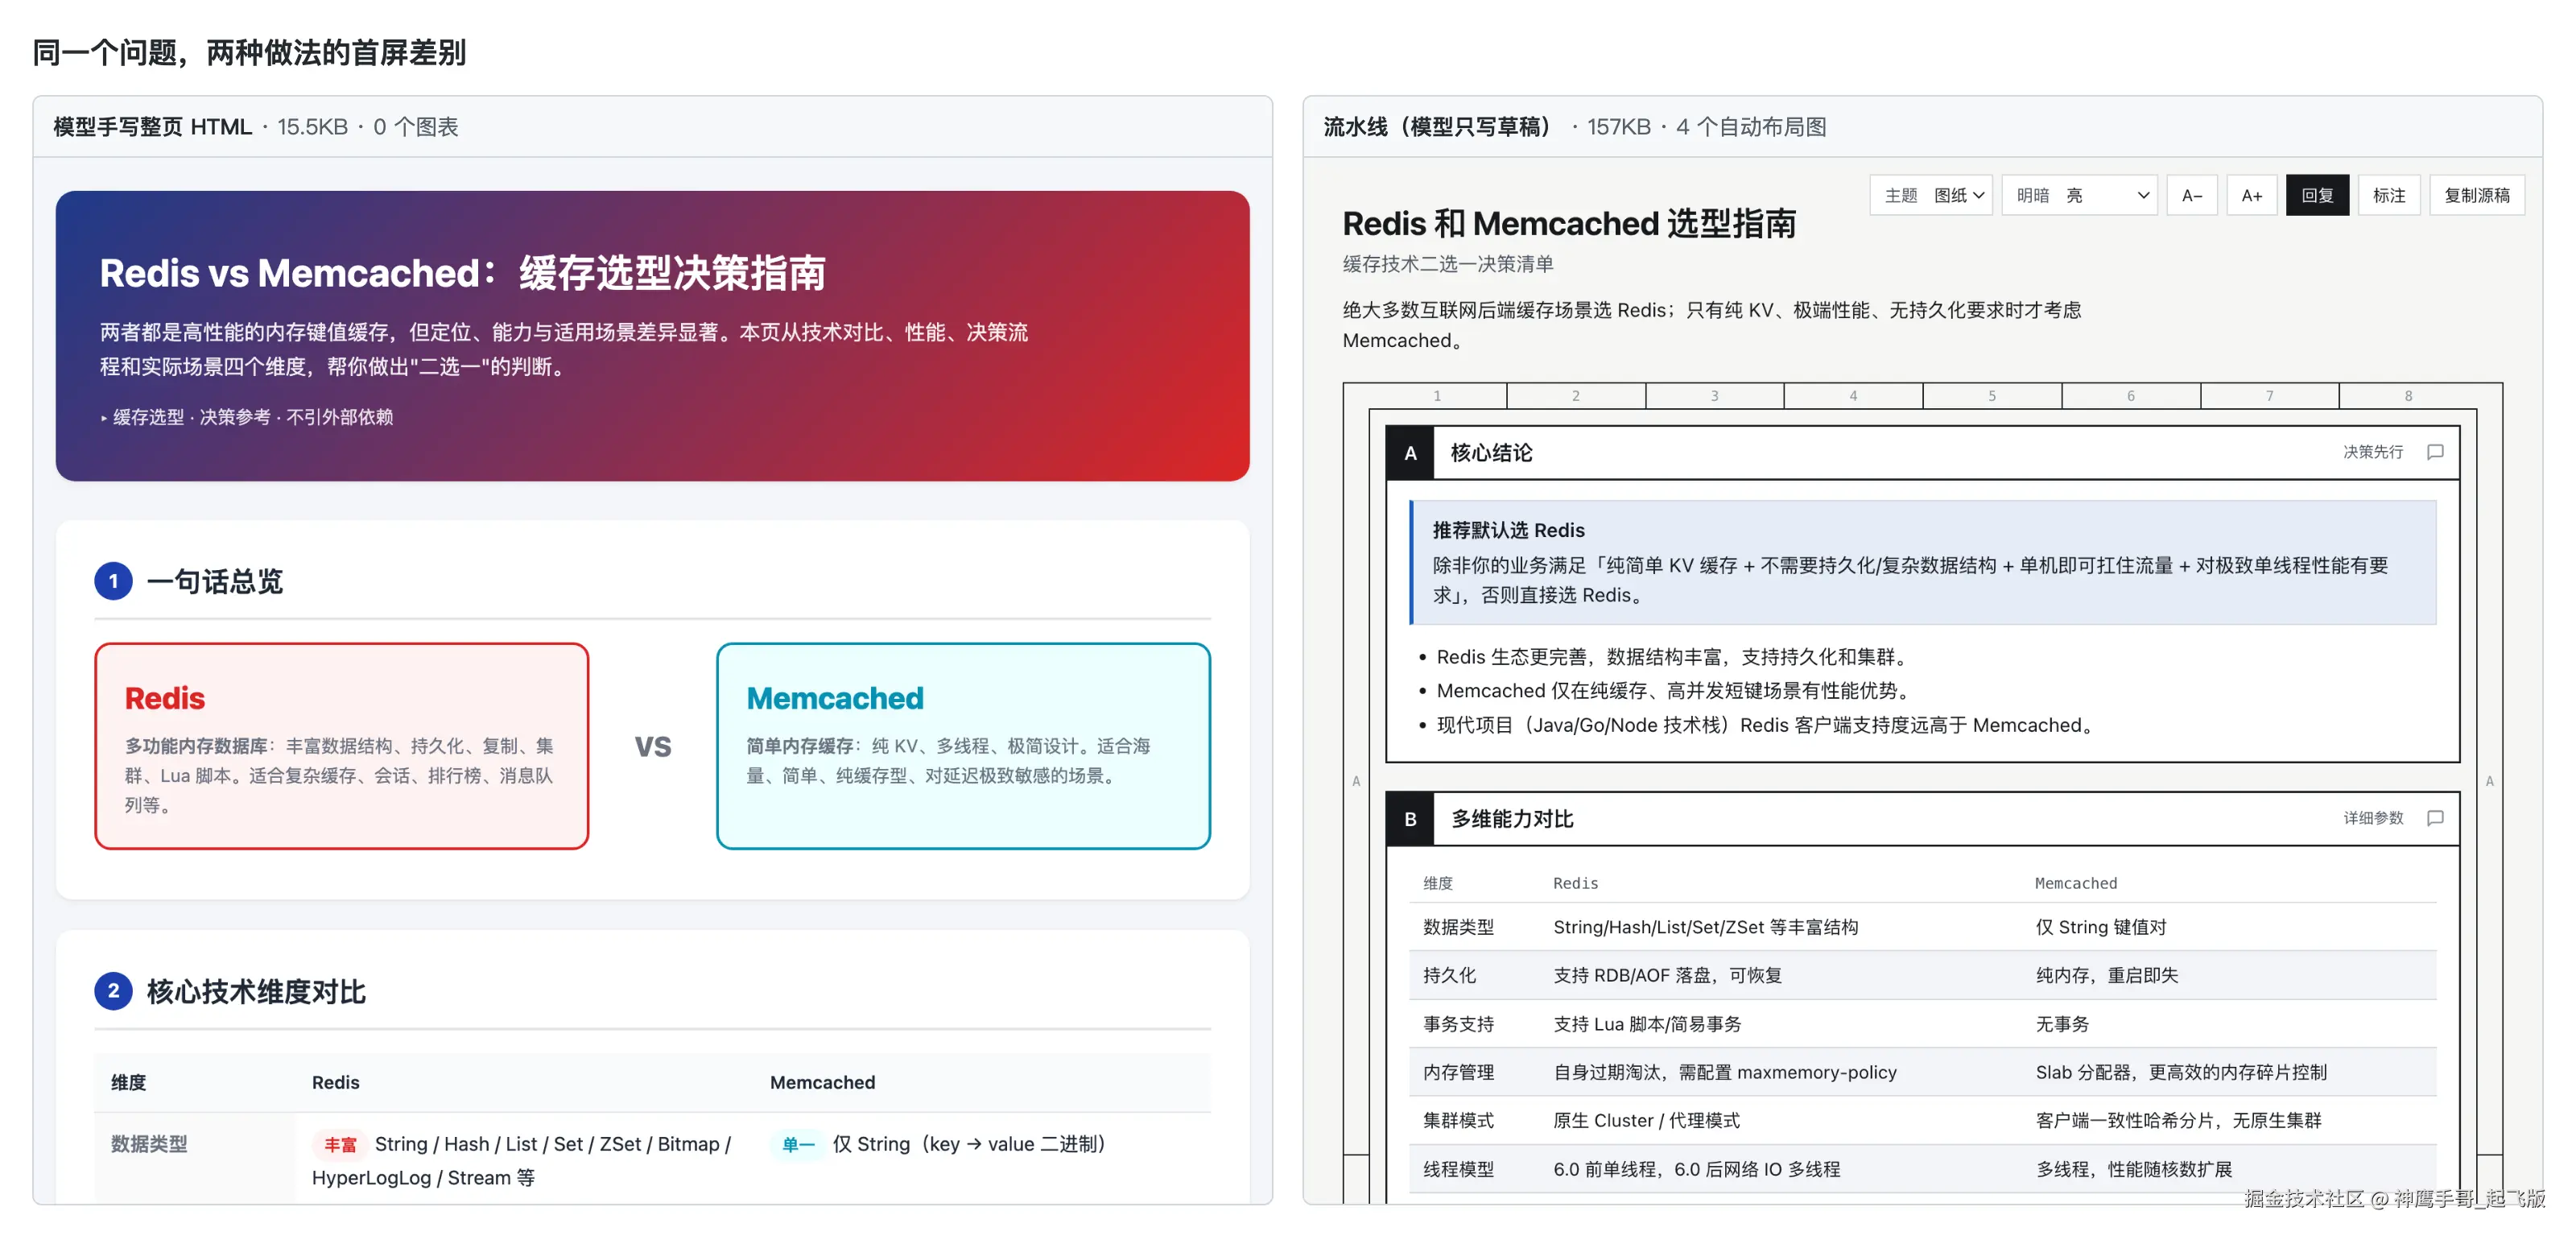
模型手写 HTML 时,坐标和标签吃掉了它的预算,它就放弃了图表;把排版外包给代码后,模型只管「这里该有个决策树」,画出来是引擎的事。分工不只是省钱,是把模型的活换成了它擅长的活。
三套主题,零额外 token
同一份草稿换个参数就是另一套视觉,模型一个字都不用多写:
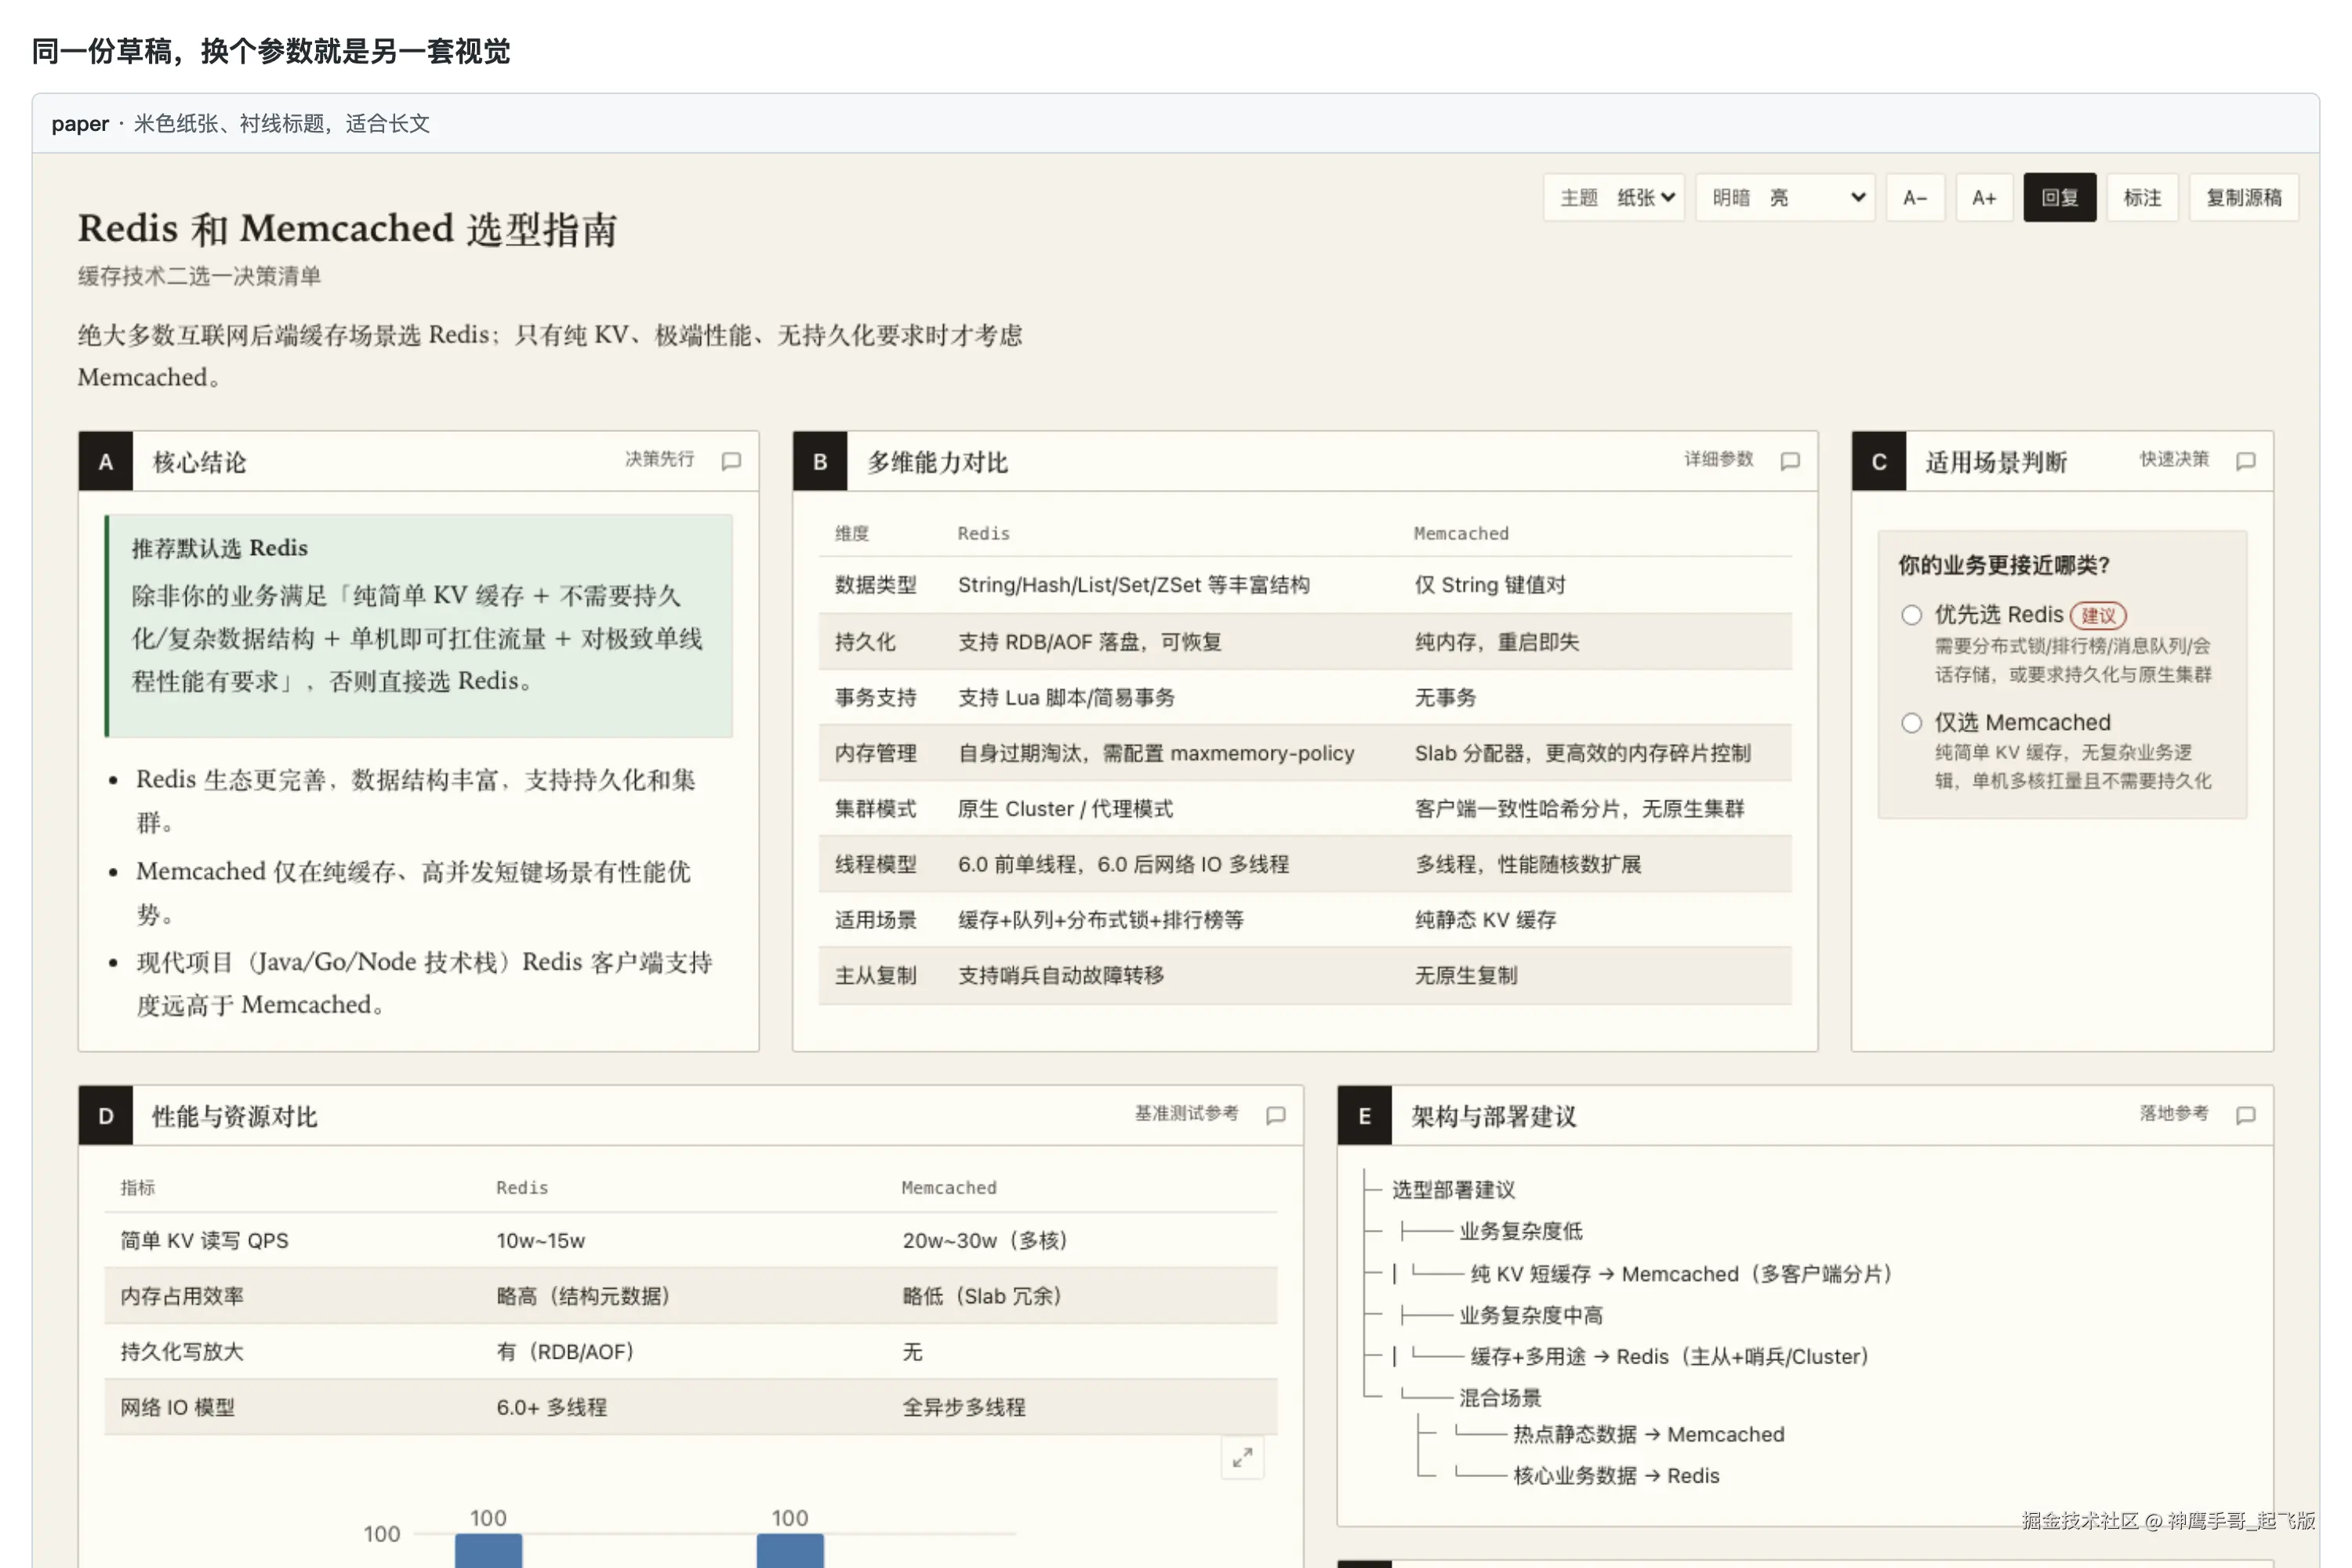
我的选型:长文为主用 paper(米色纸张、衬线标题,像杂志);图表多用 blueprint(工程蓝图风,深色最抓眼);要发产品感的内容用 shadcn(卡片风)。
写作检查器:管得住形式,管不住事实
排版引擎内置一套受控写作检查(源自航空维修手册的 ASD-STE100 规范,中文规则另有适配):句子长度、黑话、连环「的」、段落句数。美团题首轮草稿被逐行点名:
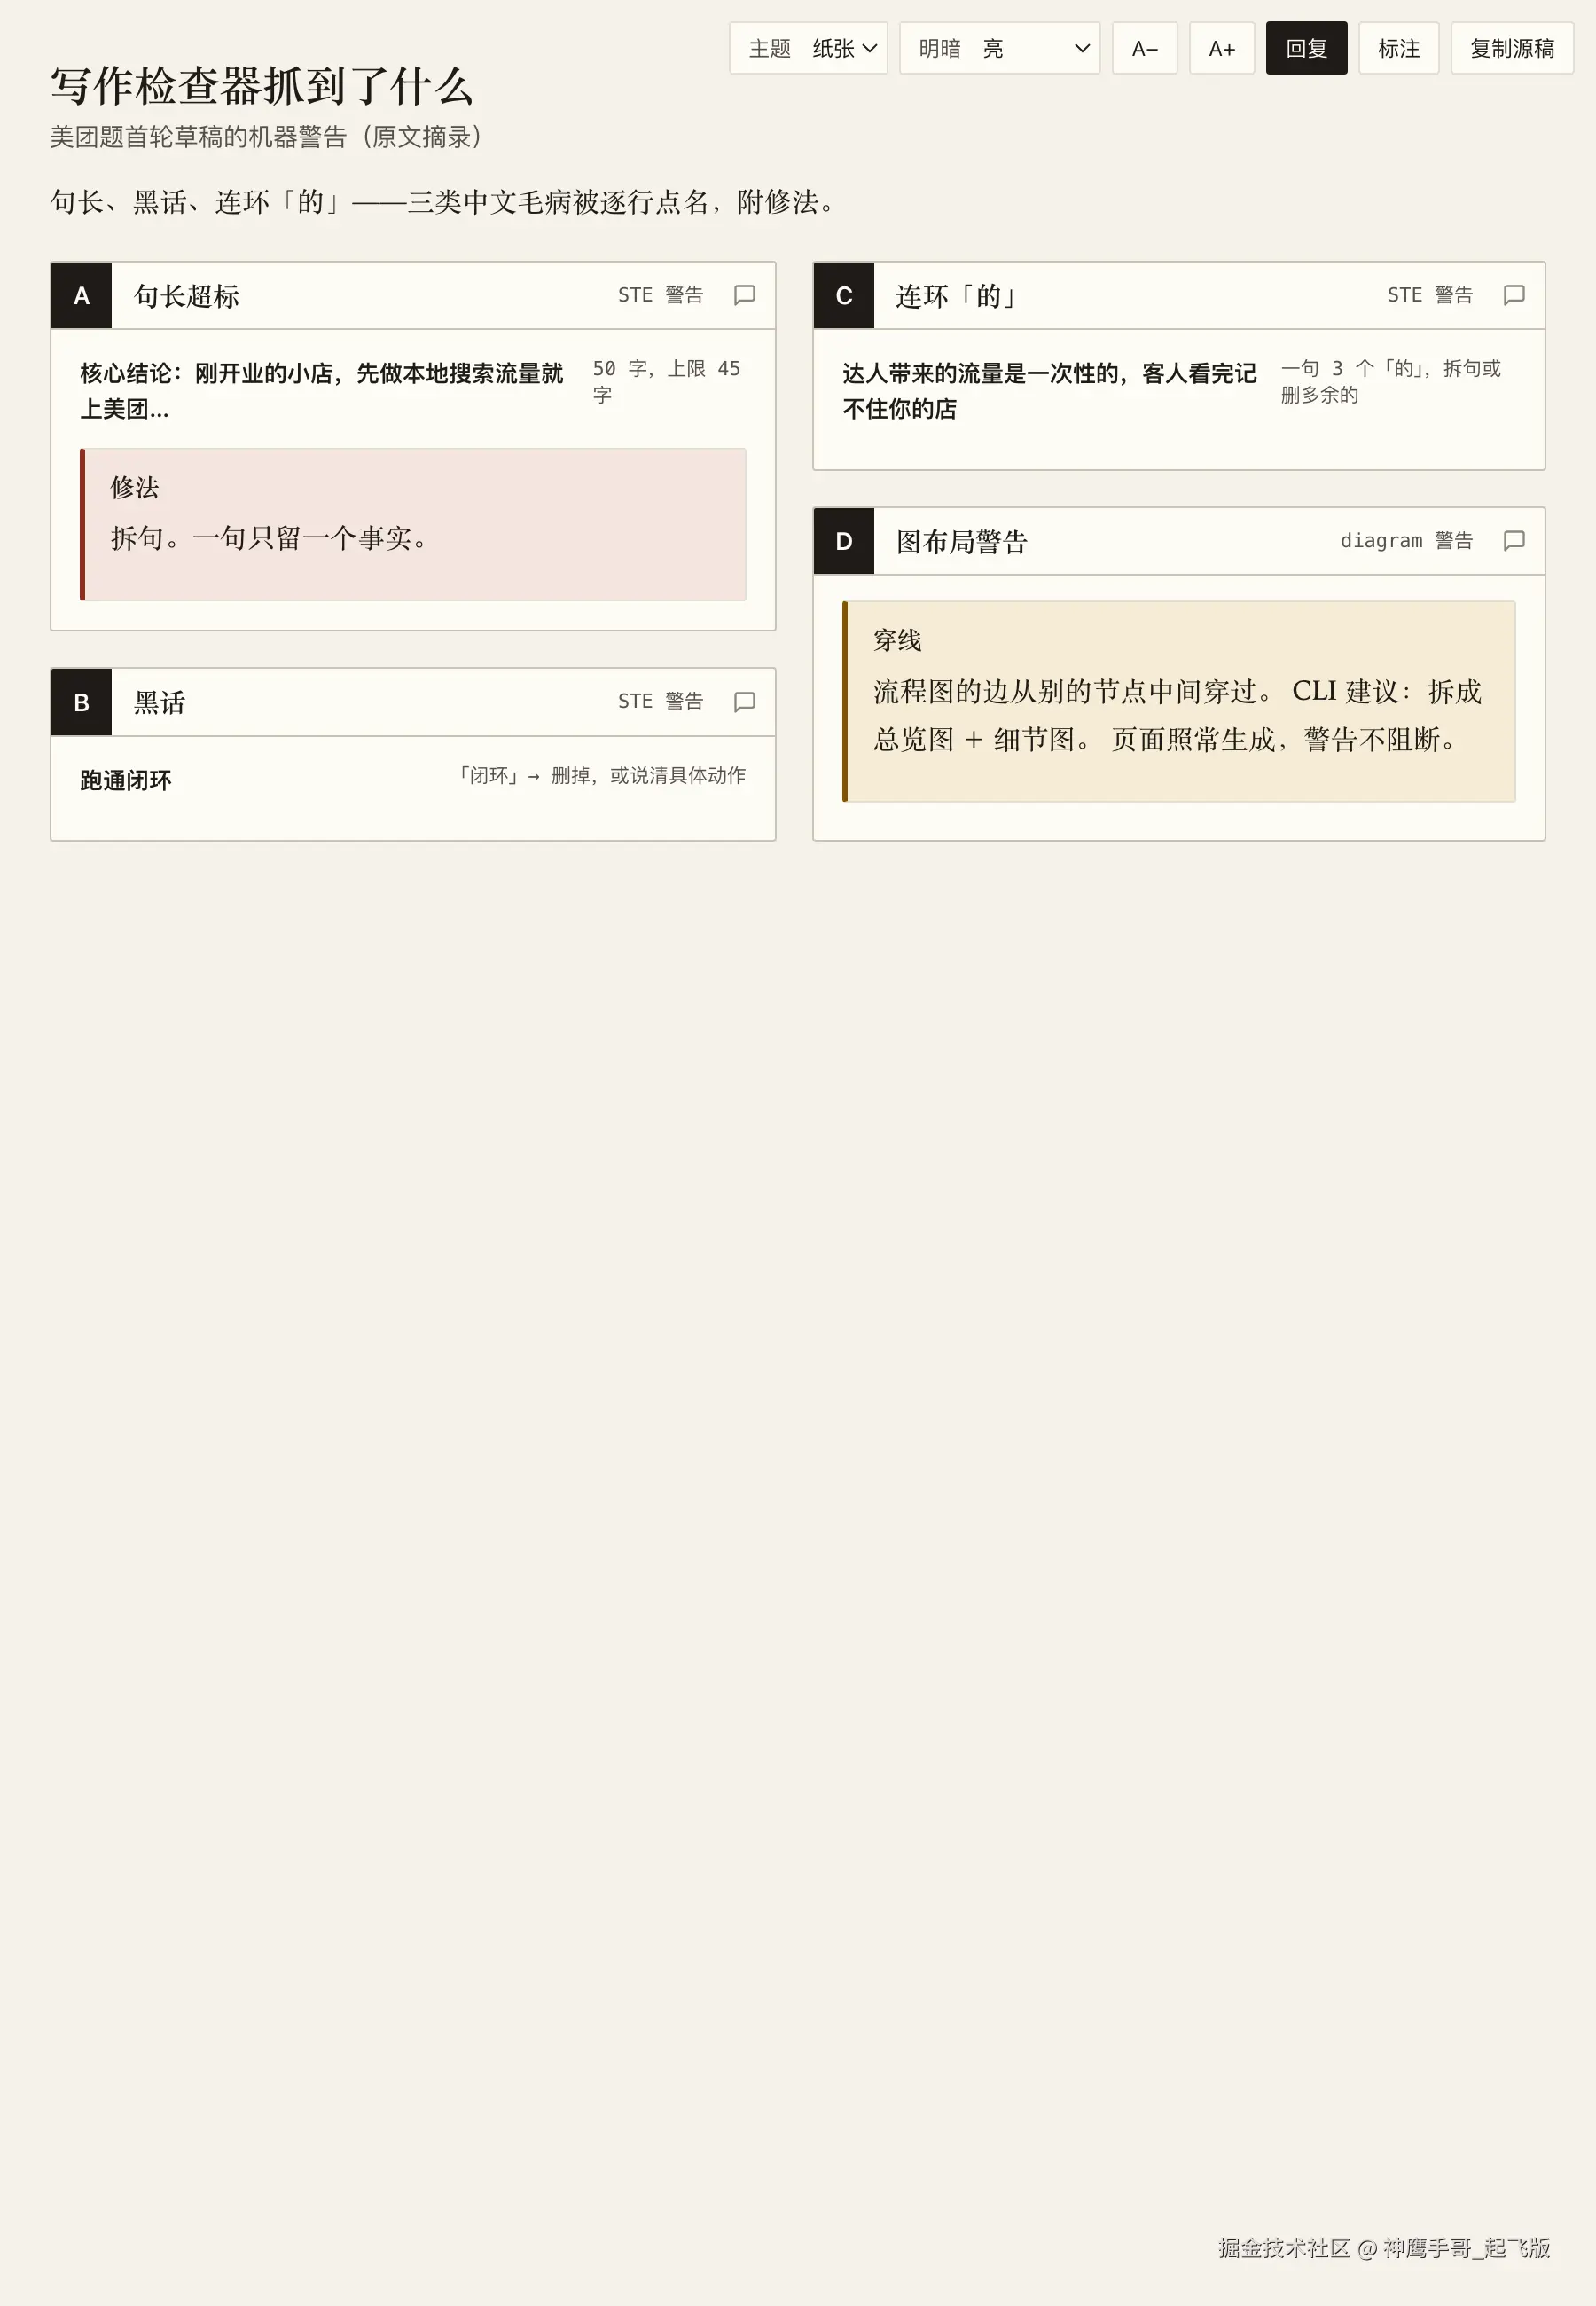
- 「核心结论:刚开业的小店,先做本地搜索流量就上美团...」------50 字,上限 45 字
- 「跑通闭环」------黑话,删掉或说清具体动作
- 「达人带来的流量是一次性的,客人看完记不住你的店」------一句 3 个「的」
这些警告带行号和修法,比在 prompt 里写一百句「请简洁」有效。
但机器只查形式。 同一份草稿里,lite 写下了「封面和标题决定 70% 流量」,还画了一张「同城本地服务 5000 元 / 品牌商单 3000 元」的变现对比图------数字全是编的。检查器不会碰它们,因为格式完全合规。所以我的流程留了人工终审这一关,规范里也写死「不发明数据:没有真实数字就不用图表,示意数据必须标注」。但那是约束,不是保证。
直接出公众号配图
页面出完不用截图,一条命令导出 PNG 切片:
bash
node am.mjs export 页面.html --png out/按 1200 CSS px 宽、2 倍分辨率渲染,自动沿面板之间的空隙切成不超过 1800px 的长条,交互控件自动隐藏。本文的流水线配图全部这么来的,也支持导出 A4 PDF。
复现与部署
门槛很低,三步:
- 装排版引擎 :需要 Node.js 20+,引擎是单文件 CLI,运行时零依赖、没有
npm install步骤。把仓库 clone 下来,取skills/answer-me-with-html/scripts/am.mjs这一个文件就够。 - 配一个 key :
ARK_API_KEY,端点和模型自己按需填写即可; - 跑起来:任何能发 HTTP 的脚本按上面的草稿规范调模型、拿到草稿后调 CLI 渲染即可;也可以直接把技能装进你的编程 agent,对话提问就出页。我的 harness 约 120 行,随文放出。
结尾
模型写内容,代码管排版。这条分工的性价比不在「省 8 倍 token」这种宣传数字上,而在两个实测事实里:一次通过时 lite 每页 1 分钱、质量反而比手写更好。想复现的话,把规范写严、把思考关掉、把人工终审留着。
这条流水线的排版引擎参考了上游开源实现(MIT 协议,QingYunA/answer-me-with-html);接入方式、实测数据和本文结论均为我自己的实践。