我将基于 QtQuick 框架开发的音乐播放器性能做到顶级
各位好,我是 QueMusic 的主要开发者。QueMusic是基于QtQuick框架开发的项目,从发布第一个Beta更新到现在三个月,版本已经更新到0.7.2 Beta了,GitHub 上两百多个 star,主要还是宣传的不是太多,但是这个在性能上我是非常自豪的,而且QueMusic是永久开源免费的。
现在项目里有 92 个 QML 文件、两万多行 QML,加上三万行左右的 C++ 和着色器。这篇文章只讲性能:为什么底层选 QtQuick 而不是 Web 内核,QML 层做了哪些结构上的处理,后端的音频和网络链路是怎么搭的。功能列表和更新日志不在这里重复。
GitHub:github.com/BroNekoX/Qu...
官网:quemusic.top
QQ 群:1105114511
B 站:QuabldayX
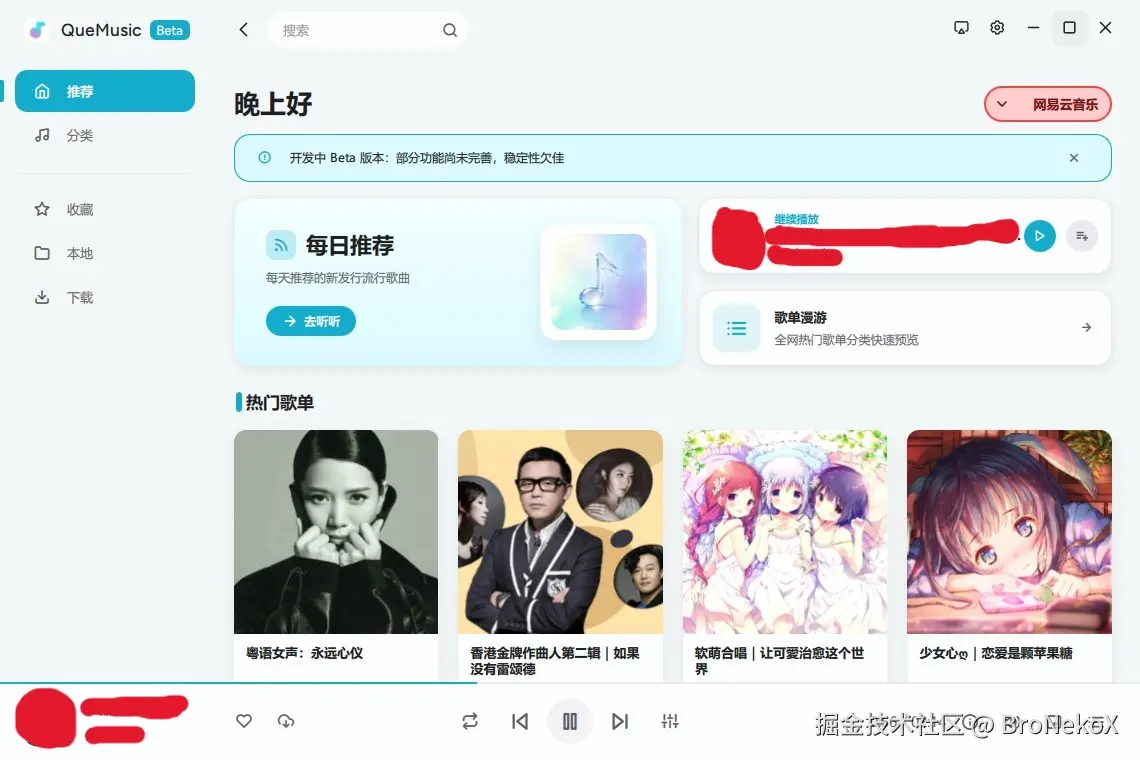
一、前言
QueMusic 的渲染链路是:C++ 后端 → QML 前端 → Qt Quick Scene Graph → Qt RHI → 系统图形 API。Qt RHI 是一层渲染硬件接口抽象,往下直接落到 D3D11、D3D12、Vulkan、Metal、OpenGL系统渲染引擎。界面最终由系统图形栈绘制,中间没有额外的合成层。
这是它和 Electron、Tauri 这类播放器最根本的差别。Chromium 本身不慢,但它要为"能运行网页"这件事承担一整套 HTML/CSS 布局、合成器和 JavaScript 运行时。一个音乐播放器需要的只是滚动列表、封面、歌词和几个面板,用整套浏览器内核来做,绝大部分开销和需求无关。
Flutter 的 Impeller 和 Avalonia 的渲染同样不慢,这一点没必要回避。区别在于它们的绘制指令还要先经过自己的引擎再交给系统,有中间层,包括skia渲染引擎也是,而 Qt RHI 可以说很底层。这个差别在跑分上可能只有几个百分点,但在低端核显上,几个百分点往往就是稳定 60 帧和偶尔掉帧的分界。
框架本身只提供上限,真正影响结果的是另外两件事。
一件在编译期。QML 里的绑定和函数,如果类型是明确的,qmlcachegen 会在构建时把它们编译成 C++ 和字节码,而不是留到运行期逐行解释。所以项目里大量使用 required property、pragma ComponentBehavior: Bound 和带类型的函数签名,目的是让编译器拿到足够的信息。构建时还会顺带跑 qmllint,类型写错在编译阶段就会报出来。
另一件在着色器。项目里所有 .frag、.vert 都通过 qt6_add_shaders 在构建期编译成 .qsb,运行时不解析 GLSL,首帧不会因为编译着色器卡一下。
所以QueMusic在为了编译更好,解析更好下了许多功夫,比如js的function我都显式类型比如:function afunct(index: int): void {},还有所有非本组件操作的属性全部显式设置id.xxx,以及delegate中的提前required modelxxx来填充。这些其实也是Qt官方的优化方法,具体可以自己搜搜看看Qt官方视频。
二、工程结构
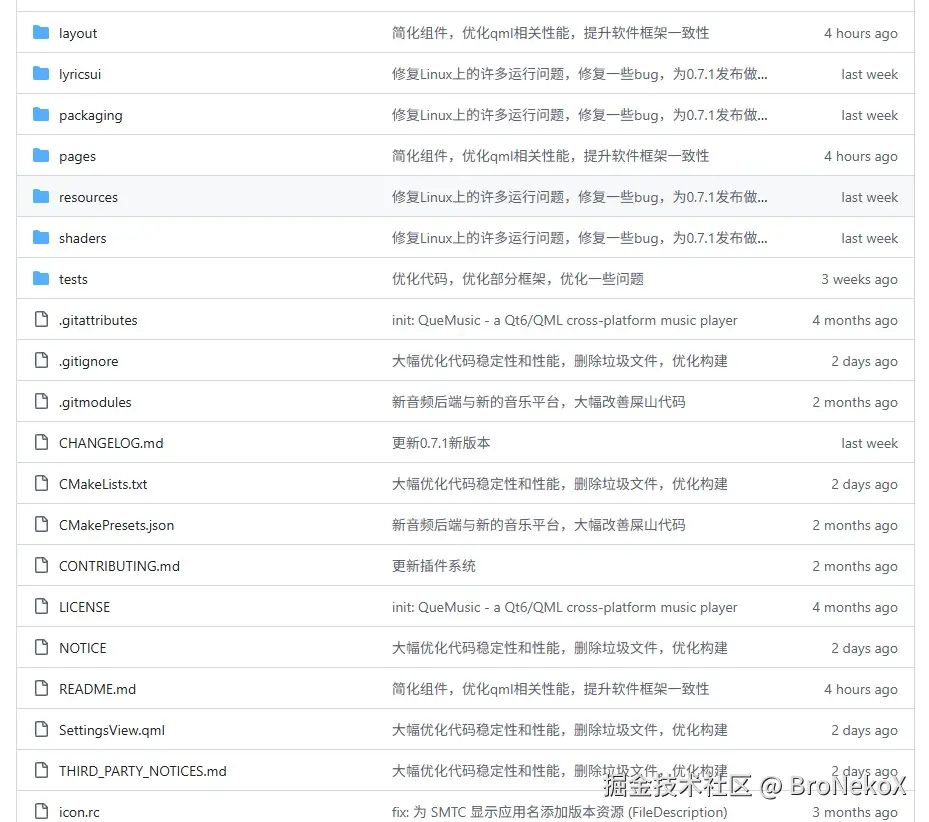
我看到好多QtQuick框架的应用,项目目录都非常乱,可能不会将软件源代码直接放到根目录,所以我就比较随意,像CMakeLists.txt、main.cpp、main.qml这些文件直接放在项目根中。其余就放文件夹里里:components 放自定义组件,layout 放一个窗口只有一份的骨架(左栏、播放控制、窗口控制、歌词主体),pages 放会被切换的页面,lyricsui 放歌词界面的几套实现,shaders 放着色器相关的。api 和 cpp 是后端,一个管在线音源,一个管音频引擎、曲库、下载、账号、WebDAV 和插件,对了,还有resources,就是放不是代码的(图片、字体)。
还有设置界面比较随意。SettingsView.qml 现在 3131 行,仍然躺在根目录。当初觉得设置页只有一份,放根目录省事,结果它长成了全项目最大的单个文件。当然它应该放在layout中,图方便先就这样吧。
构建上还有一个小处理:CMake 用 file(GLOB_RECURSE ... CONFIGURE_DEPENDS) 按目录收集 QML,新增文件不需要改构建脚本,少一类"加了文件却没生效"的排查。
三、前端与渲染
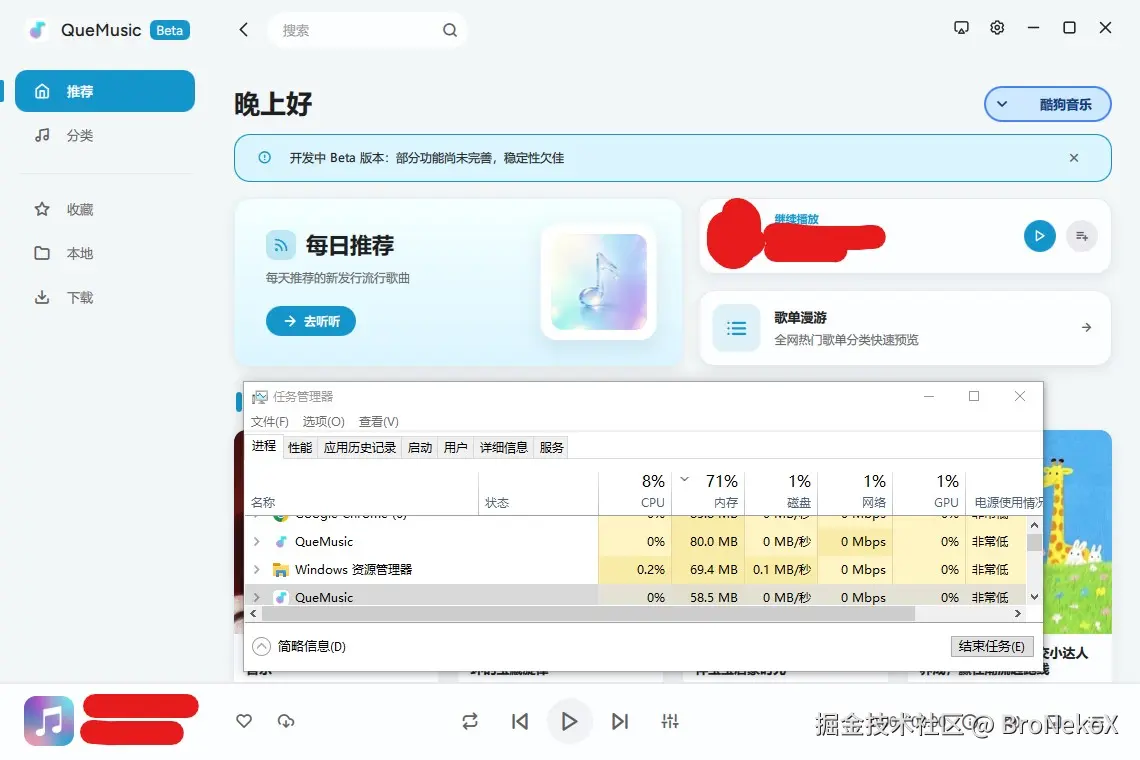
先给数据。i5-12400 加 UHD 730 核显,1080P、60 FPS、歌词界面开满效果,CPU 平均占用 4%,GPU 平均 15%。群里一位用十年前低端赛扬的用户跑下来也流畅,这个结果我一开始不太信,让他确认过配置和驱动。 QueMusic 内存占用也很低,笔者电脑打开才只有60mb不到,性能也很好。
QtQuick 默认配置也能跑,但默认写法里有相当多"反正也不卡"的浪费。下面几处是改动最大、也最值得说的。
歌词弹簧动画
歌词逐行上浮最初用 NumberAnimation 加 Easing.OutBack或者使用qml的弹簧动画。能看,但有两个问题:每行都要配一套动画属性,写起来重复;连续跳转时动画会从起点重新开始,视觉上像被拽了一下;然后还会有状态管理等7788的开销。
后来改成自己写的 SpringAnimator,C++ 实现,多次调节以实现更流畅的效果,核心是把位置和速度都当作状态量,每帧对弹簧方程求解析解:
cpp
void SpringAnimator::step(double dt)
{
    const double eps = m_value - m_to;
    // 欠阻尼解析解,无条件稳定、与帧率无关
    const double wd = m_omega * std::sqrt(1.0 - m_zeta * m_zeta);
    const double e  = std::exp(-m_zeta * m_omega * dt);
    const double ct = std::cos(wd * dt);
    const double st = std::sin(wd * dt);
    const double b  = (m_v + m_zeta * m_omega * eps) / wd;
    const double nextEps = e * (eps * ct + b * st);
    m_value = m_to + nextEps;
    m_v = -m_zeta * m_omega * nextEps + e * wd * (-eps * st + b * ct);
}用解析解而不是欧拉积分,好处是结果与帧率无关,dt 有波动也不会积累误差;掉帧时把 dt 限制在 50ms 以内,避免一次积分跨过太远的位置。换目标时保留速度,行飞到一半改了目的位置,会顺着当前惯性弯过去,而不是停下重来,这是 NumberAnimation 做不到的。对外只暴露 duration 和 bounce,内部换算成角频率和阻尼比,调手感不用碰公式。 其实这些是ai写的,我可没有能力写这些复杂的算法,哈哈哈
它也没有接入 QML 的动画系统。实现挂在 QQuickWindow::afterAnimating 上,每帧解一次方程、写一次属性、调用 update(),没有 QAbstractAnimation 的状态机,也不需要额外的 QQuickItem,所以在性能上还是非常牛逼的,一起跑1000个动画都没问题
qml
SpringAnimator {
    target: lyricItem
    property: "standY"
    duration: 460
    bounce: 0.2 + Style.springValue * 0.05
    autoStart: false
}
好,然后这个歌词界面的这个动画虽然一起跑1000个动画没问题,跑100行应该也没问题,但是为了照顾低低低端机,所以默认不在显示的几行的就同时绑定一个属性动画驱动:然后每行的动画滚动延迟类似:0 0 0 1 2 3 4(当前唱行) 5 6 7 8 9 10 11 12 12 12 12,这个连续的0和12就是动画直接用blinding绑到统一的属性了。然后逐行动画的计算如下:
qml
durationMs = (d + 4) ** 1.2 * 24;
lyricAnime.duration = 460 + (d + 4) * 32;
离当前行越远,动得越晚、走得越慢,视觉上像一道波纹向外扩散。这个错峰是刻意的,因为没有错峰时,整屏文字会像一块板子整体平移,反而显得生硬。
剩下的行不参与弹簧,直接绑定到两个统一的动画值上:上方绑定 fixedH,下方绑定 finalH,两个值各由一个 SpringAnimator 驱动。
qml
lyricItem.standY = Qt.binding(function() {
    return lyricContent.fixedH + nowY;
});
上百行的位移因此从"上百个动画各自解方程"变成"两个弹簧加一批加法绑定"。绑定只在 fixedH 变化时重算,开销基本可以忽略。这是低端机也能照跑流畅的原因。
歌词的行高也是缓存过的。每行的高度在布局完成后写入数组并累加前缀和,切歌重排时直接用前缀和算出目标 y,不重新做一次文本测量。
算了直接把图片放出来给大家吊吊胃口
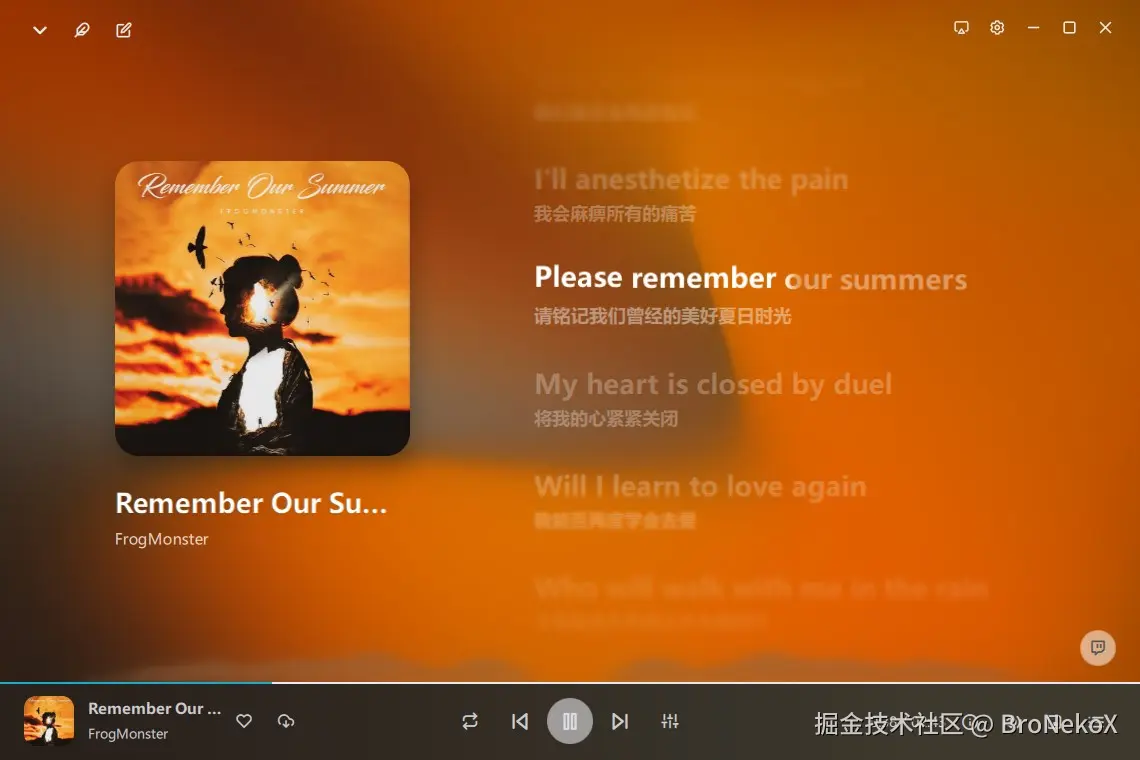
很难想象这个效果内存占用低到100mb(连同整个QueMusic),在UHD730这种只有GTX750显卡性能的核显上,跑到了满75帧的流畅,而且是全屏,GPU占用大概28%,每帧渲染耗时大概5ms,我都想不到这么nb。关键这是纯qsb着色器+QML实现,代码可参考项目/layout/MainLyrics.qml
当然整个歌词界面这个歌词也有很多优化,上方和下方的这种渐隐渐显和渐模糊效果都是自定义着色器,这个歌词逐字过渡效果也是着色器,歌词排版纯QML实现。
左栏与列表
左侧导航栏原来用 Column 竖排,Repeater 生成按钮。按钮之间要一条分割线,位置大约在第三个按钮上方。当时的做法是把第三个按钮隐藏,然后把他高度减少,在这个地方放个横线,可见非常草率。
现在改成 Repeater 直接挂在父节点上,delegate 在 Component.onCompleted 里按索引算 y:
qml
Component.onCompleted: {
    y = index > 1 ? 100 + index * 44 : 70 + index * 44
}
index > 1 带来的 30 像素,就是分割线的位置。省掉的是一个 Column(Item)、一个被隐藏的实例和一次额外的布局。性能收益虽然忽略不计,但是让我看了顺心。
在线歌曲列表 QListView.qml 是全项目实例化次数最多的组件,每一行的开销都会被乘以几百,所以改动集中在这里。
封面圆角原来在每个 delegate 里放一个 QPictures组件,这个组件之前是Item里MultiEffect 遮罩Item和Image。这样每个可见行都有一个离屏图层,滚动时反复创建销毁。现在把 mask 提到 ListView 根节点,只做一份,然后delegate里直接放MultiEffect;MultiEffect 的 source 直接给 Image,可以说这样特别是列表比较多的时候要好很多,当然开了reuseItems复用,也没啥事。
行尾的三个按钮(更多、收藏、加入列表)位置固定,原来用 Column 对齐,现在直接写xy坐标,x 依次偏移 38 像素。
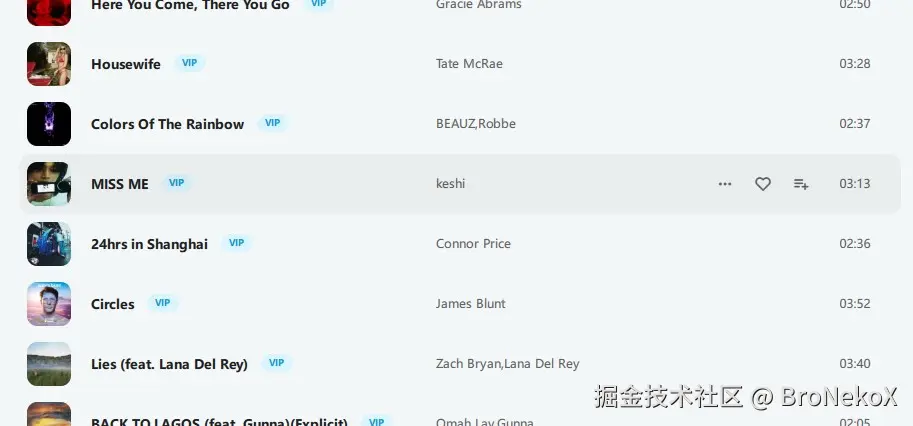
卡片与模糊
首页的每日推荐卡片最早是让 AI 生成的,结构是 Row 套 Column 再套 Row,只为了摆一个图标、两行文字跟一个按钮,没给我气死。卡片尺寸固定,内部元素位置也固定,用布局容器没有好处。所以现在全部改成直接写 x/y放卡片上,一个嵌套都不需要,只有右边的抽象图把 x 绑定到 dailyCard.width - 142,窗口变宽时跟着走。
这一处省下的性能和内存都很小,意义在于 QML 树是平的,改的时候不用先理清谁在管谁。
真正有明显收益的是模糊。卡片毛玻璃最早的方案是标准链路:ShaderEffectSource 抓背景,MultiEffect 做模糊,再来一层调饱和度,最后用圆角遮罩裁剪。四步之间靠中间纹理传递。
现在合并成一个 ShaderEffect、一个 fragment shader,采样、模糊、饱和度、圆角裁剪在 main() 里顺序完成:
glsl
void main() {
    // 模糊:同一 mip 层级 + 步长恰好一个纹素的 2D tent 核
    float radius = max(blurMax * blur, 1.0);
    float lod0   = clamp(log2(radius / float(R)), 0.0, 5.0);
    vec2  texel  = exp2(lod0) / texSize;
    // 7×7 加权累加......
    float gray = dot(col.rgb, vec3(0.299, 0.587, 0.114));
    col.rgb = mix(vec3(gray), col.rgb, saturation);
    float d = roundedBoxSDF((qt_TexCoord0 - 0.5) * cardSize,
                            cardSize * 0.5, corner);
    fragColor = col * (1.0 - smoothstep(-aa, aa, d)) * qt_Opacity;
}
模糊核的写法有几个约束。所有采样取同一 mip 层级,不跨层,避免混出台阶和条纹;步长恰好是该层级的一个纹素,连续覆盖,不漏采也不重复采;模糊半径靠 mip 层级放大,与采样次数解耦,所以半径变大时开销基本不变。抓取纹理按 0.5 倍设备像素,反正要模糊,细节本来留不住,用全分辨率只会多占带宽。
圆角用距离场计算,smoothstep 顺带解决抗锯齿,不再需要单独的 mask 图。着色器分普通和高质量两个版本,采样数不同,设置里可以切换。
这里有个驱动层面的坑值得记一笔。模糊核的循环里,索引要先转成 float 再算权重,因为 qsb 会生成 GLSL ES 1.00 的变体,而 ES 1.00 没有 abs(int),传进去的 int 会被隐式转成 float,部分严格的 NVIDIA 驱动会直接编译失败(C7011)。源码里这行上方有注释,避免以后改回去。
歌词界面上下那层渐隐模糊同理,lyricfade.frag 在一个 shader 里同时处理淡出和模糊,不再叠两层 OpacityMask。
QML有个垃圾的问题就是没法直接给卡片后面的内容模糊,直接设置模糊源为parent或者窗口就会导致被卡片盖住,非常智障,也没有解决办法,这个渲染链也没法改,只能把卡片抽出来或者放到Overlay上,然后设置模糊源。
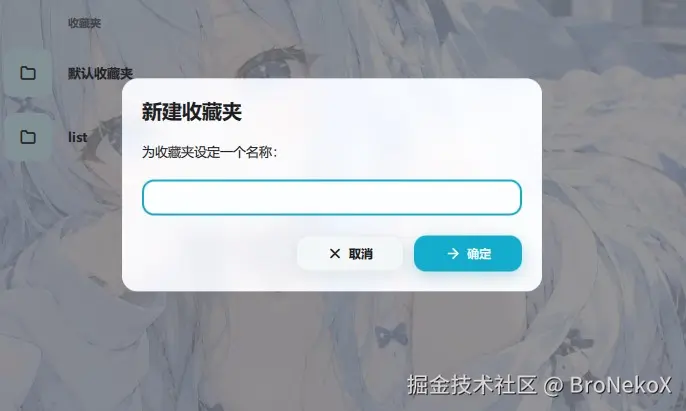
效果还是可以的,有卡片阴影,模糊相对以前克制。
四、后端
前端再快,后端卡一下,整体体验一样会掉下去,所以这部分单独说。
音频链路
QueMusic 没有使用 MediaPlayer,解码器用 FFmpeg,但整条链路是自己写的:
FFmpeg 解码线程 → 无锁环形缓冲 → 音频回调线程(DSP + 设备输出)解码线程固定为一个。FFmpeg 默认会按 CPU 核数创建线程上下文和私有缓冲,音频解码不需要帧级并行,多开只增加内存占用和上下文切换。
AudioRing 是单生产者、单消费者无锁环形缓冲。解码线程写、音频回调线程读,各持一个原子游标,不互斥、不等待、不拷贝。音频回调里只要出现一次锁,就是一次爆音的候选。
DSP 全部在音频线程内完成:多段参数均衡、变速、变调、声道处理、ReplayGain 和限幅,逐样本计算,与 GUI 线程解耦。拖动窗口、切换页面、滚动长列表时,音频不受影响。bufferMs、输出采样率和输出设备都支持播放中热切换。
切歌的淡入跟随新音轨真正出声的时刻触发,而不是在 QML 里起一个 Timer 估算。这样从点击到出声,淡入的起点是确定的,不会出现淡入已经结束但声音还没出来的情况。
在线音源与线程
在线部分接了四个平台:网易云、酷狗、B 站、QQ 音乐。四家的返回结构大不相同,容易乱套,必须要做出兼容。
中间加了一层:四个平台实现暴露相同的动作签名,统一通过 resultReady(action, data, source) 回传;ApiCommon 把字段归一成 title、artist、cover、hash、paytype、duration 这种统一列表,列表模型直接消费。QML 里没有一个平台分支。
音质降级也在这层完成:无损不可用时退到 320k,再不可用退到 128k。用户选的只是上限,实际拿到的档位会在歌曲信息里显示出来。
其余耗时操作都不在 GUI 线程,都在工作线程:SQLite 读写走数据库线程,收藏状态在内存里维护一份 id 集合供 QML 直接查询;封面抓取、磁盘缓存、主色提取在后台完成,其中主色提取要对几百 KB 的图像做量化,放在主线程足以造成可感知的卡顿;本地音乐扫描边扫边出结果,不等全部完成才刷新;日志接管了 qDebug,但写盘是异步的。
构建期
Release 构建开了 LTO,函数和数据分节后由 -Wl,--gc-sections 剥离未引用代码;预编译头把 Qt 的几个主头文件压进去,全量编译时间明显缩短。
部署阶段会主动删除 ffmpegmediaplugin.dll 和 swscale-8.dll。全项目没有一处 MediaPlayer,这个后端不会被加载,删掉省下约 1.7MB。
五、最后
性能不是靠某一个技巧做出来的,是四件事反复叠加的结果。
一是少嵌套。能用一个 Item 表达的结构,不套两层容器,场景图节点数和布局次数都会跟着下降。二是定位从简,优先级依次是 x/y/width/height、anchors、Row/Column、Layouts,越靠前开销越小。三是绑定要准,只让真正会变化的属性参与绑定,一条数据引发整棵子树重算是最常见的隐形开销。四是按可见性分配预算,屏幕外的歌词不做弹簧,滚出视口的 delegate 立即复用。
还有一条不属于技术范畴:结构要清晰。找不到的代码没法优化,没人敢动的代码也没法维护。
没做完的部分也列一下。SettingsView.qml 的三千多行还没拆;qmltc 已经接进构建但默认关闭,它能把 QML 编译成 C++ 类,理论上还有提升空间,只是目前对布局和单例的限制太多;3D 歌词舞台默认 14000 个点,位置、大小和亮度都在顶点着色器里计算,低端机上还能再降,降到什么程度不影响观感仍在测试;插件系统刚开放,单个插件的性能开销还没有系统测量过。
接下来会先拆设置页,再处理 qmltc,然后继续接音源。如果你也在写 QtQuick,或者需要一个占用不高的本地播放器,欢迎试用并提出问题。
最后再放一下,感谢各位技术人的支持,非常感谢
GitHub:github.com/BroNekoX/Qu...
官网:quemusic.top
插件仓库:github.com/bronekox/qu...
QQ 群:1105114511