之前在前司遇到过这么一个线上问题,运维直接给我甩过来这么几个MySQL 监控情况;
慢查询一天竟然有 16K,在我这个 QPS 只有2000 左右的系统中确实比较罕见。
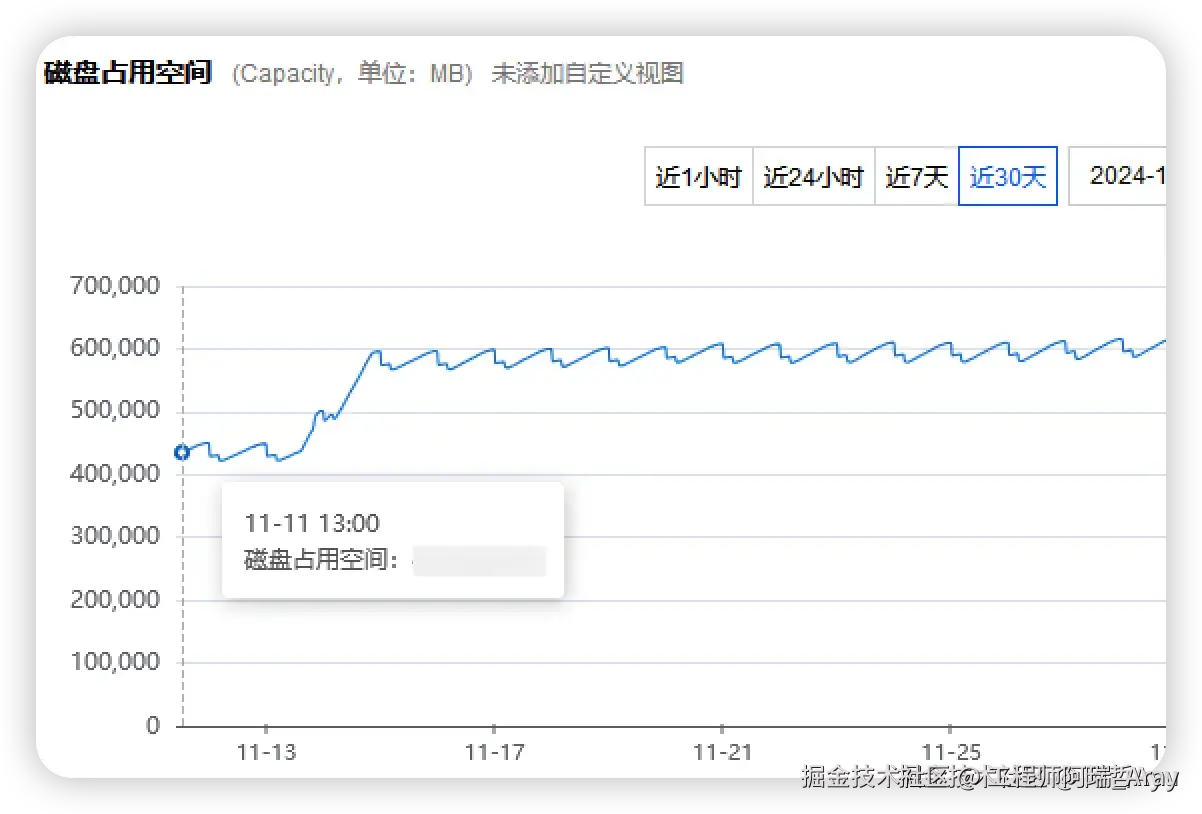
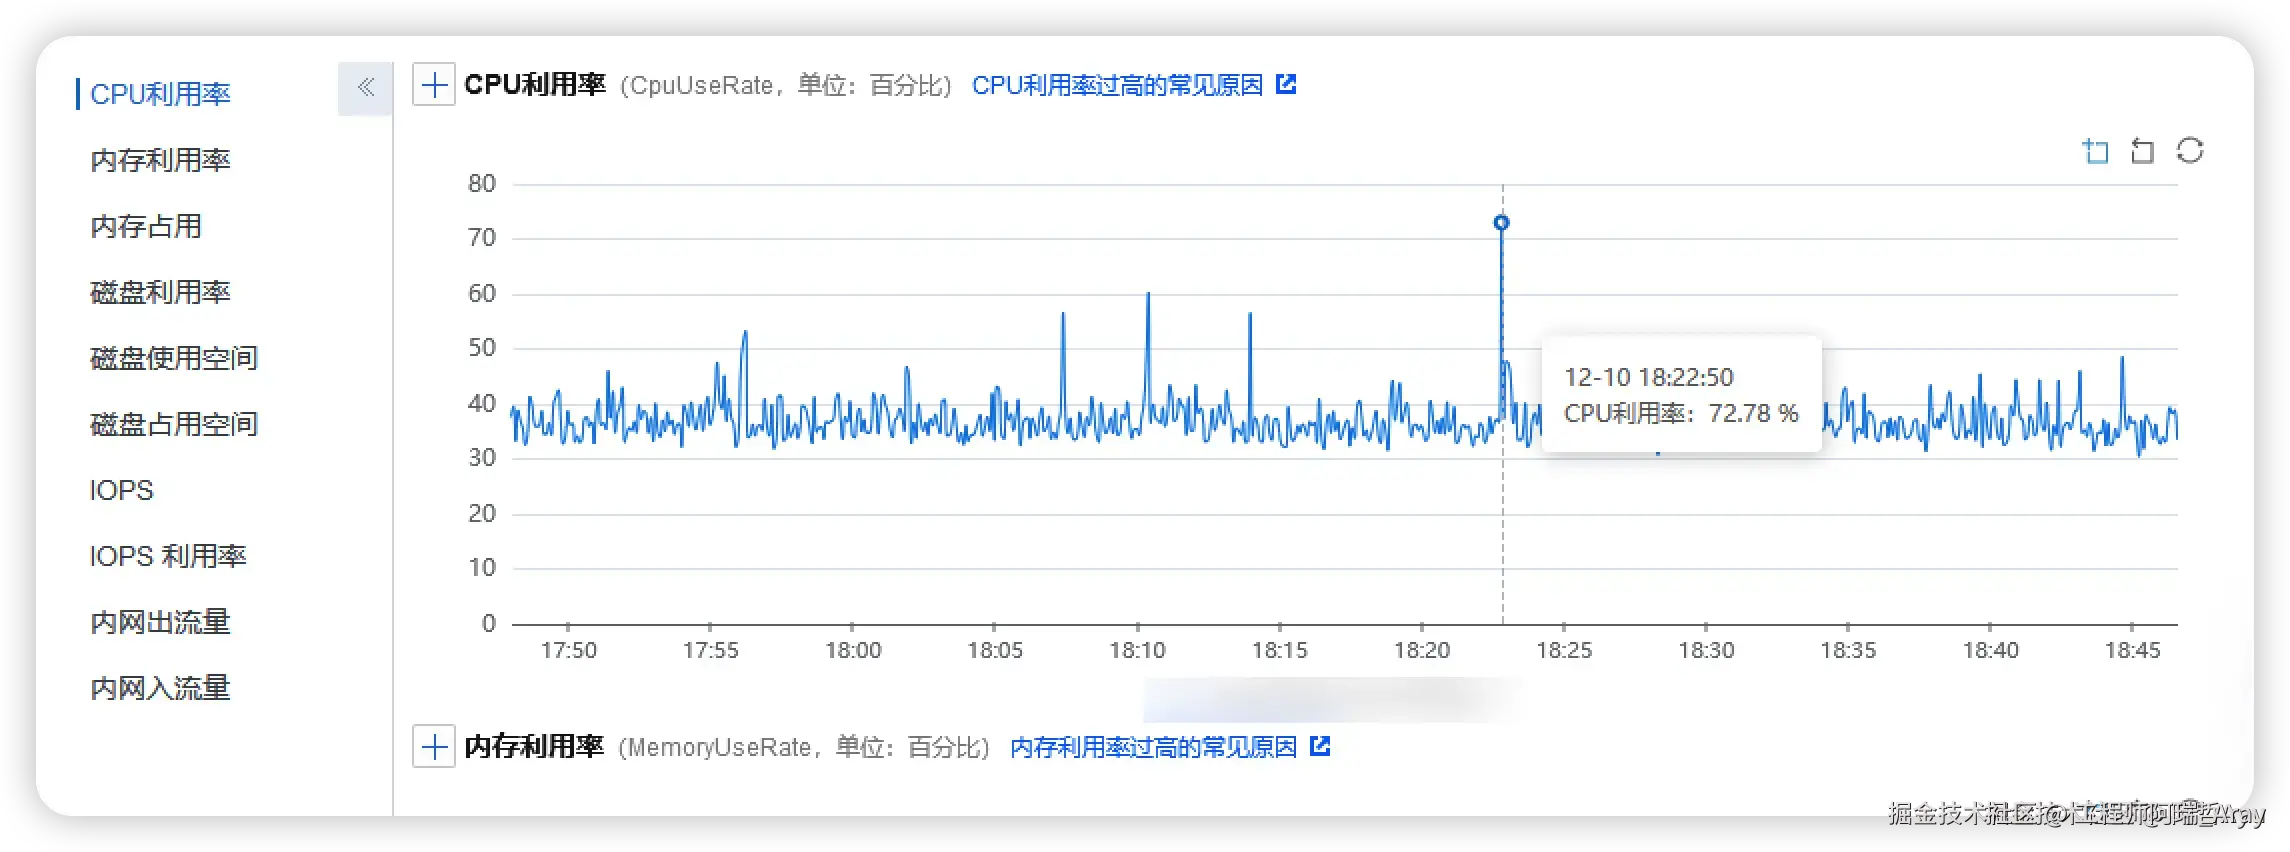
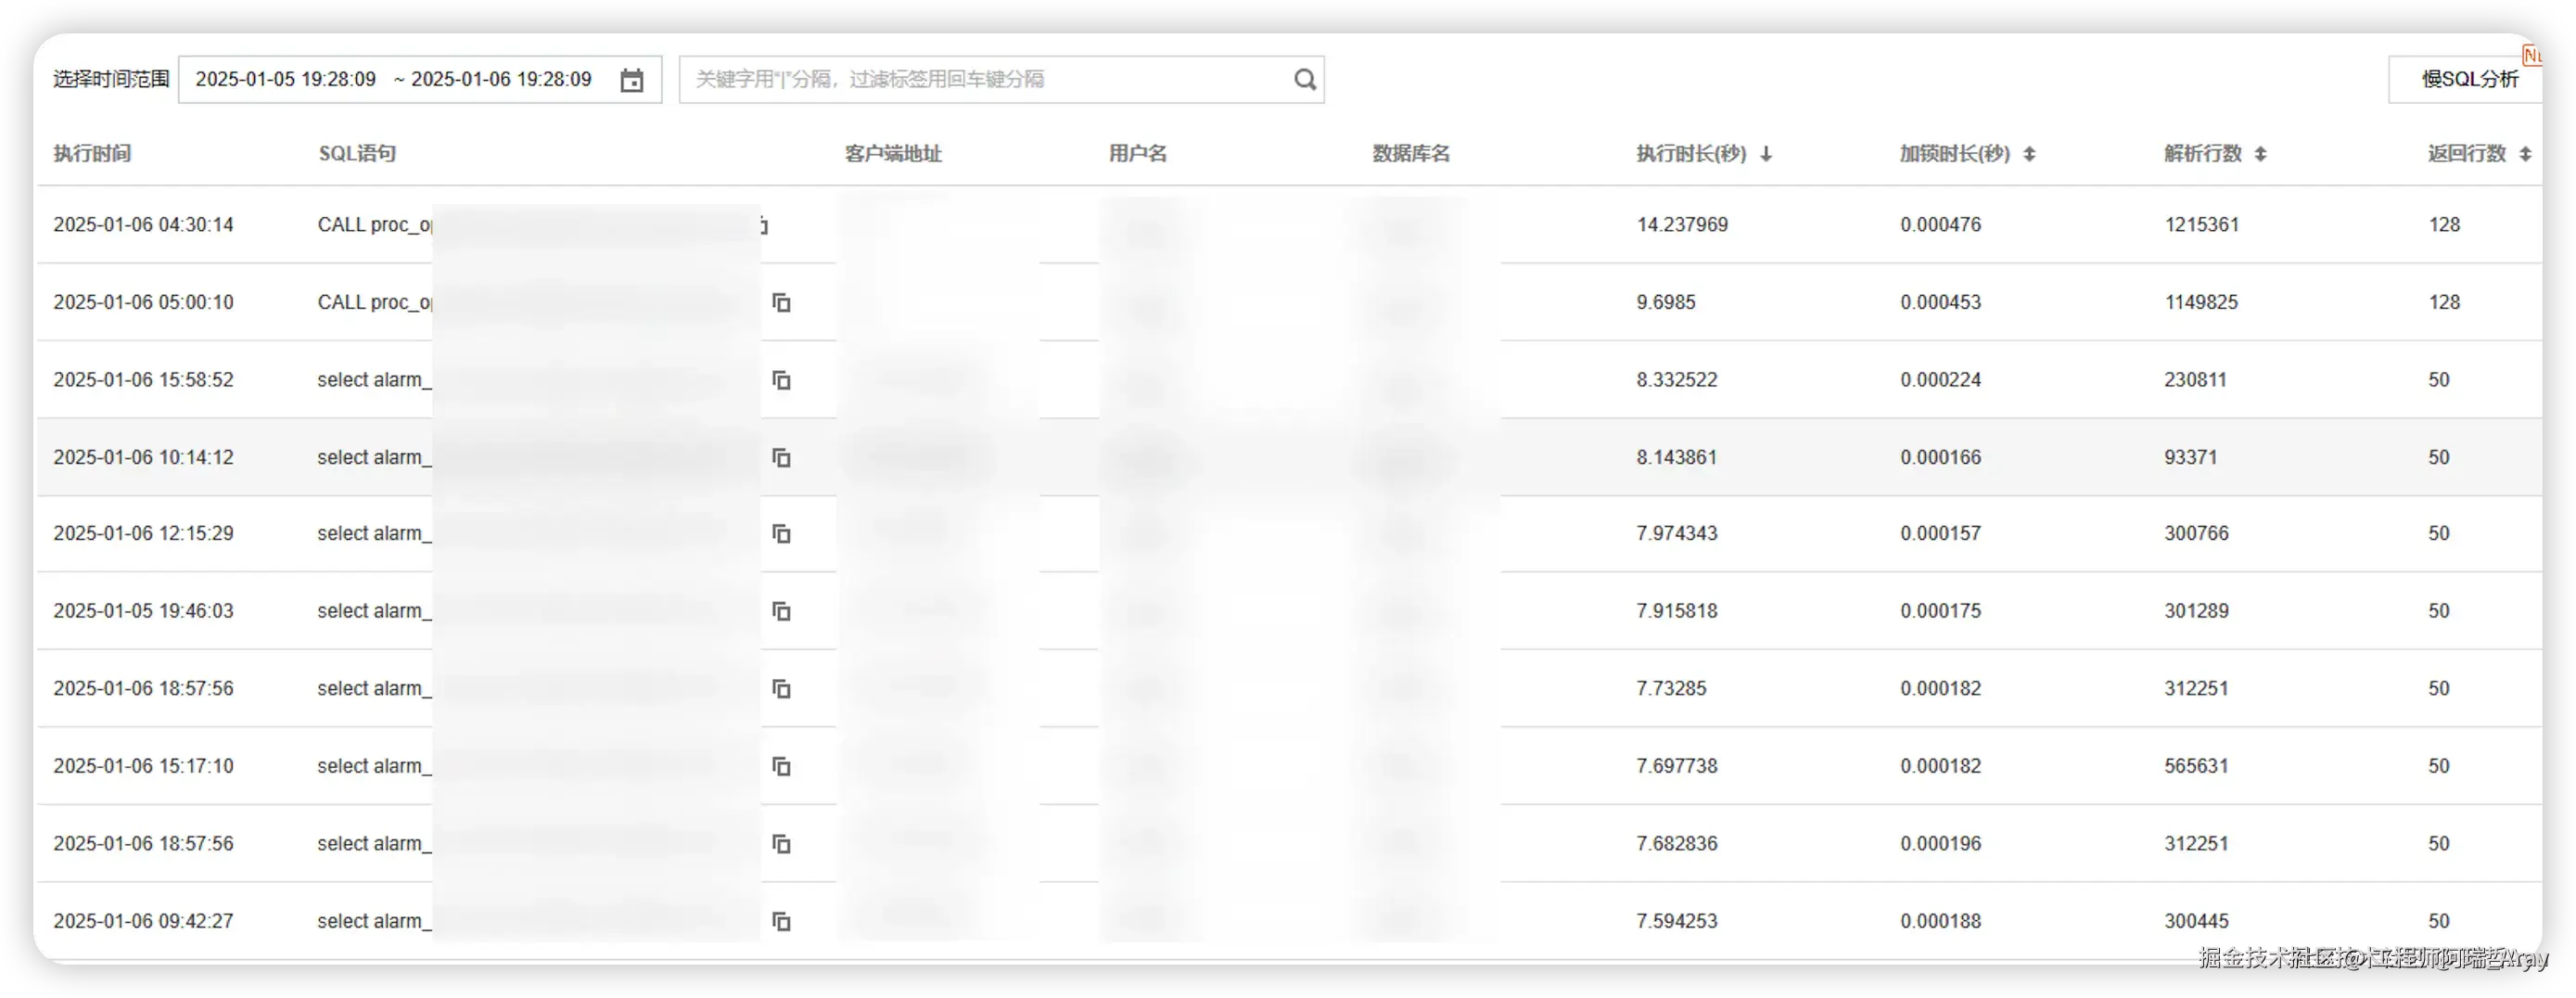
目前是 2 个现象,一个是 MySQL 资源紧张,一个是我管理的微服务有大量慢查询,其实这可以看出来,就是慢查询导致的 MySQL CPU 比较高,但是为了以防万一,我还是拉了一份慢查询时间频率和对应时间 CPU 的情况,比对了下。
发现确实就是慢查询导致的,那其实就安心解决慢查询问题就好了。
慢查询的问题发现了,出现问题的基本上就是同一个地方的查询,除此之外的慢查询才占 1%,这下知道是哪一个业务产生的了,就是当天上午刚上线的 APP 新页面。其实只要解决了这一个慢查询的 SQL,整个功能就恢复正常了,不过考虑到我的这边至少 40+个微服务都在用同一个 MySQL 实例,我还是得快点才行。
我在线上环境,通过 explain 查看了一下慢查询对应的SQL
| id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | SIMPLE | tbl_alarm_... | p20241203... | range | IX_deviceic... | IX_deviceic... | 16 | Null | 127941 | 2.19 | Using index... |
其实问题还是不少的
| 序号 | 分析维度 | 现象排查 | 优化方向 |
|---|---|---|---|
| 1 | partitions (分区) | 占用较多,涉及大量分区扫描。 | 过会会优化分区策略 |
| 2 | type (访问类型) | 为 range(非 ref/eq_ref/const/system),怀疑索引效果差。 | 怀疑是排序顺序有问题,并且也会优化索引,顺便看看数据量 |
| 3 | key (命中索引) | 有值,说明成功使用了索引。 | 基准确认:既然有索引,问题在于索引的"选择性"或"覆盖度",而非没有索引。 |
| 4 | rows / filtered | rows 极大,filtered 仅 2%。扫描 200 条数据需遍历海量底层数据,极不合理。 | 修改查询条件或优化索引 :排查是否存在隐式类型转换、函数计算导致索引失效;增加更精准的过滤条件;优化索引列的选择性。 我就找了几个业务重要的字段,发现设备 ID 独立程度 1-5%,告警类型独立程度 10%,实际上设备 ID 更值得排序在告警类型前面。 |
| 5 | Extra (额外信息) | 出现 Using filesort(文件排序),排序未触发索引。 | 消除文件排序:将 ORDER BY 的字段加入联合索引(注意最左前缀原则);或减少参与排序的数据量。 |
| 6 | 业务现象 (数据倾斜) | 大客户(20W-50W告警量)稳定慢查询;小客户跨分区不慢。 | 针对大客户特殊处理:1. 强制走特定索引;2. 限制查询时间跨度;3. 考虑冷热数据分离或引入缓存(如 ES/Redis)。 |
问题找到了,改动就好改的,我就按照我后端服务能改的和需要其他方配合的做了个分类
| 序号 | 配合方 | 事项 | 诉求 | 原因 |
|---|---|---|---|---|
| 1 | 产品经理 | 重构时默认查询 7 天,涉及多个 partition | 是否可以改成默认查询 1 天 | 为了在功能上对标海康、大华,不能进行修改,都已经将功能投放出了 |
| 2 | App 研发 | 缺少偏移量,后续可能出现深分页问题 | 期望入参增加偏移量,避免后续深分页问题 | App 暂时没人力投入,不进行修改,而且APP 升级也不是强制升级,我这边先支持 |
当时的想法是先试一下,由于效果不确定,所以也把这个风险提前跟上级沟通过。
优化点最终敲定这几个:
- 因为考虑到查询条件带有选择性,选择性高的字段放在前面其实是更合适、更合理的。
- 有一些查询条件是之前的业务带的,考虑到重构之后没有及时删掉,所以一直在保留着。
- 并且随着新业务的加入,有些同事不知道这个字段顺序是怎么样的,错误地把一些不必要的字段排到了前面,导致索引其实已经失效了。
- 当时也想过删除 partition,但是 partition 本身之前是为了解决定时删除的长时间问题,所以肯定不能去掉。去掉会造成其他业务不可用,效果变差;造成线上长时间的数据库资源紧张,甚至最终会把 MySQL 给打崩。
- 也想过增加 MySQL 的资源,但是考虑到当时已经是买的云服务厂商最高规格的实例了,所以后续只能通过组织架构调整,陆续地迁移出 MySQL 的实际数据来解决问题。
- 后续可能会考虑对它做分户分表优化,因为当前是 128 张表,每张表 1200 万条数据,实际上已经比我当初设计的单表最大值要多得多了。
- 同时还有个问题,就是索引它本身用的也不对,所以我这边 force 了它的一个索引。之前我也有过几次大迭代,我的旧版本 APP 用的索引当时一直没有删除掉。现在我到了新平台,新 APP 上的索引其实并没有在本次真实用到反而是呃麦优化器自以为它要使用。旧版本 APP 的索引。但实际上我这边测试过,如果 force 了我创建的新版本 APP 的索引,那么它的排查效果就会更好。我怀疑原因是有人乱改了查询条件的顺序导致的。
验证还是比较好验证的。我我这边委托运维从线上拷贝了一张分表的数据到本地,真正的优化过的索引,也是我这边不断的重试拿到的最好索引顺序。
优化效果还是可以的,考虑到索引可以直接换,我这边就直接增加了对应的索引,代码的话,也是当天重新提了一个上线申请,重新上线的
| id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | SIMPLE | tbl_alarm_18 | p20250701,p20250702,p20250703,p20250704,p20250705,... | range | IX_expire_time,IX_userid_alarmtime | IX_userid_alarmtime | 16 | 383 | 5.00 | Using index condition; Using where; Backward index scan |
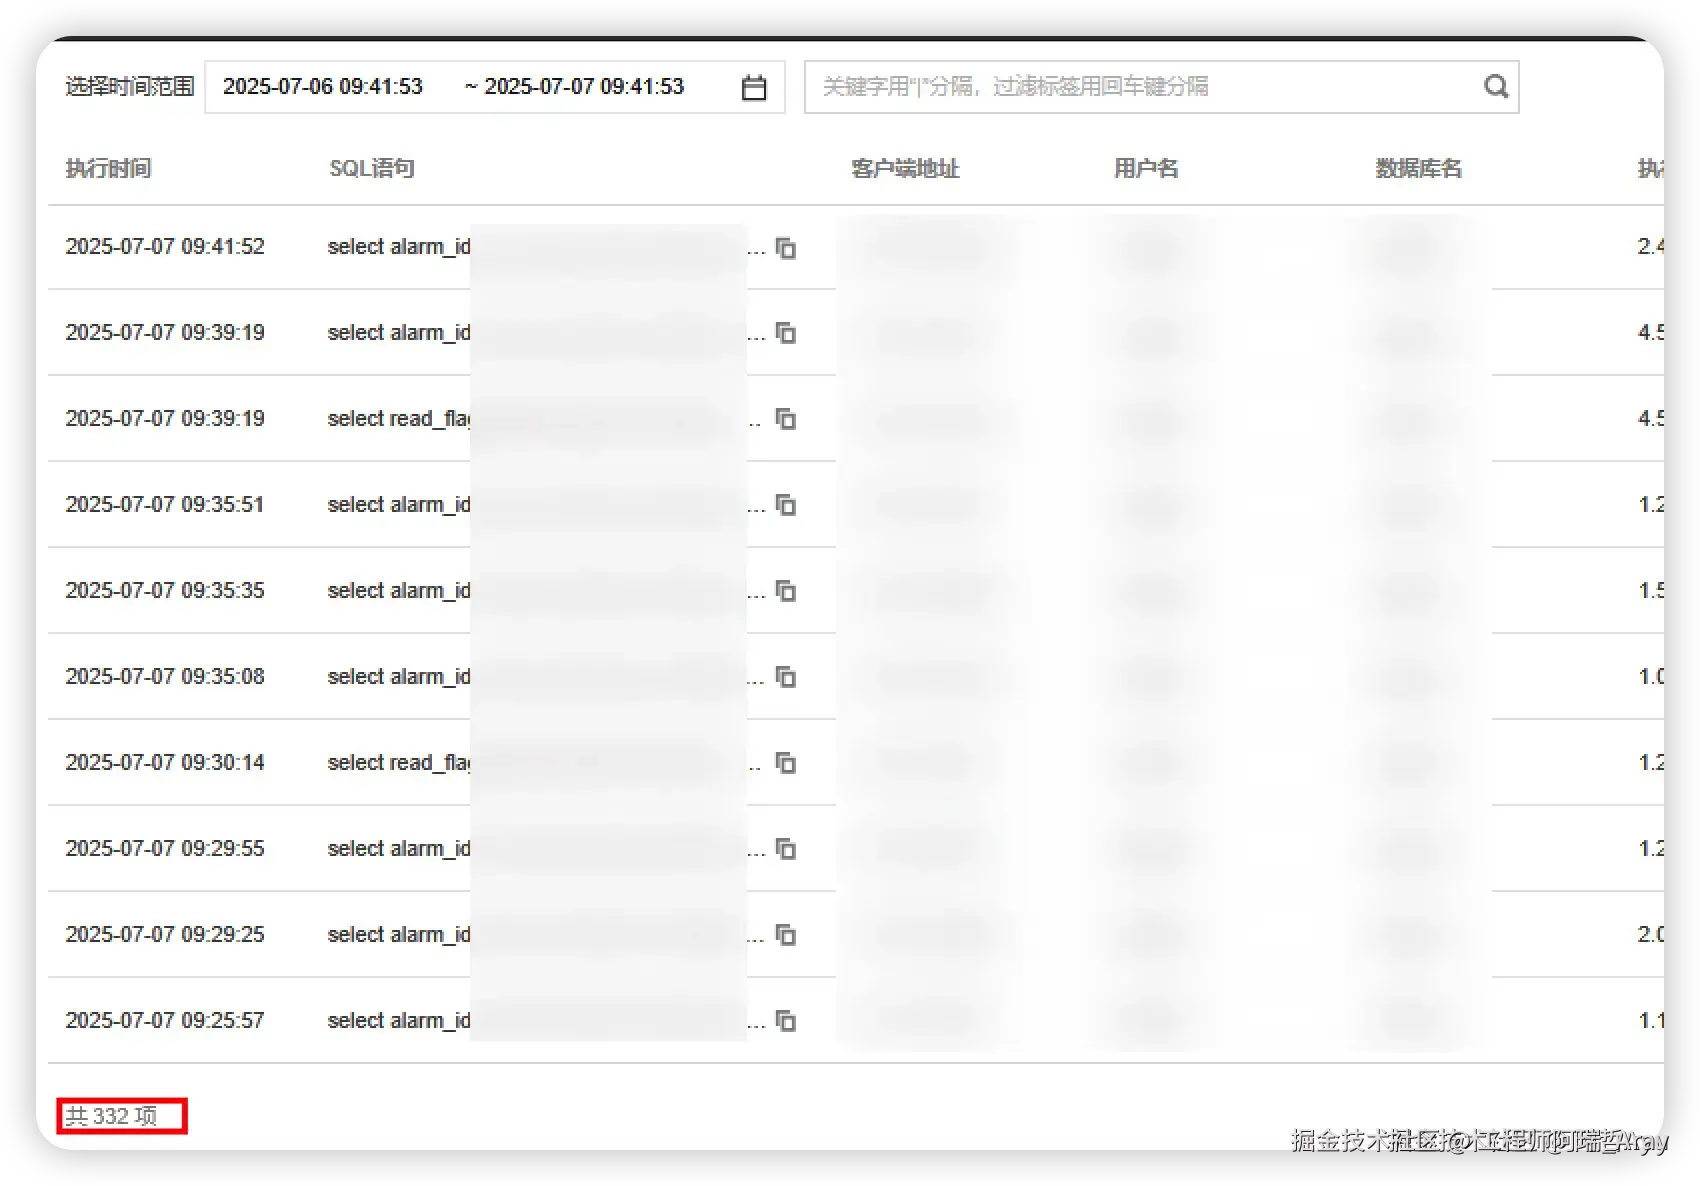
慢查询数量也降低了,16k/天 -> 0.5k/天
MySQL 的 CPU 情况也正常了,修复了慢查询之后,CPU 升高的情况也消失了。(虽然还是偏高)
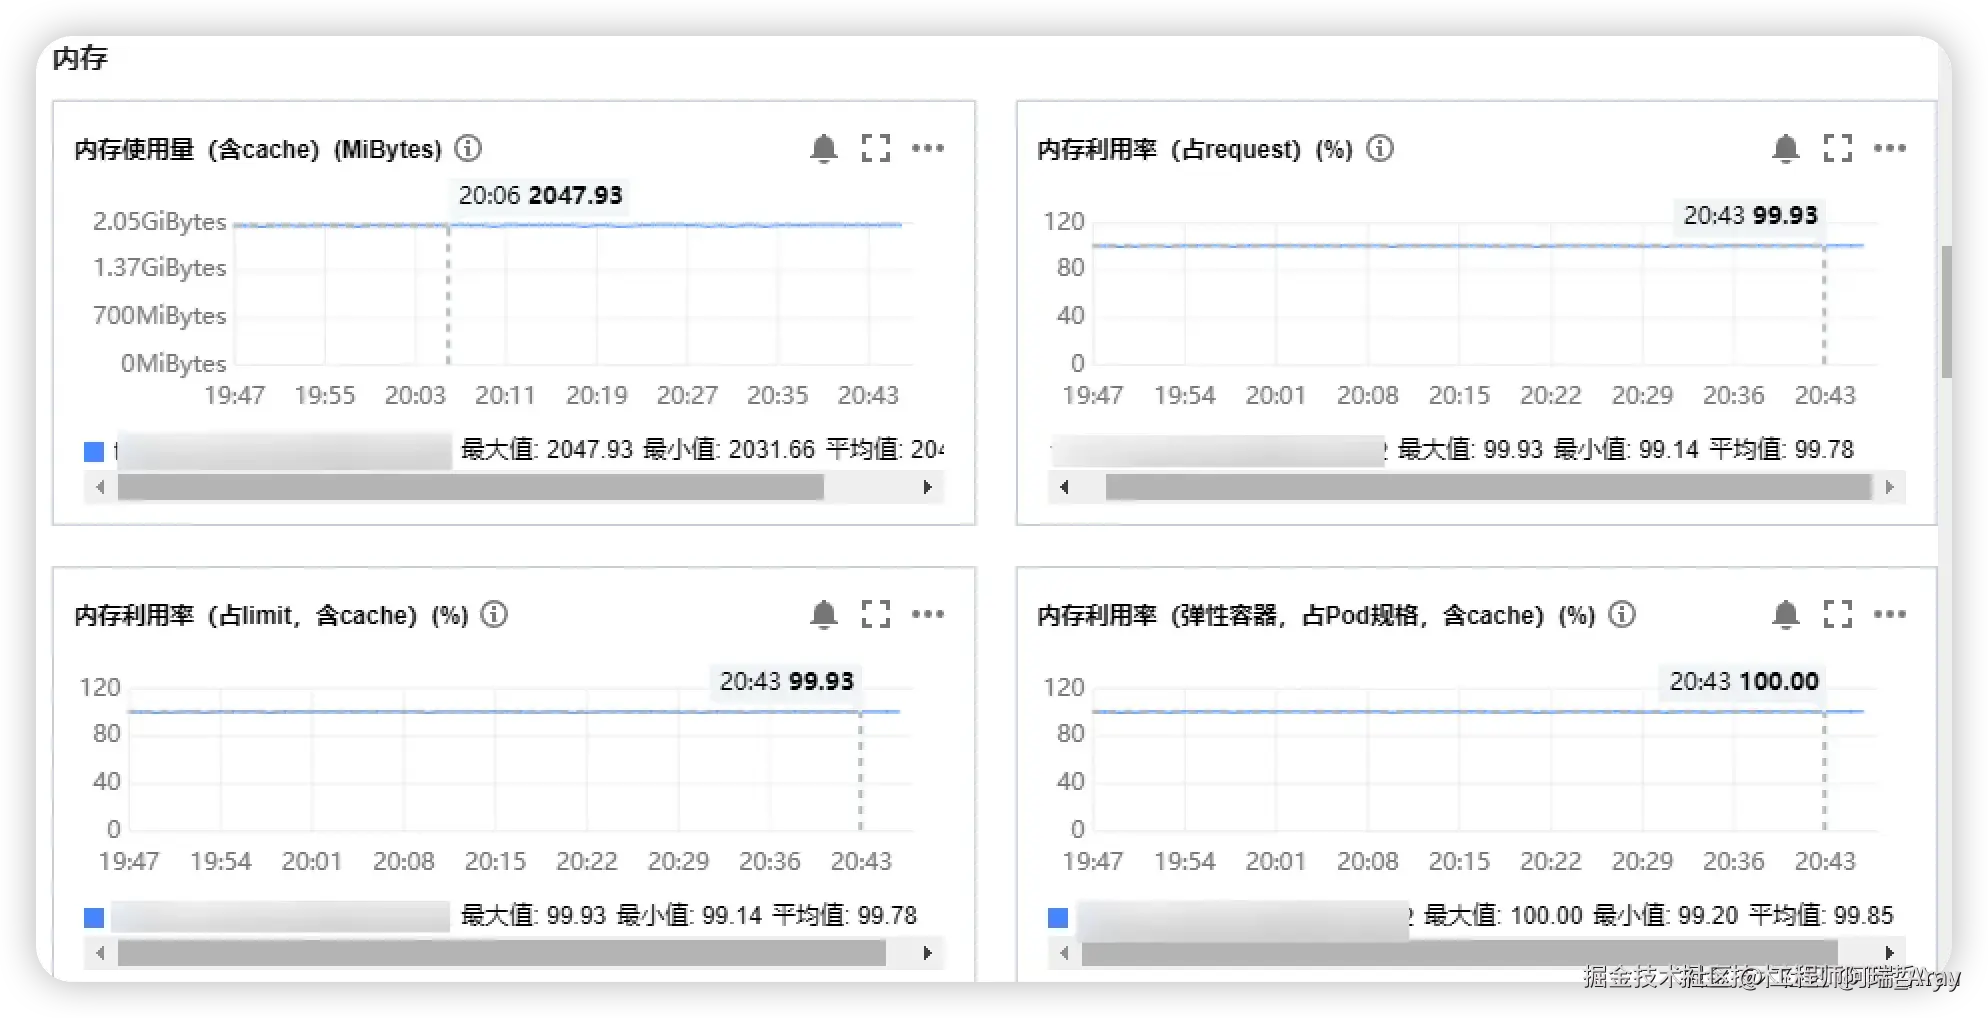
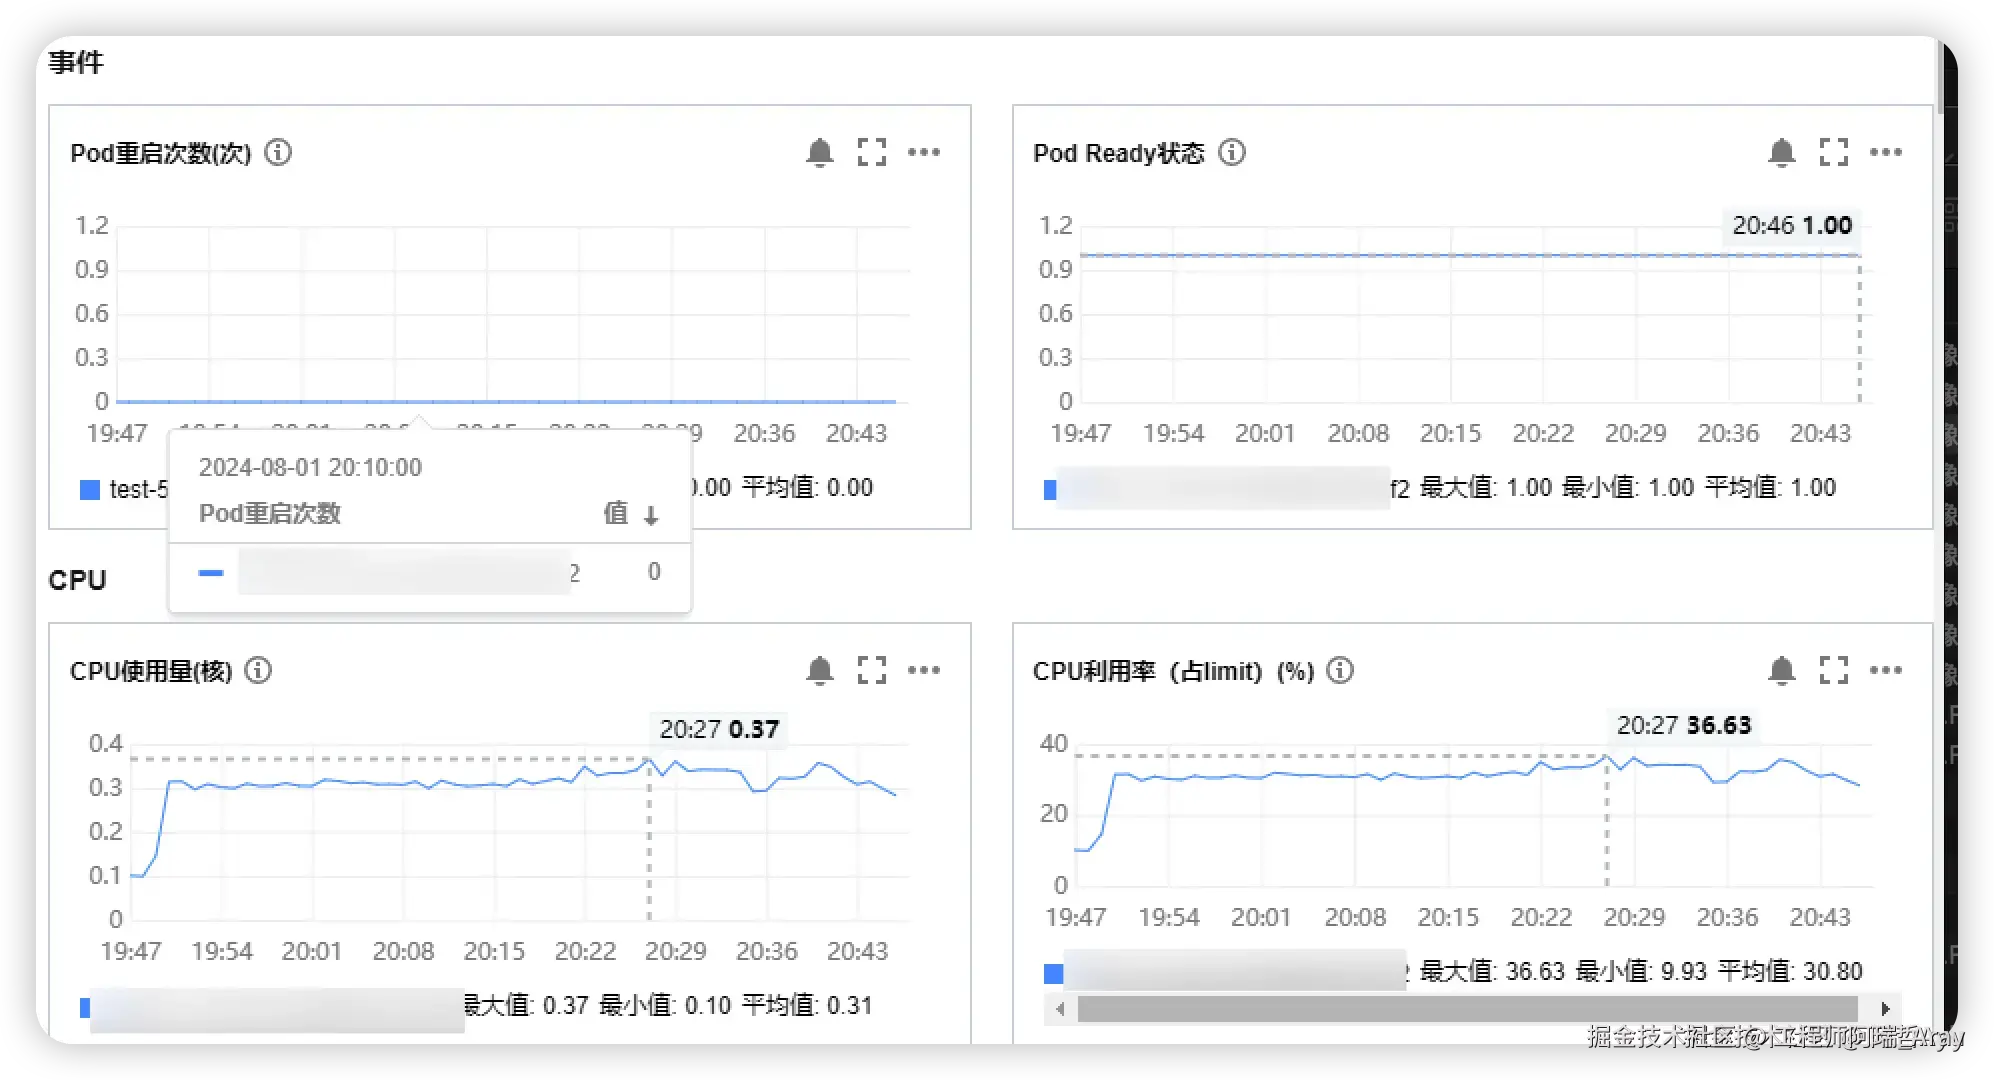
真正回溯这个问题的根因的话,我个人认为还是基本的职业能力没做好,一些 MySQL 的索引知识需要学习下,不然直接把查询条件塞到查询条件中间,会很容易造成联合索引的失效。并且我这边在重构的时候,因为确实也缺少人力,并没有对有问题的索引或者是查询条件进行进一步的重构,只是单纯地重构了一下功能。
至于测试为什么没有测出来,我发现其实大部分的慢查询还是集中在那些数据量较少的用户上,之前虽然造出了百万级别的数据库数据,但是压测的时候,并没有考虑到用户的真实分布特性,导致我认为是极端情况但在线上是正常情况的场景并没有测试出来。
不过不管怎么样,吃一堑长一智,下次这种问题应该不会再犯了。