摘要:扫描件送进 OCR 之前要不要纠斜、去噪、二值化?我把这三步拆成开关挨个打开关上。英文一页跑了 Tesseract 108 组,是 4 个倾角乘 3 种噪声乘 9 种处理。中文一页跑了 macOS 自带识别 60 组。另外补了几组顺序、核大小和页面分割模式的对照。纠斜和去噪对 Tesseract 有用。单独做 Otsu 几乎没用。自适应二值化碰上高斯噪声会直接输出空白。真正的坑在顺序和力度:椒盐噪声下先纠斜再去噪只剩 91.5~94.4,先去噪再纠斜是 98.6~99.1;中值核开到 9×9,英文从 98.9 掉到 91.0。同样的开关换一个识别器就不是一回事。macOS 自带识别对倾斜几乎无感,Otsu 在它身上反而让错字变多。
版本声明:数据在 2026-11-04 测得。测试用的 Mac 电脑芯片是 Apple M4,系统 macOS 26.5.2。软件是 Python 3.9、OpenCV 5.0.0 和 Tesseract 5.5.3,Tesseract 只装了英文语言包。macOS 自带识别调用的是系统文字识别框架的精确模式。浏览器端那一路跑在同一台电脑的桌面浏览器上。所有数字都是单次运行,没有重复取平均。
适用边界:样本只有两页清晰的出版物扫描。一页英文、一页中文,都是一栏、字号适中。倾斜和噪声是程序加上去的,不是真的扫歪、真的脏。下面的准确率只在这两页、这台电脑、这组参数上成立。别把它当成哪个识别器的通用水平,更别拿去换算成谁比谁强多少倍。手写、双栏、多页和手机拍照的透视变形都没测。
文章目录
一、扫描PDF识别前到底要不要做预处理
- 我想弄清每个开关各管多少用
- 两页样本和三个识别器
- 错字数按编辑距离算
二、页面歪了对识别影响有多大
- Tesseract歪5度只掉2.7个点
- macOS自带识别在5度内几乎不变
- 浏览器端识别从3度起就乱了行序
三、纠斜去噪二值化各自有多大用
- 只纠斜就能把5度拉回99.0
- 椒盐噪声下只去噪就拉到97.6
- Otsu单独用和不处理差不到1.2个点
- 自适应二值化遇到高斯噪声输出全空
四、为什么顺序反了结果差这么多
- 先纠斜再去噪只剩91.5到94.4
- 旋转插值把噪点糊成了灰斑
- 去噪纠斜再Otsu的组合每格都过98.5
五、预处理会不会做过头
- 中值核开到9英文掉到91.0
- 字号小一半时中值3就开始伤字
- 闭运算会把细笔画整片抹掉
- 中文页上Otsu让错字变多
六、歪5度只做中值为什么掉到34
- 字没认错而是版面被切碎了
- 换成整块识别模式就回到96.51
- 椒盐5度那一格也是同一个病
七、到底该开哪几个开关
- 先在你用的识别器上测一遍
- 接Tesseract时我会按这个顺序开
八、测量方法自身有哪些坑
- minAreaRect的角度换算会差90度
- JPEG和PNG的3度不是同一张图
- 只有两页清晰印刷件
九、适用边界与风险提示
十、还没解决的问题
参考资料
一、扫描PDF识别前到底要不要做预处理
我想弄清每个开关各管多少用
扫描版 PDF 里每页存的其实是图片,文字得靠 OCR 从图里认出来。识别脚本里的预处理有个省事的写法:转灰度、去噪、二值化、纠斜,四步一口气做完再交给识别器。字对得上的时候没人会回头看它,可一旦结果不好,你根本不知道是哪一步出的事,也不知道哪一步其实什么都没干。我是中文系转行过来的人,OpenCV 的参数多半靠查。对每一步背后的原理我没把握,这次干脆不讲原理,直接把每一步做成开关。开一个、关一个、换个顺序,再看错字数怎么变。这样做的好处是每一个结论都能落到某一格具体的数字上,看不懂原理也能看懂哪个开关在帮忙哪个开关在捣乱。
想回答的问题就三个:页面歪了几度识别会掉多少?纠斜、去噪、二值化分开看,各自能救回多少?顺序和力度会不会把好事办坏?为了让后两个问题有得比我把倾斜和噪声也做成了变量。倾角取 0°、1°、3°、5° 四档。噪声分无噪、高斯 σ=25、椒盐 5% 三种。预处理一共 9 种做法,含「不处理」。英文页上全部交叉一遍,我跑了 108 组。
两页样本和三个识别器
英文页是 H. G. Wells《The Time Machine》1895 年 William Heinemann 版的第 8 页。扫描件放在维基共享资源上,属于公有领域。真值用的是英文维基文库同一页的转录稿,那一页标着 Validated,意思是两个人校对过。我在上面补了页眉和页码,归一之后一共 1,002 个字符。中文页是国家语言文字工作委员会 1986 年发布的《关于重新发表〈简化字总表〉的说明》,扫描件来自 Internet Archive 并标注了公有领域标记。真值是逐句对图核出来的 557 个字。两页都是清晰的印刷件:英文页本身带约 0.3° 的原始倾斜,中文页大约是 −0.2° 到 −0.3°。后面估角度的时候这个零头还会冒出来。
识别器有三个:第一个是开源的 Tesseract 5.5.3。本机只有它的英文语言包,于是它只跑英文页。中文页上一律没测。macOS 自带的文字识别排第二,调的是系统框架精确模式。中英两页都跑了。最后一路是跑在浏览器里的 PP-OCR,我用的是图映 ImgIng imging.cn/ 的 PDF 内容提取默认档,模型在首次使用时下载到浏览器里。108 组网格只用了 Tesseract;中文页那 60 组接的是 macOS 自带识别。
错字数按编辑距离算
「错几个字」得先说清楚怎么数,这里用的是字符级编辑距离。把识别结果改成真值最少要增、删、改几个字符就记几。准确率 = 1 − 编辑距离 ÷ 真值字符数。英文页错 11 个字符时准确率就是 1 − 11/1002,约等于 98.9%。数之前先做了归一:中文去掉所有空白并统一全角半角标点。英文把弯引号统一成直引号,把行尾断开的词合并回去,多余空格合成一个。这样做是为了不让排版差异冒充识别错误。
另外还算了一项「丢字数」:它不管顺序,只看真值里有多少字在输出里压根没出现。编辑距离很大的时候,靠它判断是漏认了字还是排错了顺序。浏览器端那一路歪了以后的结果,就得靠这一项来读。
二、页面歪了对识别影响有多大
Tesseract歪5度只掉2.7个点
先看最简单的一行:不加噪声也不做处理,只把英文页转一个角度。0° 是 98.9,1° 是 99.5,3° 是 98.1,5° 是 96.2。1° 完全没掉还高了一点。3° 掉 0.8 个点,5° 掉 2.7 个点。换成字符数,在这页上只多错了二十几个。
加上高斯噪声后坡度陡一些:97.9、96.8、95.2、92.9。5° 比 0° 少了 5 个点。真正让 Tesseract 掉下去的是椒盐噪声。0° 不处理就只剩 75.5,5° 是 63.3。单看这一行就能排出一个和直觉相反的顺序:在这页清晰印刷件上伤 Tesseract 最重的是点状噪声,倾斜排在后面。1° 比 0° 还高这件事我没追。原页自带 0.3° 的倾斜,转 1° 之后实际是多少度、为什么反而好一点。单次结果说明不了。先记着。
macOS自带识别在5度内几乎不变
同样的倾角换到 macOS 自带识别上。中文页不处理时 0°、1°、3°、5° 分别错 5、4、9、5 个字(真值 557 字)。高斯噪声下是 7、7、7、6。这几组数上下跳几个字,跟倾角看不出关系。英文页在另一组测试里正页错 0、歪 3° 错 1、歪 5° 错 0,也很稳。它唯一明显吃亏的是椒盐噪声:中文页不处理时错 16~26 个字。系统框架内部怎么处理倾斜我不知道。只能从结果看出它对 5° 以内的倾斜不敏感。这一点对后面很重要:同一个纠斜开关对 Tesseract 有用。对它几乎是白做。
它也不是完全不受影响。歪 3° 再叠一层高斯 σ=12 的噪声后,中文页错 9 个字,英文页一下子错到 50 个字符。英文这 50 个里丢字只有 2 个,大头是一整行「"Our ancestors had no」被挪到了下一行后面。也就是说在噪声和倾斜一起出现时,它同样会出现行序错位,只是程度比浏览器端轻得多。同一张加噪页走完去噪、投影法纠斜和 Otsu 再交给它,中文降到 6 个,英文回到 1 个。
顺带记一个和倾斜无关的坑:系统框架还有一个快速模式,我也拿两页样本跑了一次。英文页错 260 个字符,中文页错 526 个,中文基本全错。我猜快速模式只认拉丁字母,这只是推断。如果你在脚本里调系统识别处理中文,记得用精确模式。
浏览器端识别从3度起就乱了行序
第三个识别器又是另一副样子:中文页正着放时图映默认档只错 2 个字。错在单独列出的偏旁「讠」被漏掉,以及「雠」出成了繁体「讎」。第二次跑结果逐字相同。英文页错 1 个字符,就是没输出页码 8。歪 1° 时中文错 1 个还算正常。到了 3° 中文错 175 个、丢字 31 个。两行短句整行没了,段首那一行还被排到下一行后面。英文错 400 个而丢字只有 1 个。字基本都认出来了,错在顺序。5° 时中文错 362 个、丢字 275 个,14 行里只剩大约一半。这时界面状态仍是处理完成,没弹任何提醒。
这里的两种「错」要分开看:英文 3° 那份输出字基本都在,错的是行序。拿去全文搜索问题不大,拿去直接排版就不行。中文 5° 的丢字是真丢。那几行字在输出里就不存在。歪了的页面先去噪、纠斜、做 Otsu 再送进去。中英两页都回到错 2 个。它为什么对倾斜这么敏感?我只能猜是文本行检测或阅读顺序那一步受了影响。这个说法没有依据,只能当推断看。对我更实际的结论是:用这类浏览器端识别处理扫描件时纠斜不是可选项。三个识别器对倾斜的耐受度排下来差的不是一点半点。
三、纠斜去噪二值化各自有多大用
108 组网格的完整结果在下面这张热力表里。行是 9 种预处理,列分成无噪、高斯、椒盐三块,每块里是 0°、1°、3°、5° 四个倾角。颜色越绿准确率越高、越红越低。
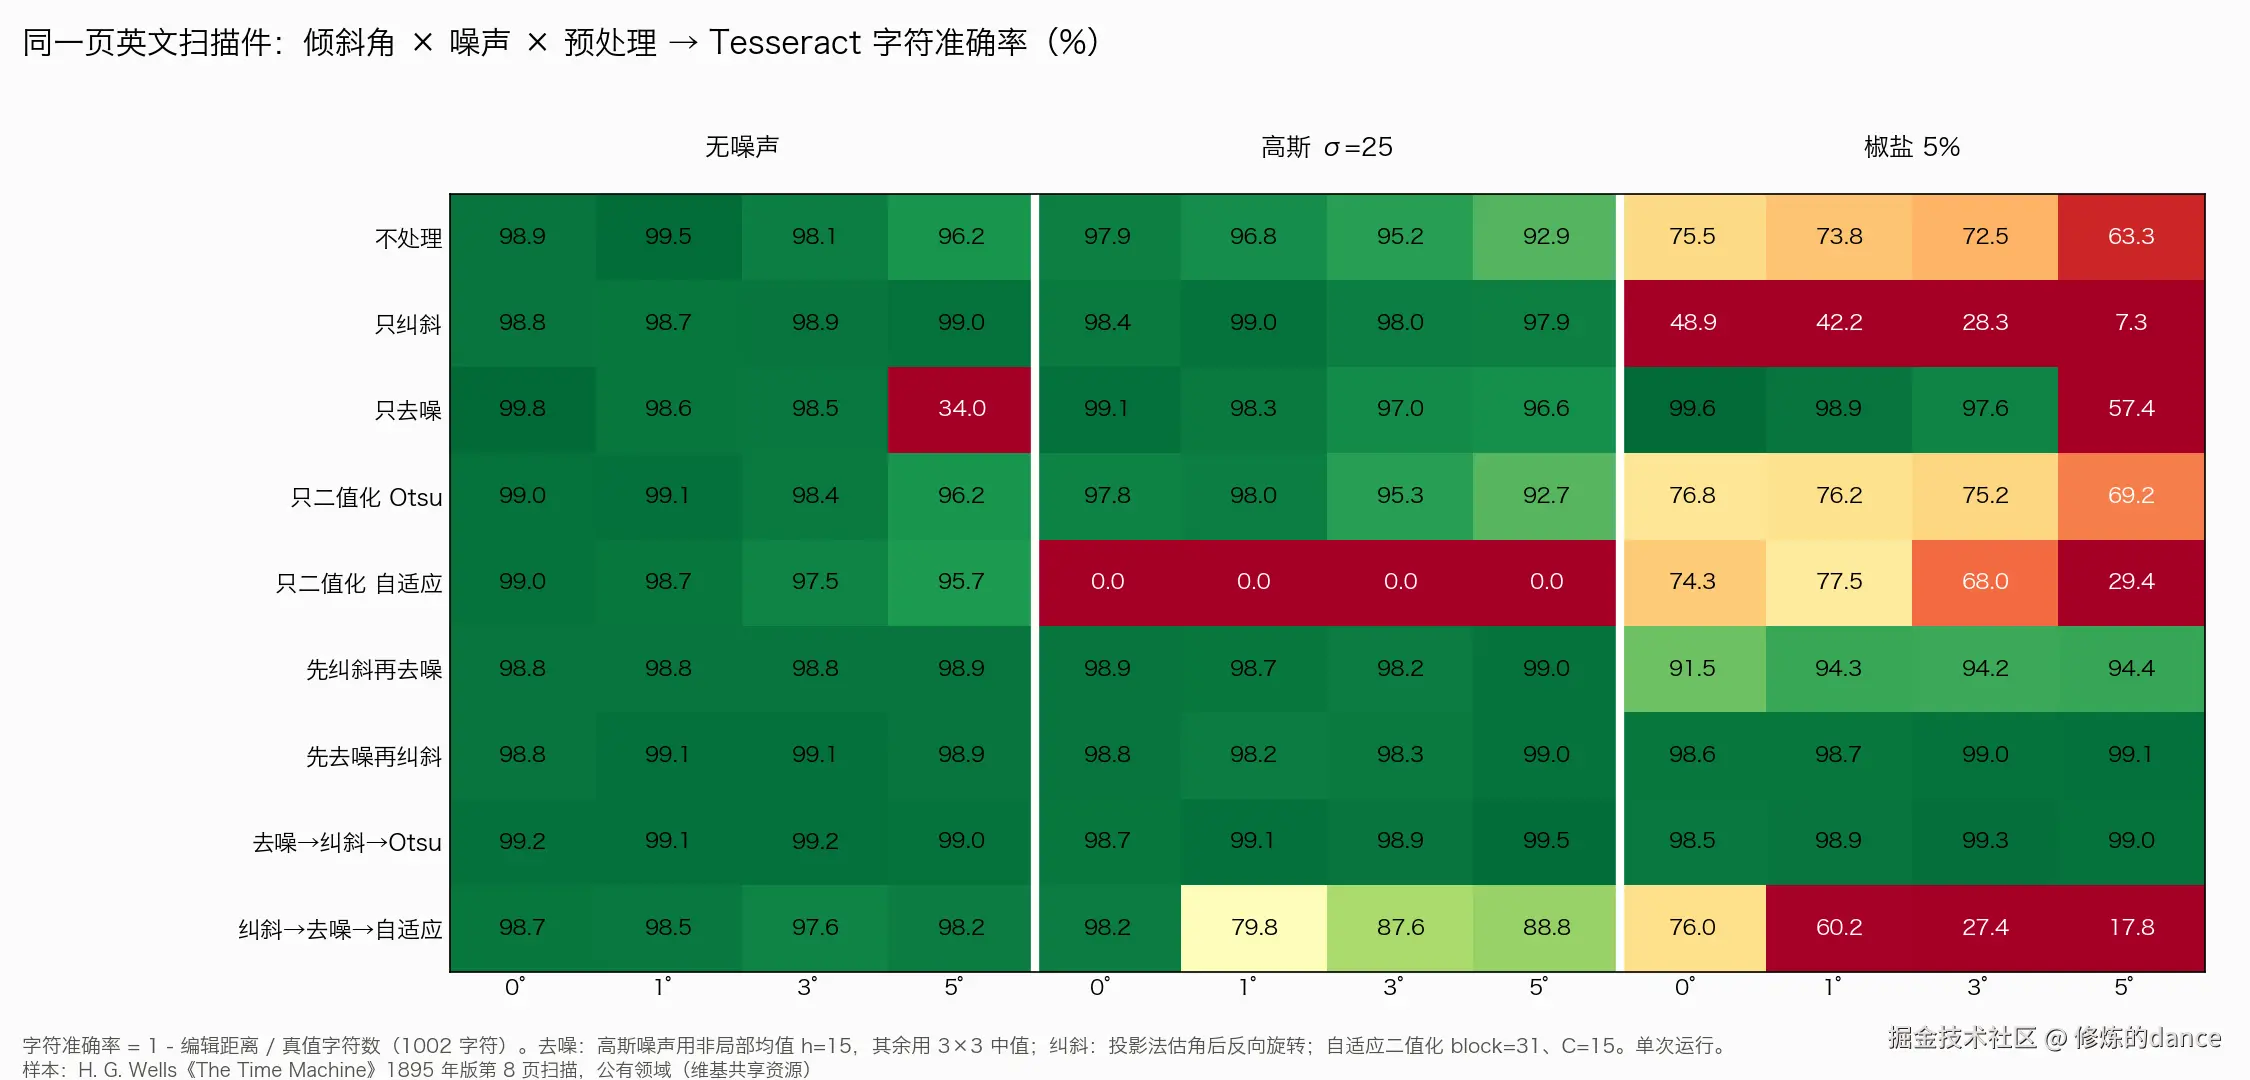
这张图要看三处红色:椒盐那一块里「只纠斜」整行发红,5° 只有 7.3。高斯那一块里「只二值化 自适应」四格全是 0.0。无噪 5° 那格「只去噪」孤零零一个 34.0。再看「先去噪再纠斜」和「去噪→纠斜→Otsu」两行在三种噪声下都是深绿。「先纠斜再去噪」在椒盐那块明显浅一截。样本是 H. G. Wells《The Time Machine》1895 年版第 8 页,来自维基共享资源,公有领域。倾斜和噪声是程序自制的。
这张热力表我习惯先横着看再竖着看。横着看的是同一种处理在不同倾角和噪声下稳不稳,一行里颜色忽深忽浅的处理就不适合写进固定流程。竖着看的是同一种页面状况下哪种处理最好,每一列最深的那一格就是这个条件下的最优解。两种看法得出的答案并不总是一致,第三章和第四章基本就是在拆这两种看法之间的差别。
只纠斜就能把5度拉回99.0
纠斜用的是投影法:先把页面缩到四分之一并转成黑底白字。再在 ±7° 范围内每 0.1° 转一次并算出每一行像素和的方差。方差最大的那个角度就是文字最横平的时候。原理不难懂:行和行之间是空白,转正了空白就整齐,行投影一高一低时方差最大。英文页转 0°、1°、3°、5° 后它估出来 0.3°、1.2°、3.3°、5.3°。多出来的 0.3° 正好是原页自带的倾斜。三种噪声下估出来都一样。
按估出的角度转回去后无噪 5° 从 96.2 回到 99.0,高斯 5° 从 92.9 回到 97.9。整行看,只纠斜在无噪下四个倾角是 98.8、98.7、98.9、99.0,在高斯下是 98.4、99.0、98.0、97.9。转完以后角度这个变量基本被抹平了,四格之间的差距都缩到一个多点以内,剩下的高低主要来自噪声本身。这一步在 Tesseract 上真有用,而且越歪越有用。1° 时只纠斜反而是 98.7,比不处理的 99.5 低一点。3° 才开始赚。
椒盐那一块的 0° 也值得多看一眼。页面本来没转,只纠斜却从不处理的 75.5 掉到 48.9。原因是投影法在这张图上照样估出了原页自带的那 0.3°,脚本就老老实实转了 0.3°。我的推断是:转得再少也要做一次三次插值,满页噪点会被抹开。这说明「歪得不多就别转」不只是省时间的考虑,在点状噪声多的页面上它直接决定结果好坏。所以第七章的流程里我会加一条门槛:估出来不到 1° 就不转。依据是这一格,门槛本身没有单独测。
椒盐噪声下只去噪就拉到97.6
去噪按噪声类型分开选:高斯噪声用非局部均值(强度 15、模板 7、搜索窗 21)。无噪和椒盐用 3×3 中值。椒盐那一块收益最大:歪 3° 时不处理是 72.5 而只去噪是 97.6,一步补回 25 个点。0° 的椒盐页只去噪是 99.6,比干净原页不处理的 98.9 还高。高斯那一块的收益温和得多,5° 时从 92.9 到 96.6。把只去噪那一行整行读下来更能看出它管不了什么。椒盐下四个倾角是 99.6、98.9、97.6、57.4,高斯下是 99.1、98.3、97.0、96.6。两块都是角度越大分越低,去噪只把噪点清掉了,倾斜带来的那部分损失还原样留着。椒盐 5° 的 57.4 掉得最狠,它的成因放在第六章单独拆。
最让我意外的是「只纠斜」在椒盐噪声下的表现。不去噪直接纠斜时 0° 是 48.9,5° 掉到 7.3。这比什么都不做的 63.3 差得多。纠斜在另外两块都是加分项。到这里成了减分最狠的一步。原因放到第四章和顺序问题一起说。
Otsu单独用和不处理差不到1.2个点
Otsu 是全局阈值二值化。它自动在灰度直方图里找一个分界把整页切成黑白两色。在无噪和高斯两块里只做 Otsu 和不处理的差距都在 1.2 个点以内。有的格子高一点有的低一点,看不出方向。高斯 1° 是 96.8 对 98.0,5° 是 92.9 对 92.7。椒盐那一块高出 1.3~5.9 个点,可绝对值仍只有 69~77%。这只是从很差变成不太差。推断原因是 Tesseract 识别前本身就会二值化一遍,外面先做等于抢了它的活,没有增量。这条没核实。单独开这个开关在这页上收益接近于零。如果你的扫描件纸面发黄或者有大片阴影,全局阈值可能会表现不一样。这次的两页纸面都还算干净,这一点没有样本能验证。
自适应二值化遇到高斯噪声输出全空
自适应二值化按局部窗口算阈值,这次的参数是高斯加权、窗口 31、常数 15。无噪时它和 Otsu 差不多:四个倾角是 99.0、98.7、97.5、95.7,和不处理那一行一样随倾角往下走,说明它在干净页面上既没帮上忙也没捣乱。可一加高斯噪声,四个倾角全是 0.0。Tesseract 一个字都没输出。处理后的图满屏都是斑点。局部阈值把每一处噪声起伏都当成了笔画。椒盐那一块也不好,5° 只有 29.4。前三个倾角是 74.3、77.5、68.0,和不处理的 75.5、73.8、72.5 差不多,局部阈值并没有把椒盐点当成背景处理掉,到 5° 才和倾斜叠在一起彻底塌下去。就算先纠斜、先去噪再做自适应,高斯 1° 也只有 79.8,椒盐 3° 是 27.4。
所以自适应二值化不适合放进默认流程。它不是不能用,确认页面干净之后再开更稳。
四、为什么顺序反了结果差这么多
先纠斜再去噪只剩91.5到94.4
同样是纠斜加去噪,换个先后椒盐那一块就差出一大截。先纠斜再去噪时四个倾角是 91.5、94.3、94.2、94.4。先去噪再纠斜是 98.6、98.7、99.0、99.1。无噪和高斯两块里两种顺序都在 98~99 之间。看不出差别。差别只出在椒盐上。为了确认不是网格脚本哪里写岔了我单独写了一段。它只看歪 3°、椒盐 5% 这一个条件,把四种开法放在一起跑。
python
import cv2, numpy as np, subprocess
from cer import score   # 字符编辑距离打分,归一规则见正文

def spin(pic, deg):                      # 绕中心转 deg 度,画布放大、补白
    h, w = pic.shape
    m = cv2.getRotationMatrix2D((w / 2, h / 2), deg, 1)
    cw, sw = abs(m[0, 0]), abs(m[0, 1])
    nw, nh = int(h * sw + w * cw), int(h * cw + w * sw)
    m[0, 2] += nw / 2 - w / 2; m[1, 2] += nh / 2 - h / 2
    return cv2.warpAffine(pic, m, (nw, nh), flags=cv2.INTER_CUBIC, borderValue=255)

def dots(pic, ratio, seed=20261104):     # 椒盐噪点
    roll = np.random.default_rng(seed).random(pic.shape)
    out = pic.copy(); out[roll < ratio / 2] = 0; out[roll > 1 - ratio / 2] = 255
    return out

def guess_tilt(pic):                     # 投影法:缩到 1/4,±7° 每 0.1° 试一次
    tiny = cv2.resize(pic, None, fx=0.25, fy=0.25, interpolation=cv2.INTER_AREA)
    mask = cv2.threshold(tiny, 0, 255, cv2.THRESH_BINARY_INV + cv2.THRESH_OTSU)[1]
    rows_n, cols_n = mask.shape
    def row_var(t):
        m = cv2.getRotationMatrix2D((cols_n / 2, rows_n / 2), t, 1)
        rows = cv2.warpAffine(mask, m, (cols_n, rows_n), flags=cv2.INTER_NEAREST).sum(1, dtype=np.float64)
        return np.var(rows)
    return -round(max(np.arange(-7, 7 + 1e-9, 0.1), key=row_var), 2)

def read_en(pic):
    cv2.imwrite('tmp.png', pic)
    return subprocess.run(['tesseract', 'tmp.png', 'stdout', '-l', 'eng'],
                          capture_output=True, text=True).stdout

ref_text = open('truth.txt').read()
if __name__ == '__main__':
    page = dots(spin(cv2.imread('page.jpg', 0), 3), 0.05)
    flows = {
        '不处理':         lambda p: p,
        '只纠斜':         lambda p: spin(p, -guess_tilt(p)),
        '先纠斜再中值':   lambda p: cv2.medianBlur(spin(p, -guess_tilt(p)), 3),
        '先中值再纠斜':   lambda p: (lambda q: spin(q, -guess_tilt(q)))(cv2.medianBlur(p, 3)),
    }
    for name, fn in flows.items():
        r = score(ref_text, read_en(fn(page)), 'en')
        print(f"{name:<8} 错 {r['edits']:>4} / {r['gt_chars']}  准确率 {r['acc']}%")
yaml
$ python3 toggle.py
不处理      错  275 / 1002  准确率 72.55%
只纠斜      错  718 / 1002  准确率 28.34%
先纠斜再中值   错   58 / 1002  准确率 94.21%
先中值再纠斜 错 10 / 1002 准确率 99.0%代码说明:page.jpg 是英文原页,truth.txt 是真值。cer 是按第一章那套归一规则算编辑距离的小模块。倾斜和噪点都在内存里加,不另存 JPEG,这张图和 108 组网格用的是同一种输入。四种开法唯一的区别是中值和旋转的先后。估角都用投影法,旋转都用三次插值,中值都是 3×3。后面几段代码会从这个文件里借 spin、dots、guess_tilt、read_en 以及真值和打分函数。
四行输出和热力表上「歪 3°、椒盐」那一列对得上:72.5、28.3、94.2、99.0。先中值再纠斜只错 10 个字符,先纠斜再中值错 58 个,只纠斜错 718 个。同样两步只是换了先后,错字就从 58 个降到 10 个。
网格里还有一行能佐证这件事:「纠斜→去噪→Otsu」和「去噪→纠斜→Otsu」只差前两步的先后,后面都接了 Otsu。前者在椒盐下是 92.5、94.5、97.7、96.6,后者是 98.5、98.9、99.3、99.0。加了 Otsu 也没把先纠斜的亏补回来。推断是灰斑在二值化时被切成了黑块。换成自适应收尾更糟,「纠斜→去噪→自适应」在椒盐下只有 76.0、60.2、27.4、17.8,倾角越大掉得越多。
旋转插值把噪点糊成了灰斑
为什么会这样呢?我能给的只是推断,好在和图上看到的对得上。椒盐噪声是一个个孤立的纯黑、纯白像素。中值滤波专门对付这种东西:3×3 窗口里取中间值时一个孤零零的黑点会被周围八个白点投票投掉。可如果先旋转事情就变了:三次插值转图时,新图每个像素都是旧图 4×4 邻域里十六个点的加权和。一个孤立黑点会被抹到旁边几个像素上变成一小团深浅不一的灰斑。灰斑不再是孤立的一个点,3×3 中值投不掉它。Tesseract 把它当成笔画的一部分。错字就上去了。只纠斜不去噪时满页都是这种灰斑,于是掉到 28.34%。
眼下能确定的只有一句:在这页上碰到点状噪声时,去噪要放在纠斜前面。想自己核对这个推断,可以把旋转后的椒盐页局部放大到 400% 左右,再和先做中值再旋转的同一块区域对比,看孤立黑点有没有变成边缘发灰的小团块。这条推断和图像对得上,但没做量化统计。
去噪纠斜再Otsu的组合每格都过98.5
顺序理顺后再把 Otsu 接在最后。这一行在 12 个条件下是 98.5~99.5。最低的 98.5 在椒盐 0°,最高的 99.5 在高斯 5°。和不加 Otsu 的「先去噪再纠斜」比各格互有高低。差距都很小。Otsu 放在最后起的作用跟它单独用时差不多,聊胜于无。把两行在无噪和高斯下的数并排放就看得出来:不加 Otsu 时无噪四个倾角是 98.8、99.1、99.1、98.9,加上之后是 99.2、99.1、99.2、99.0;高斯下不加是 98.8、98.2、98.3、99.0,加上之后是 98.7、99.1、98.9、99.5。差得最多的一格也不到一个点,而且有升有降。
这一行的价值不在最高分而在稳。三种噪声、四个倾角里它没有一格掉下 98.5。要是只能写死一套流程又事先不知道进来的扫描件是什么状况,在 Tesseract 上我会选它。网格里用自适应收尾的那一行是「纠斜→去噪→自适应」,高斯 1° 只剩 79.8。它前两步的顺序也不同,没法全算在自适应头上,但最后那一步选哪种二值化至少不是随便的。
五、预处理会不会做过头
中值核开到9英文掉到91.0
去噪有用,那开大点是不是更好?我把英文原页分别做 3×3、5×5、7×7、9×9 中值,不加噪也不旋转。错字数是 2、6、14、90,对应准确率 99.8、99.4、98.6、91.0。不处理是错 11 个、98.9。3×3 最好,比不处理还少错 9 个。我猜是它顺手抹掉了纸面上的一些杂点。5×5 开始回升,9×9 直接多错了 79 个。非局部均值也一样:强度 15 时错 7 个,开到 40 错 28 个。中文页那边接的是 macOS 自带识别,不处理错 5 个。中值 3、5、7、9 依次是 4、9、34、178。9×9 的准确率是 68.0%,7×7 起就明显伤字。
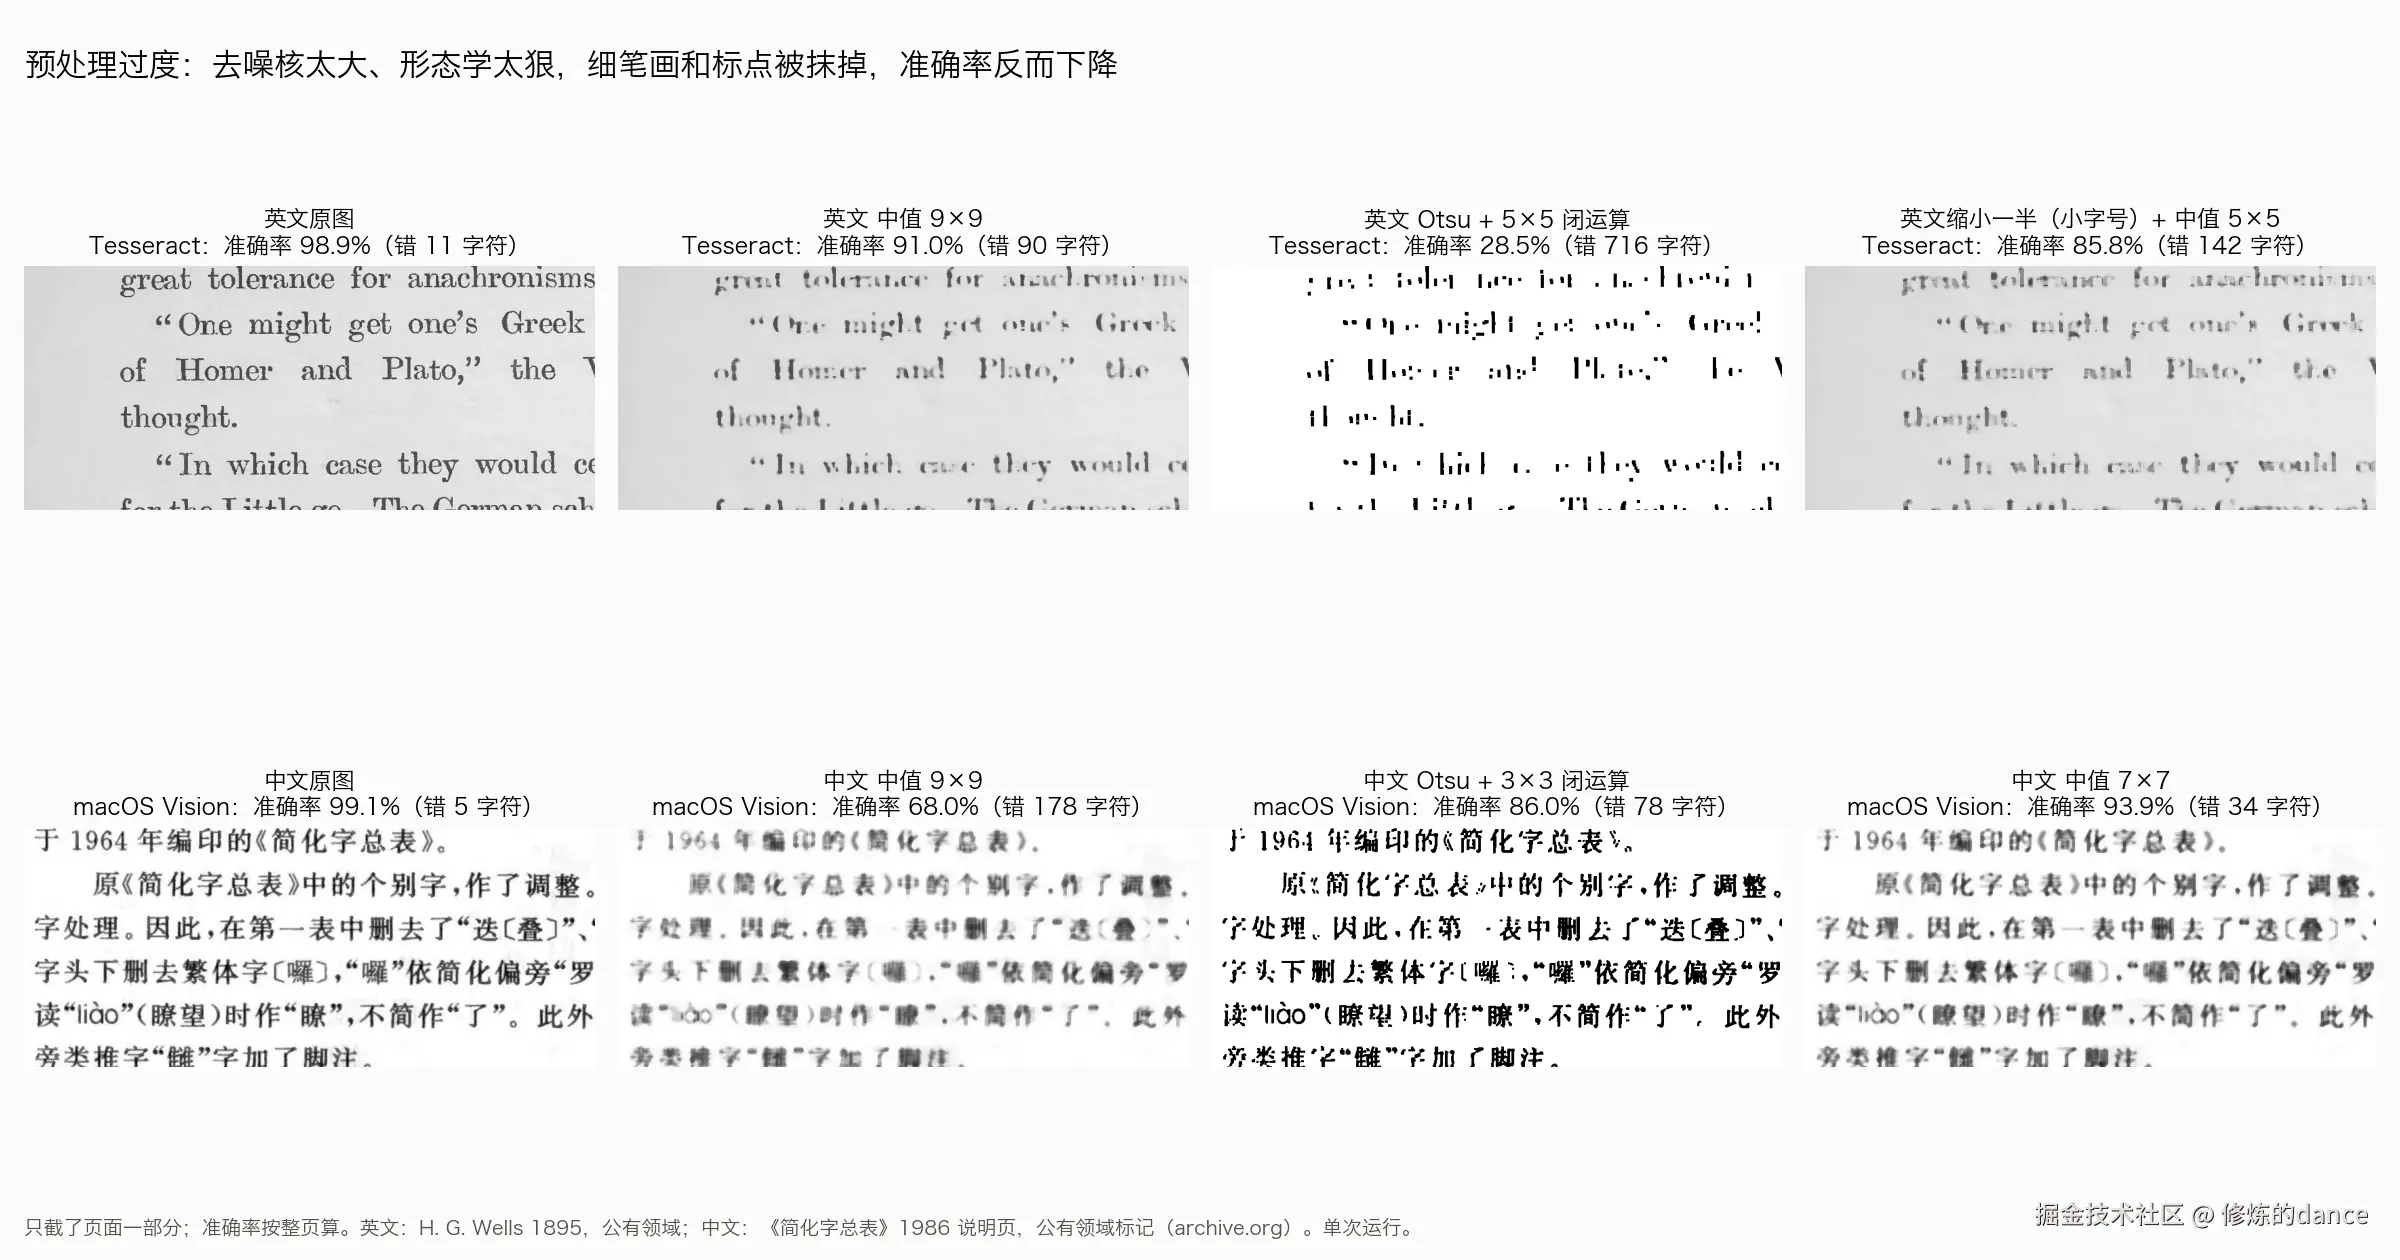
这张图要看第二列和第三列:英文「中值 9×9」那一格字母边缘糊成一团,「anachronisms」已经认不太出来。英文「Otsu + 5×5 闭运算」那一格笔画被抹成了断断续续的碎块,准确率只剩 28.5%。下面一排中文里「中值 9×9」的顿号、细横和偏旁明显变淡,标的是 68.0%。英文样本是 H. G. Wells《The Time Machine》1895 年版。公有领域。中文样本是国家语言文字工作委员会《简化字总表》1986 年新版说明页,来自 Internet Archive 并标注公有领域标记。
字号小一半时中值3就开始伤字
核开多大跟字号绑在一起。我把英文页缩小一半,宽度从 1516 变成 758。这相当于模拟一份字号更小或分辨率更低的扫描件,然后跑一遍同样的中值核。
python
import cv2
from toggle import read_en, ref_text, score

full = cv2.imread('page.jpg', 0)
half = cv2.resize(full, None, fx=0.5, fy=0.5, interpolation=cv2.INTER_AREA)
for tag, pic in (('原尺寸 宽1516', full), ('缩一半 宽758', half)):
    row = []
    for k in (0, 3, 5, 7, 9):
        out = read_en(cv2.medianBlur(pic, k) if k else pic)
        row.append(f"{'不做' if k == 0 else f'中值{k}'} {score(ref_text, out, 'en')['edits']}")
    print(tag, ' | '.join(row))
ruby
$ python3 kernel.py
原尺寸 宽1516 不做 11 | 中值3 2 | 中值5 6 | 中值7 14 | 中值9 90
缩一半 宽758 不做 4 | 中值3 28 | 中值5 142 | 中值7 765 | 中值9 730代码说明:缩小用的是 INTER_AREA。k 为 0 表示不做中值直接识别。输出是错字数,真值 1,002 字符。read_en 每次把图写成临时 PNG,再用默认参数调 Tesseract。
3×3 中值在原尺寸上是 11 降到 2;同样的核放到缩一半的页面,错字由 4 涨成 28。缩一半后中值 5 错 142 个(准确率 85.8%)。中值 7 错 765 个,基本不能用了。缩一半的中值 9 错 730 个,比中值 7 还少一点。这两个数都烂到没有比较意义,我没去追。
还有个顺手看到的现象:缩一半后不处理只错 4 个,比原尺寸的 11 个还少。原因我说不上来,我猜是缩小时 INTER_AREA 本身就把纸面杂点平均掉了一部分,没验证。核大小要跟着字号走,这一点在这组数里很清楚。笔画越细,能承受的核越小。
闭运算会把细笔画整片抹掉
形态学操作是另一个容易开过头的开关。OpenCV 的形态学操作把白色当前景。闭运算填的是白色区域里的小黑缝。在白底黑字的图上,被当成小黑缝填掉的恰好是细笔画。想对黑字做闭运算,得先反相。
数据很难看:英文页先 Otsu 再做 3×3 闭运算,错 62 个(准确率 93.8%)。接 5×5 闭运算错 716 个,只剩 28.5%。缩一半的页面上做 Otsu 加 3×3 闭运算后 Tesseract 干脆输出为空。中文页交给 macOS 自带识别,3×3 闭运算版本错 78 个,5×5 版本错 519 个(准确率 6.8%)。这个坑比核大小更隐蔽,因为参数看着都很小,3×3 而已。
中文页上Otsu让错字变多
最后一个反例来自 macOS 自带识别。中文页 60 组网格里只做 Otsu 那一行在三块里的错字是这样的:无噪 9/6/11/8,高斯 11/12/11/8,椒盐 18/13/13/12。和不处理比,无噪和高斯两块里 Otsu 一律更差。只有椒盐那块不处理本身就很差(25/26/19/16)。Otsu 才显得好一点。纠斜对它也几乎没贡献。只纠斜那一行和不处理基本持平。只纠斜那一行的具体数是无噪 5/4/5/5、高斯 6/9/4/8、椒盐 25/20/24/23,和不处理那一行逐格比有高有低,看不出纠斜往哪个方向推。只去噪那一行在高斯下是 5/6/10/6,和不处理的 7/7/7/6 也差不多。它唯一真正受益的是椒盐下的去噪,只去噪那一行是 5/5/8/6。连「去噪→纠斜→Otsu」这条在 Tesseract 上最稳的组合到它身上也是 5~14 个错字。无噪和高斯两块的 8 格里有 7 格比不处理差。只在椒盐下好一些。
把这一节和第三章放在一起看就明白我为什么不想给一个通用流程。Otsu 对 Tesseract 是聊胜于无,对 macOS 自带识别是有害。纠斜对 Tesseract 要 3° 以上才有用,对 macOS 自带识别是白做,对浏览器端那一路是必须做。同样一串预处理换个识别器,结论就得重来。
六、歪5度只做中值为什么掉到34
字没认错而是版面被切碎了
热力表里最刺眼的一格是无噪、5°、只去噪:34.0。前后左右都是 96~99,就它掉到了三十几。直觉上会以为是中值滤波伤了字。可同样的 3×3 中值在 0° 上是 99.8,在 1° 和 3° 上也都在 98 以上。偏偏只有 5° 出事,这说不通。
把这一格的识别文本打开一看,问题不在字。一栏正文被切成了好几块,前一句的前半截和别的句子的后半截交错排在一起。单词本身大多是对的。Tesseract 的版面分析在这张图上判断错了并把一栏当成了好几块。读出来的顺序全乱,编辑距离按顺序算自然就爆了。
既然是版面切分的问题,我想到的办法是不让它自己切。Tesseract 有个页面分割模式参数 --psm。默认的 3 表示全自动版面分析。6 表示把整张图当成一个统一的文字块,不再找栏和区块。我写了一段只看 5° 的对照:三种输入各跑两种模式,顺便数一下输出有多少非空行。纠斜后的那张图输出是 28 个非空行。
python
import cv2, subprocess
from toggle import spin, guess_tilt, ref_text, score

src = cv2.imread('page.jpg', 0)
tilted = spin(src, 5)
cases = {
    '歪5° 不处理':        tilted,
    '歪5° 只中值3':       cv2.medianBlur(tilted, 3),
    '歪5° 纠斜后中值3':   cv2.medianBlur(spin(tilted, -guess_tilt(tilted)), 3),
}
for label, pic in cases.items():
    cv2.imwrite('cur.png', pic)
    for mode in ('3', '6'):
        out = subprocess.run(['tesseract', 'cur.png', 'stdout', '-l', 'eng', '--psm', mode],
                             capture_output=True, text=True).stdout
        r = score(ref_text, out, 'en')
        print(f"{label:<12} psm {mode}  错 {r['edits']:>4}  准确率 {r['acc']}%  非空行 {sum(1 for x in out.splitlines() if x.strip())}")
erlang
$ python3 psm.py
歪5° 不处理      psm 3  错   38  准确率 96.21%  非空行 27
歪5° 不处理      psm 6  错   35  准确率 96.51%  非空行 28
歪5° 只中值3     psm 3  错  661  准确率 34.03%  非空行 64
歪5° 只中值3     psm 6  错   35  准确率 96.51%  非空行 28
歪5° 纠斜后中值3   psm 3  错   11  准确率 98.9%  非空行 28
歪5° 纠斜后中值3 psm 6 错 11 准确率 98.9% 非空行 28代码说明:三种输入都在内存里由英文原页转 5° 得到,不加噪声。每张图写成临时 PNG,分别用默认的 --psm 3 和 --psm 6 跑一次。非空行是输出里去掉空白行之后的行数。
换成整块识别模式就回到96.51
输出把事情说得很清楚:只中值 3 在默认模式下错 661 个(准确率 34.03%),非空行是 64。这比正常的 28 行多出一倍多,就是版面被切碎的样子:一行字被拆成好几截各占一行。换成 --psm 6 后同一张图错 35 个、96.51%,非空行回到 28。先纠斜再中值的那张图两种模式都是 98.9%。这张图摆正以后,版面分析就没再切错。
这一组是我这次最大的收获。热力表里那个 34.0 如果只看数字,很容易得出「歪了就别做中值」或「中值在大角度下伤字」这种结论。两个都不对,字根本没伤。病根是 5° 时 Tesseract 的自动版面切分很脆,中值让某些细节变了一点它就切错了。解法有两条:先纠斜,或者在确定是单栏时直接用 --psm 6。
不过 --psm 6 有前提:双栏、带表格、带侧边注释的页面用它会把不同栏的字串成一行,那是另一种乱。这一页是单栏,我也只验证了这一种图。换别的页面能不能同样救回来我不知道。
椒盐5度那一格也是同一个病
热力表里还有一格和 34.0 长得很像:椒盐 5% 下歪 5° 只去噪是 57.4,同一列先去噪再纠斜却是 99.1。按上面的思路,我怀疑它也是版面被切碎,就用同样的办法补跑了一组。
python
import cv2, subprocess
from toggle import spin, dots, ref_text, score

noisy5 = dots(spin(cv2.imread('page.jpg', 0), 5), 0.05)
for label, pic in (('椒盐 歪5° 不处理', noisy5), ('椒盐 歪5° 只中值3', cv2.medianBlur(noisy5, 3))):
    cv2.imwrite('cur.png', pic)
    for mode in ('3', '6'):
        out = subprocess.run(['tesseract', 'cur.png', 'stdout', '-l', 'eng', '--psm', mode],
                             capture_output=True, text=True).stdout
        r = score(ref_text, out, 'en')
        print(f"{label:<14} psm {mode}  错 {r['edits']:>4}  准确率 {r['acc']}%  非空行 {sum(1 for x in out.splitlines() if x.strip())}")
erlang
$ python3 psm_sp.py
椒盐 歪5° 不处理     psm 3  错  368  准确率 63.27%  非空行 28
椒盐 歪5° 不处理     psm 6  错  395  准确率 60.58%  非空行 21
椒盐 歪5° 只中值3    psm 3  错  427  准确率 57.39%  非空行 50
椒盐 歪5° 只中值3 psm 6 错 40 准确率 96.01% 非空行 28代码说明:输入是英文原页在内存里转 5° 再加椒盐 5%,随机种子和网格一致。dots 和 spin 都从第四章那个文件里借。其余跟上一段相同,只是输入换成了带噪的页面。
猜对了一半:只中值 3 在默认模式下非空行是 50,又是切碎的样子;换成 --psm 6 后错 40 个、96.01%,非空行回到 28。不处理的那张图换 --psm 6 却没有帮助,反而从 63.27% 变成 60.58%。非空行只剩 21 行。我的理解是噪点还在的时候,问题出在字本身被噪点污染,不在版面切分上,换分割模式也救不回来。两格放在一起看就清楚了:--psm 6 管的是版面被切碎,管不了噪声。先去噪、再纠斜仍然是更稳的那条路。
七、到底该开哪几个开关
先在你用的识别器上测一遍
把前面几章的数据压成一张表,是下面这样。每格写的是这个开关在这个识别器上的作用,依据都是这两页的单次结果。
| 开关 | Tesseract(英文页) | macOS 自带识别(中文页) | 浏览器端 PP-OCR(图映默认档) |
|---|---|---|---|
| 纠斜 | 3° 起有用,5° 无噪从 96.2 回到 99.0 | 几乎没贡献 | 必须做,3° 起行序乱,5° 中文丢约一半 |
| 去噪 | 椒盐下决定性(3° 从 72.5 到 97.6),高斯下中等 | 只在椒盐下明显有用(16~26 降到 5~8 个错字) | 只测了去噪、纠斜、Otsu 连做 |
| Otsu | 单独用和不处理差 ≤1.2 个点 | 一律略差 | 单项没测 |
| 自适应二值化 | 遇高斯噪声输出全空 | 没测 | 没测 |
| 顺序 | 椒盐下去噪要在纠斜前(98.6~99.1 对 91.5~94.4) | 没单独测 | 没测 |
表里的「没测」我没去补。浏览器端那一路只跑了正页、歪 1°、3°、5° 以及「去噪→纠斜→Otsu」之后再送进去这几种。单项开关都没有拆开。
这张表想说的就一件事:别人给的预处理流程的前提是他用的那个识别器。换了识别器就先拿几页自己的扫描件把开关挨个开关一遍,再决定留哪几个。这三个识别器正好对应三种常见的拿法:装一个开源命令行工具自己写脚本,调用系统自带的识别能力,或者在网页里直接把文件拖进去。前两种的预处理开关都握在你自己手里,想加哪一步就加哪一步。第三种的预处理你基本碰不到,只能在把文件交给它之前自己把页面摆正弄干净。落到实际使用上就是一句话:用浏览器端工具的时候要做的预处理反而得在工具外面完成。Tesseract 是命令行工具,几十组开关写个循环就能跑完而不用一格格手点。
我这次的做法可以照搬到自己的扫描件上,成本不高。先挑三到五页有代表性的页面,至少有一页是你最常处理的那种。页面最好覆盖你手里最差的那种状况,比如复印过好几次的发灰页面或者边角卷起来的页面。挑一页手工录出真值,几百字就够,录完逐句对一遍图。然后把倾角和噪声当变量,用程序在这页上造出几个变体,再把每个预处理开关单独开、两两组合开,各跑一次识别。最后按编辑距离打分,顺手数一下输出的非空行。非空行突然变多就是版面被切碎了。这比看准确率更早发现问题。非空行数可以当成第一道检查。它不需要真值,任何一页识别完都能数出来,和同一批页面的平均值差得太多就单独拎出来看一眼。整张表跑出来以后,留下那几个在你的页面上真有用的开关,其余的从流程里删掉。
接Tesseract时我会按这个顺序开
后面接的是 Tesseract 而扫描件状况又不确定时我会这样排。先估角度,歪得不到 1° 就不转,省一次插值。有点状噪声就先做 3×3 中值再纠斜。高斯类的颗粒噪声用非局部均值并且强度别开太大。纠斜用投影法,角度范围按自己的扫描件定。最后接 Otsu 而不用自适应。核大小按字号定,字小的页面宁可不做中值。确认是单栏的话识别时加 --psm 6。给自动版面分析留一道保险。网格里不带门槛、不加 --psm 6 的「去噪→纠斜→Otsu」在这页 12 个条件下是 98.5~99.5;门槛和 --psm 6 加进去之后没有整套重跑。
接 macOS 自带识别时我基本只留一步。页面上有明显的点状噪点就做个 3×3 中值。其余都不做。
接浏览器端识别(比如前面用的图映 PDF 内容提取)时,倾斜是第一件要处理的事。扫描件歪了先在本地摆正再拖进去。它在 5° 时少了半页字而界面上不会告诉你。它还有两个边界:页面图是 JPEG 2000 或 JBIG2 压缩的扫描件当前识别不了,韩文也不识别。本次抓包里 19 次任务都没有发出把 PDF 传出去的请求。处理时下载的是识别模型和运行库。默认档的模型约 31.2 MB。
八、测量方法自身有哪些坑
minAreaRect的角度换算会差90度
估倾斜角除了投影法,另一个常见做法是对所有文字像素求最小外接矩形。角度取自 OpenCV minAreaRect 的返回值。坑在版本:OpenCV 升级后 minAreaRect 的角度取值区间变过,网上流传的 if w < h: a -= 90 对应的是旧区间。我用 OpenCV 5.0.0 对歪 3° 和 5° 的两张页面各跑了一次。
python
import cv2, sys
from toggle import guess_tilt

pic = cv2.imread(sys.argv[1], 0)
ink = cv2.threshold(pic, 0, 255, cv2.THRESH_BINARY_INV + cv2.THRESH_OTSU)[1]
(_, _), (bw, bh), raw = cv2.minAreaRect(cv2.findNonZero(cv2.medianBlur(ink, 3)))
old = raw - 90 if bw < bh else raw          # 网上常见的老换算
new = (raw + 45) % 90 - 45                  # 不管哪个版本,先折回 ±45°
print(f'OpenCV {cv2.__version__}  原始角度 {raw:.2f}  框宽 {bw:.0f} 框高 {bh:.0f}')
print(f'老换算 {-old:.2f}°   折回后 {-new:.2f}°   投影法 {guess_tilt(pic):.2f}°')
yaml
$ python3 tilt.py page_rot3.jpg
OpenCV 5.0.0  原始角度 -3.37  框宽 1202 框高 2033
老换算 93.37°   折回后 3.37°   投影法 3.30°
$ python3 tilt.py page_rot5.jpg
OpenCV 5.0.0  原始角度 -5.37  框宽 1202 框高 2033
老换算 95.37° 折回后 5.37° 投影法 5.30°代码说明:page_rot3.jpg 和 page_rot5.jpg 是英文原页旋转后另存的 JPEG。minAreaRect 之前先做 Otsu 反相和 3×3 中值,去掉零星噪点,免得一个孤立点把外接矩形撑大。old 是老写法,new 把任何区间的角度都折回 ±45°。
老写法在这里给出 93.37° 和 95.37°。要是直接拿去旋转页面会被转成竖的。原因是这一页的文字区域是竖长的(框宽 1202、框高 2033)。这个版本已经直接返回 −3.37,老换算又多减了 90。折回 ±45° 之后是 3.37° 和 5.37°,和投影法的 3.30°、5.30° 只差零点零几度。原页自带的 0.3° 两种方法都量到了。
网格里用的是投影法,这个坑没影响网格结果。但如果你的脚本是从老教程抄的 minAreaRect,换了 OpenCV 版本后最好先打印一次原始角度。还有一处别混:5° 这张 JPEG 上 minAreaRect 是 5.37°,网格那边 PNG 输入量出来是 5.41°。输入不同不能拿来比。
投影法在中文页上同样准。中文页转 0°、1°、3°、5° 后估出来的是 −0.2~−0.3°、0.8°、2.8°、4.8°,扣掉原页自带的那一点负角度,和加上去的角度对得上。反方向转 −3° 时投影法估出 −2.7°,minAreaRect 是 −2.59°,两者差得比正方向稍多一点。这次只有这一个反向样本,差距是不是固定偏向哪一边我说不好。
JPEG和PNG的3度不是同一张图
同样叫「歪 3°」这次其实有两种图。108 组网格是在内存里旋转、加噪再直接写 PNG 送进 Tesseract 的,没经过 JPEG。第二章里浏览器端和 macOS 自带识别用的倾斜页,是另存成质量 88 的 JPEG 再嵌进 PDF 的。Tesseract 3° 不处理时网格里那张 PNG 是 98.1%,JPEG 那张错 23 个(97.7%)。差的这一点我猜来自那次 JPEG 压缩,没单独验证。差距不大。可要是把两张表里的数混着比就会得出一些莫名其妙的结论。文中凡是引倾斜页的数我都尽量交代了是哪一种。
JPEG 那一套倾斜页交给 Tesseract,原页 11 个错,3° 是 23 个,5° 是 38 个,3° 叠高斯 σ=12 是 25 个。同一张加噪页走完去噪、投影法纠斜和 Otsu 之后错 13 个。这套数和网格里 PNG 的趋势一致,只是绝对值差几个字符。引用的时候把这两套分开写就不会乱。
还有一个口径问题:错字数是按顺序算的编辑距离。行序乱了而字一个没少时编辑距离也会很大。第二章浏览器端英文 3° 那份输出就属于这种。单看编辑距离会把排错和漏认混在一起,所以这次另算了丢字数。用这套数做判断前先想清楚你的用途怕哪一种。做全文检索时顺序乱问题不大。要原样排版的话顺序乱就是不能用。
只有两页清晰印刷件
最大的局限是样本:两页都是清晰的出版物扫描,一栏且字号适中。英文是 1895 年的书,中文是 1986 年的官方文件。真实的扫描件会有阴影、透视、装订线、双栏、表格和手写批注。这些这次一个都没有。中文页上 Tesseract 没测这件事也会限制结论的范围。英文页上 Tesseract 的规律能不能搬到中文页上,这次的数据回答不了。中文页的预处理结论全部来自 macOS 自带识别,它恰好又是三者里对倾斜最不敏感的那一个。倾斜和噪声是程序加的。椒盐 5%、高斯 σ=25 这样的强度在真实扫描里不一定常见。
所有结果都是单次运行。Tesseract 这几组我补跑时和网格逐格对得上。浏览器端那一路只在中文正页上跑了两次且逐字相同,其余条件没有重复。参数也都只取了一组,比如非局部均值强度 15、自适应窗口 31。换一组参数后自适应遇到高斯噪声未必还是全空。
九、适用边界与风险提示
数据只来自两页样本和一台 Apple M4 的 Mac 电脑。Tesseract 是 5.5.3 默认参数,只装英文语言包。macOS 自带识别用的是精确模式。浏览器端识别跑在桌面浏览器上。Tesseract 的中文没测,中文页上的预处理结论都只针对 macOS 自带识别。浏览器端那一路只测了倾斜和一种组合预处理,单项开关没拆。文中所有准确率都是这两页上的字符准确率。它们不代表这几个识别器在别的文档上的表现,也不适合拿来排名。
预处理本身有风险:中值核、闭运算、自适应二值化这几个开关开错一次就可能让整页结果不能用。界面和命令行都不会报错,你只会拿到一份看着像样而实际错了很多的文本。浏览器端识别在歪 5° 时少了约一半内容。同样没有提示。批量处理扫描件时抽几页人工对照一下。别只看程序有没有跑完。跑批量任务之前最稳妥的做法是先拿三五页人工核过的样本把整条流程跑一遍再放开跑全量。--psm 6 只适合单栏页面。多栏页面用它会串行。minAreaRect 的老换算在新版本 OpenCV 上会差 90°。抄代码前先打印原始角度。
十、还没解决的问题
有两件事我只有猜测:1° 比 0° 准确率还高一点(99.5 对 98.9)。缩一半的页面不处理比原尺寸错得还少(4 对 11)。都没验证。估角这边只用了投影法和 minAreaRect,霍夫直线、Tesseract 自带的方向检测、Leptonica 内置的纠斜都没试,--psm 也只比了 3 和 6 两档。多页 PDF、分辨率很低的扫描件、转成带文字层的可搜索 PDF,这几类需求这次也没覆盖。
最想补的是真实的歪扫描件:程序转出来的 5° 页面每一行都严格平行。真扫歪的纸常常一边歪得多一边歪得少,投影法估出来的那一个角度够不够用现在不知道。手写、双栏、手机拍的带透视变形的页面,同样不在这次范围内。
参考资料
- H. G. Wells,《The Time Machine》, William Heinemann, London 1895,第 8 页;扫描来自 University of Illinois(HathiTrust),维基共享资源,公有领域: commons.wikimedia.org/wiki/File:T...
- 英文真值:英文维基文库 Page:The Time Machine (H. G. Wells, William Heinemann, 1895).djvu/20(Validated),转录文本 CC BY-SA 4.0: en.wikisource.org/wiki/Page:T...
- 国家语言文字工作委员会《关于重新发表〈简化字总表〉的说明》及《简化字总表》(1986 年新版),Internet Archive,Public Domain Mark 1.0: archive.org/details/jia...
- 文中倾斜与噪声版本为程序自制。
- Tesseract 5.5.3 关于页面分割模式(--psm)的说明。
- OpenCV 5.0.0 文档:minAreaRect、medianBlur、fastNlMeansDenoising、threshold、adaptiveThreshold。