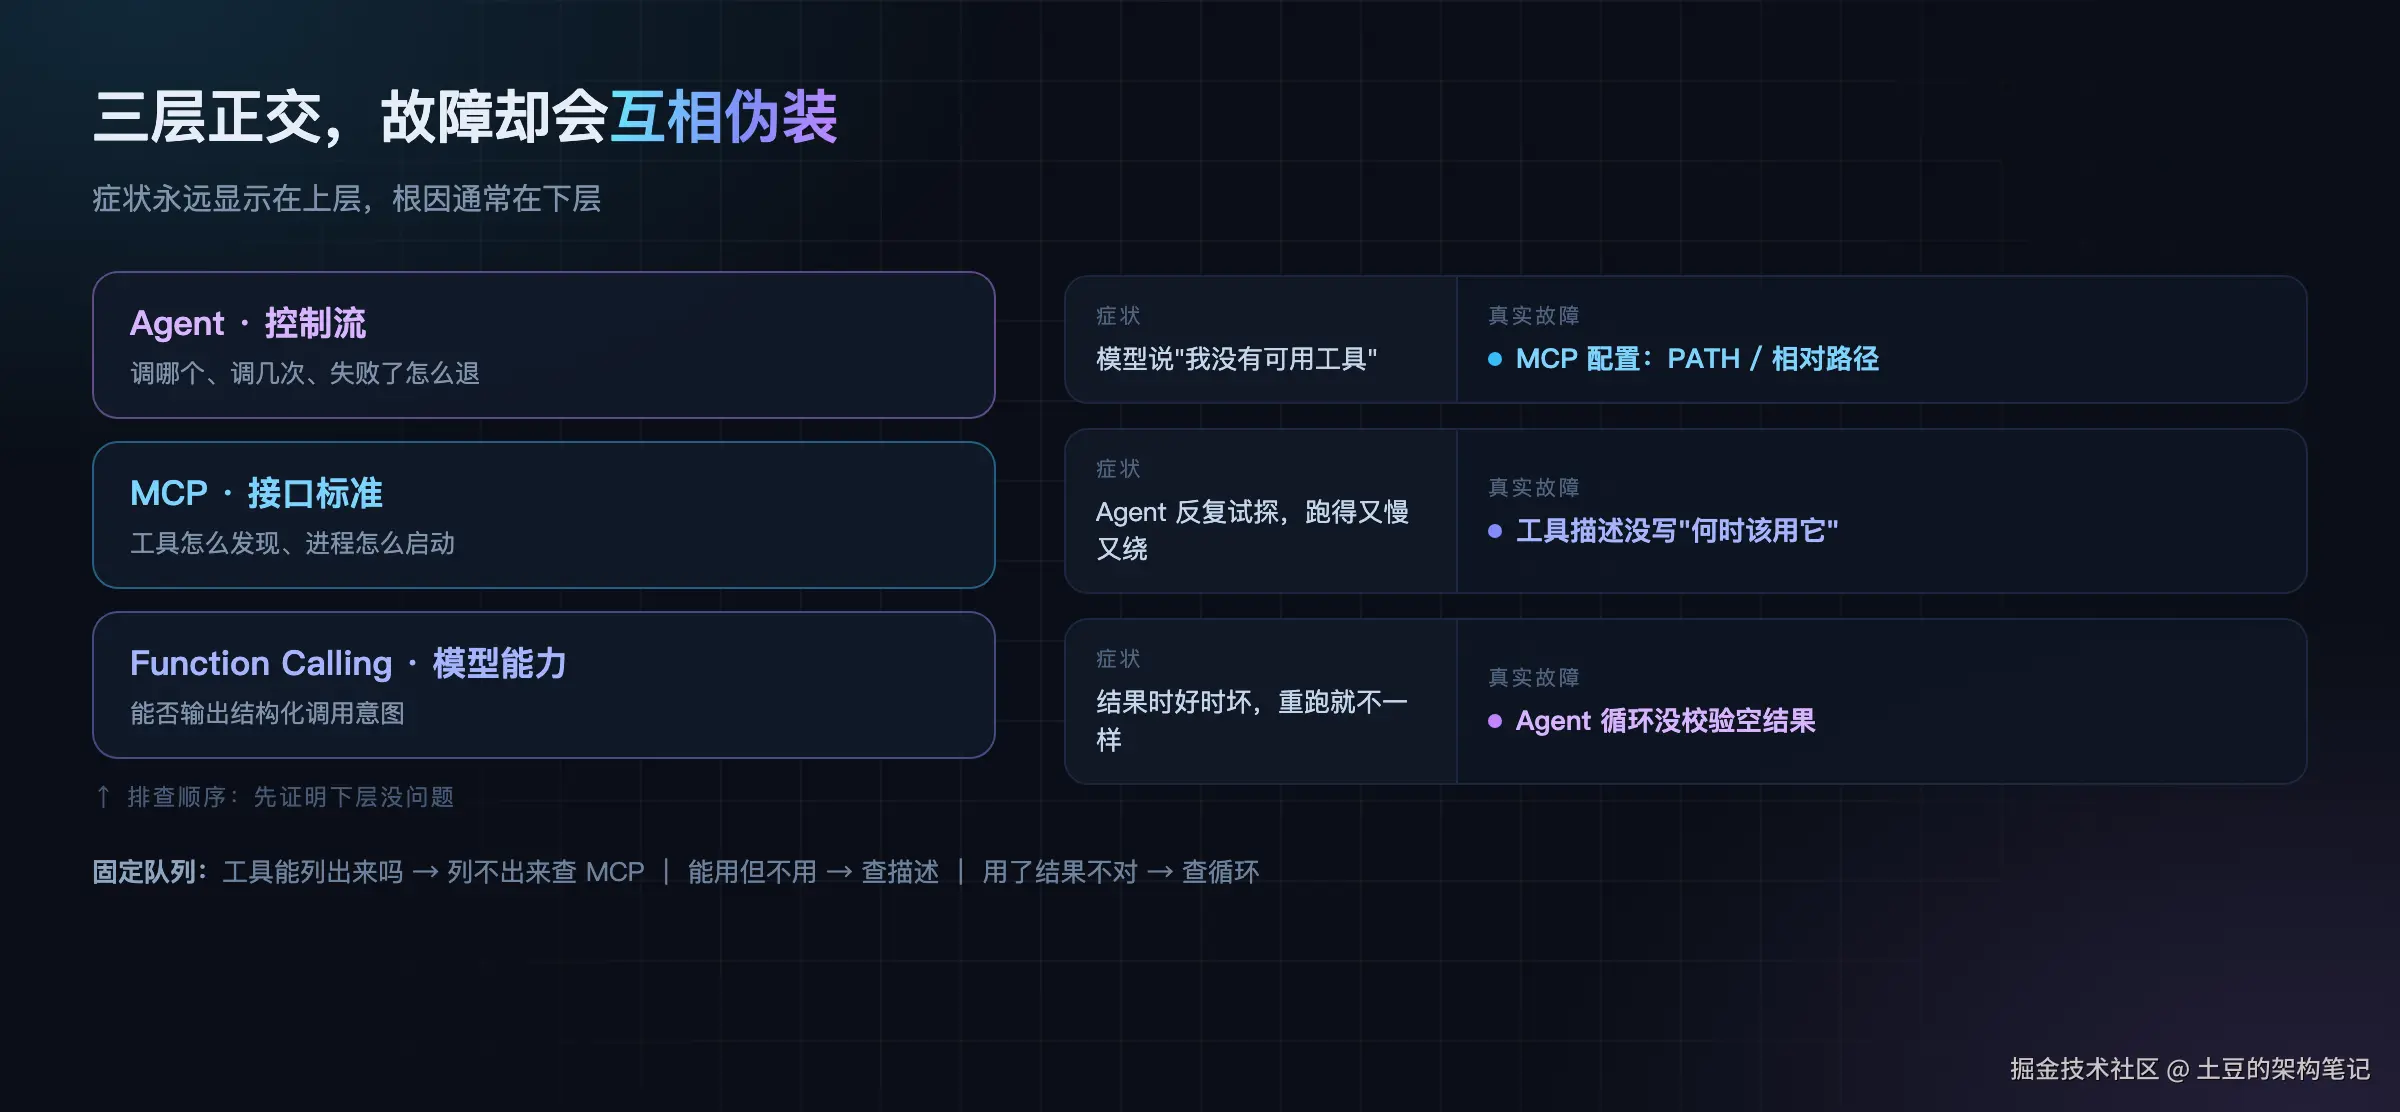
把这三个词混着用,是排查大部分 AI 工具故障时最大的障碍。
现在说"我做了个 Agent"的人,很多其实只是接了个 MCP Server。这两个词被混用得很厉害,但它们解决的根本不是同一层的问题。
混用带来的直接后果不是概念不严谨,而是故障定位错误:明明是配置文件写错了,你去改提示词;明明是编排逻辑有问题,你去换模型。每一层都会伪装成另一层的故障。
这篇文章把三层拆开,说清楚各自解决什么、成本在哪、失败时长什么样,最后给一个能直接用的判断流程。
一、先把三个词拆到不同层上
| 解决什么 | 谁定义 | 失败时的典型表现 | |
|---|---|---|---|
| Function Calling | 模型能不能输出结构化的调用意图 | 模型厂商 | 模型不用工具,或参数格式错 |
| MCP | 工具从哪来、怎么发现、怎么启动 | 协议标准 | 工具列表为空,或进程起不来 |
| Agent | 调哪个、调几次、失败了怎么退 | 你写的代码 | 死循环、重复调用、放弃太早 |
换个说法:
- Function Calling 是模型能力。你给它一个 JSON Schema,它输出一段符合 schema 的 JSON。这是模型本身的行为,跟你用什么协议无关。
- MCP 是接口标准 。它规定工具怎么被发现(
tools/list)、怎么被调用(tools/call)、进程怎么启动(stdio 还是 HTTP)。它不关心模型怎么决策。 - Agent 是控制流。它是一段你的代码:拿模型输出 → 执行 → 把结果喂回去 → 再问模型 → 循环,直到满足退出条件。
这三层是正交的。 你可以有 Function Calling 而没有 MCP(直接写死工具),可以有 MCP 而没有 Agent(单轮调用),也可以有 Agent 而没有 MCP(自己维护工具表)。
举个具体场景把三层串起来。用户问:"这个接口改坏了哪些地方?"
- Function Calling 让模型能输出
{"name": "search_code", "arguments": {"pattern": "xxx"}}这样一段结构化意图 - MCP 负责让
search_code这个工具真的存在、能被发现、进程能被拉起来 - Agent 负责判断"先搜定义、再追调用点、最后查测试覆盖"这个顺序,以及搜不到时换个关键词重试
三层各司其职,缺一层链路就断。但它们的故障表现几乎一样------都表现为"AI 不好用"。
混用它们,就会在错误的层上找 bug。
二、故障会互相伪装,这是最难的地方
这三层出问题时的外部表现高度相似,所以定位时极容易跑偏。三个我实际踩过的例子:
伪装一:MCP 配置错,看起来像"模型不会用工具"
客户端不继承你 shell 的 PATH,你写的 command 是相对路径或者依赖 ~/.local/bin 在环境变量里。进程起不来,tools/list 返回空。
现象:模型说"我没有可用的工具"。
你的第一反应是"模型能力不行"或者"提示词没写清楚"。实际上是配置问题------换三个模型都一样。
判断方法 :手动跑一次 initialize + tools/list,能返回工具清单就说明 MCP 层没问题,故障在客户端配置或更上层。
伪装二:工具描述写错,看起来像"Agent 不智能"
工具描述写得像 API 文档(功能、参数、返回值齐全),但没写"什么时候用它"。模型面对"看一下这段逻辑"这种需求,不知道选哪个工具,转头去 grep 或者读整个文件。
现象:Agent 跑得慢、反复试探、有时候干脆不做。
你的第一反应是"这个模型规划能力不行",于是换模型。换了还是这样。
这不是编排问题,是工具接口设计问题。 模型的选择几乎完全由描述开头一两句决定。
伪装三:Agent 循环写错,看起来像"MCP 不稳定"
工具返回了空结果,你的循环没有区分"空结果"和"调用失败",直接把空字符串喂回模型。模型以为任务完成了,输出一个看起来合理但完全错误的结论。
现象:结果时好时坏,同一份输入跑两次结果不一样。
你的第一反应是"这个 MCP Server 有 bug"或者"模型不稳定"。实际上是你的循环缺少终止条件校验。
这三个例子的共同点:故障出现在 A 层,症状显示在 B 层。
所以排查顺序必须固定:先证明下层没问题,再怀疑上层。
工具清单能导出来吗?        → 不能:MCP / 配置层
能导出来但模型不用?        → 描述 / 接口设计层
用了但结果不对?            → Agent 循环 / 结果校验层
顺序反了,就会在"是不是模型不够聪明"上耗掉一整个下午。
三、每一层的成本结构完全不同
选型时最容易忽略的是成本模型------三层的成本项完全不一样,混着算会做出错误决定。
Function Calling 的成本是 token 和误调用率。 工具定义本身占上下文(我那个 codebase 知识图谱 Server,15 个工具的定义序列化后约 2.4 万字符、7000 多 token),而且这个成本是每一轮都付。工具越多,模型选错的概率越高。
MCP 的成本是进程管理的复杂度。 每个 Server 是一个子进程,启动有延迟(索引加载可能要几十秒),异常退出要重连,多客户端各起一份还得处理端口和单例。这部分成本是一次性的工程成本,换来的是多客户端复用。
Agent 的成本是延迟乘以次数。 一次 Agent 循环至少两次模型调用(决策 + 总结),复杂任务五到十次很常见。每一次都要等,每一轮都可能出错,错误还会累积。
一个具体的账:单步任务用 Agent 跑,延迟是直接调用的 5 倍以上,准确率还更低------因为多了两次模型决策的机会出错。
四、判断流程:什么时候该上哪一层
不用纠结名词,按这个顺序问四个问题:
javascript
① 需要给模型提供外部能力吗?
   └── 不需要 → 结束,别为了"看起来智能"加工具

② 只有 1 个应用、1 个模型厂商?
   ├── 是 → 直接 Function Calling,别上 MCP
   └── 否 → 上 MCP(多客户端复用才值得付出进程管理成本)

③ 任务是固定步骤、路径确定?
   ├── 是 → 写成工作流(固定编排),别上 Agent
   └── 否 → 上 Agent

④ 上了 Agent 之后,步骤数能控制在 5 步以内吗?
   ├── 能 → 继续
   └── 不能 → 拆成子任务,或者退回工作流 + 人工确认
第三条是最容易搞反的。
路径确定的流程不要用 Agent。 我踩过一次:一个固定五步的数据处理流程,每一步的输入输出都是确定的,我为了"更智能"包成了 Agent。结果是延迟翻了七八倍,还出现了两次步骤乱序------因为模型有时候会"优化"流程,跳过它认为不必要的一步。
固定流程用固定代码,Agent 只留给真正需要动态决策的地方。
五、一个判断标准:把不确定性留在哪一层
三层里,不确定性是逐层放大的:
- Function Calling 的不确定性:模型输出的 JSON 可能有偏差 → 用 schema 校验兜住
- MCP 的不确定性:进程可能起不来 → 用启动检查和健康探测兜住
- Agent 的不确定性:路径可能跑偏 → 这个没有便宜的兜底方案
所以架构上的原则是:能在下层解决的不确定性,不要留到上层。
- 工具的可用性用 MCP 的
tools/list验证,不要让 Agent 去"试试看" - 参数的合法性用 schema 校验,不要让 Agent 重试三次才发现格式错了
- 步骤的顺序用代码固定,不要让 Agent 每次重新规划
Agent 应该只负责"选哪条路",不该负责"这条路怎么走"。
把这两件事混在一起,就是大部分 Agent 项目失控的原因。
多 Agent 也是一样的道理。两个 Agent 之间的通信成本------上下文怎么传、状态怎么同步、结论冲突了听谁的------往往超过它带来的收益。
我的经验:一个 Agent 加多个工具,能覆盖绝大多数场景。只有当子任务需要完全不同的上下文、不同的权限、或者不同的模型时,拆成多个 Agent 才划算。为了架构图好看拆 Agent,是典型的过度设计。
六、结论
三层的关系可以这么记:
Function Calling 是"能说",MCP 是"能找到工具",Agent 是"决定怎么用"。
排查时先分层,再定位,最后才改。选型时先问"我需不需要这一层",而不是"这一层现在很火"。
绝大多数 AI 工具项目的复杂度失控,不是因为技术难,而是因为用了超出需要的那一层。