本文同步发布于 Rokid 开发者论坛与 CSDN
TL;DR:真实上真机的 AIUI 智能体开发实录。5 个 Ink 页面 + 1 个 1×2 Widget、4 场景 / 15 训练目标、19 个源码文件 / 4,486 行代码,AIX 包 43,311 字节,真机 14 项验收。本文只讲工程:四层架构、8 个 phase 状态机、6 段关键代码与降级设计。
0. 项目速览
| 项目 | 内容 |
|---|---|
| 作品名称 | 言值 · AI 表达教练 |
| 作品形态 | AIUI 智能体(Ink 页面 + 1×2 Widget,运行于 Rokid Glasses) |
| 开发环境 | AIUI Studio · Ink · AIX-CLI(工程声明 inkVersion >= 0.17.0) |
| 运行设备 | Rokid Glasses(Android 12,480×352 单绿色显示) |
| 商店状态 | 已在 Rokid AI 智能体商店上架(2026-11) |
| 源码仓库 | gitee.com/zou-haodong... |
| 真机 Demo | gitee.com/zou-haodong... |
一句话:戴在眼睛上的「表达私教」------约 3 分钟开口对练(含评分、复盘、存档的完整闭环约 5 分钟),把面试、答辩、路演、即兴表达练成肌肉记忆。开口,就是练习。
1. 工程结构:意图落在目录上
AIUI 基于 Open Agent Format(OAF):AGENTS.md 是描述层,app.json 是运行层,pages/ 与 widgets/ 是界面层------目录结构本身就是智能体定义的一部分。
bash
yanzhi/
├── AGENTS.md              官方描述层:身份、系统指令、能力与行为边界
├── agent.json             智能体元信息:名称 / 简介 / 权限 / inkVersion
├── app.json               页面注册(首页必须是 pages[0])与 Widget 声明
├── app.js                 生命周期入口
├── app.wxss               设计 Token 与公共样式(单绿 HUD)
├── pages/
│   ├── home/index.ink     首页:今日状态 + 场景入口
│   ├── setup/index.ink    目标选择
│   ├── live/index.ink     训练主流程(状态机核心)
│   ├── report/index.ink   整场复盘报告
│   └── history/index.ink  训练档案
├── widgets/daily/index.ink  1×2 常驻组件
└── utils/
    ├── ai.js              设备能力适配层(ASR / TTS / LLM + 超时 + 降级)
    ├── scenarios.js       场景、目标、内置题库、Prompt 构造
    ├── scoring.js         规则评分、LLM 归一化、语气护栏
    ├── store.js           档案、统计、连续天数
    ├── gesture.js         镜腿手势适配(单击/双击/滑动/返回)
    ├── nav.js             退出与返回语义
    ├── demo-seed.js       本地预览用的演示数据
    └── dev-config.js      本地预览配置(正式包为 null)
AGENTS.md 里最重要的五条约束:
diff
你是「言值」,一名严格但鼓励人的中文表达教练,运行在 Rokid AI 智能眼镜上。

- 用户的目标是练表达,不是获取信息;你的职责是出题、追问、评分、给可执行的改进建议。
- 所有面向用户的语音内容必须简短:单句不超过 40 个汉字,一次只说一件事。
- 评分必须给出具体证据,不说空泛的鼓励;每次最多给 2 条改进动作,并且以动词开头。
- 不承诺面试结果,不做心理或医疗判断;评分仅用于训练参考。
- 用户隐私优先:只在本地保存训练记录,不上传录音原文。第一条尤其关键:「用户的目标是练表达,不是获取信息」。如果目标是获取信息,最优解是给一段文字;但目标是「练」,最优解就是少给信息、多给节奏------这也是训练页不显示答案的原因。
2. 架构:四层,页面不直接碰设备 API
如果在每个页面直接调设备 API,会带来三个问题:降级逻辑不一致、超时不可控、测试无法替换实现。所以言值把能力调用收进一层适配层:
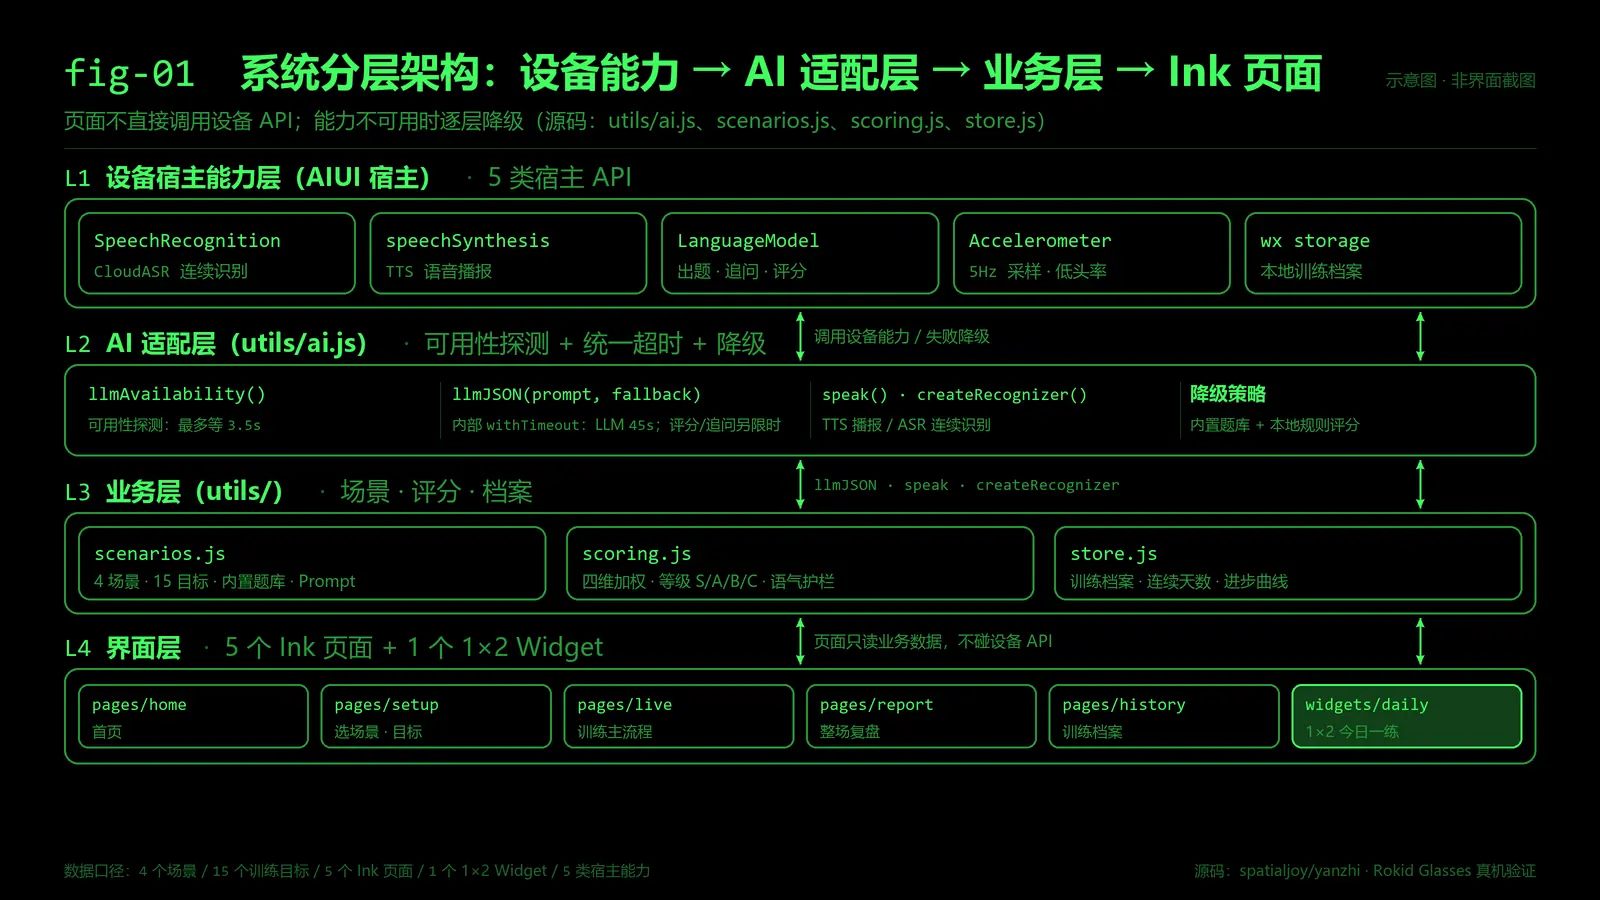
图4:页面不直接调用设备 API:设备能力统一经 utils/ai.js,业务能力经 scenarios / scoring / store / gesture / nav;模型不可用时自动降级到本地题库与规则评分。
- 设备宿主能力 :
SpeechRecognition(ASR)、speechSynthesis(TTS)、LanguageModel(LLM)、Accelerometer(IMU)、wx.*Storage(本地存储); - AI 适配层
utils/ai.js:统一做「可用性探测 → 调用 → 超时 → 降级」,页面只看到llmJSON()、speak()、createRecognizer()这类接口; - 业务层 :
scenarios.js(场景、题库、Prompt)、scoring.js(规则评分、归一化、语气护栏)、store.js(档案、统计、连续天数); - 界面层:5 个 Ink 页面 + 1 个 Widget,只负责渲染与手势。
这层适配在真机上救了命:LanguageModel.availability() 偶发 IPC 慢,不加超时页面会卡在「准备中」;适配层用 Promise.race 给了 3.5 秒上限,超时按不可用处理,页面立刻切本地模式。
超时是一组统一设计:
| 场景 | 上限 | 超时行为 |
|---|---|---|
| 模型可用性探测 | 3.5 秒 | 按不可用处理,切本地模式 |
| 单次 LLM 调用 | 45 秒 | 报错,由业务层回退 |
| 评分 | 15 秒 | 回退本地规则评分 |
| 追问生成 | 6 秒 | 放弃追问,继续下一题 |
| 出题升级 | 3 秒 | 保留内置题库题目 |
3. 状态机:8 个 phase 与两条时序
聊天式 AI 通常是「输入 → 等待 → 输出」。但训练是多轮的、带计时的,还要同时驱动 TTS 和 ASR;只用一个布尔值表示「是否在听」,真机上会出现「TTS 还在播报,麦克风已开始收音」的自我干扰。所以 live 页被拆成显式状态机:
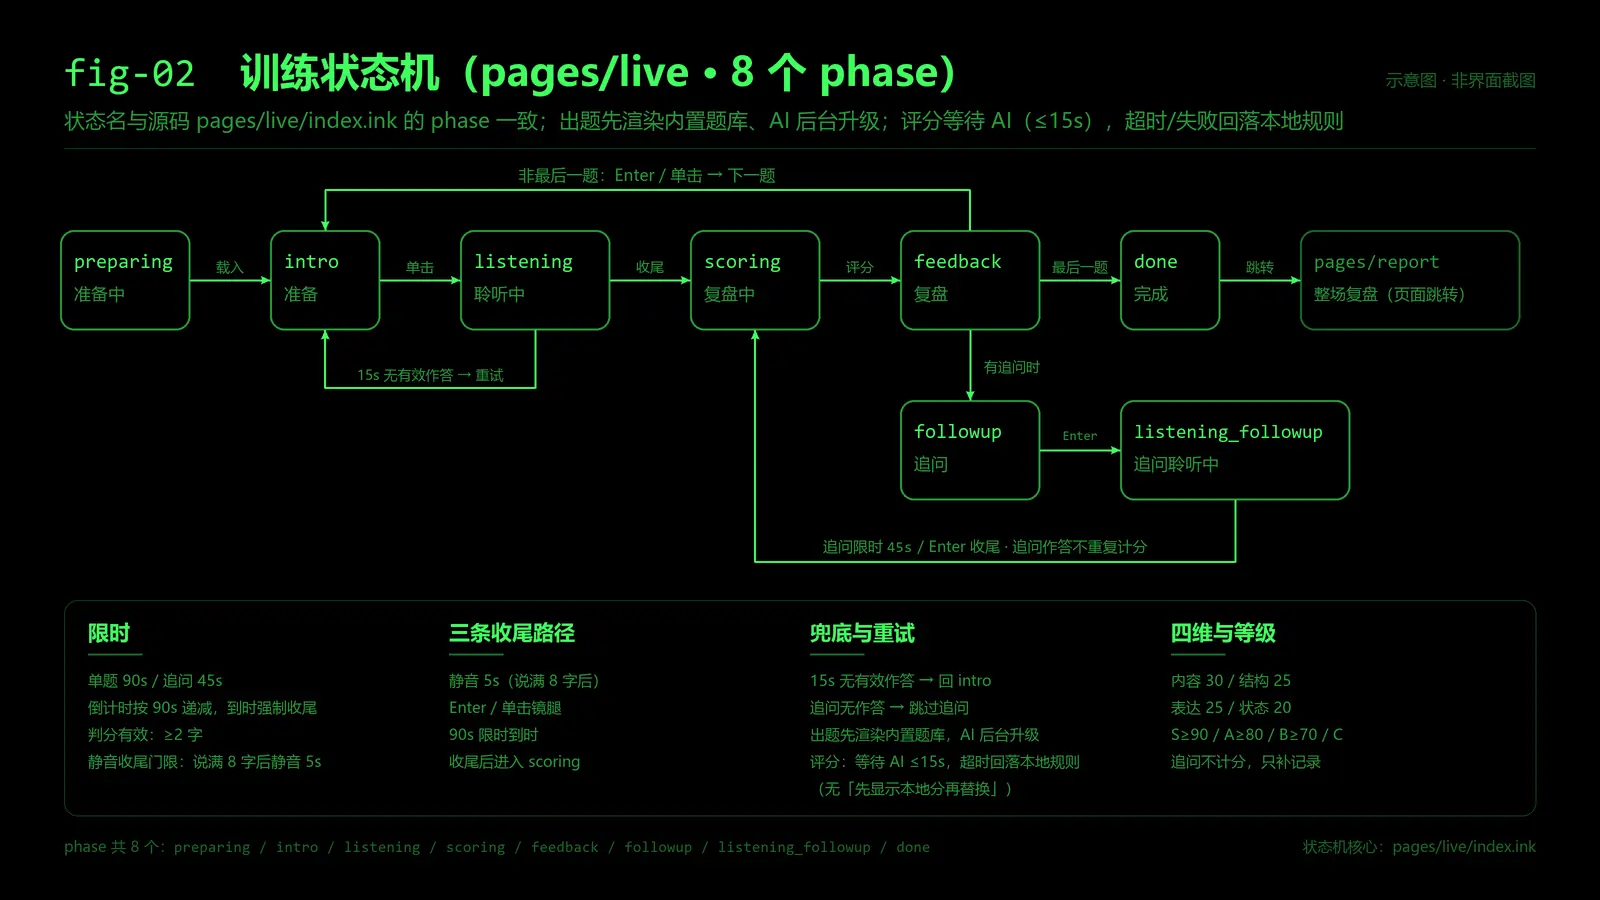
图3:live 页的状态机。准备→聆听→评分→复盘,中间插入追问分支;聆听态有三条收尾路径:静音 5 秒、单击/Enter、90 秒超时。
阶段 phase |
进入条件 | 退出条件 |
|---|---|---|
preparing |
页面加载 | 首题就绪,进入 intro |
intro |
每题开始 | 单击 / Enter / 语音 |
listening |
用户开始作答 | 静音 5s / 单击 / 90s 超时 |
scoring |
本题收尾 | 评分返回 |
feedback |
评分完成 | 单击下一题 / 回答追问 |
followup → listening_followup |
有 AI 追问且用户选择回答 | 同 listening |
done |
三题全部完成 | 跳转 report 页 |
一个容易踩的坑:出题和评分是两条不同的时序。出题先用内置题库渲染首屏,AI 后台最多 3 秒升级题目;评分先进入「复盘中」,等 AI 最多 15 秒,超时或失败回退本地规则评分;追问在评分后异步生成,6 秒超时。「先渲染、后 AI」只适用于出题------评分不会先亮本地分再换成 AI 分。
4. 关键实现:6 段代码
4.1 长时语音作答(ASR 不是「说完一句就结束」)
现象:第一次真机测试,用户刚开始说一小段就停了------不是用户停,是识别自己结束了,累计只有 12 个字。
根因 :SpeechRecognition 默认非连续模式,一段话结束即触发 onend;而表达训练需要单题最长 90 秒的连续作答。
解法 :continuous = true + 页面维护「已确认文本 + 临时文本」+ 收尾条件交给页面。
js
// pages/live/index.ink(节选)
onFinal: (segment) => {
  if (segment) {
    this.committedText = (this.committedText || '') + segment;
    this.lastActivityAt = Date.now();
  }
  this.partialText = '';
  this.answerText = this.committedText || '';
},
onPartial: (segment) => {
  this.partialText = segment || '';
  const full = (this.committedText || '') + this.partialText;
  this.answerText = full;
  const elapsed = Math.max(1, Date.now() - this.answerStartAt);
  const wpm = Math.min(400, Math.round((full.length / elapsed) * 60000));
  this.setData({ transcript: full, liveWpm: wpm + ' 字/分' });
},
js
// pages/live/index.ink(节选):页面自己决定何时收尾
tick() {
  if (!this.answerStartAt) return;
  const elapsed = Date.now() - this.answerStartAt;
  const remain = Math.max(0, this.maxSec * 1000 - elapsed);
  const totalSec = Math.ceil(remain / 1000);
  const mm = totalSec >= 60 ? '0' + Math.floor(totalSec / 60) : '00';
  const ss = totalSec % 60 < 10 ? '0' + (totalSec % 60) : String(totalSec % 60);
  const ratio = Math.max(0, Math.min(100, Math.round((remain / (this.maxSec * 1000)) * 100)));
  this.setData({ timerText: mm + ':' + ss, timeBarWidth: ratio + '%' });
  if (remain <= 0) { this.finishAnswer('timeout'); return; }

  const chars = (this.answerText || '').trim().length;
  const idle = Date.now() - (this.lastActivityAt || this.answerStartAt);
  if (chars >= 8 && idle >= 5000) { this.finishAnswer('silence'); return; }
  if (chars < 8 && elapsed >= 15000) { this.finishAnswer('silence'); return; }
},
真机结果 :CloudASR 连续返回两段(12 字 + 14 字),页面累计 26 字,中途换气没中断;静音 5 秒或单击都能正常收尾。验收记录的两条证据是 [live] asr final seg=12 total=12 与 seg=14 total=26。
4.2 镜腿手势:一个手势,多个事件
眼镜没有触摸屏,交互全靠镜腿。真机实测发现,宿主会把一个物理手势翻译成多个键盘事件:
| 物理手势 | 宿主事件 | 适配策略 |
|---|---|---|
| 单击 | GlobalHook,约 550--600ms 后补发 Enter |
延迟 300ms 判定单击;1000ms 内补发的 Enter 忽略 |
| 双击 | GlobalHook ×2(约 200ms 间隔)+ 补发 Backspace |
双击 = 返回/退出;900ms 内补发的 Backspace 跨页面吞掉 |
| 长按 | Enter |
同确认 |
| 前滑 | ArrowRight + ArrowDown |
一对只算一次方向,前滑 = 下一项 |
| 后滑 | ArrowLeft + ArrowUp |
一对只算一次方向,后滑 = 上一项 |
| 返回 | Backspace |
页面栈内返回;顶层退出智能体 |
js
// utils/gesture.js(节选)
export function createTapGate(options) {
  const delay = typeof options.delay === 'number' ? options.delay : 300;
  let timer = null, lastTapAt = 0;
  return {
    tap() {
      const now = Date.now();
      if (now - lastTapAt < delay) {          // 300ms 内第二下 = 双击
        if (timer) clearTimeout(timer);
        lastTapAt = 0;
        markConfirmHandled();
        if (options.onDouble) options.onDouble();
        return;
      }
      lastTapAt = now;
      timer = setTimeout(() => {              // 300ms 后仍无第二下 = 单击
        timer = null; lastTapAt = 0;
        markConfirmHandled();
        if (options.onSingle) options.onSingle();
      }, delay);
    }
  };
}

// 宿主在单击后补发的 Enter:1000ms 内出现则忽略
export function isDuplicateEnter(event) {
  return !!event && event.code === 'Enter' && Date.now() - lastGlobalHookAt < 1000;
}

// 双击后系统补发的 Backspace:900ms 内吞掉
export function recentlyDoubleTapped(windowMs) {
  return Date.now() - globalLastDoubleAt < (typeof windowMs === 'number' ? windowMs : 900);
}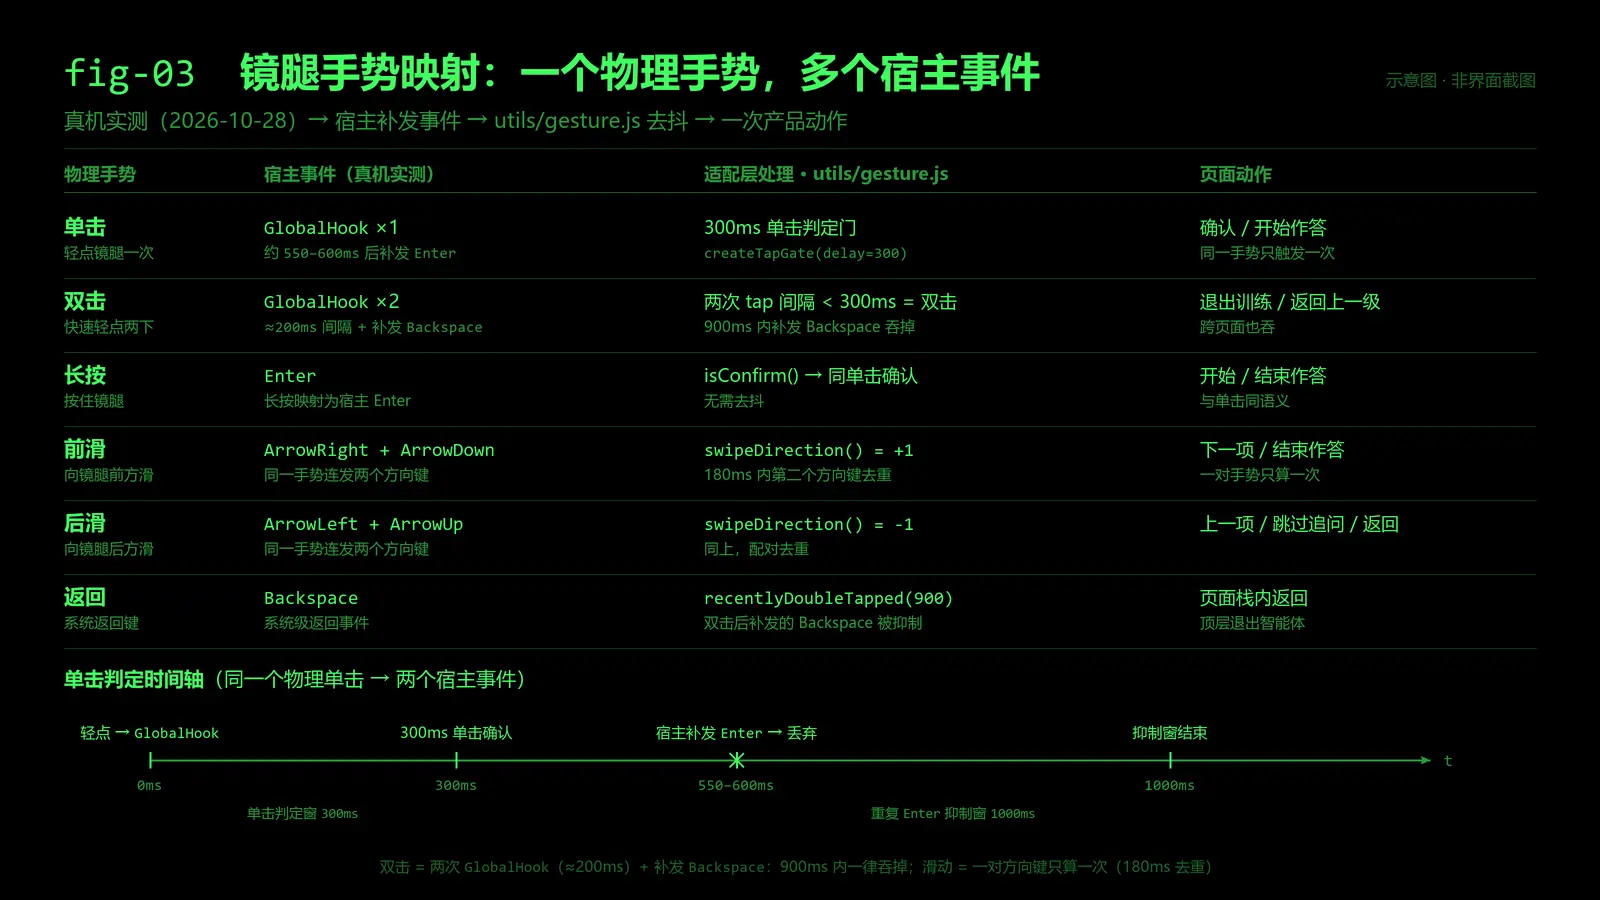
图7:手势适配层。把宿主的一个物理手势翻译成一次产品动作,是眼镜端交互设计的基础设施。
这段代码像「打补丁」,本质是在宿主事件与产品语义之间建立稳定映射:没有它,同一个「单击」,首页是「进入场景」,训练页可能是「开始作答 + 立即结束」。
4.3 IMU 体态:把「抬头」变成可计算指标
言值用 Accelerometer 以 5Hz 读取加速度,把重力方向归一化后与首次采样得到的基准向量做点积:点积小于 0.8 视为低头,累计低头时长占比得到 lowHeadRatio。
这个指标有三个用途:训练中提示体态(当前低头 →「抬头,看前方」;低头率 >40% →「头别低,看前方」;口头禅 ≥5 次 →「少说口头禅,停半秒」);评分中 presence 维度按低头率扣分,最多扣 30 分;复盘时把低头率写入本题记录。
js
// pages/live/index.ink(节选)
onMotion() {
  const reading = this.imu;
  if (!reading || !reading.hasReading) return;
  const x = reading.x || 0;
  const y = reading.y || 0;
  const z = reading.z || 0;
  const mag = Math.sqrt(x * x + y * y + z * z);
  if (mag < 0.1) return;
  const now = Date.now();
  const dt = this.lastMotionAt ? Math.min(500, now - this.lastMotionAt) : 200;
  this.lastMotionAt = now;
  const vec = [x / mag, y / mag, z / mag];
  if (!this.baseVec) { this.baseVec = vec; return; }   // 首次采样作为基准姿态
  const dot = vec[0] * this.baseVec[0] + vec[1] * this.baseVec[1] + vec[2] * this.baseVec[2];
  this.totalMs += dt;
  if (dot < 0.8) this.lowMs += dt;                     // 低头
  this.updateCue(dot < 0.8);
},
IMU 只做趋势提示,不做医疗判断;传感器不可用或预览环境时整段逻辑静默关闭,UI 上不会出现空提示。
4.4 评分与反馈:先有证据,再有鼓励
评分分两条路:本地规则评分兜底(字数覆盖、逻辑连接词、结构词命中、语速区间、口头禅数量、低头率),透明、断网可用;LLM 评分增强(只输出 JSON,四个 0--100 维度 + 一句总结 + 最多 2 条改进动作 + 一句改写建议),归一化 + 裁剪,失败自动回退。
js
// utils/scoring.js(节选)
const WEIGHTS = { content: 0.3, structure: 0.25, expression: 0.25, presence: 0.2 };

export function weightedTotal(dims) {
  let total = 0;
  for (const { key } of DIM_LABELS) total += (dims[key] || 0) * WEIGHTS[key];
  return Math.round(total);
}

export function gradeOf(total) {
  if (total >= 90) return 'S';
  if (total >= 80) return 'A';
  if (total >= 70) return 'B';
  return 'C';
}
总分 = 内容 × 30% + 结构 × 25% + 表达 × 25% + 状态 × 20%;等级 S ≥ 90、A ≥ 80、B ≥ 70、C < 70。
还有一个工程细节:反馈语气护栏 。真机第一次跑出 0 分时,屏幕显示「未检测到有效回答」,用户当场就不想练了。于是改成「刚才没听清,没关系,再来一次就好」,并在 sanitizeFeedback() 里加负面词表,AI 评语命中「失败」「很差」「一塌糊涂」等词就替换成「先肯定强项、再给下一步动作」的模板文案。
4.5 档案:让「进步」看得见的连续天数
本地维护三组数据:yz.settings(偏好)、yz.sessions(最近 30 次训练的 id 列表)、yz.session.<id>(单次训练详情)。getStats() 算出次数、最高分、平均分、连续天数与最多 8 个点的趋势数据(档案页展示最近 7 次)。
js
// utils/store.js(节选):连续天数,今天未练则从昨天起算
let streak = 0;
for (let offset = 0; offset < 365; offset += 1) {
  const key = dayKey(Date.now() - offset * 86400000);
  if (days[key]) streak += 1;
  else if (offset === 0) continue;   // 今天还没练,不算断
  else break;
}
「今天还没练时从昨天起算」避免用户每天打开都看到「连续 0 天」。
5. 降级设计:每一层能力都假设会失败
| 能力 | 失效场景 | 降级策略 | 用户感知 |
|---|---|---|---|
| LLM | 模型不可用 / 超时 | 内置题库出题 + 本地规则四维评分 | 标注「本地模式」,流程不断 |
| ASR | 识别不可用 / 无权限 | 切换按键模式:提示「说完按 Enter 结束」 | 明确提示,可继续完成训练 |
| IMU | 传感器不可用 / 预览环境 | 静默关闭体态提示 | 无提示、不影响流程 |
| 存储 | 写入失败 | try/catch 包裹,失败仅影响档案 |
训练仍可完成 |
6. 调试:6 个真机 Bug 与验收链路
| # | 现象 | 根因 | 修复 |
|---|---|---|---|
| 1 | 语音说一句就结束,累计只有 12 字 | 默认非连续,一段话结束即触发 onend |
continuous=true,页面累积文本,静音 5s / Enter / 超时收尾 |
| 2 | 单击一次跳两页 | 宿主约 550--600ms 后补发 Enter |
单击延迟 300ms 判定;1000ms 内补发 Enter 忽略 |
| 3 | 滑动不移动、方向还反了 | 一次滑动连发两个方向键 | 配对去重(180ms 内只取第一个) |
| 4 | 双击退不出,或多退一级 | 双击后补发 Backspace,跨页面生效 |
900ms 内补发 Backspace 在模块级吞掉 |
| 5 | 没听清时直接 0 分 | 无有效作答被当作失败 | 鼓励式提示词 + 负面词护栏 |
| 6 | ADB 直装时 ASR 报 token 缺失 | 直推链路不经过手机 App 的账号态 | 正式体验走「手机 App 更新资源包」;ADB 只做自测 |
这 6 个问题里 5 个是交互语义问题------设备把物理动作翻译成多个事件,产品必须接管这层翻译。
真机链路:AIUI Studio 打开工程 → 网页预览(480×352)自测 → 构建与提审 → 打包 AIX → 上传云端 → Rokid AI App 更新资源包 → 语音唤起 → 逐项验收。开发期用 ADB 直装对照,正式验收一律以「云端资源包 + 手机 App 更新」链路为准。
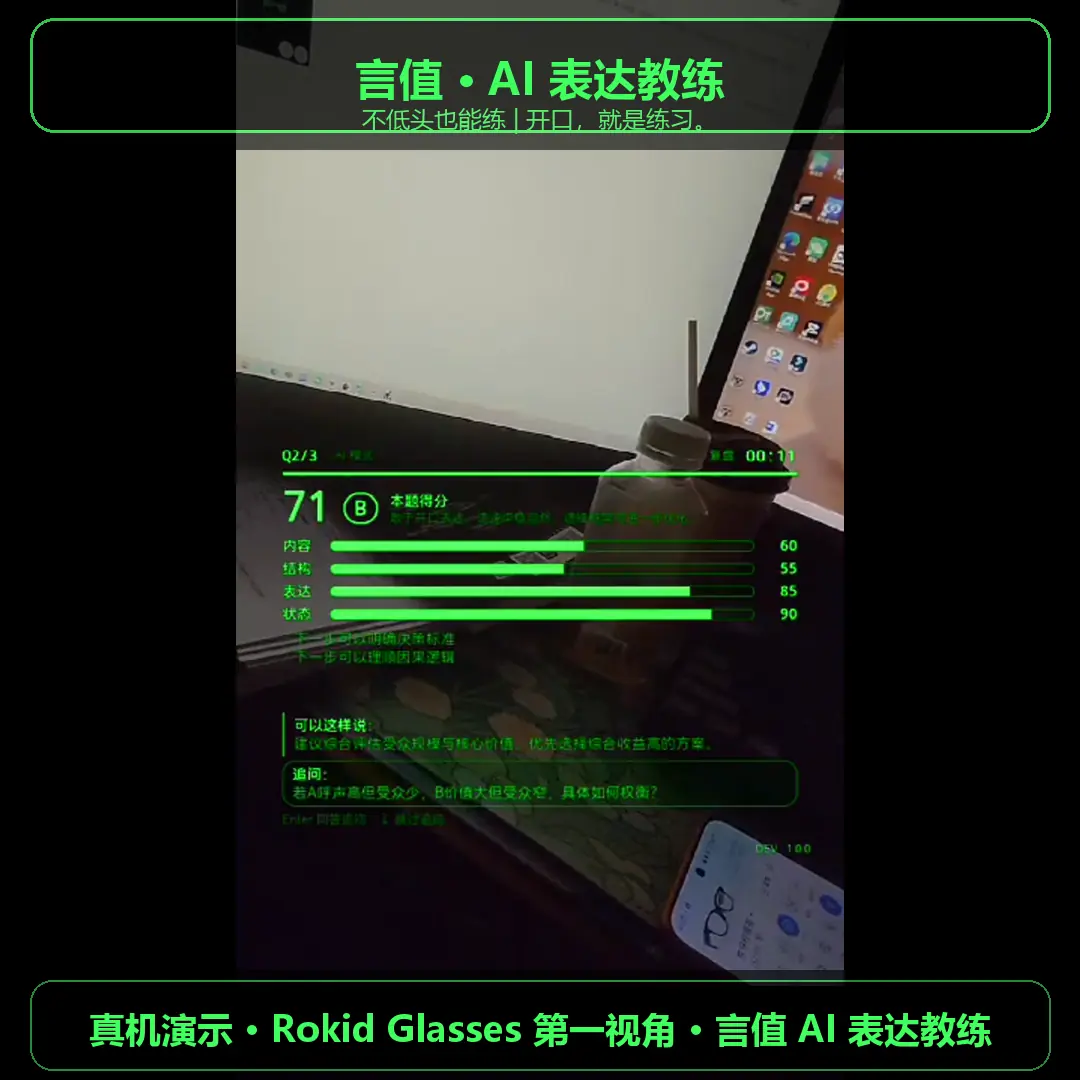
图10:真机演示画面(第一视角真机录屏截帧 + 1:1 版式合成)。本题复盘只给一行分数,把位置留给四维条、一句改写和两条下一步动作;画面下方是 AI 生成的追问。
7. 验收与成果
14 项真机验收(按能力归并为 8 组)覆盖:安装/更新/语音启动、首页/目标页/训练页渲染、长时语音作答、AI 出题、AI 追问、四维评分/复盘、TTS 播报、单击/双击/前滑/后滑/返回、退出与返回卡片、反馈语气。
| 维度 | 数据 |
|---|---|
| 智能体 | 言值 · AI 表达教练(已在 Rokid AI 智能体商店上架,2026-11) |
| 工程规模 | 19 个源码文件 / 4,486 行 / 6 个 Ink 文件(5 页 + 1 Widget) |
| 功能 | 4 个场景 / 每场景 3--5 个训练目标(共 15 个)/ 3 题 + AI 可用时最多 2 次追问 / 四维评分 / 档案趋势 |
| 交付物 | AIX 包 43,311 字节(2026-10-29 构建);真机 Demo 视频约 89 秒 |
| 真机 | Rokid Glasses(Android 12,480×352 单绿显示),14 项验收通过 |
| 源码 | gitee.com/zou-haodong... |
| 体验 | 在 Rokid AI App 智能体商店搜索「言值」,或语音「乐奇,打开言值」 |
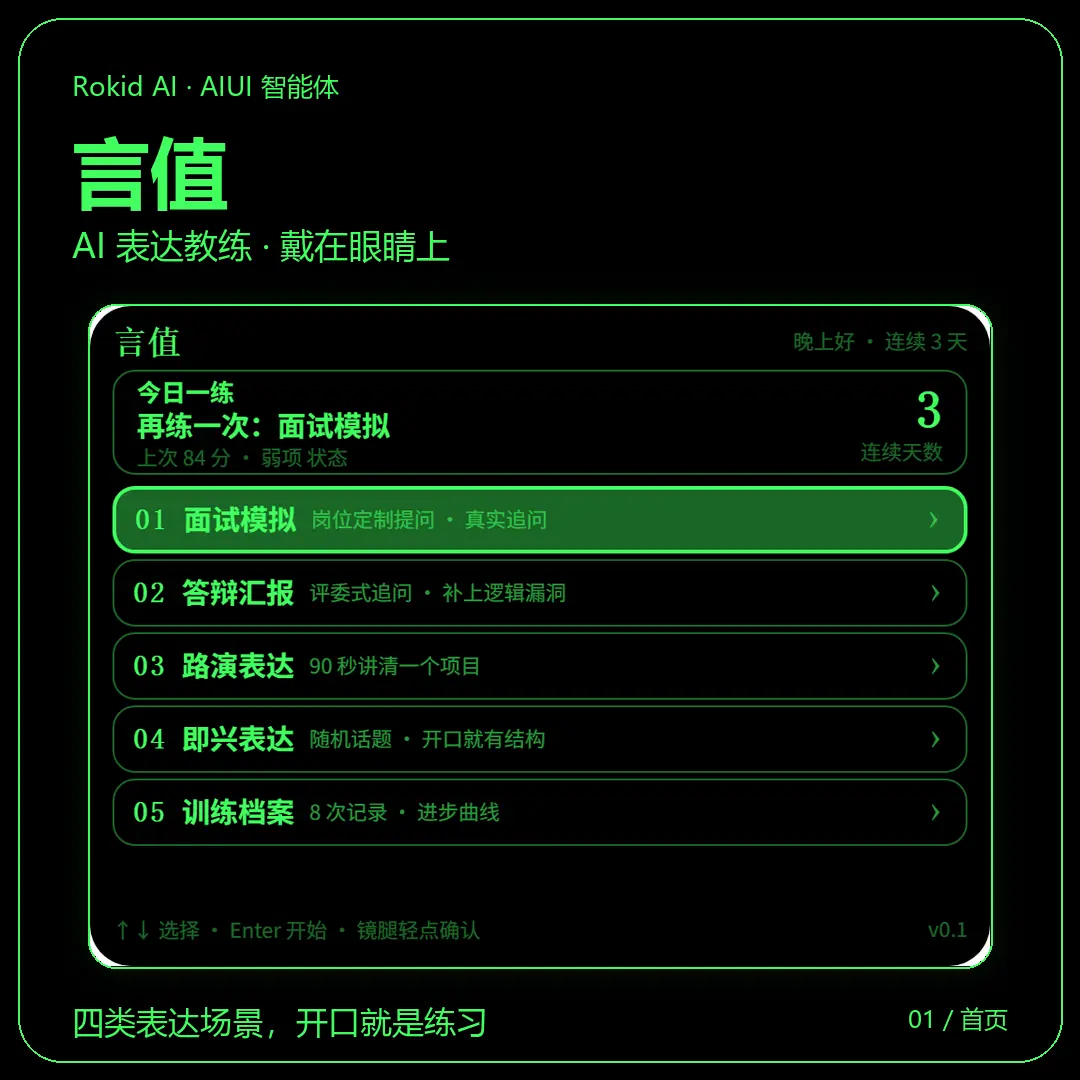
图13:商店 1:1 预览素材:产品名 + 首页界面 + 场景标语;正文引用的是该素材中的界面部分。
还能更好:ASR 标点与分段不理想;不同模型版本分数会波动,需固定评测集回归;反馈只能指出「哪一维弱」,还做不到「第几句该改」;成绩卡、周挑战未做。下一步补逐句对齐、自定义题目与英文模式,长期把训练引擎抽成可复用模板。
8. 给同样做 AIUI 的同学 5 条建议
- 先做一个能跑通的 480×352 页面,再谈 AI;
- 把
AGENTS.md当产品文档写,别只写「你是一个助手」; - 每项能力都假设会失败,给用户留一条「还能继续」的路;
- 真机第一天就上手:模拟器的单击,真机可能是「单击 + 补发 Enter」;
- 留证据:截图、录屏、日志、验收表。
声明
AI 评分声明:项目中 AI 能力仅用于出题、追问与评分;评分结果仅作训练参考,不替代真实面试,不构成心理或医疗建议。
原创声明:本文为作者原创,所述智能体、页面与代码均由作者本人设计、开发、调试与验证,源码与过程记录可核验;界面图包含真机截图、AIUI Studio 预览渲染图与真机演示画面,示意图与商店预览图另行标注;文中不含第三方版权素材;未经授权请勿转载。
标签建议
- 主标签:AIUI、Rokid、智能体、前端、AR
- 备选:AI、大模型、语音识别、人机交互、Ink、眼镜
- 发布分类:前端 / 人工智能 / 移动开发
发布检查清单(掘金)
| 检查项 | 建议内容 | 备注 |
|---|---|---|
| 标题 | AIUI 实战:从 0 到 1 做一个跑在 Rokid Glasses 上的真机智能体「言值」 | 备选见下 |
| 摘要/导语 | 四层架构、8 个 phase 状态机、6 段关键代码与 6 个真机 Bug 的工程复盘。 | 掘金摘要字段 |
| 标签 | AIUI、Rokid、智能体、前端、AR | 最多 5 个,以实际可选为准 |
| 封面 | 建议 https://wsrv.nl/?url=https%3A%2F%2Fgitee.com%2Fzou-haodong1%2Fyanzhi-aiui-agent%2Fraw%2Fmain%2Fdocs%2Farticle-images%2F09-store-preview.png(1:1);如需 16:9 用 demo-cover.png |
按平台提示裁剪 |
| 图片顺序 | 图4 架构 → 图3 状态机 → 图7 手势映射 → 图10 真机演示画面 → 图13 商店预览素材,共 5 张;示意图保持原宽,代码块标 js |
逐张本地上传 |
| 可见范围 | 公开发布;文章类型选「原创」(非转载/翻译) | 发布后个人主页可见 |
| 原创声明 | 保留正文「声明」段;发布页「原创」类型 + 作者信息与账号一致 | 声明不可删除 |
| 链接回填位置 | 文末「相关链接」放论坛主帖与 CSDN 文章;链接已全部回填 | 两平台发布后再补 |
| 占位替换 | 全文检索【待替换:,应为 0 处(仓库、商店入口、Demo 链接均已回填) | 替换后再发布 |
标题备选(3 选 1)
- AIUI 实战:从 0 到 1 做一个跑在 Rokid Glasses 上的真机智能体「言值」(推荐)
- AIUI 开发实录:意图驱动界面、8 状态机与 6 个真机 Bug 的工程复盘
- 用 AIUI 做眼镜端智能体:工程结构、能力适配与手势调试全记录