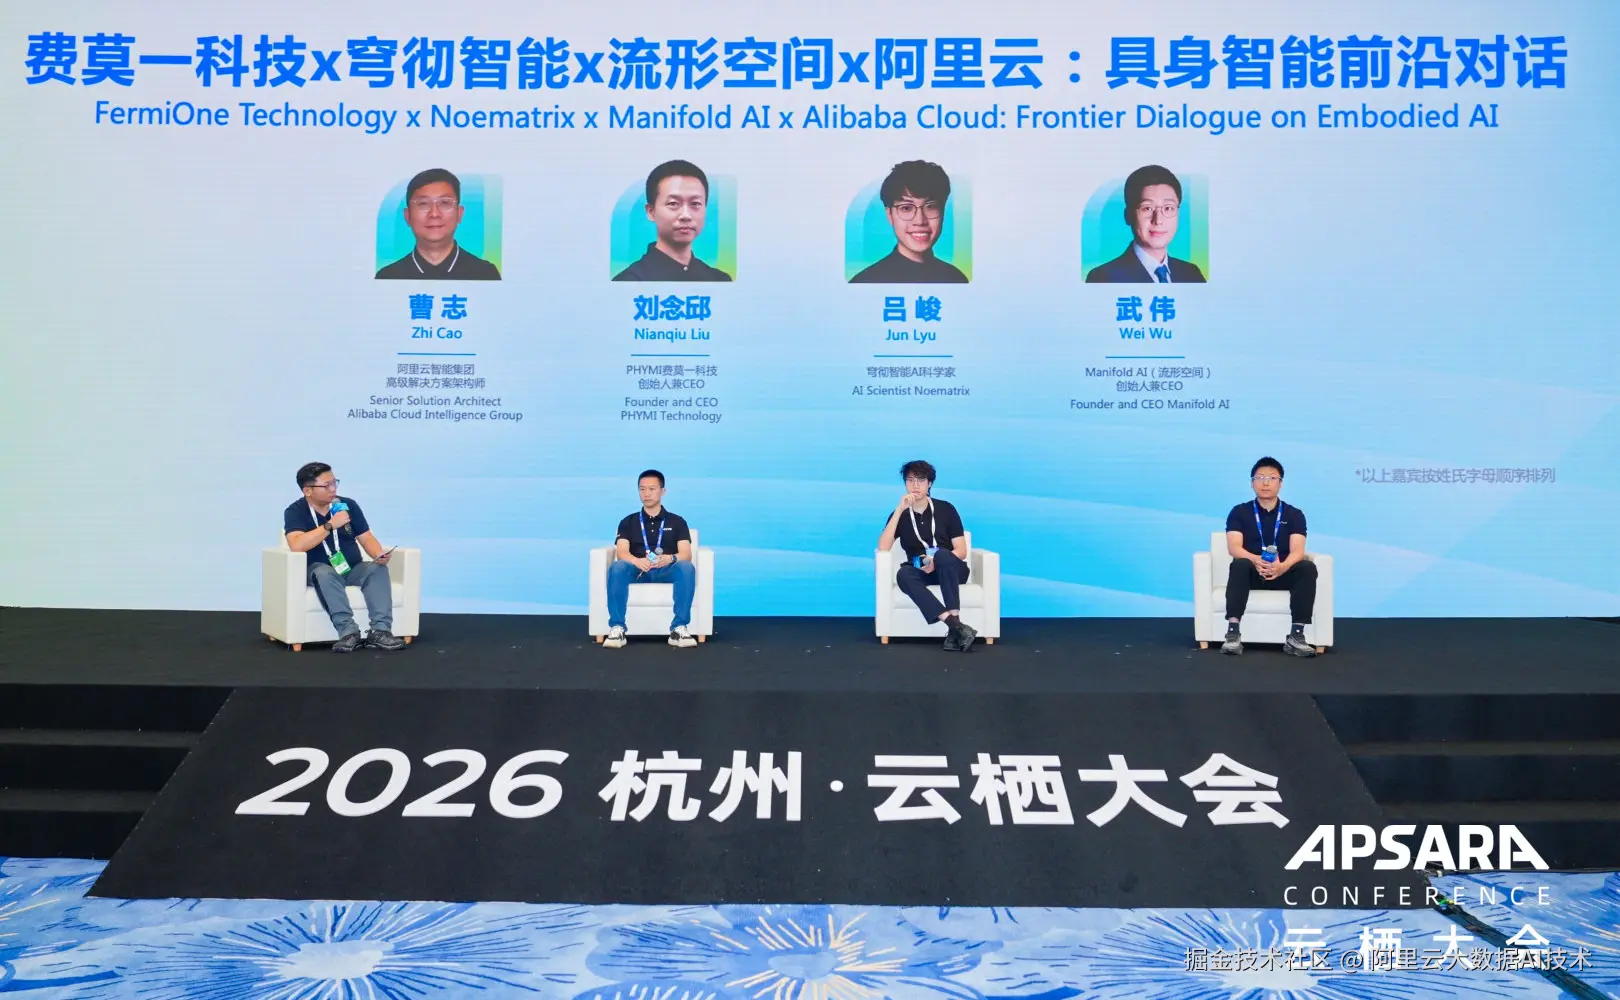
如今,具身智能是 AI 领域最活跃的方向之一,上百家公司入场,上百套数据方案并行,VLA、世界模型等多条模型路线并存。在 2026 云栖大会人工智能平台 PAI 论坛的"具身智能前沿对话"圆桌上,费莫一科技(PHYMI)创始人兼 CEO 刘念邱、穹彻智能 AI 科学家吕峻、流形空间(Manifold AI)创始人兼 CEO 武伟三位行业专家进行了深度探讨。
三家的技术选型各不相同,判断却相近:具身智能仍在"加速发散"、远未收敛;决定成败的不是某个单点算法,而是能否搭起一套让数据、模型、反馈持续自我进化的闭环系统。
如果用一个词形容 2026 年的具身智能?
刘念邱 :真实的应用。就像自动驾驶真正被装到消费者的车上、用起来才高速增长,具身也一样------机器人要尽快进入真实场景、和真实用户交互,拿到真实反馈,再持续优化硬件、数据闭环和模型。
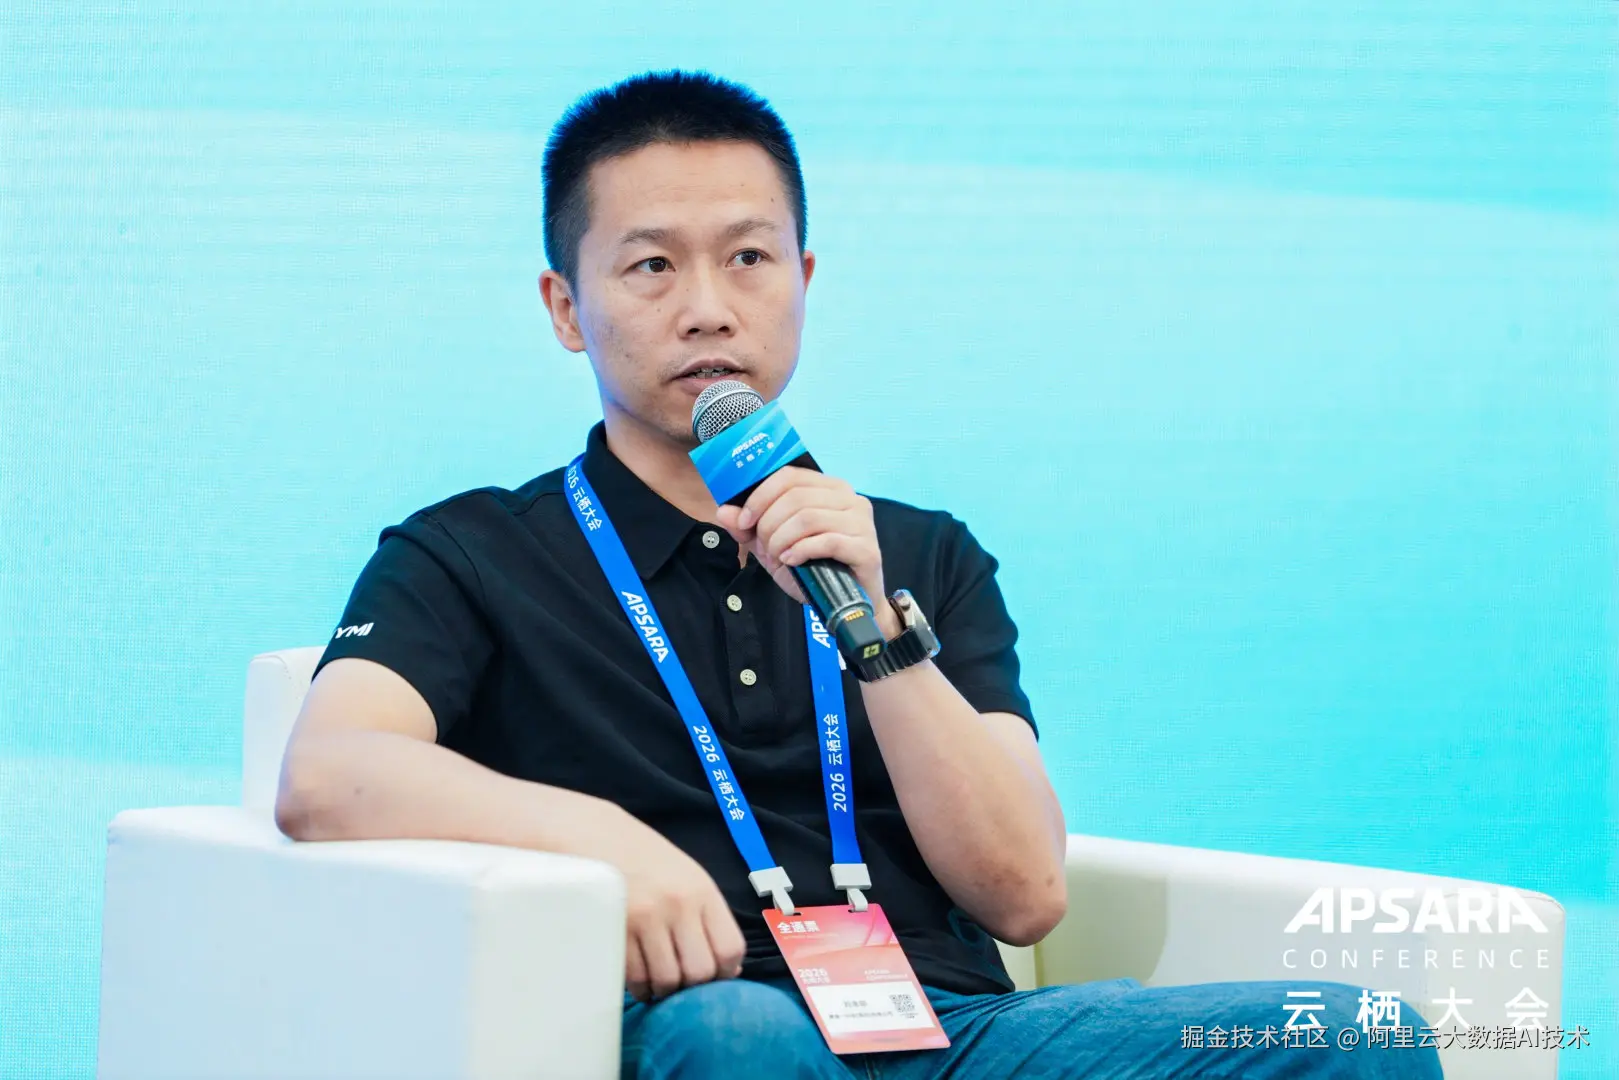
费莫一科技(PHYMI)创始人兼 CEO,刘念邱
吕峻 :变化。2026 年很难用一个词概括:年初还在争论无本体、遥操等数据采集路线,今年又有 VLA 与世界模型之争,最近一个月基模有新进展,又冒出更多关于技术路线的探讨------热点一直在变。
武伟 :发散 ,而且是"加速发散"。模型架构上 code-as-policy、VLA、world model、skills 并存;数据上从真机遥操到 UMI、egocentric,再到 pair-wise 的 in-context learning;应用上还在等模型的 scaling。收敛可能还需要一段时间。
关于数据来源,工业规模的人类遥操作、仿真加强化学习,以及生成式世界模型,哪条路更值得投入?
武伟 :考虑数据一定要先考虑终局------能不能覆盖几乎所有的人类动作,所以 egocentric 数据必不可少。我对仿真很谨慎:现有仿真器不是模型驱动的、参数量极少,相当于一些小模型,训不动今天几十亿参数的具身模型。世界模型合成数据的反事实生成能力不强,这对训练是致命的,所以我宁愿直接去采物理真实的 corner case、长尾 case;世界模型更适合当推理侧的 foundation model,而不是数据合成器。"
吕峻 :采什么数据,就得什么模型。终局是要在真实环境里应对任意任务、任意物体、任意场景,所以数据必须来自真实世界。穹彻坚持无本体数采、核心押注 UMI------在早期阶段,找一个没有严重短板的方案把链路跑通更重要。至于世界模型合成数据,我们试过,成本上没有任何优势,成功率也低,基本是"抽三得一、抽四得一"。
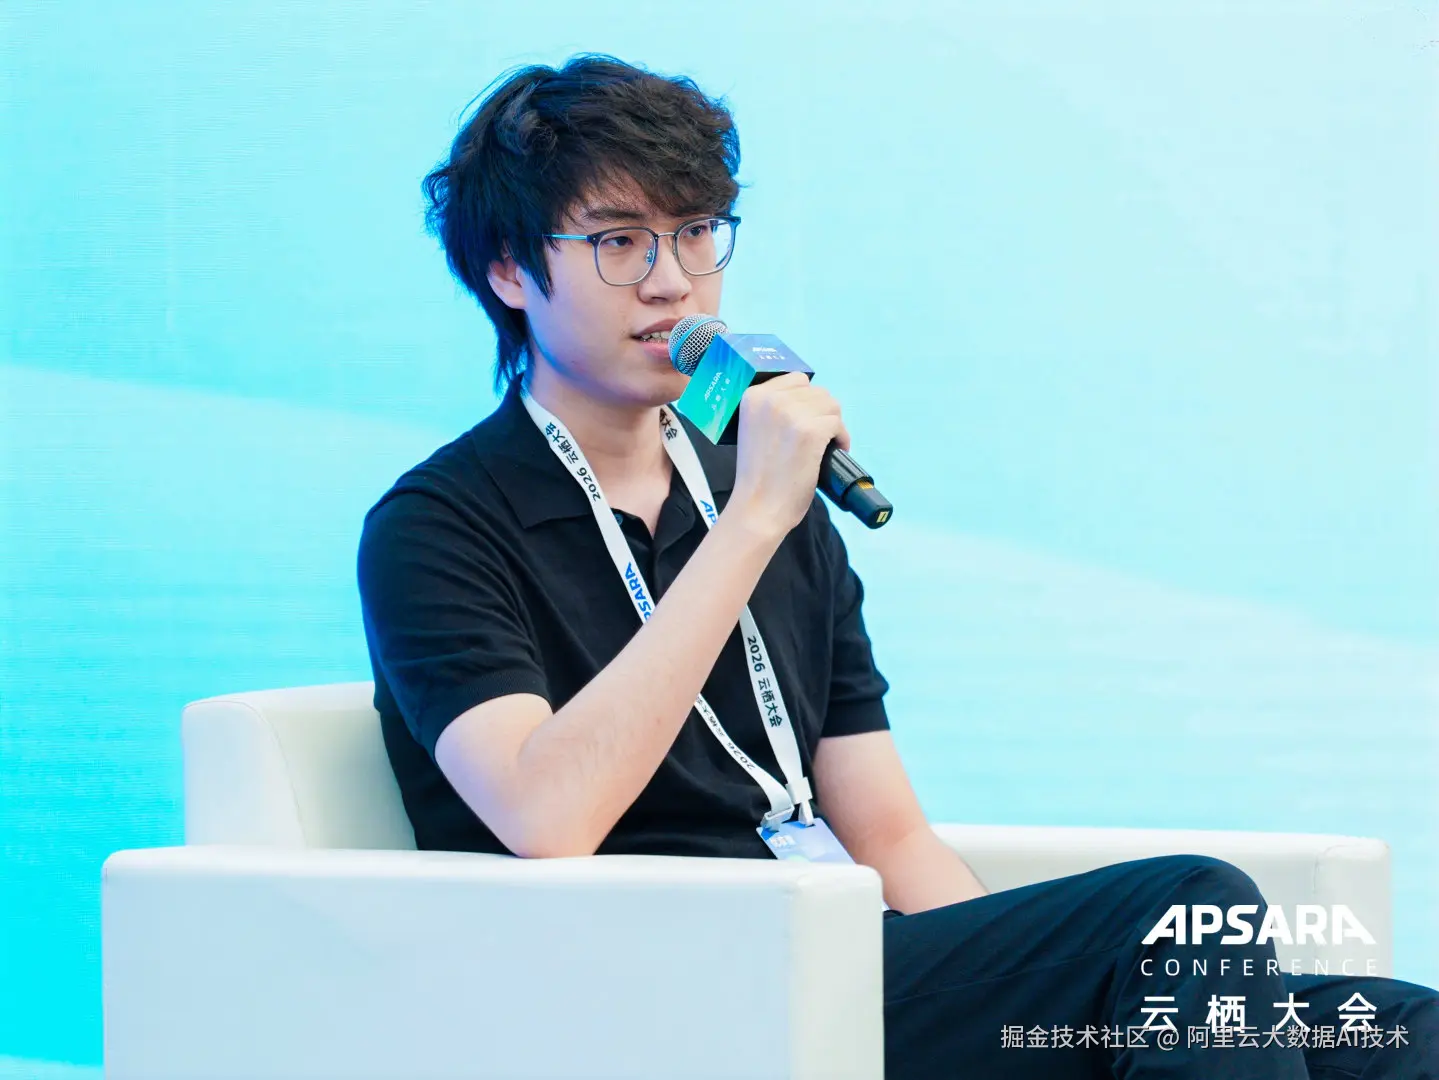
穹彻智能 AI 科学家,吕峻
刘念邱 :我更看重数据能不能在真实场景里被用起来。模型能力分三层------认知空间、动作空间、接触空间,遥操、UMI、仿真各自解决不同层的问题,所以数据一定是组合,不是某一种包打天下。世界模型我们用得少:真实世界的数据确定性是对的,而世界模型的输出还要额外质检,最多做点纹理替换这类少量增强。
训练阶段的痛点、成本与性能,怎么取舍?
刘念邱 :训练最大的挑战,是怎么分配数据、怎么做不同类型数据的迁移,以及把训练和数据来源、反馈连成一个好闭环------我要的增长不只是评测集上的分数,更是用户真实场景里的体验。成本和性能之间是有边界的,我们会用大量测试集加真实场景的'用例池'一起评估,关注的不只是数据和模型,而是整套闭环系统。
吕峻 :训练上我们最下功夫的是算法。在当前大家都能拿到的数据量级上,模型能力还有很大的提升空间;比如大家在模型训练的早期对 training recipe 摸索不充分,数据利用率就低,加上测评体系短缺,很容易迷失迭代方向。成本和性能要看是哪种性能:就模型性能而言,现在所有具身企业都应该不计成本地追更高性能,因为还没跨过合理的 bar;而 Infra 的效率本质上也是成本------它决定了你迭代的速度,是时间成本。
武伟 :大家一提卡点就是数据、算法、算力,却常常忽略训练,而训练对具身非常关键。数据按什么配比、分几个阶段进训练,像训 Qwen 的课程学习一样复杂,跳过中间几步,同样的数据和架构也会训得很糟------这些'暗知识'大多没写进论文。成本和性能上,现阶段智能化的上限比性价比更重要:量化、压缩、蒸馏、迁到国产芯片,中国工程师很快能做,真正难的是把数据里的智能蒸馏进模型;而且很多成本会从后训练、部署这一侧前移到预训练。
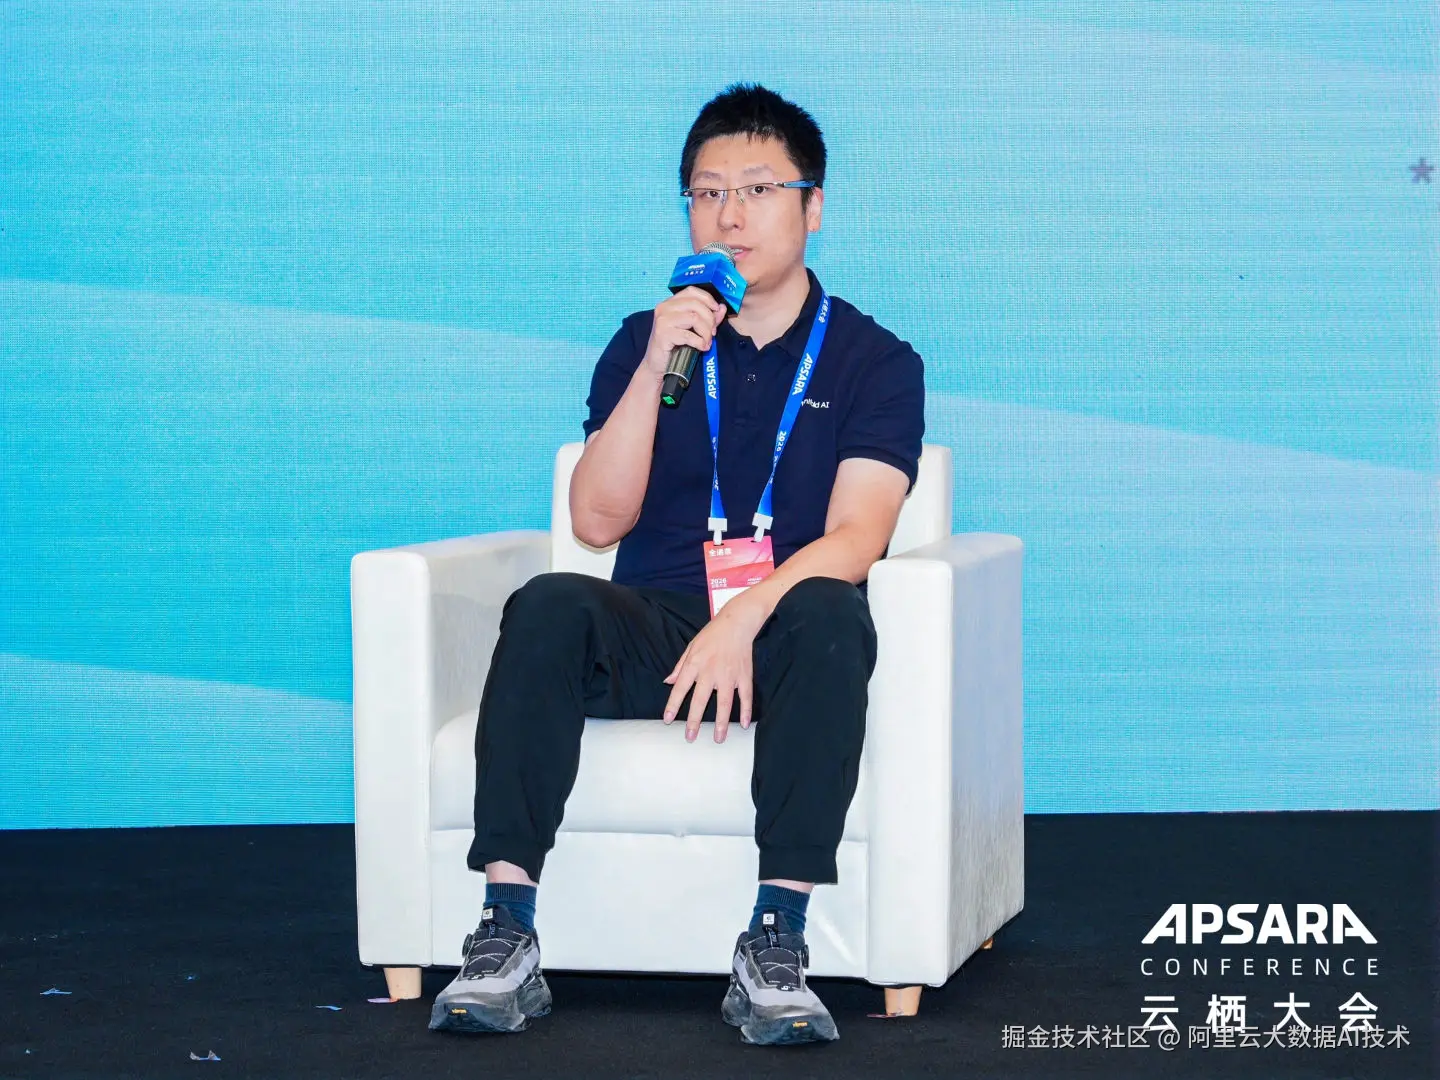
流形空间(Manifold AI)创始人兼 CEO,武伟
接下来1年内会把更多的资源投入到哪里?
武伟 :未来 12 个月我们最想押注的,是构建一套可以闭环反馈的系统,这是第一优先级。AI 做 Coding、做 RSI 发展很快,也许 12、24 个月后最聪明的不再是天才少年,而是 AI。这条能持续吸纳高质量数据、快速试算法、快速评测再迭代的管线一旦搭起来就是飞轮:先在自己家里转,再和客户之间转,模型智能化会指数级往上走。
吕峻 :比起单点的算法突破,更重要的是在团队内部搭起一套成熟的工程化研发体系,让资源被最高效利用、能时刻校验自己在不在进步。未来几个月重点还在算法迭代和算力极限上------此时此刻大家最缺的不是数据,而是把数据用得更好的算法和训练方法。但这个判断会很快变,所以要始终保持灵活的身位,随时识别当下最大的卡点。
刘念邱:我的规划是一大一小的。大的层面,我们希望把真实场景的闭环系统搭起来------数据采回来、训出模型、部署到机器人、再收回数据,形成飞轮。小的层面,我们接下来几个月会专注在几个具体场景的落地,把"真实的应用"这四个字做到位。
结语
技术路线仍在加速发散、共识却逐渐清晰:具身智能的竞争,正在从"谁的模型更炫",转向"谁的数据闭环转得更快、谁的工程体系更稳"。无论模型和数据如何演变,都要构建让"数据---模型---生产"快速转起来的闭环,这套基建是必不可少的。阿里云大数据 AI 平台在具身智能的数据管线、模型开发等环节支撑了大量行业客户,未来还将不断迭代,支撑各家具身企业把上述数据与模型的大闭环真正跑起来,为企业具身智能创新提供坚实基础。