作者:范振,StarRocks TSC Member;阿里云开源 OLAP 负责人
阿里云 EMR Serverless StarRocks 是面向实时数仓与湖仓分析的全托管服务,Stella 是其企业级内核。围绕企业在开放数据湖上的查询需求,Stella 持续优化存算分离架构、数据读取、缓存与查询执行,让保留在湖中的数据可以直接用于交互式查询、多表关联与业务分析。随着湖中的数据类型与使用方式不断扩展,Stella 也在将湖上分析能力进一步延伸到多模态检索与 AI 数据准备。
这一方向延续了 StarRocks 对 Lakehouse 的长期投入。自 2023 年提出"From OLAP to Lakehouse"技术路线以来,社区持续完善对 Delta Lake、Iceberg、Paimon 等开放湖表的支持。围绕这些湖上查询需求积累的 SQL 优化、分布式执行与数据缓存能力,也为 Stella 在云上承载更大规模、更多类型的分析负载提供了基础。
今天,湖中的分析对象正在扩大。视频、图像、音频、文档和传感器记录,需要与订单、日志、标签和评测指标一起进入计算。模型能够提取这些内容的语义,也让企业有了新的数据使用方式:根据内容发现样本,关联业务记录解释结果,再把选出的数据送入训练与评测。Paimon 2.0 在实时湖表的基础上,进一步将数据管理、特征加工和索引检索连接起来,也让查询引擎需要同时处理大范围分析与低延迟检索。
Paimon 与 StarRocks 已在阿里巴巴集团的核心业务中实现大规模落地。从淘天的大规模分析、高德的轨迹服务,到 AI Data 平台的多模态混合检索与训练数据准备,这一组合已覆盖多类核心业务。在公有云,EMR Serverless StarRocks 持续将相关技术积累转化为产品能力,服务不同行业的湖仓分析需求。集团内部的大规模应用与公有云客户的持续反馈,为 Stella 与 Paimon 在多模态场景中的协同提供了实践基础。
从结构化分析延伸到多模态检索,也给查询引擎带来了新的技术任务。大范围列扫描之外,系统还需要访问索引、归并候选,并根据稀疏的 row IDs 回捞数据。围绕 Paimon 2.0,Stella 将向量与全文检索、标量前置过滤、BLOB 读取及缓存能力接入湖上查询链路,让列式分析与索引检索进入同一套 SQL 执行架构。本文将从 Paimon 2.0 的数据组织出发,介绍分析与检索的执行路径、引擎适配,以及实际使用中的数据管理与维护方法。
Paimon 2.0:多模态数据湖的场景与技术基础
过去的湖仓分析,主要围绕业务记录构建:数据经采集、清洗和建模,形成可以过滤、关联和聚合的表。多模态应用保留了这些需求,同时把原始内容纳入分析对象。一次驾驶异常既对应一条事件记录,也对应视频中的某个画面、附近的点云和车辆状态;只看事件表,很难解释模型为什么在这一刻做出错误判断。
公开数据集已经展示了这一变化的规模。Waymo Open Motion Dataset 在 2025 年 10 月的官方说明中包含 103,354 个 20 秒场景 clips,将目标轨迹、地图与图像 embedding 等信息关联起来。Google DeepMind 在 2023 年发布的 Open X-Embodiment,则汇集了 22 类机器人的超过 100 万个任务 episodes。在这些数据中,一次观测的含义依赖于前后时序、周围环境和任务目标。样本整理因此需要同时处理内容、关系和版本。
在实际业务中,这类数据组织需求通常与内容检索、样本筛选和业务分析相结合。以下选取几个典型的行业场景加以说明:
-
智能驾驶:难例检索与问题复盘
从一次雨夜驾驶异常出发,检索相似画面,限定车型与软件版本,再关联道路条件、点云和车辆状态,排查共性问题。检索结果形成可复核、可补标的样本集,用于模型评测与训练补样。
-
具身智能:任务检索与策略评估
从一次机器人插接失败出发,检索相似的视觉状态与动作轨迹,限定任务类型和策略版本,再关联接触力与执行结果,分析失败原因。检索结果形成可回放、可比较的任务样本,用于策略评估与数据补采。
-
广告:素材检索与效果分析
从一组高转化广告出发,检索构图、商品或风格相近的素材,限定投放地区与活动周期,再关联曝光、点击和转化指标,比较不同内容特征的表现。检索结果形成带有效果指标的素材集合,用于创意迭代与投放测试。
-
游戏:资产检索与版本治理
从一项角色或场景设计需求出发,按参考图或文本描述检索相近资产,限定项目与版本,再关联授权信息和上线记录,核查复用条件。检索结果形成可追溯的资产清单,用于研发协作与资产复用。
多模态数据体量大、迭代频繁,低成本存储与数据一致性仍是基础需求。Lakehouse 将数据保留在对象存储中,不同任务可以固定在同一 Snapshot 上读取,减少数据搬迁与副本维护。Paimon 2.0 在实时湖表基础上,让原始媒体长期保留、标签和向量持续回填,使同一张表支撑特征加工、检索、分析与训练。
-
Paimon 2.0 的核心能力与实现
本文重点讨论开启 Row Tracking 与 Data Evolution 的多模态 Append 表,其关键能力与实现如下:
| 能力与组成 | 实现要点 | 查询与加工中的作用 |
|---|---|---|
| Catalog 与表 metadata | Schema、Snapshot、manifest-list 与 manifest | 发现表,固定读取版本,确定可见文件与索引 |
| Data Evolution | 更新列写入新文件,复用未变化的列 | 按列回填特征,读取时组合原始列与更新列 |
| Row Tracking | _ROW_ID 标识记录,_SEQUENCE_NUMBER 标识版本 | 对齐特征与原始样本,衔接索引结果与数据定位 |
| BLOB 与 VECTOR | 媒体、向量与普通列可分别组织 | 按需读取,避免附带加载无关的媒体内容 |
| Global Index | 标量、向量、全文索引及其覆盖范围 | 提供候选 row IDs 或分数,支持条件组合、归并与回捞 |
| PyPaimon | Python 读写与列回填,连接 Ray、PyTorch | 让特征加工、训练数据准备与 SQL 分析共用湖表 |
- 驾驶帧示例:从原始媒体到可检索的特征 一条驾驶帧记录可以逐步补充特征。首次写入时,采集时间、车型等属性保存为普通列,原始媒体通过 BLOB 独立存储,Row Tracking 为记录分配 row ID。模型完成计算后,携带同一 row ID,通过 Data Evolution 回填标签、评测结果和向量:标签与评分写入普通列,本例的向量使用单独组织的 VECTOR 文件,未变化的业务属性与媒体文件继续复用。
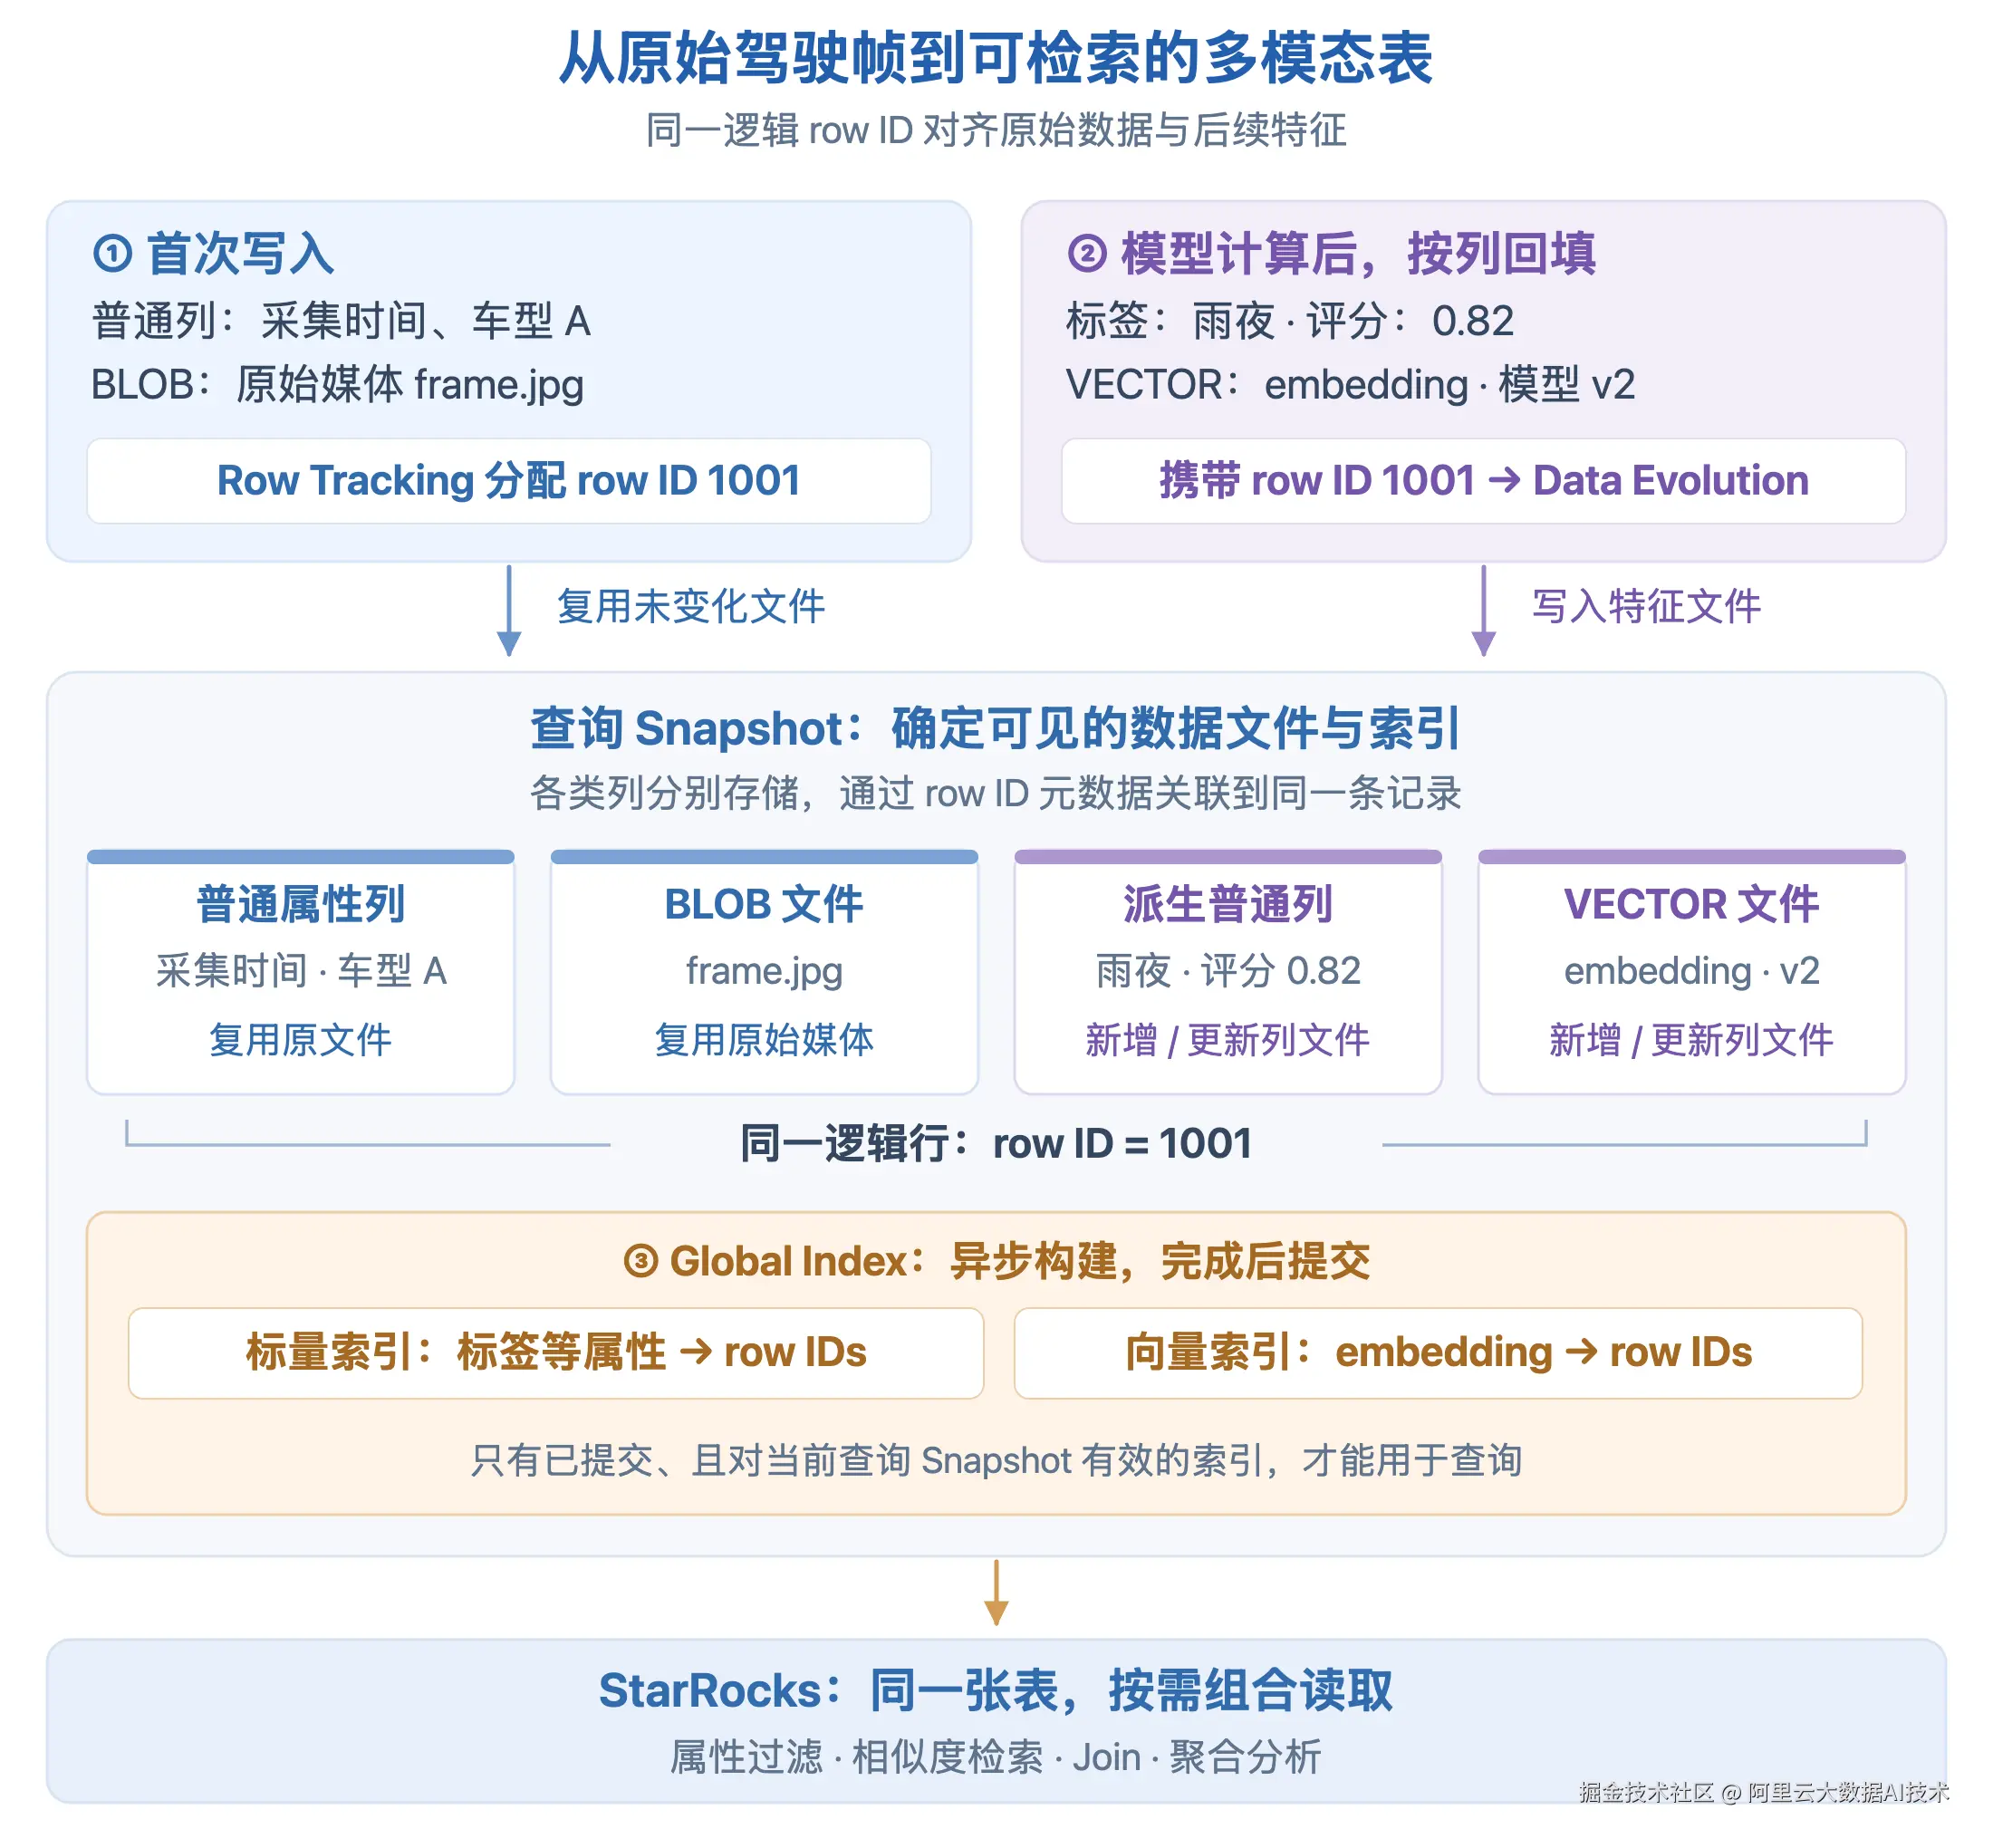
标签和向量还可以分别构建标量、向量 Global Index。查询选定 Snapshot 后,Paimon 使用该版本可见的文件与可用索引,按需组合列数据。原始内容与后来回填的特征仍属于同一张表,StarRocks 可以通过 SQL 完成检索、关联和分析。
StarRocks 与 Paimon 2.0:同一架构承载分析与检索
从 Delta Lake、Iceberg 到 Paimon,StarRocks 已经积累了跨格式的 metadata 管理、SQL 规划、分布式执行与数据缓存能力。多模态湖仓可以继续利用这些基础:业务分析仍需要 Join、聚合和排序,对象存储访问需要控制 I/O,并发查询需要资源管理。Paimon 2.0 的 Global Index 则为查询规划增加了索引访问路径。
StarRocks 对 Paimon 的支持覆盖向量与全文检索、标量前置过滤、BLOB 读取及缓存集成。查询可以先通过时间、车型和标签等条件缩小候选,再进行相似度或关键词检索;命中结果继续关联业务记录,完成统计分析。数据保留在 Paimon 表中,检索与分析共用表版本和查询执行能力。
Global Index 的标量条件可以产生 row ID 集合,并按 AND、OR 等关系组合;向量索引与全文索引还会产生候选分数,用于归并与排名。标量候选集合也可以用于向量检索的 prefilter。StarRocks 根据查询语义和成本选择列扫描或索引访问,并安排候选归并与列数据读取。
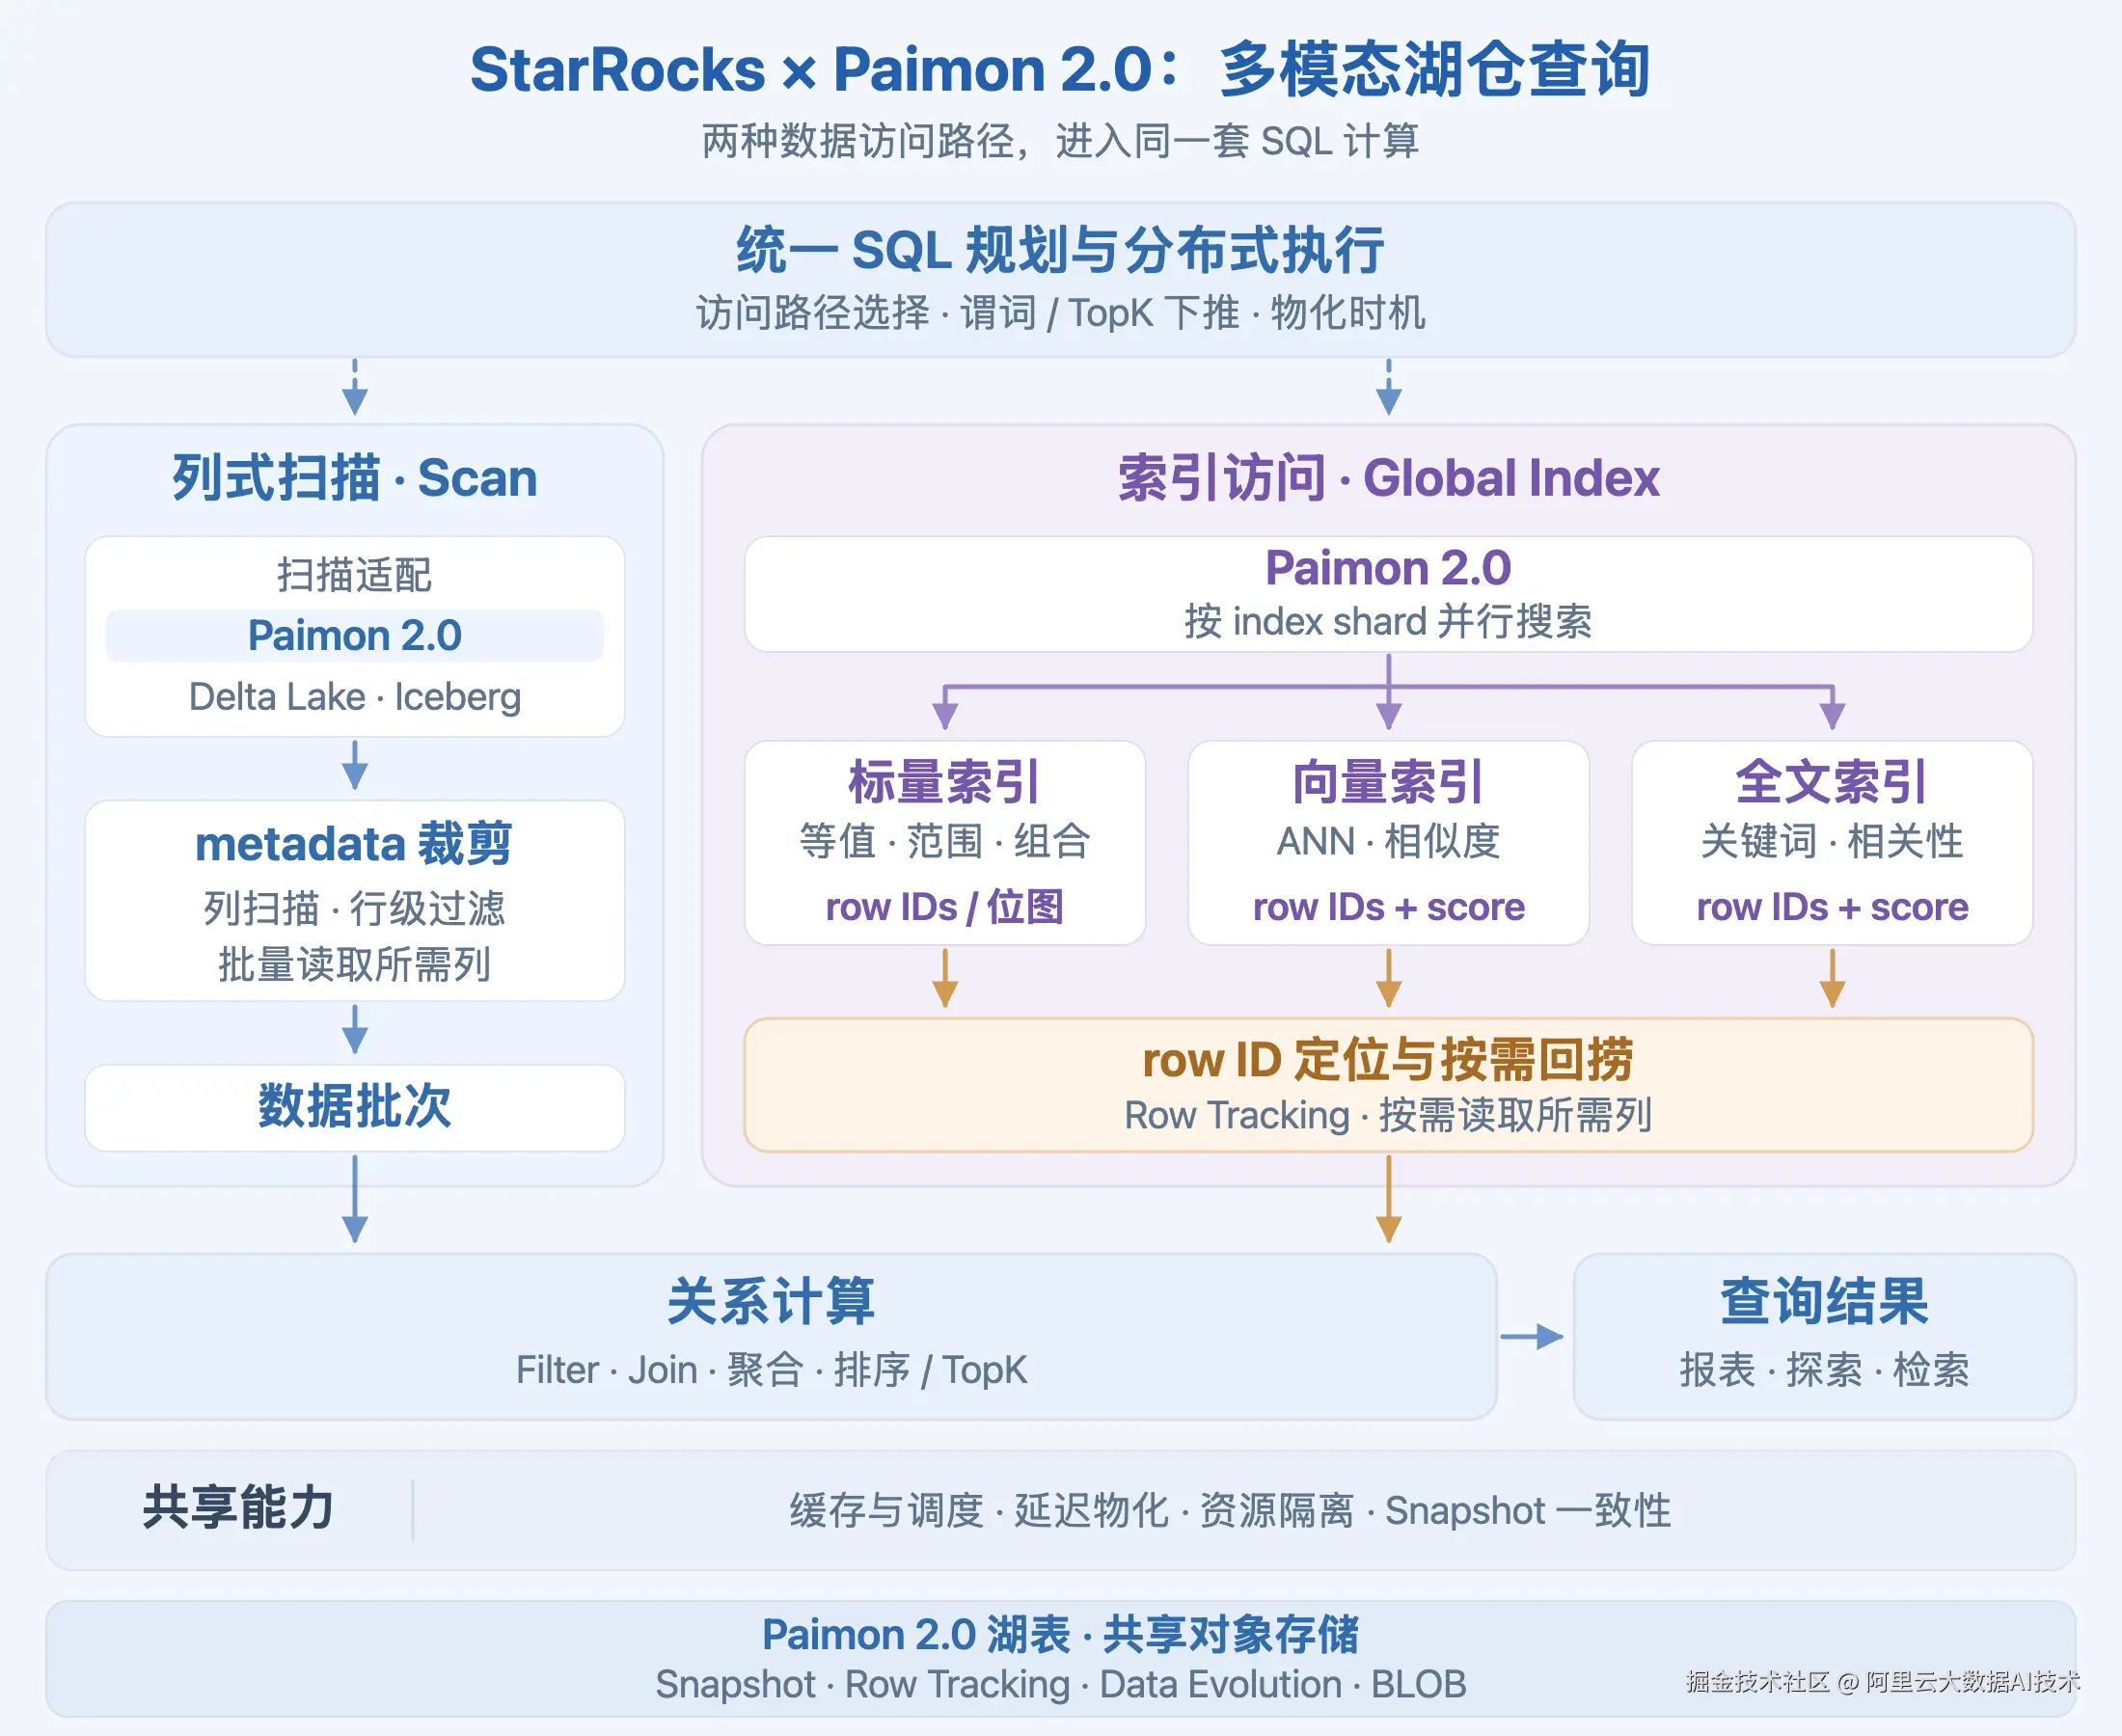
图中两条路径最终都进入关系计算。Paimon 负责表版本、行身份、列文件与索引组织,StarRocks 负责 SQL 规划、并行执行、缓存和资源管理。一条多表查询可以同时使用扫描与索引访问;Filter、Join、TopK 和延迟物化的实际顺序由查询计划决定。
从 OLAP 到 Search:查询的执行重心发生变化
OLAP:通过 data skipping 缩小列扫描范围
metadata 裁剪 → 并行列扫描与过滤 → Join、聚合与排序
以扫描为主的湖上 OLAP 查询,通常先利用分区信息、文件 metadata 中的 min/max 等统计信息,跳过不可能满足条件的数据文件。读取候选文件时,reader 还可以利用 row group、page 等更细粒度的统计信息继续裁剪。这类 data skipping 根据数据范围的摘要减少读取量,保留下来的数据仍需读取并执行行级过滤。
执行引擎以文件或文件内的数据范围组织并行读取任务,按需读取列、批量解码和过滤,再将结果送入 Join、聚合、排序等算子。这条路径常用于报表、场景统计和较大范围的关联分析,优化重点是减少扫描字节数,提升批量读取与计算吞吐,并让各执行节点承担相近的工作量。
Search:先搜索索引,再按稀疏 row IDs 回捞
索引搜索 → 候选组合或排名 → row ID 定位 → 按需回捞与后续计算
Search workload 以索引为入口,根据查询条件或向量找到候选记录。标量检索通常输出 row ID 集合,向量检索还会输出距离或分数;执行引擎组合条件、归并候选,再按需取回所需列,继续参与关系计算。
回捞时,Paimon 根据查询 snapshot 中的 row ID metadata 定位相关数据文件,再由 reader 读取所需列。对于 Data Evolution 表,同一条记录的列可能来自多个文件,需要按行身份和版本组合。稀疏候选能够缩小读取目标,实际成本还取决于命中文件数量、投影列和缓存状态。
StarRocks 的执行适配
-
搜索与回捞协同调度
StarRocks 已有的分布式执行与数据缓存,为 Paimon 查询提供了并行调度的基础。向量和全文索引可按 index shard 组织搜索任务;结果中的 row IDs 再用于定位需要读取的文件与列。索引搜索与数据读取的任务边界不同,需要分别安排并行度,并结合缓存位置和节点负载调度。回捞时按目标文件组织批量请求,可以复用 metadata 与数据缓存,控制对象请求和跨节点传输的开销。
-
候选归并与延迟物化
StarRocks 的分布式归并与全局延迟物化框架,可以先交换轻量的 row IDs 和分数,完成全局候选归并与排名。媒体地址、场景描述等仅用于输出的列,则在最终 TopK 确定后,按入选的 row IDs 批量回捞,减少无效读取、解码和跨节点传输。能否延后读取,取决于这些列的用途:如果过滤或 Join 决定哪些记录参与排名,就需要在确定最终 TopK 前处理相应条件;相关列,以及需要精排时使用的原始向量,仍可能提前读取。回捞后的数据进入 StarRocks 既有的向量化执行链路,继续完成后续分析。例如,选出最相似的 100 个驾驶帧后,可以关联车辆信息,按软件版本聚合并排序,分析这些命中样本的版本分布。
-
按整体成本选择访问路径
StarRocks 的 CBO 利用统计信息评估执行代价,并与谓词下推、Join 顺序选择共同组织查询计划。面对 Paimon 的索引访问,还需要将索引搜索量、候选规模、命中文件分布和 Data Evolution 的列合并成本纳入评估,与后续关系计算一起选择访问路径。候选过多或分布过散时,列扫描可能更经济;采用 ANN 的查询则需在既定召回目标下比较延迟与资源开销。
Paimon 2.0 最佳实践:从写入到查询的数据管理
结合实际落地经验,我们将 Paimon 多模态表的管理归纳为三件事:控制文件规模、有序回填特征、及时维护索引。它们分别影响 StarRocks 的扫描、列数据组合和索引访问成本。将查询表现与后台维护一起观察,才能判断问题出在访问路径,还是数据组织本身。
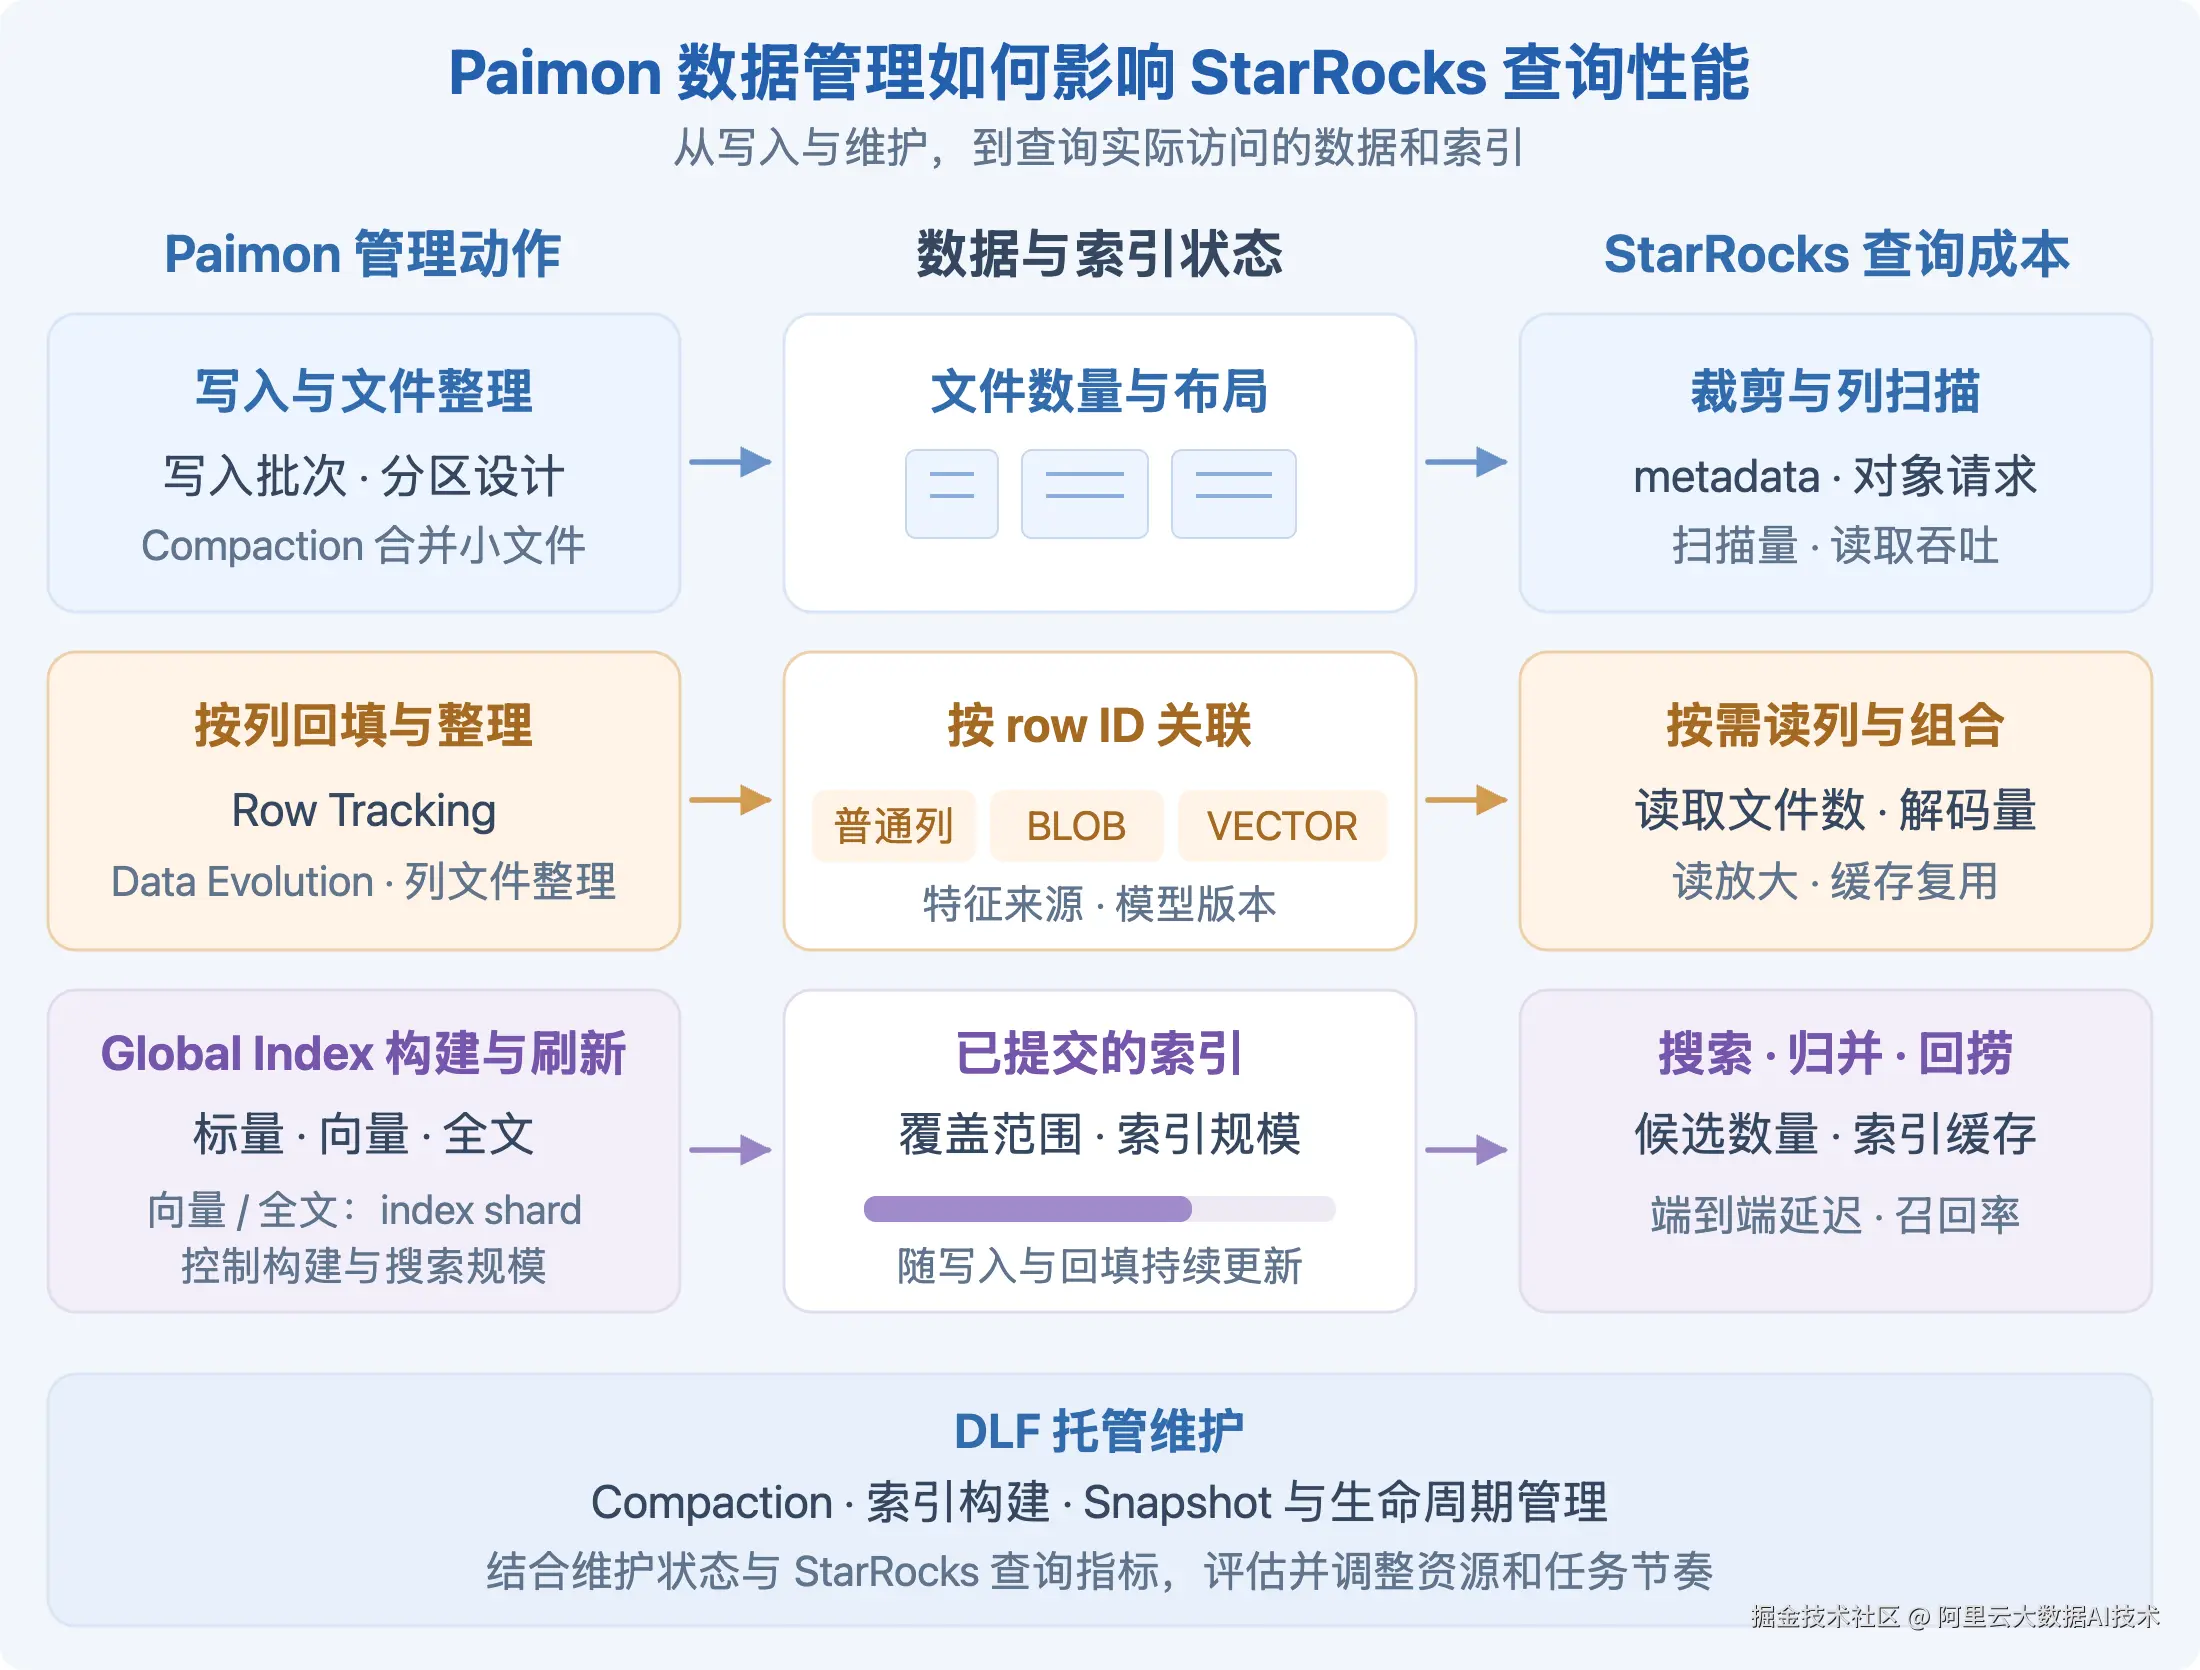
写入与 Compaction:让文件布局服务查询
-
分区与写入批次一起设计
按时间、业务域等常用条件分区,帮助 StarRocks 缩小读取范围;同时避免过细分区和过小批次。1 TiB 数据按 1 MiB 文件写入约有 105 万个对象,按 256 MiB 写入则约有 4096 个。目标文件大小仍需兼顾写入时效、查询裁剪与并行度。
-
用实际读取开销校准整理节奏
持续观察文件数量、大小分布和 Compaction 积压,并结合 StarRocks 的扫描量、对象请求与缓存命中判断维护效果。本文讨论的 Row Tracking 表采用 unaware Append 模式,不能直接套用主键表的 bucket 规划。
Data Evolution:把回填与读取成本一起规划
- 按 row ID 回填,同时保留特征版本
只写入新增或变化的列,并记录模型版本、计算时间和处理状态。不同模型生成的向量可能不属于同一特征空间,查询需要明确比较范围。Row Tracking 解决行的对应关系,特征含义与版本仍需业务管理。
- 回填计划包含列文件整理与索引刷新
局部更新会积累列文件,应结合 StarRocks 常用的投影列评估组合读取成本。被索引列更新后,需要检查索引覆盖与版本;涉及 row ID 重新分配的维护,也要处理受影响的索引和外部引用。
Global Index:围绕真实查询配置与评估
| 查询需求 | 典型索引 | 重点关注 |
|---|---|---|
| 等值、范围与类别过滤 | BTree、Bitmap | 选择性、基数、候选数量 |
| 文本与关键词检索 | 全文索引 | 分词、相关性、搜索成本 |
| 向量相似检索 | IVF-PQ 等向量索引 | 距离度量、索引体积、召回率 |
-
用 index shard 平衡并行度与任务开销
向量与全文索引的 shard 过多,会增加 StarRocks 的调度与归并开销;过大则提高单任务的处理量。BTree、Bitmap 有各自的排序和范围组织,不能套用同一种划分策略。index shard 也不等同于表分区或 bucket。
-
评估完整查询,并核对索引覆盖
固定模型、距离度量与召回目标,对比冷热缓存下的搜索、归并与回捞耗时,结合候选数量和命中文件分布调整配置。新增数据或特征更新后,单独核对已提交索引的覆盖范围。
DLF 托管维护:把维护状态与查询表现对齐
阿里云数据湖构建 DLF 可统一管理 Global Index 异步构建、自动 Compaction、Snapshot 清理、分区生命周期与废弃文件清理。团队可以将索引覆盖、任务积压和资源消耗,与 StarRocks 的查询延迟、扫描量及缓存表现一起评估,调整维护资源与执行频率。
数据写入成功与索引可供查询,是两个需要分别观察的状态。 DLF 管理湖表和索引维护,StarRocks 根据查询版本规划扫描或索引访问;维护策略要同时满足可检索时效、查询性能和成本要求。
后续持续工作:StarRocks 在混合负载下的系统优化
随着 Paimon 多模态表承载更多业务,StarRocks 需要同时处理低延迟检索与复杂 OLAP 查询,并应对特征回填、索引构建和 Compaction 带来的数据变化与 I/O 竞争。后续优化将围绕资源隔离、索引感知的查询规划,以及查询与湖表维护的协同展开,让同一套执行架构更好地适应不同负载。
-
通过 StarRocks 计算组与调度机制隔离混合负载
交互检索关注尾延迟,批量分析更关注吞吐。StarRocks 可以用不同计算组承载这两类查询,分别设置并发、资源预算和扩缩容策略。后续需要进一步结合查询特征优化任务调度、缓存复用与热点处理,减少高吞吐任务对在线检索的干扰。计算组隔离之外,还要将 StarRocks 的读取压力与后台维护使用的存储带宽一起评估,合理分配共享 I/O 资源。
-
让 StarRocks 查询规划明确感知索引覆盖
数据写入完成与索引就绪之间存在时间差。StarRocks 需要依据查询 Snapshot 中可用的索引及其覆盖范围组织访问:在查询语义和 reader 能力允许时,对未覆盖数据安排补充读取;如果业务选择只检索已建索引的数据,则应明确可检索范围。后续需要在查询规划和性能观测中体现这种差异,评估补充读取的成本,让业务能够在结果完整性、数据时效与查询延迟之间作出明确选择。
- 将 StarRocks 查询指标用于湖表维护决策
Compaction 和索引刷新由 Paimon 的维护任务或 DLF 执行,其效果最终体现在 StarRocks 的扫描、搜索和回捞开销上。后续需要将查询延迟、缓存命中与读取量,同文件规模、索引覆盖和任务积压联系起来,为维护频率与资源配置提供依据。StarRocks 侧需要完善 metadata 与缓存管理,让新查询及时使用新版本的数据和索引;运行中的查询继续固定 Snapshot,并与湖表的版本保留策略配合,保障读取一致性。
Paimon 2.0 将原始媒体、持续回填的特征与索引组织在同一套湖表与版本体系中,Stella 则在此基础上衔接索引搜索、候选归并、按需回捞与后续关系计算。一次查询可以从相似画面或关键词出发,结合业务条件筛选样本,再通过关联与聚合解释结果。数据保留在 Paimon 表中,特征加工、检索分析与训练数据准备可以围绕同一份湖上数据展开。
在阿里云上,这条链路由湖表、维护服务与查询引擎共同支撑:Paimon 组织表版本、列数据与索引,数据湖构建 DLF 可托管索引构建、Compaction 等维护任务,Stella 负责 SQL 规划、分析与检索执行。EMR Serverless StarRocks 进一步提供全托管实例管理、弹性伸缩与多计算组隔离,帮助团队根据交互检索和批量分析的不同需求配置计算资源,并结合查询表现调整湖表维护策略。
后续,Stella 将继续围绕混合负载隔离、索引感知的查询规划,以及查询与湖表维护的协同展开优化,让同一套执行架构更好地服务低延迟检索与复杂分析。集团业务与公有云客户的实际负载,将持续为这些工作提供反馈。随着 Paimon 的数据组织与索引能力不断完善,Stella 也将进一步拓展开放湖表上的多模态分析与检索能力。