一、trace 与 pprof 的本质区别
pprof 是聚合统计 :一万个样本按调用栈折叠成一张表,时间维度被抹掉。 trace 是全量事件流:每个 goroutine 的每次状态切换(创建/阻塞/唤醒/运行/让出/结束)、每次 syscall 进出、每次 GC 阶段、每次 P 启停,都带纳秒时间戳和调用栈记录在案。
ini
pprof:  f() ──► 3200 个样本 ──► "f 占了 32% CPU"          (平均,无时间轴)
trace:  t=1000123ns G7 Runnable → Running (P2)
        t=1000987ns G7 Running → Syscall (read)
t=1002455ns G7 Syscall → Runnable (等了 1.5ms!) (每个事件都有)一句话:pprof 告诉你"哪里烧时间",trace 告诉你"每一毫秒发生了什么"。所以:
- 稳态性能问题(CPU 高、分配多)→ 先 pprof;
- 时序问题(偶发延迟、尾延迟、卡顿、调度不公平、GC 影响)→ trace。
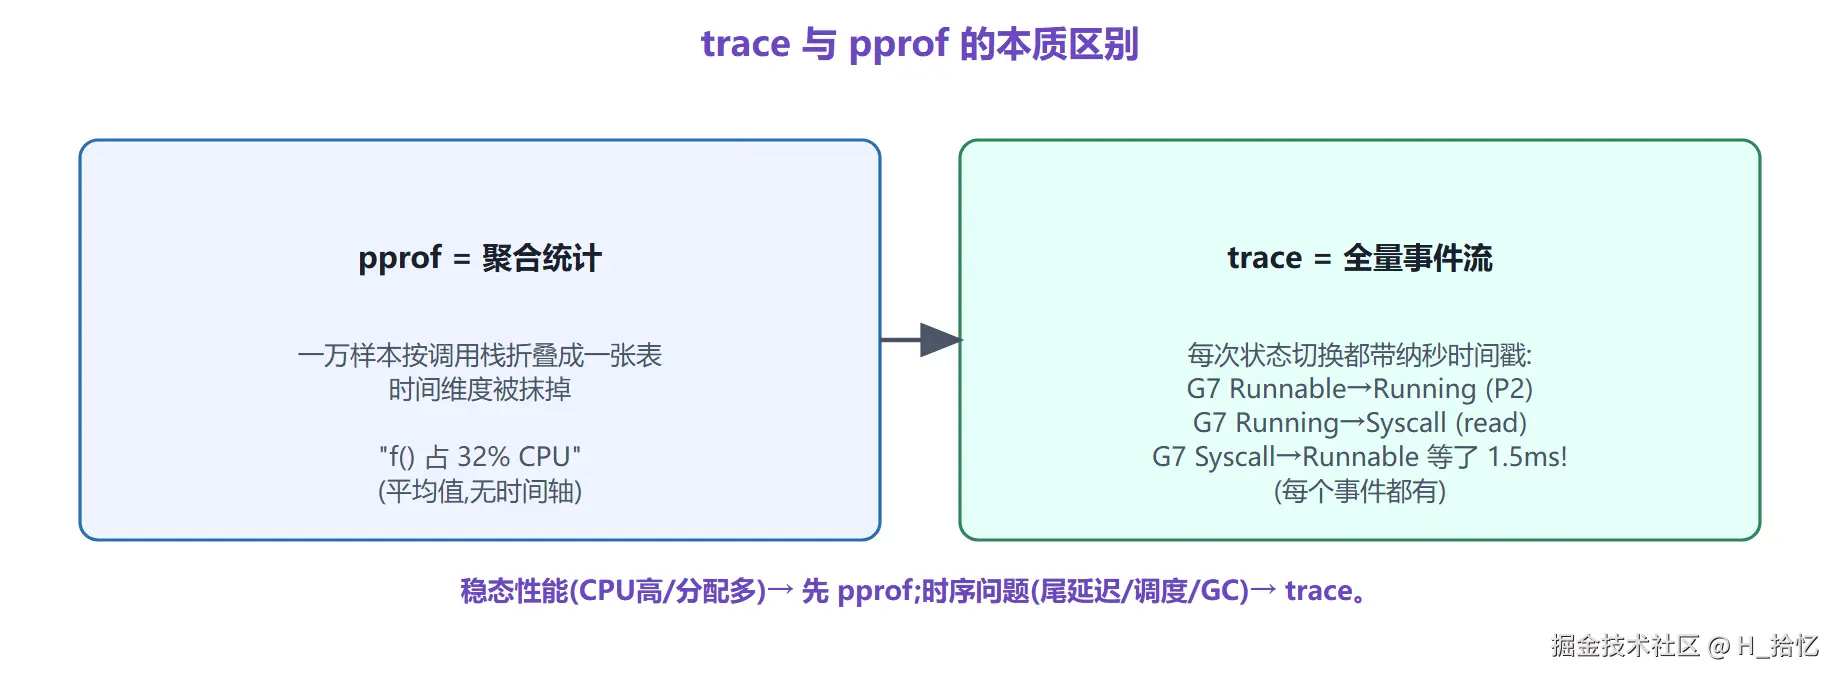 图:trace 与 pprof 的本质区别:聚合统计 vs 全量事件流
二、三种采集方式
方式 1:HTTP 端点(线上常用)
bash
curl -o trace.out "http://localhost:6060/debug/pprof/trace?seconds=5"
go tool trace trace.outseconds不传默认 1 秒 (1.24 源码net/http/pprof/pprof.go:172-175,注意与 CPU profile 的默认 30 秒不同)。- 采集期间数据流式写回,
configureWriteDeadline会把 HTTP 写超时自动加长seconds(pprof.go:123-131),不会因服务器的 WriteTimeout 截断。
方式 2:程序内显式 API(离线程序常用)
go
package main

import (
	"os"
	"runtime/trace"
)

func main() {
	f, err := os.Create("trace.out")
	if err != nil { panic(err) }
	defer f.Close()

	if err := trace.Start(f); err != nil { panic(err) } // 已在采集则返回错误
	defer trace.Stop()                                  // Stop 会等所有数据写完才返回

	// ... 业务代码
}
1.24 公共 API 的 Start 实现(runtime/trace/trace.go:121-139)值得看一眼,它会:
- 调
runtime.StartTrace()让 runtime 开始产数据; - 另起一个 goroutine 死循环
runtime.ReadTrace(),把分块数据搬给你的io.Writer------这就是为什么"trace 数据是流式的,不是一次性快照"。
Stop() 只在全部数据落盘后 返回(trace.go:141-149),这就是"优雅退出不丢尾部数据"的保证。
方式 3:go test
bash
go test -trace=trace.out ./...
go tool trace trace.out
想看单个 benchmark 的 trace 时,用方式 2 包在测试代码里也可以(Start/Stop 夹住被测段)。
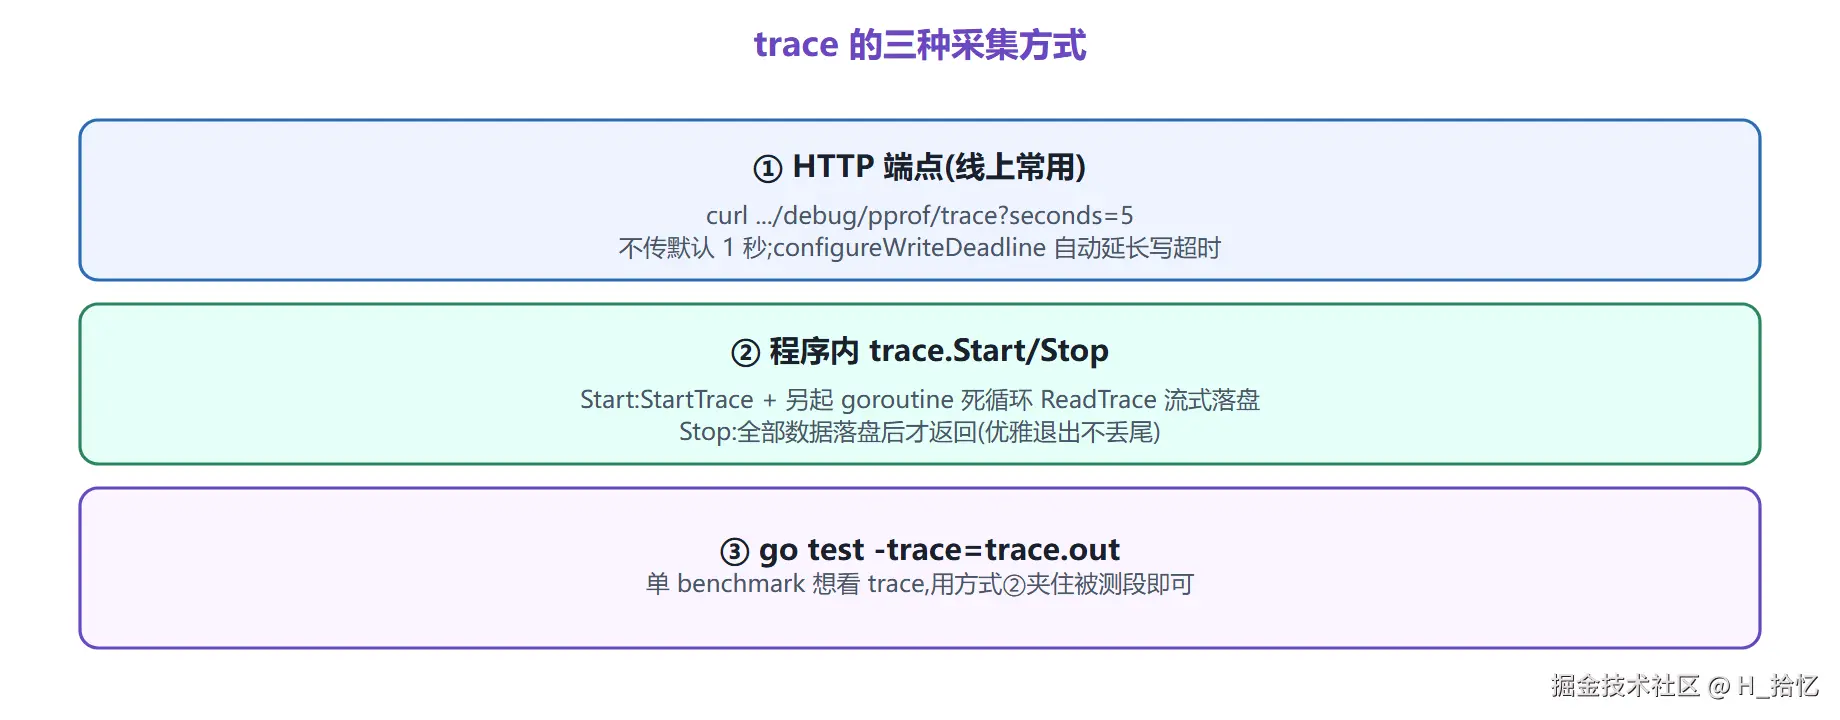 图:trace 的三种采集方式
三、打开 viewer:首页地图
bash
go tool trace trace.out
# 2026/11/01 11:20:00 Preparing trace for viewer...
# 2026/11/01 11:20:02 Opening browser (this may take a while)
它会在本机起一个 HTTP 服务并打开浏览器。首页(internal/trace/traceviewer/http.go)包含:
| 区块 | 内容 |
|---|---|
| View trace | 时间线主视图(下节精读),可按 thread / GC / 代(generation)等维度切换 |
| Goroutine analysis | 按创建栈分组的 goroutine 耗时分析(第五节) |
| Network blocking profile | 网络等待的 pprof 图(/io) |
| Synchronization blocking profile | channel/mutex 等同步等待(/block) |
| Syscall profile | 系统调用阻塞(/syscall) |
| Scheduler latency profile | 调度等待(就绪→运行的间隔)(/sched) |
| User-defined tasks / regions | 你用 API 标注的任务/区间直方图 |
| Garbage collection metrics | GC 时长统计 + MMU 图(最小 mutator 利用率) |
后四个 profile 均可 ?raw=1 下载成标准 pprof 文件,离线用 go tool pprof 打开------trace 也能产出 pprof 数据,这是两个工具的交汇点。
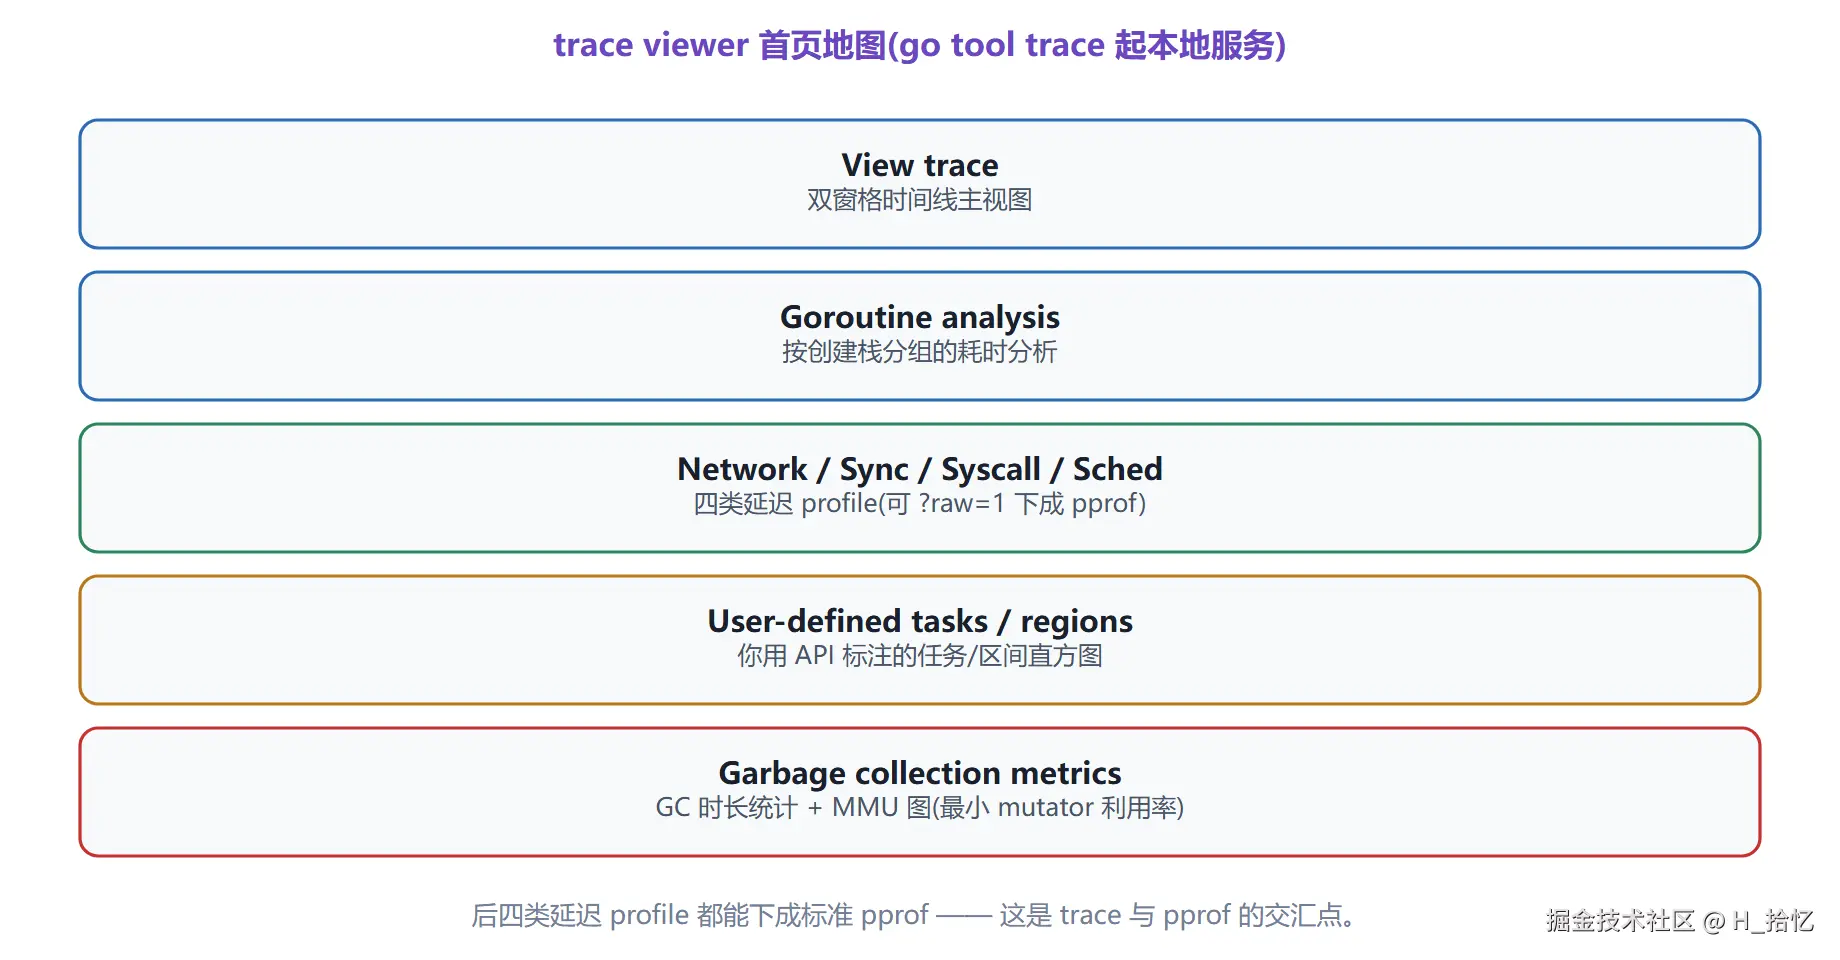 图:trace viewer 首页地图
四、时间线视图精读
"View trace" 打开的是双窗格时间线:
less
┌─ 上窗格:宏观总览(整条 trace 压缩成一行,颜色块=事件密度) ──────────┐
│  ▓▓▓▒▒▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓│
└────────────────────────▲拖动选窗口────────────────────────┘
┌─ 下窗格:微观明细 ────────────────────────────────────────────┐
│ Threads    │ T1 ████████░░░░████████████                     │
│ Proc 0..N  │ P0 ██ G7 ███████ ██ G9 ████████████            │  ← 每行一个 P
│ Goroutines │ G7 ▁▁▂▁▁▁▁▁▁▂▁ (事件密度,点开看单个 G)        │
│ Heap       │     ╱╲    ╱╲   ╱╲  ← 堆大小曲线                │
│ OS Threads / Runtime │ ██STW██   █GC█  ← runtime 阶段        │
└──────────────────────────────────────────────────────────────┘读法三步:
- 先看堆曲线与 GC/STW 区块:毛刺时刻是否有 GC/STW 对齐?heap 是否锯齿异常?
- 看 P 行的颜色段:每个 P 上显示当前运行的 G 序号。大量 P 同时空白(白段)→ CPU 没吃满,去看 goroutine 状态;P 全满但延迟高 → CPU 瓶颈,回 pprof。
- 点开具体 goroutine :从 Goroutine analysis 或点击 P 上的 G 跳转,视图切换为"以该 G 为中心,只显示与它有阻塞/唤醒关系的 G"------顺着 unblock 关系可以人肉追出一条唤醒链(
goroutines.go:171-176页面上的 goroutine 链接即此)。
WASD/V 快捷键:W/S 缩放,A/D 平移------大 trace 必备。数字键切换窗格焦点。
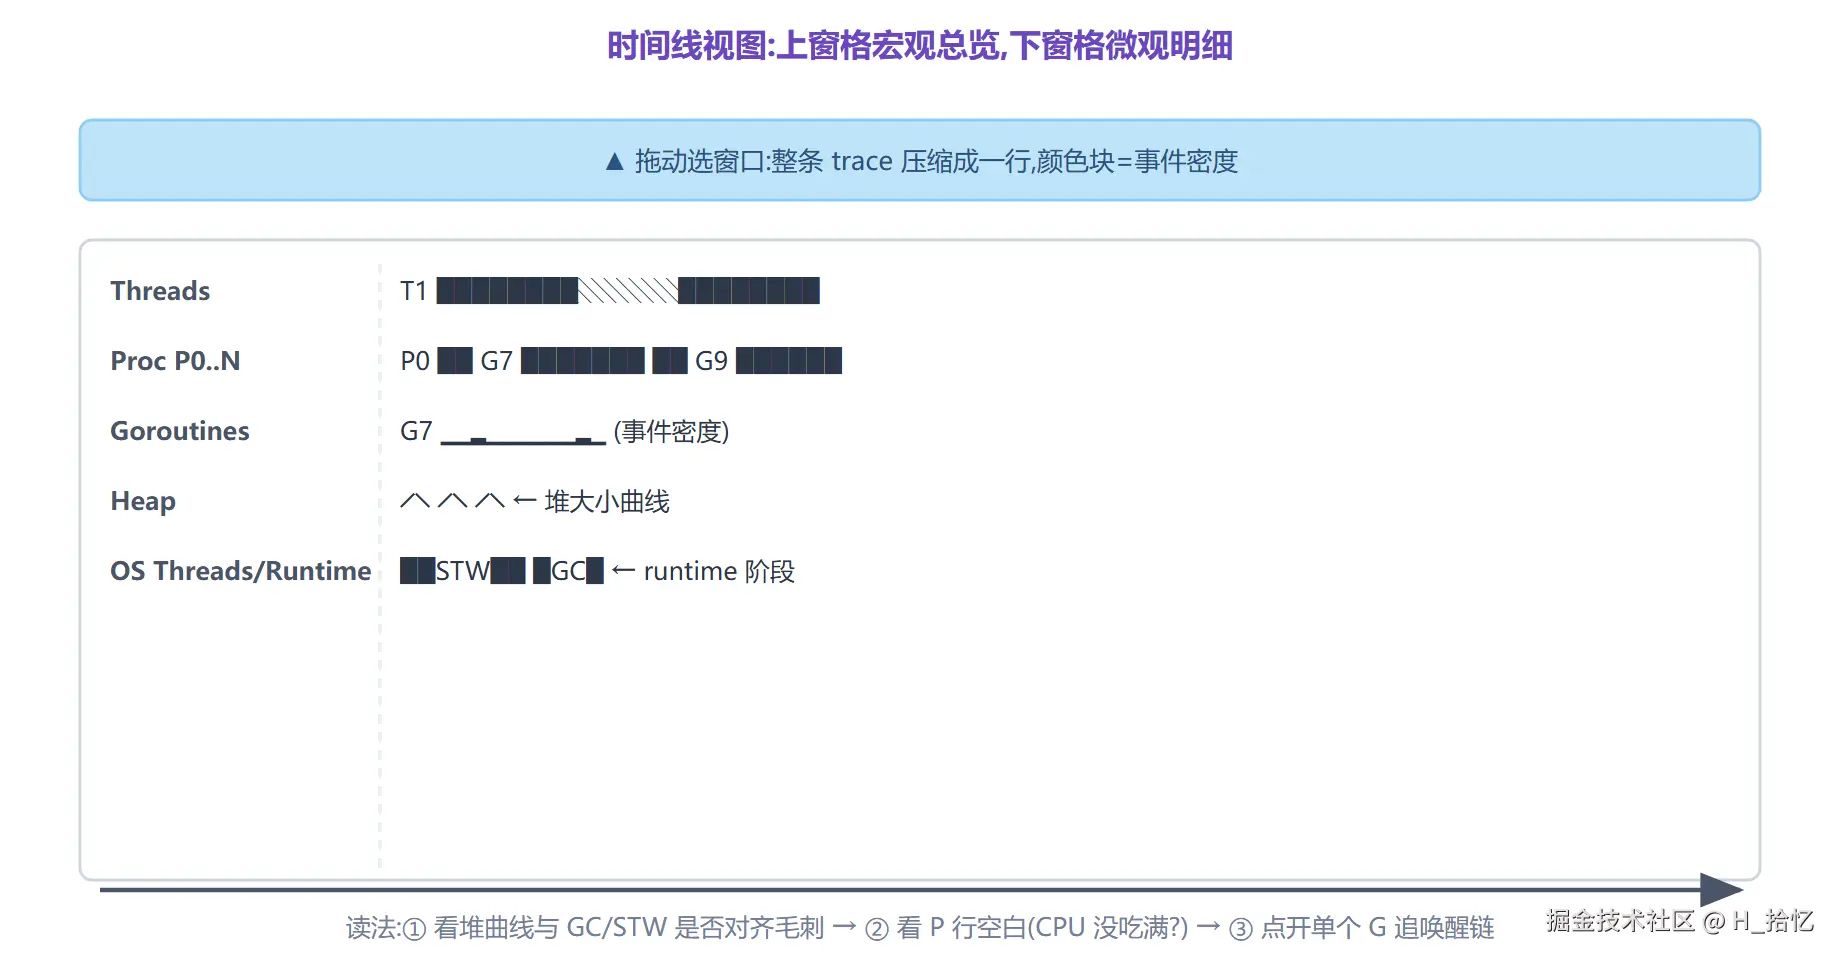
图:时间线视图:上窗格宏观总览,下窗格微观明细
五、Goroutine analysis:六类耗时桶
按创建栈分组后,每个 goroutine 的生命周期被拆进互不重叠 的耗时桶(internal/trace/summary.go:122-136,1.24 实际类别):
| 桶 | 含义 | 异常时说明什么 |
|---|---|---|
| Execution time | 真正在 CPU 上跑 | 占比高 → CPU 瓶颈,转 pprof |
| Sched wait time | Runnable → Running 的排队时间 | 高 → G 多 P 少/CPU 饱和/被抢占,GOMAXPROCS 或任务切分问题 |
| Syscall execution time | 系统调用自身执行 | 高 → IO/文件系统慢 |
| Block time (syscall) | 因系统调用阻塞(让出 P 后仍未就绪) | 高 → 系统调用慢且频繁 |
| Block time (原因) | 同步阻塞,按原因细分:chan receive、chan send、select、sync.Mutex.Lock、sync.WaitGroup.Wait、GC assist... |
直接指认等待点 |
| Unknown time | 以上都对不上的残余 | 通常很小;偏大说明有未被建模的状态(如 cgo) |
表格中每个 goroutine 有一根堆叠条形图,颜色按桶占比------一眼扫出"整排都是 Sched wait"的分组,就是调度饥饿的群体。
分组页还有四个可下载的 pprof:Network wait、Sync block、Syscall、Scheduler wait(每组按创建栈过滤,goroutines.go:325-339)。
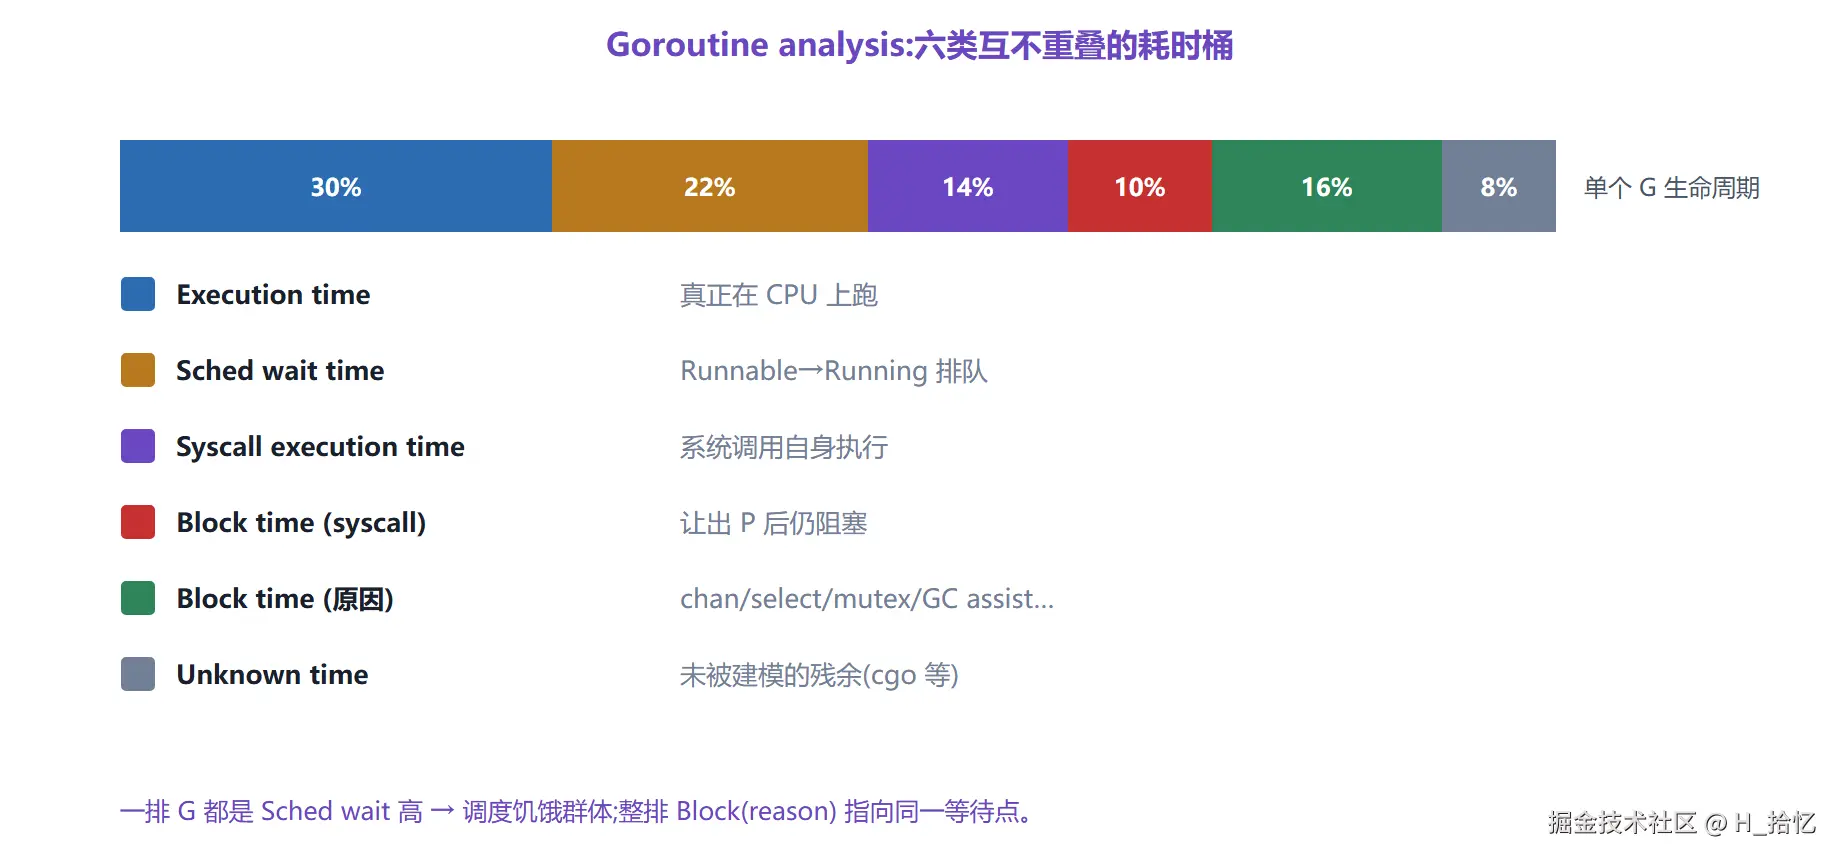 图:Goroutine analysis 的六类互不重叠耗时桶
六、四类延迟 profile 与 GC 页面
首页四个延迟 profile 的定义(traceviewer/http.go:187-190 原文):"goroutine 无法在逻辑处理器上运行的四种原因"------等网络、等同步原语、等系统调用、等可用 P。
用法与第 01 篇的 pprof 完全一致(它们就是 pprof 格式):
bash
curl -o sched.profile "http://127.0.0.1:PORT/sched?raw=1"
go tool pprof -http=:8080 sched.profile
与 runtime 的 block/mutex profile 的区别 :trace 版把"就绪但没跑"单独拎出来(scheduler latency),而 runtime 的 block profile 只看同步原语。尾延迟问题 80% 的入口是 Scheduler latency profile------先看谁在排队,再回时间线找原因。
GC 页面 :GC 次数、每次 STW/mark 时长;MMU 图(Minimum Mutator Utilization)回答"任意 X 毫秒窗口内,应用代码至少能占到百分之多少 CPU"------GC 越凶,曲线越低。这是评估"GC 对延迟敏感服务影响"的量化工具。
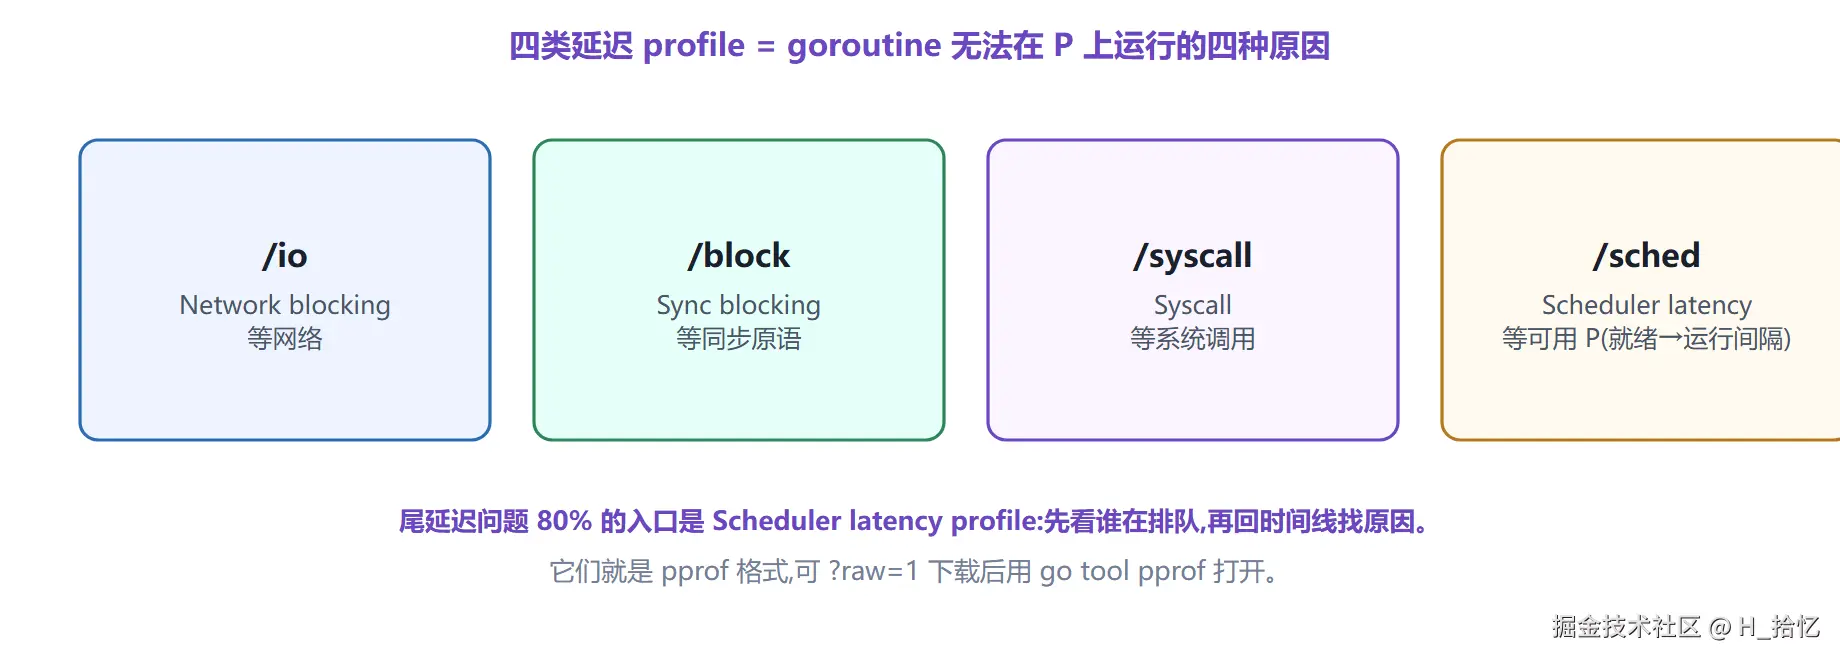 图:四类延迟 profile = goroutine 无法在 P 上运行的四种原因
七、用户标注 API:task / region / log
三级标注,粒度从粗到细(全部在 runtime/trace 包,annotation.go):
7.1 Log:瞬时事件
go
trace.Log(ctx, "orderID", orderID)                    // 总是记录
trace.Logf(ctx, "timing", "stage2 took %v", elapsed)   // 仅在开启采集时才格式化(省开销)
Logf 先查 IsEnabled() 才做 Sprintf(annotation.go:101-108)------高频路径用 Logf,低频用 Log。
7.2 Region:同 goroutine 内的时间区间
go
// 闭包式(推荐,难漏 End)
trace.WithRegion(ctx, "extractCoffee", extractCoffee)

// 手动式:StartRegion 必须在同一个 goroutine 里 End,且区间必须正确嵌套
r := trace.StartRegion(ctx, "parse")
defer r.End()
两条硬规则(源码注释 annotation.go:146-148):同 goroutine 内必须嵌套 (后开的必须先关);未开启采集时 StartRegion 返回 noop 实例,零成本。
7.3 Task:跨 goroutine 的逻辑操作
go
ctx, task := trace.NewTask(ctx, "makeCappuccino") // 挂进 context,顺着 ctx 传给所有参与者
defer task.End()                                   // 延迟 = NewTask 到第一次 End 的时长

go func() { // 子任务:ctx 里带着 task,自动关联
	trace.WithRegion(ctx, "steamMilk", steamMilk)
	milk <- true
}()- task 通过
context.Context传播:任何拿着这个 ctx 的 goroutine 里的 region/log 都归属该 task。 - viewer 的 "User-defined tasks" 页给出每类 task 的延迟直方图,点开能看到该 task 的完整事件序列(谁创建、在哪等、日志打了什么)------这就是"一次请求"级别的追踪。
NewTask即使未开启采集也会分配 ID (annotation.go:45-48的注释解释了原因:ctx 可能跨越采集的开关边界)。- taskType/regionType 的取值集合必须有限(源码注释明确要求 "a handful of unique")------别把订单号当 taskType,那是 Log 干的事。基数爆炸会拖垮 viewer。
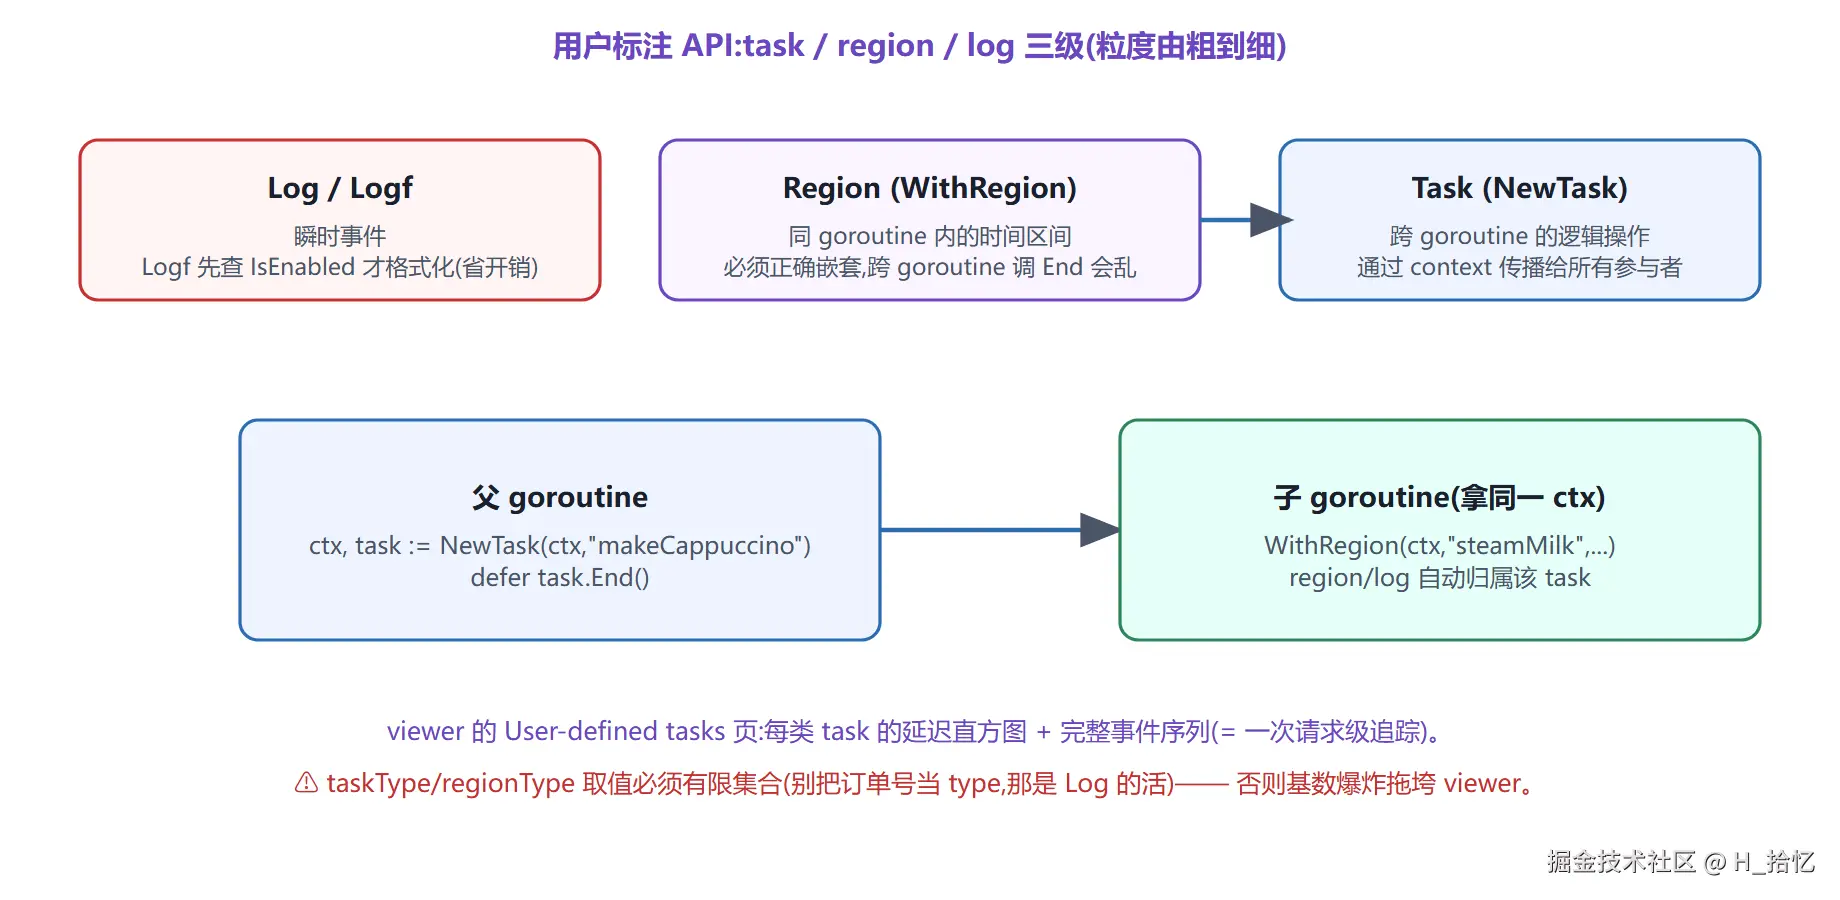 图:用户标注 API:task / region / log 三级
八、实战手册:四类问题的 trace 侧排查
8.1 偶发延迟毛刺(P99 高)
- 毛刺时刻前后抓 5~10 秒 trace;
- 时间线对齐毛刺时刻,看是否有 STW / GC mark 区块重叠;
- 看 runnable 队列(Goroutines 行突然变高)→ 调度饥饿;
- Scheduler latency profile 找排队大户 → 回时间线点开它,看它是被谁阻塞后唤醒晚了。
8.2 吞吐上不去但 CPU 闲
时间线上 P 大量空白 + goroutine 全在 Block time (chan receive) → 管道串行化瓶颈;Block time (sync.Mutex.Lock) → 锁竞争(配合第 01 篇 mutex profile 定位持锁者)。
8.3 GC 压力评估
GC 页看 STW/mark 时长与频率;MMU 图看 100ms 窗口利用率;heap 曲线锯齿的斜率 = 分配速率,斜率陡 → 回 pprof 的 allocs 灭火。
8.4 系统调用 / cgo 慢
Goroutine analysis 的 Syscall 两桶异常大;时间线上看 G 的 Running → Syscall 段长度。cgo 调用在 1.24 trace 里同样以 syscall 阻塞形态出现(且常伴随线程不归还 P 的现象)。
九、开销、格式与版本注意事项
- 开销 :Go 1.21 全面重写 tracer(frame pointer 回溯 + 流式落盘),大多数服务开销在 1~2% CPU 以内;1.22 起高并发下的伸缩性进一步改善。可以常开短窗,但别当 7×24 全量记录用------文件大小与事件数成正比,繁忙服务每分钟可达数百 MB。
- 采集时长建议:10~30 秒封顶,够看问题了。
- 格式版本 :1.21+ 是新格式
go 1.22 trace版本头;go tool trace向下兼容旧格式(读旧文件走internal/trace/oldtrace.go的兼容读路径),但旧 Go 的 viewer 读不了新格式。 - 1.24 还没有飞行记录仪 :
trace.FlightRecorder(常驻环形缓冲、事后取最近片段)是 Go 1.25 加入的;1.24 上等价做法是定时短窗采集(如每 5 分钟抓 10 秒滚动覆盖)。 - trace 与 pprof 同开:完全支持,而且 CPU 采样会被合入 trace(时间线上能看到样本)
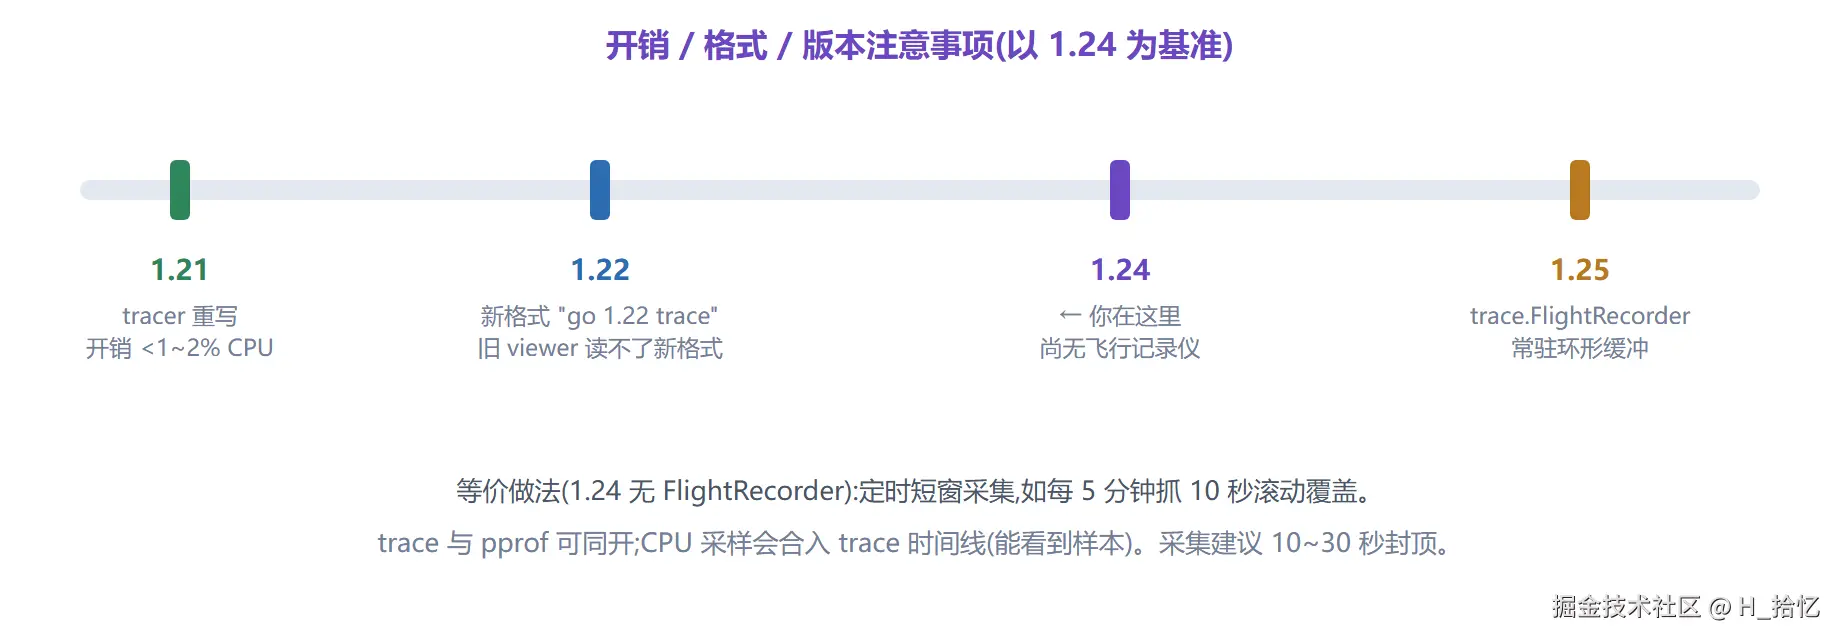 图:开销 / 格式 / 版本注意事项(以 1.24 为基准)
十、常见坑 Top 8
| # | 现象 | 原因 → 解法 |
|---|---|---|
| 1 | trace.out 是空的/残缺 | trace.Stop() 没等完就退出了 → 用 defer,HTTP 端点等请求自然结束 |
| 2 | viewer 打不开、浏览器卡死 | trace 太大(几 GB)→ 缩短采集;用 Goroutine analysis 页代替全量时间线 |
| 3 | 大量 "Unknown time" | 存在 cgo/长系统调用等未建模状态 → 结合 /syscall profile 看 |
| 4 | task/region 页面巨卡 | taskType 基数爆炸 → 类型用有限集合,动态值走 trace.Log |
| 5 | StartRegion 的 End 崩溃/数据乱 | 跨 goroutine 调 End 或未嵌套 → 换 WithRegion 闭包式 |
| 6 | goroutine 在时间线上找不到 | 新版按事件密度渲染 → 用 Goroutine analysis 里的 /trace?goid=N 直达 |
| 7 | 旧 Go 版本看新 trace 报错 | 新旧格式不兼容 → 用匹配版本的 go tool trace |
| 8 | 采集时服务抖动 | 秒级参数太大或磁盘慢 → 秒数降到 5,输出写到本地盘再拷走 |