双层缓存与权限实时生效:织码在线教育系统的 Caffeine + Redis 设计
网关鉴权既要快,也要在权限变更后尽快收敛。本文以织码在线教育系统为例,拆解 Caffeine + Redis 双层缓存、权限刷新策略和在线计数的不同一致性要求。
网关的每一次请求都要判断:Token 是否有效、用户有哪些接口权限、当前请求是否允许通过。并发量上来后,鉴权如果每次都查数据库,数据库会成为流量放大器;如果每次都访问 Redis,虽然减轻了数据库压力,却给每个请求增加了一次网络往返。
更敏感的问题是权限变更。管理员刚刚关闭一个角色的接口权限,用户手上的旧权限如果仍停留在网关本地缓存里,安全策略就不会立即生效。
织码在线教育系统采用 Caffeine 本地缓存 + Redis 分布式缓存 的两层架构,并用较短的本地 TTL 控制收敛时间。本文聚焦这套缓存设计,不重复展开权限模型本身。
阅读说明:配置名、类名和业务案例沿用原稿描述;代码片段用于说明设计思路,具体版本的实现和参数以源码为准。文中"30 秒内生效"是缓存策略目标,不等同于严格的实时安全保证。
一、先看请求路径:L1 命中时不访问网络
一次网关鉴权可以抽象为:
text
请求
  -> SysGlobalFilter
  -> L1:Caffeine 本地缓存(expireAfterWrite 30s,maximumSize 500)
       命中:直接读取权限列表
       未命中 -> L2:Redis(ADMIN_APIS + userId)
                    命中:回填 L1
                    未命中:查询数据库 -> 写 Redis -> 回填 L1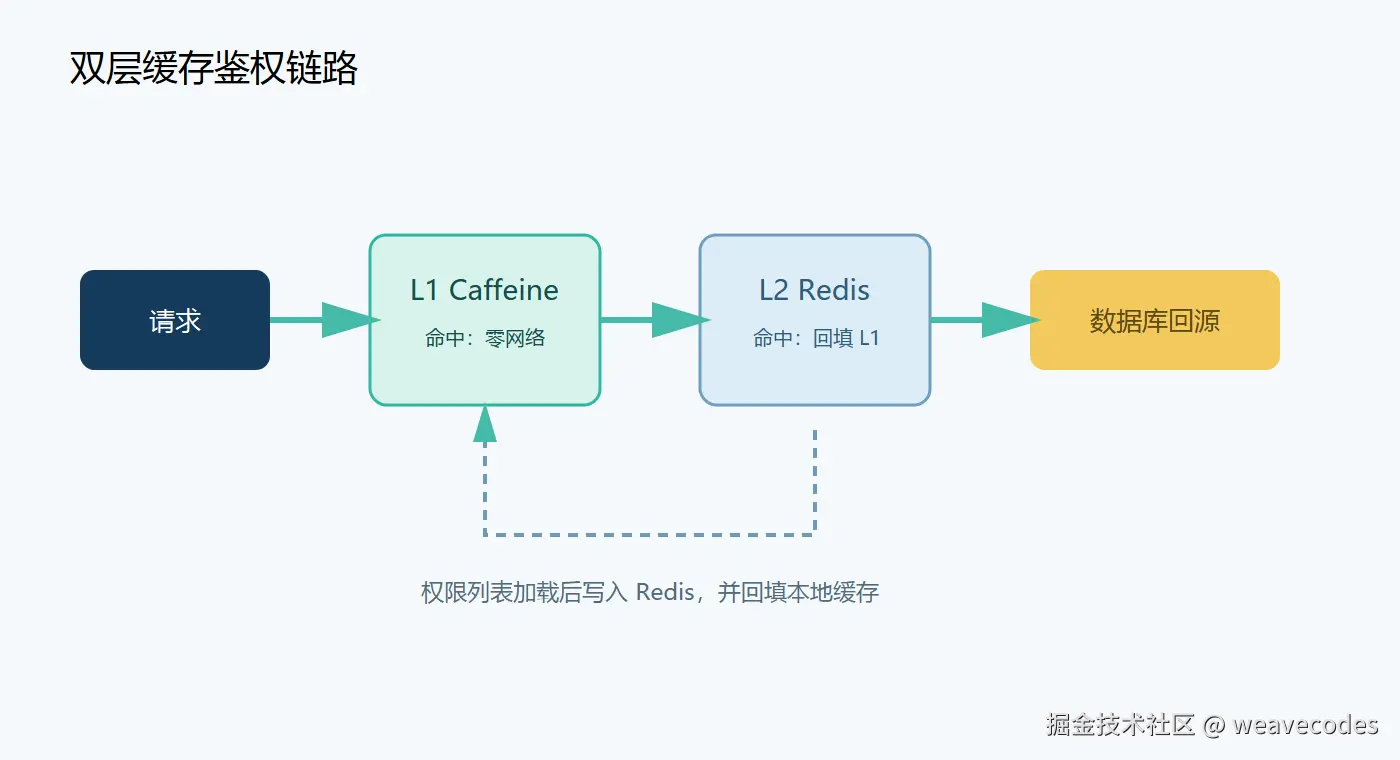
图 1:热点请求在 L1 结束;只有缓存未命中才会向下访问 Redis 或数据库。
本地缓存通常在 SysGlobalFilter 中创建:
java
private final Cache<String, List<String>> localPermissionCache = Caffeine.newBuilder()
        .expireAfterWrite(30, TimeUnit.SECONDS)
        .maximumSize(500)
        .build();
两个参数对应两类约束:
| 参数 | 作用 | 需要关注的点 |
|---|---|---|
expireAfterWrite(30s) |
控制本地权限最长保留时间 | 影响权限变更的收敛速度 |
maximumSize(500) |
限制单实例缓存条目数 | 防止用户规模增长造成内存失控 |
网关是多实例部署时,每个实例都有自己的 L1。maximumSize(500) 不是全局上限,而是每个实例的上限;实际内存占用还取决于每个用户的权限列表长度。
二、L1、L2 如何协作:加载、回填和续期
原稿中的读取逻辑可以概括为:
java
localPermissionCache.get(userIdStr, key -> normalizeApis(
        cacheRedis.list(RedisConstant.Base.ADMIN_APIS.concat(key), String.class)
));

cacheRedis.expire(
        RedisConstant.Base.ADMIN_APIS.concat(userIdStr),
        PC_TIMEOUT,
        TimeUnit.MINUTES
);
这里有三个容易被忽略的行为:
- L1 未命中才访问 L2:大多数热请求不产生网络开销。
- L2 命中后回填 L1:后续请求继续在本地完成鉴权。
- Redis 侧滑动续期:活跃用户的权限数据不会因为固定 TTL 频繁失效,但要为 Redis 内存设置容量和淘汰策略。
Caffeine 的 get(key, mappingFunction) 可以把"检查并加载"封装在一次调用中,降低同一实例并发未命中时的重复加载。不过它只解决单实例内的加载协调,无法替代跨实例的失效通知、幂等更新和 Redis 高可用设计。
三、权限变更为什么是"Redis 立即刷新,L1 最多等待 30 秒"
权限调整由 SysUserCommonBiz 触发时,系统先更新 Redis 中的 ADMIN_APIS + userId:
text
权限变更
  -> 更新 Redis 权限列表
  -> 新的 L2 数据立即可读
  -> 各网关实例的 L1 继续使用旧值
  -> L1 在写入后 30 秒内自然过期
  -> 下一次请求从 Redis 加载新权限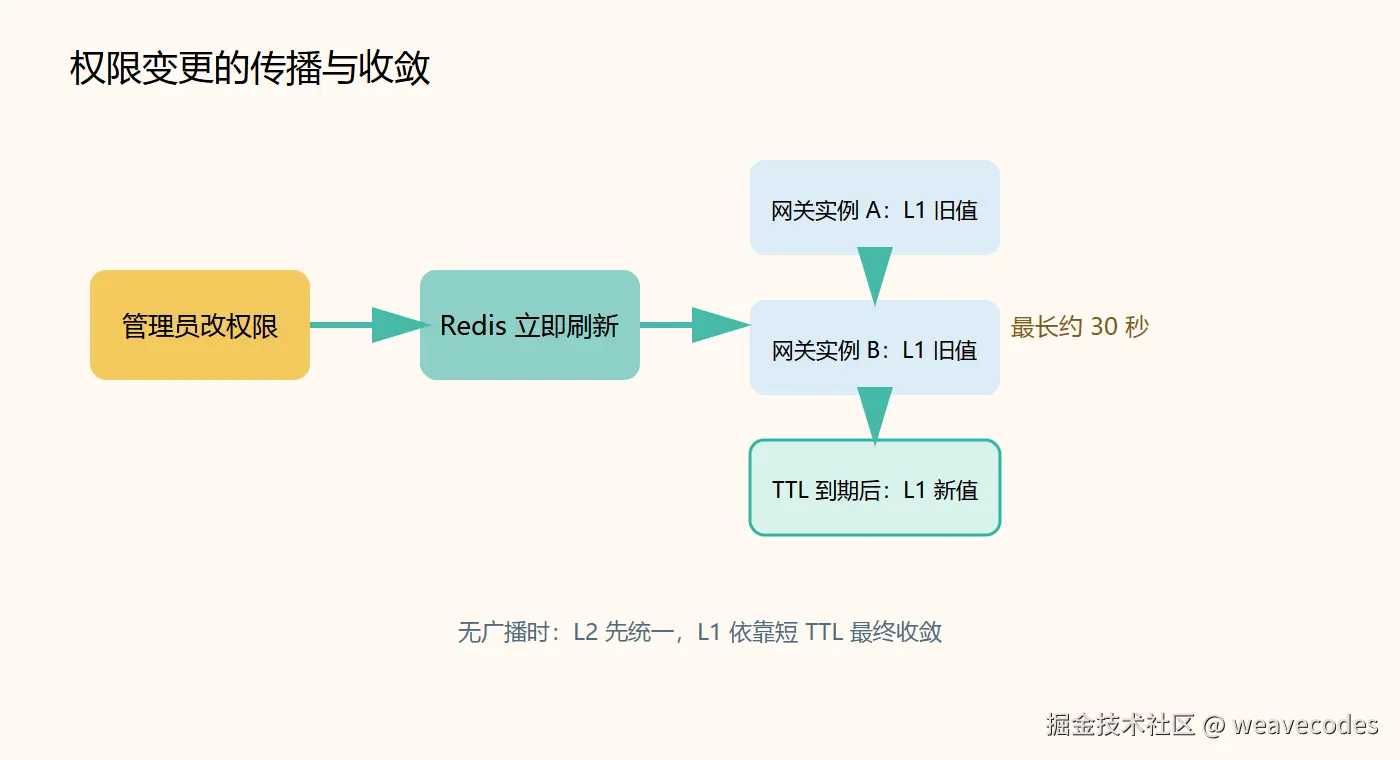
图 2:L2 先统一,L1 通过短 TTL 最终收敛;不同网关实例的生效时刻可能不同。
这种方案没有广播消息,也没有让每个网关实例订阅 Redis Pub/Sub。它用较低的架构复杂度换取了一个明确的时间窗口:在没有额外强制失效机制时,权限变更可能在本地缓存 TTL 内继续沿用旧值。
这对权限收紧尤其重要。若业务要求"管理员点击保存后立即阻断访问",30 秒最终一致性就不够,需要增加主动失效或版本校验,例如:
- 通过消息广播让所有网关实例删除指定用户的 L1 条目。
- 在 Redis 保存权限版本,网关请求同时校验本地版本是否过期。
- 对高风险接口在关键操作前执行一次更严格的中心化校验。
三种方式都会增加网络、消息或实现复杂度,应按风险等级选择,而不能把短 TTL 直接当作安全边界。
四、缓存异常时,鉴权应该如何处理
双层缓存带来性能收益,也带来故障分支。至少要明确以下情况:
| 故障场景 | 需要明确的行为 | 原因 |
|---|---|---|
| Redis 暂时不可用,L1 有值 | 是否允许使用未过期的本地权限 | 保证短时可用,但要记录告警 |
| Redis 不可用,L1 无值 | 默认拒绝还是进入降级白名单 | 不能静默放行未知权限 |
| 数据库不可用,Redis 有值 | 使用 Redis 旧值并监控 | 避免把短时数据库故障放大到网关 |
| 权限列表为空 | 代表无权限还是加载失败 | 两者必须区分,避免错误放行 |
鉴权场景通常应优先保证"不误放行"。因此,缓存加载失败、数据格式异常和权限列表无法确认时,默认拒绝高风险接口,并将原因、用户标识和缓存键写入可检索日志;不要把异常统一转成空列表后悄悄继续。
五、在线计数为什么不能直接套用双层缓存
权限列表属于"读多写少"的用户维度数据;在线人数和在线请求属于"多实例共同写入"的全局指标。两者的一致性要求不同。
原稿中的 CacheCount 使用 Redisson RSetCache 保存全局计数:
| 计数键 | 用途 |
|---|---|
online:user:exam |
考试在线人数 |
online:user:study |
学习在线人数 |
online:user |
平台在线用户 |
online:request |
在线请求 |
多个网关实例如果各自维护一份本地在线人数,最终得到的只是多个局部视图,无法直接相加得到可靠的全局结果。因此计数数据直接走 Redis;本地的 ConcurrentHashMap 只负责节流,例如使用 ONLINE_USER_THROTTLE_MS = 5 分钟,减少重复刷新。
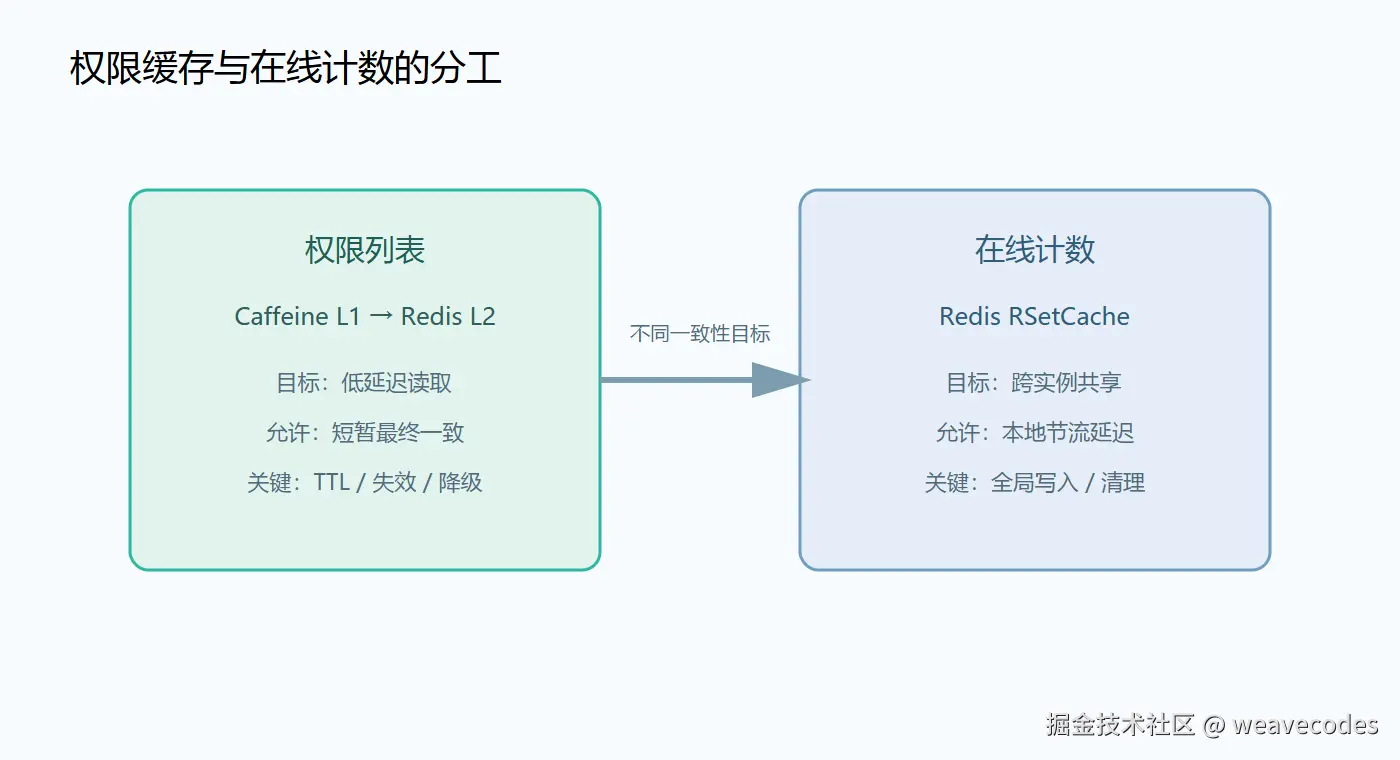
图 3:权限读取可以接受短暂的本地旧值;全局计数必须把写入汇聚到共享存储。
两类数据的边界可以这样记:
| 数据 | 存储路径 | 一致性目标 | 典型处理 |
|---|---|---|---|
| 用户权限列表 | Caffeine + Redis | 短时间内最终一致 | L1 命中优先,L2 回填 |
| 在线用户 / 在线请求 | Redis RSetCache |
跨实例共享 | Redis 统一计数,本地节流 |
六、三种方案对比:双层缓存的收益和代价
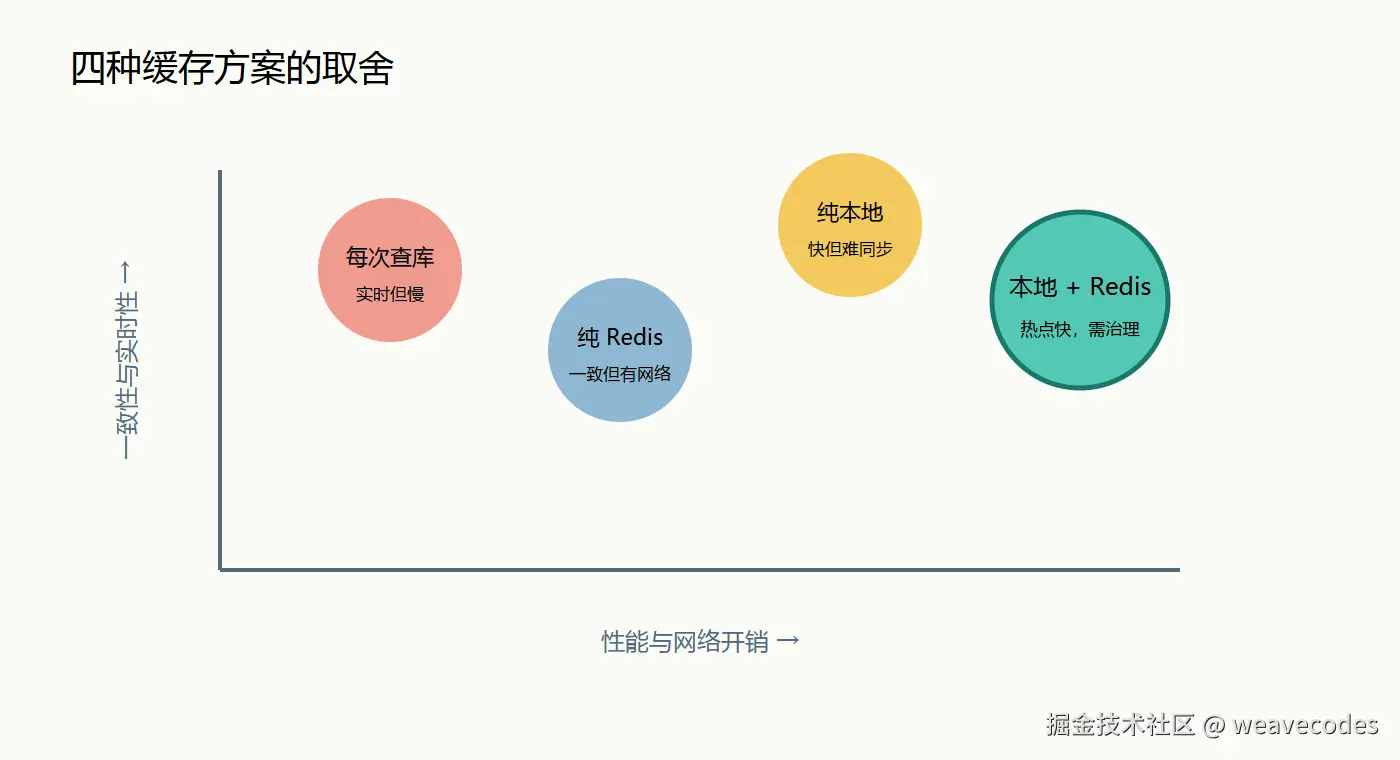
图 4:双层缓存把鉴权热点请求留在本地,但必须接受失效传播和故障降级的复杂度。
| 方案 | 优点 | 代价 |
|---|---|---|
| 每次查库 | 数据最实时 | 数据库压力随请求量增长 |
| 纯 Redis | 多实例读取一致、变更快 | 每次鉴权增加网络往返 |
| 纯本地缓存 | 延迟最低 | 多实例难同步,变更窗口不可控 |
| 本地 + Redis | 热点请求零网络,未命中才访问 L2 | 需要处理 TTL、失效、降级和内存上限 |
网关处在所有业务请求的入口,鉴权优化会被流量放大。双层缓存的收益很明确,但不能只看命中率,还要同时观察权限变更延迟、Redis 命中率、本地缓存大小和鉴权失败率。
七、落地检查清单
缓存键和数据
- 权限键是否包含用户或权限版本,是否能避免串用户?
- 空权限、加载失败和无权限是否使用不同状态表达?
- Redis 权限列表是否设置容量、过期和淘汰策略?
实时性和安全
- 30 秒是否符合权限收紧场景的风险要求?
- 高风险接口是否需要主动失效或实时版本校验?
- 权限变更后,所有网关实例是否最终都会读取到新值?
稳定性和观测
- 是否记录 L1 命中率、L2 命中率、数据库回源次数和加载耗时?
- Redis 故障时是否有明确的拒绝或降级策略?
maximumSize(500)是否按实例监控,而不是误认为全局容量?
在线计数
- 跨实例计数是否始终写入共享存储?
- 本地节流是否可能导致指标延迟,仪表盘是否能接受?
- 用户下线、过期和异常断连是否有清理机制?
总结
织码在线教育系统的缓存设计由两条思路组成:
- 权限读取走双层缓存:Caffeine 承担热点请求,Redis 提供跨实例共享,数据库只承担少量回源;本地 TTL 控制最终一致性的时间窗口。
- 权限变更先更新 L2:Redis 立即获得新值,L1 通过自然过期收敛;若业务需要零延迟收紧权限,就要增加广播失效或版本校验。
- 在线计数单独走共享存储 :
CacheCount使用 RedissonRSetCache汇聚多实例数据,本地只做节流,不把全局指标拆成多个本地副本。
缓存层级的选择,本质上是延迟、一致性和复杂度之间的取舍。把这三个指标和业务风险一起写进设计,双层缓存才能既快又可控。