一次线上CPU 100%的问题排查
凌晨 2 点 14 分,监控告警:订单服务 CPU 使用率 100%,接口 RT 从 50ms 飙到 3s。 这篇文章复盘一次完整的排查过程------从监控大盘到一行代码,每一步用过的命令、判过的证据、踩过的坑,全部展开。
0. 告警来了:先立骨架,再敲命令
新手拿到 CPU 告警的第一反应是敲 top;老手的第一个动作是建立动作框架。因为排查不是命令的堆叠,而是一连串"下一步做什么"的决策。没有骨架,你就会在命令输出里迷失。
本次排查全程按六步骨架推进:
| 步骤 | 动作 | 回答的问题 |
|---|---|---|
| 1 | 确认现象 | 真的 100% 吗?影响面多大? |
| 2 | 止血 | 影响在扩大吗?要不要先摘流量/限流? |
| 3 | 保留现场 | 重启前,证据留了吗? |
| 4 | 分层定位 | 监控侧 → 机器侧 → 代码行,逐层收敛 |
| 5 | 恢复验证 | 修复后指标回去了吗? |
| 6 | 复盘 | 为什么发生?为什么没拦住? |
后面的所有内容,都是第 4 步"分层定位"的展开。分层是这篇文章的核心思想:
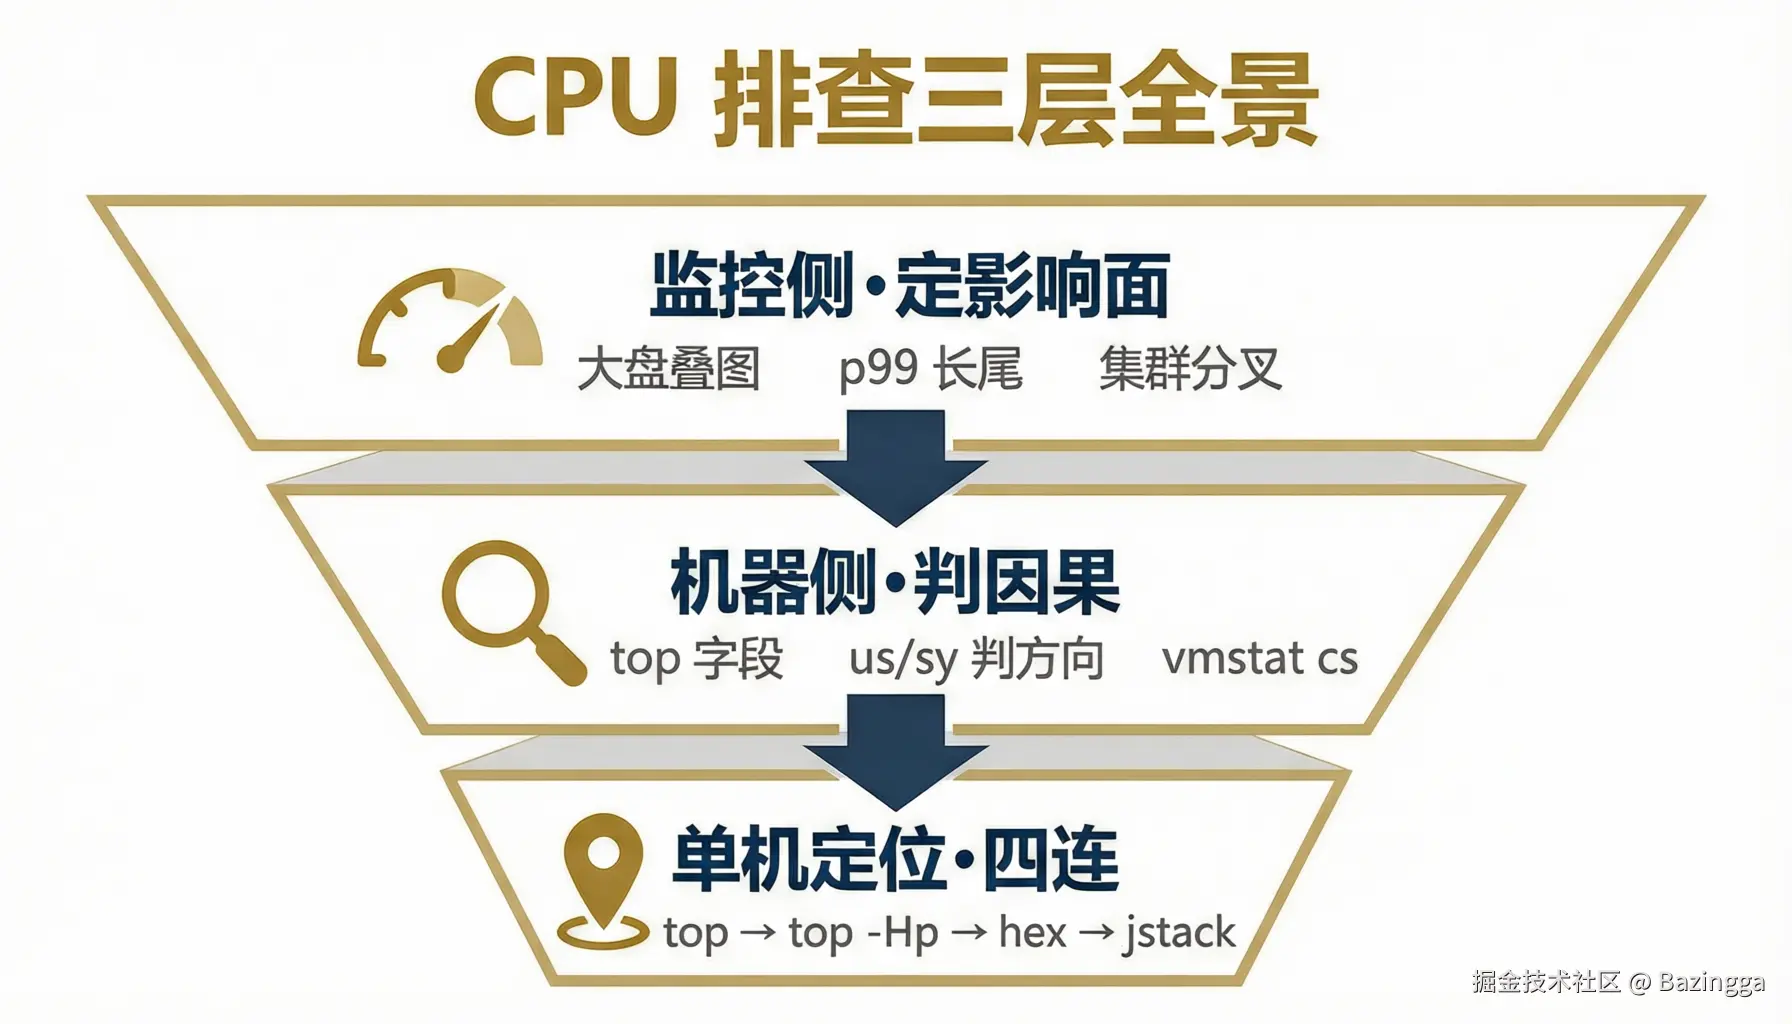
第一层(监控侧)回答"问题在哪台机器"------横向收敛;第二层(机器侧)回答"CPU 花在哪了"------判明因果;第三层(四连)回答"哪一行代码在烧 CPU"------纵向定位。 每层都有专属的工具和判据,层与层之间不能跳------跳过横向直接抓纵向,在几十台机器上就是大海捞针。
1. 第一层·监控侧:先定影响面,不上机器
1.1 为什么第一件事是看大盘,而不是 SSH 上机器
因为同一个告警,根因分布完全不同:
- 只有 1 台机器 CPU 高 → 问题藏在这台机器的局部状态里(某个特殊请求、本地缓存、本机资源争抢)
- 8 台机器全部飙高 → 问题一定在大家的共性里(代码、配置、公共依赖、流量入口)------8 台机器的局部状态不可能同时巧合异常
所以第一步:把监控大盘里所有实例的 CPU 曲线叠在同一张图上,回答一个三岔问题。
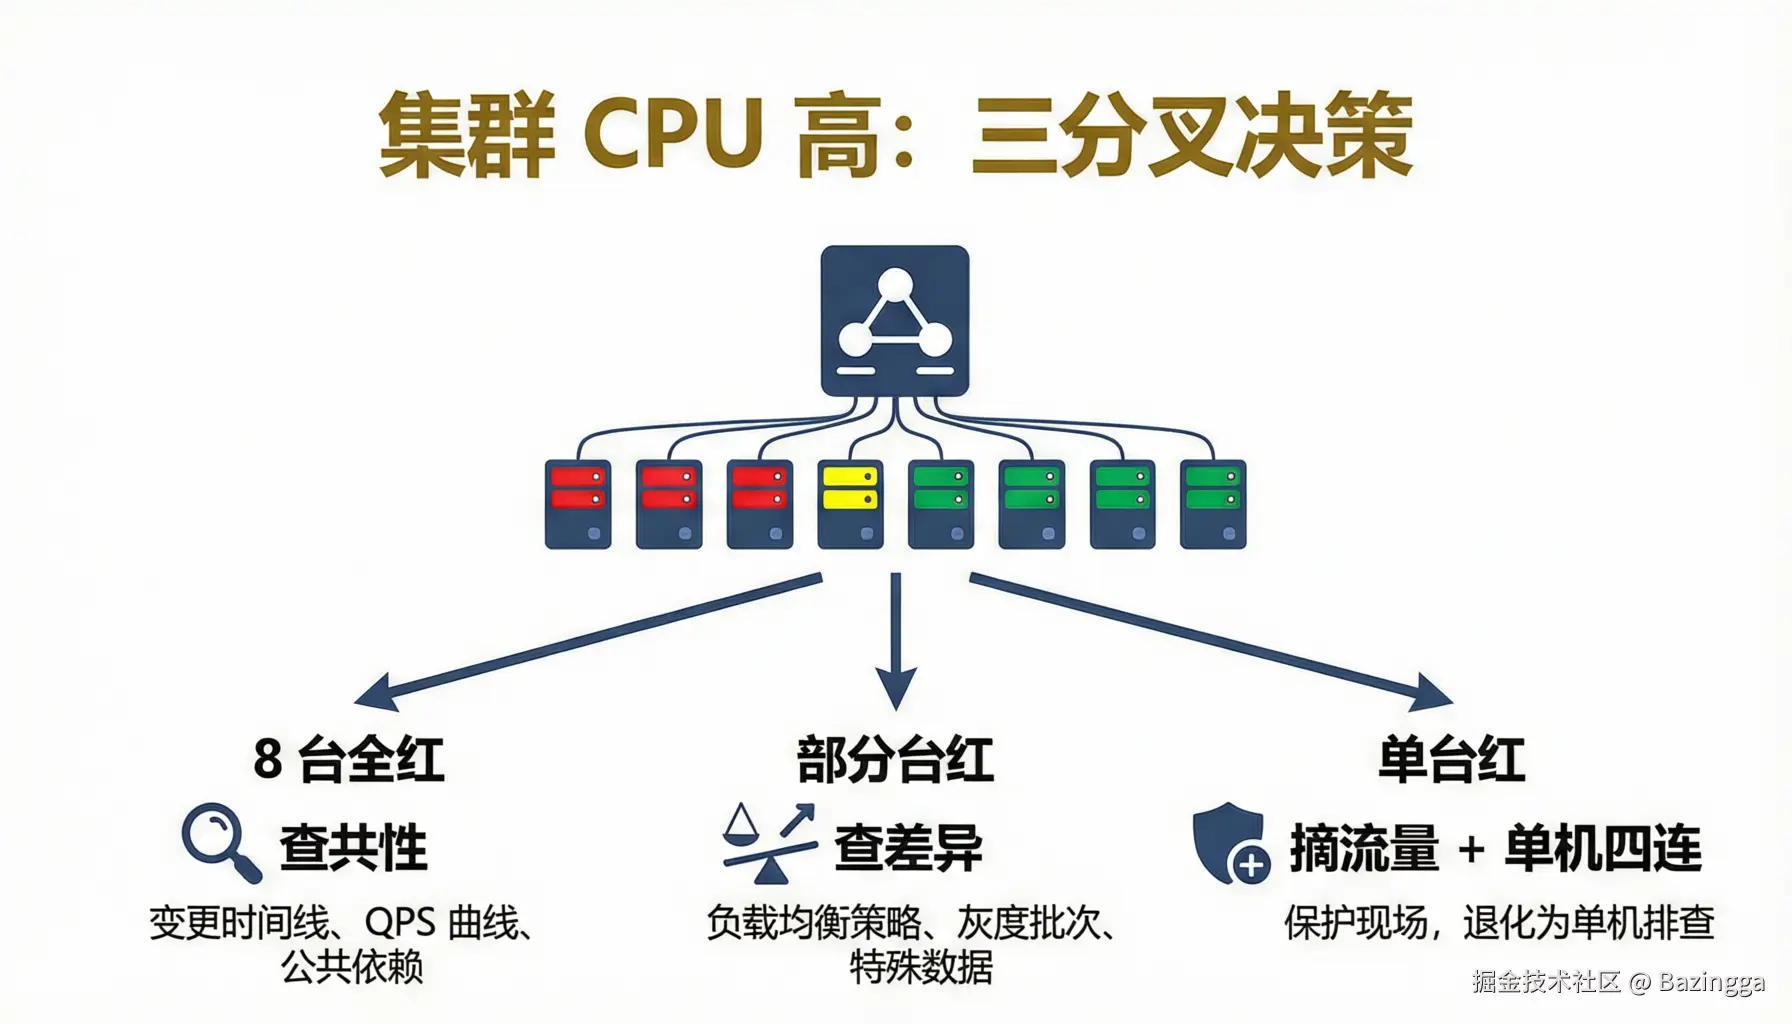
1.2 分叉一:8 台全高 → 查共性,三件套按顺序
第一件:变更时间线对齐。 CPU 起涨点是否和某次发布、配置推送、流量开关对齐?对齐 → 回滚优先,不在线上查根因------先把系统恢复到变更前,离线再查为什么。这条对应六步骨架里的"止血"。
第二件:QPS vs CPU 曲线对齐。 这是两个容易混淆的因果:
- QPS 平稳,CPU 涨 → 单位请求变贵了(代码热点、GC、依赖变慢)
- QPS 和 CPU 同步涨 → 容量问题,扩容买时间,再回头优化
第三件:公共依赖体检。 8 台机器共享的只有四样东西:代码、配置、公共依赖(缓存/DB/下游服务)、流量入口。依次查:缓存命中率是否跳水(击穿穿透到 DB)、下游服务是否变慢占满线程池、数据库是否有慢 SQL 拖住连接池。
1.3 分叉二:部分台高 → 查实例间差异
3/8 台高,问题不在共性,而在这几台的差异:
- 负载均衡策略:粘性会话(sticky session)、长连接复用、hash 不均,都可能把热点流量钉死在某几台
- 灰度批次:是不是刚好灰度到第 3 批的那几台?
- 数据形态:这几台是否恰好处理到特殊数据(大客户、大批次)
1.4 分叉三:单台高 → 摘流量,退化为单机排查
这是本文案例的走向:只有一台订单服务 CPU 飙高。处理分两步:
第一步,摘流量 ------从负载均衡把这台实例摘除,请求切到其余机器。摘流的意义不是"修好了",而是把现场保护起来:业务恢复正常的同时,这台机器的状态被冻结,你可以慢慢查,不必在"业务继续恶化"和"保留现场"之间二选一。
第二步,留监控侧旁证再上机器。 重点看接口 RT 的分位值:
avg 平稳 + p99 飙高 = 周期性短停顿(GC STW 的典型形态)
avg 和 p99 同步涨 = 常态性变慢(CPU 被抢 / 线程池排队)这个判据的价值在于:不用上机器就能预判一半方向。p99 长尾说明有"间歇性卡顿",而在 Java 世界里,最经典的间歇性卡顿制造者就是 GC 停顿(STW,Stop The World)。带着这个假设上机器,比空手上机器效率高一个量级。
1.5 补一句:APM 先行
生产环境第一手其实不是 top,而是 APM(Application Performance Management,应用性能管理)。它以 Metrics(指标)、Tracing(链路)、Logging(日志)三大支柱,把"单机视角"拉高到"全链路视角":慢调用聚类可能直接告诉你热点在哪个方法,每台实例的 CPU 曲线都在界面上。
四连(后面第 3 章)是 APM 缺位或给不出结论时的第二手------当 APM 只能告诉你"这台机器 CPU 高"却说不清"为什么高"时,才轮到上机器。
2. 第二层·机器侧:top 全景侦察与因果辨析
监控侧确认:单台机器问题。SSH 上机器,第一个命令永远是 top。
2.1 top 一行一行读:每个字段都是证据
这是当时抓到的真实画面(数据已脱敏,进程名做了处理):
perl
top - 14:20:31 up 545 days, 11:04,  2 users,  load average: 2.74, 2.80, 2.57
Tasks: 1359 total,   1 running, 1357 sleeping,   0 stopped,   1 zombie
Cpu(s): 26.4%us,  0.9%sy,  0.0%ni, 72.6%id,  0.2%wa,  0.0%hi,  0.0%si,  0.0%st

  PID USER      PR  NI  VIRT   RES   SHR S %CPU %MEM    TIME+     COMMAND
 9501 admin     20   0 38.6g  5.0g  16m S 1424.9  2.0  910502:37  java
59740 admin     20   0 16.3g  7.9g  20m S  218.2  3.1  51317:13   java
 6944 admin     20   0 11.2g 17.6g  18m S   32.9  7.0  38814:22   java
第一行 load average:系统层面的"拥堵指数"。
| 术语 | 含义 |
|---|---|
| load average | 1/5/15 分钟平均的可运行 + 不可中断任务数 |
读法不是"超过核数就危险",而是看趋势:三个数依次递减 = 压力在消退;依次递增 = 压力在累积;长时间维持高位 = 常态过载。本例是台 64 核机器,load 2.74 意味着系统整体非常空闲------这个"矛盾"后面有大用。
第二行 Cpu(s):CPU 时间的八种去向。
| 字段 | 全称 | 含义 | 排查价值 |
|---|---|---|---|
| us | user | 用户态执行代码 | 业务逻辑、JVM 执行字节码都在这里 |
| sy | system | 内核态干活 | 系统调用、线程调度切换、锁 |
| ni | nice | 低优先级进程 | 谁动了进程优先级 |
| id | idle | 空闲 | 系统整体忙不忙的基准 |
| wa | iowait | 等待磁盘 IO | 磁盘瓶颈信号 |
| hi/si | 硬/软中断 | 网卡等硬件中断 | 网络风暴、中断不均衡 |
| st | steal | 被宿主机抢走 | 虚拟化环境邻居抢占 |
注意 %CPU 的刻度:100% = 一个核。进程 1424.9% = 烧满约 14 个核。
第三块进程表的关键列:
| 列 | 含义 |
|---|---|
| S | 状态:R 运行、S 睡眠、D 不可中断睡眠(IO 中)、Z 僵尸 |
| TIME+ | 累计 CPU 时间------区别于 %CPU 的瞬时值,看增速 |
| RES | 实际驻留内存(排除 swap 后真正在物理内存里的量) |
2.2 "极端"是相对基线,不是绝对数字
判断 us 26.4% 高不高,不能查字典,要对照这台机器的历史基线 :这台机器常年 us 在 20-30% 徘徊(因为业务进程平时就占 200%),所以 26.4% 本身不算异常。真正异常的是占比结构:
bash
系统 id 72.6%(整体空闲)+ 单进程 1424.9% ÷ 64 核 ≈ 全机 22% 算力结论:系统不忙,但单一进程异常突出------问题收敛到 PID 9501 内部。 系统行的 us/sy 分布此时没有判别力,因为系统 us 的大头就是 9501 贡献的。
2.3 因果辨析:CPU 高和接口慢,谁是因谁是果
题目有两个现象:"CPU 100%"和"接口变慢"。它们不是并列关系------谁是因谁是果,决定你查哪个方向。判据不是单一字段,而是"CPU 去向 + 线程状态"的组合:
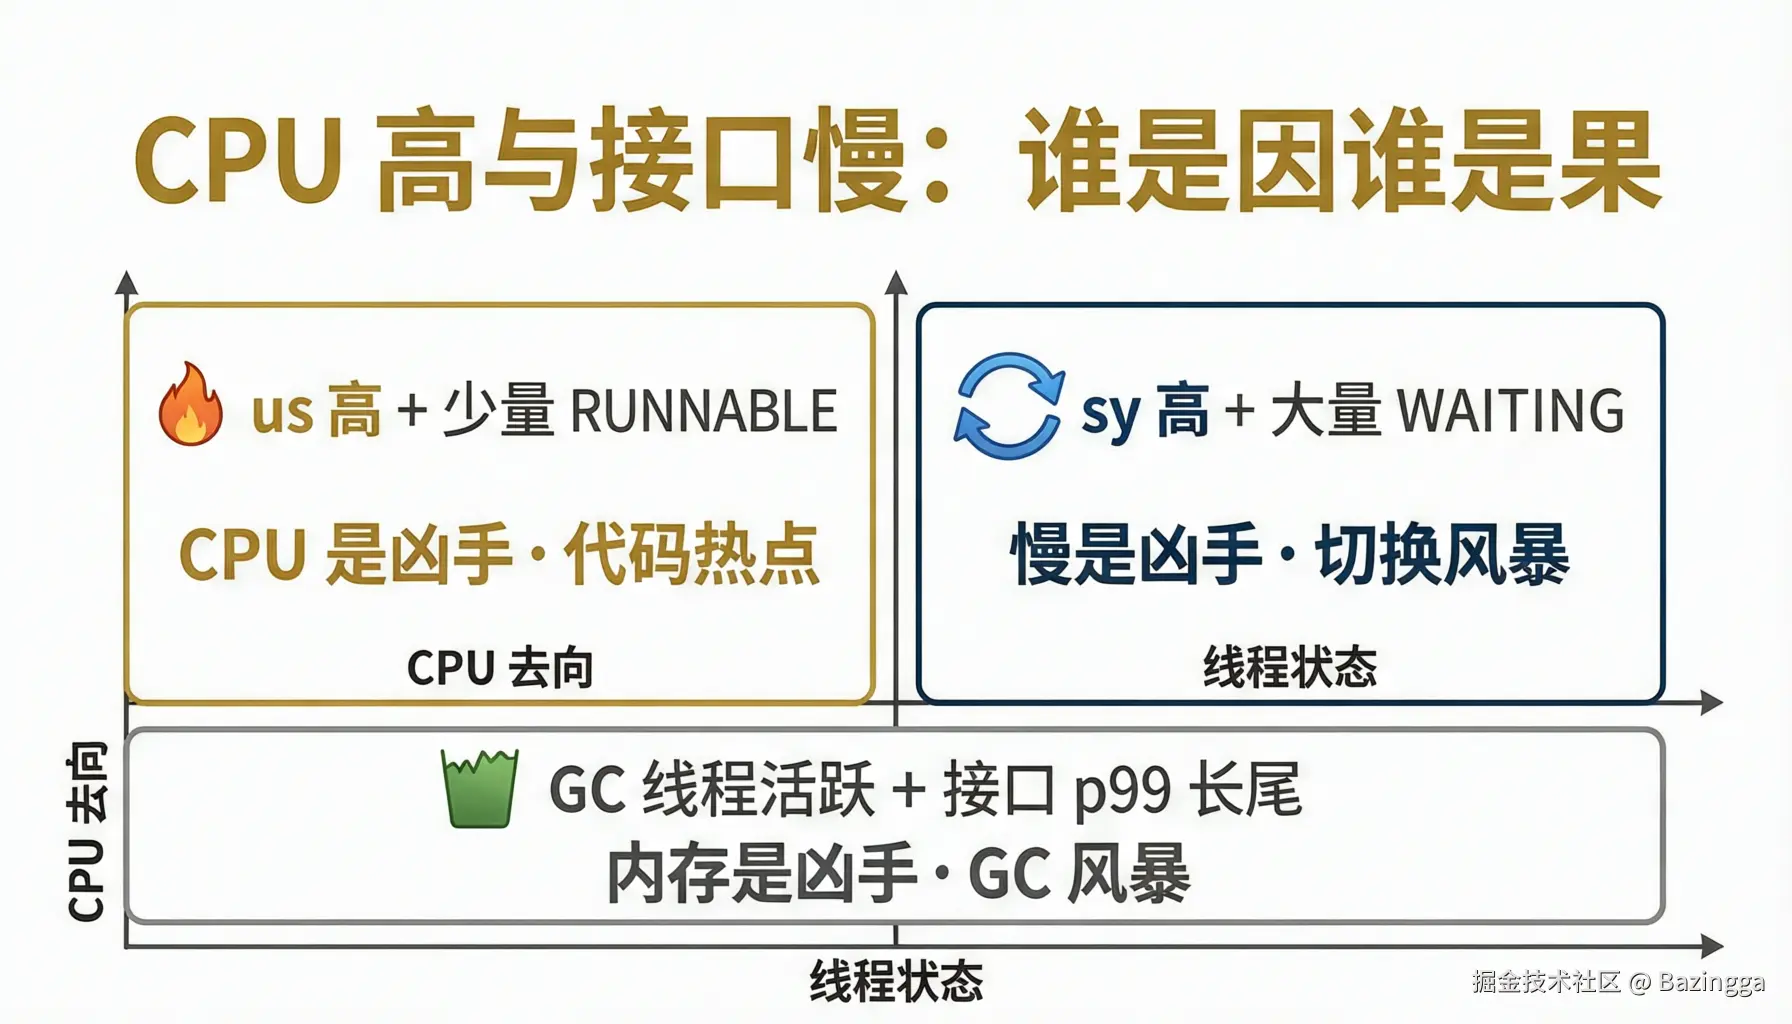
- CPU 是凶手:us 高 + 少量线程 RUNNABLE 猛算 → 死循环/热点代码吃光 CPU,接口慢是被抢资源。查四连(第 3 章)。
- 慢是凶手:sy 高 + 大量线程 WAITING + 线程总数异常多 → 接口慢导致请求堆积,堆积导致线程疯狂唤醒切换,CPU 全花在内核的切换上。验证命令:
bash
vmstat 1        # 看 cs(每秒上下文切换数)
# 正常机器 cs 在几千到几万;几十万上百万 = 切换风暴实锤- 内存是凶手:GC 线程活跃 + 接口 p99 长尾 → CPU 和接口慢都是表象,转 GC 排查(第 4 章)。
为什么"慢是凶手"会烧 CPU?完整机制链:
接口慢(DB/下游慢)→ 请求堆积 → 线程池占满 → 新请求排队
→ 大量线程阻塞在 IO 上(WAITING)→ IO 完成时线程被唤醒 → 内核上下文切换
→ 线程越多,唤醒切换越频繁 → sy 飙升一句话:慢不会直接烧 CPU,是慢引发的堆积和切换在烧 CPU。
2.4 本案的关键判读:三个数字的互相矛盾
回到 2.1 的截图,把三组数字对齐看:
| 指标 | 值 | 含义 |
|---|---|---|
| 9501 的 %CPU | 1424.9% | 瞬时采样:约 14 个核满负荷 |
| load average | 2.74 | 过去 1 分钟平均只有 ~3 个任务在等 CPU |
| Tasks running | 1 | 抓屏瞬间只有 1 个任务在运行态 |
瞬时 14 核、平均 3 个、瞬间 1 个------三个数字互相矛盾。 唯一的解释:这个进程的 CPU 是脉冲式的------爆发一阵,回落一阵。而稳定死循环(业务热点)会让三个数字都持续很高。
脉冲式消耗的典型来源:CMS 垃圾收集器的并发收集周期------并发标记阶段 GC 线程群起烧 CPU,周期结束回落。定时任务也是这个形态,但订单服务没有整点任务。带着"疑似 GC 周期性爆发"的假设,进入第三层。
2.5 顺手做排除法:hi/si/st
看到 us 不高但整体 100% 时,先排除三种"不是自己代码的事":
| 字段 | 高说明什么 | 动作 |
|---|---|---|
| hi/si | 网卡中断风暴(大流量、多队列不均衡) | 查流量来源、irqbalance 均衡 |
| st | 虚拟机被宿主机邻居抢占 | 找运维迁移,不是代码问题 |
| ni | 低优先级进程被 nice 抬高 | 查谁动了优先级 |
本例三者均为 0.0,排除干净。
3. 第三层·单机定位四连:从进程到代码行
机器侧收敛到 PID 9501 之后,进入纵向定位。这一层是 Java 排查最经典的操作,四步一条链:
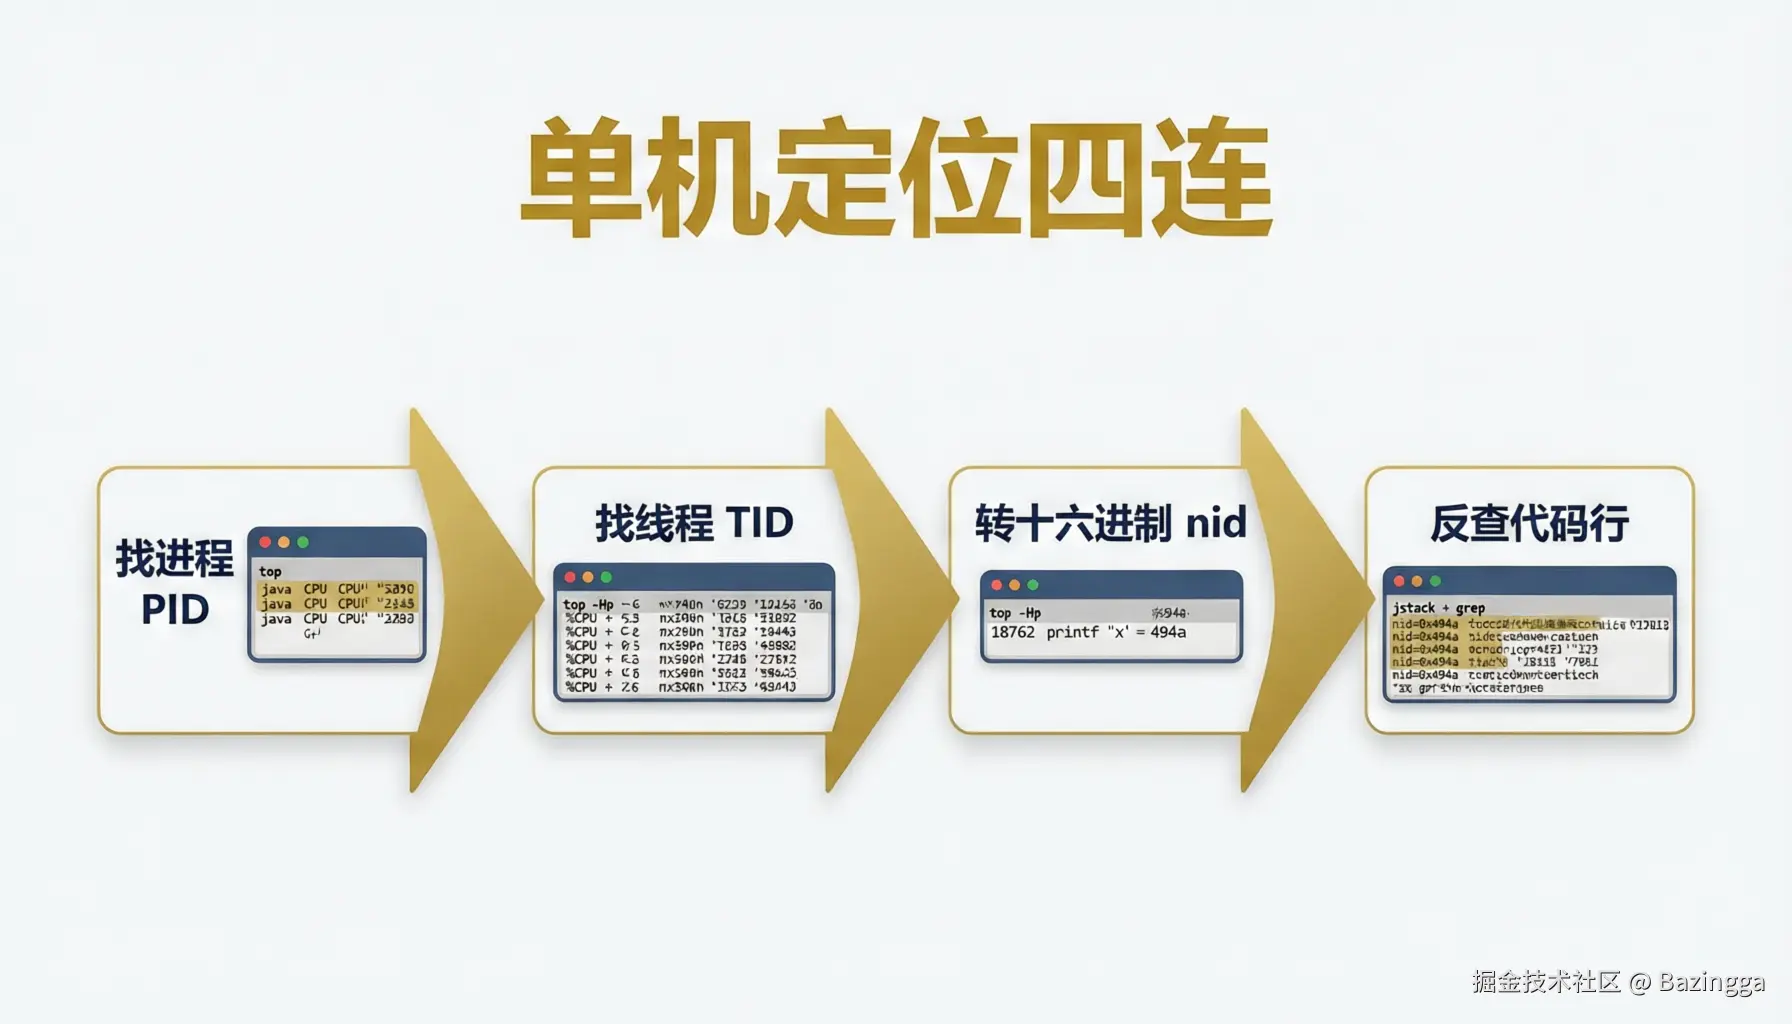
3.1 第一连:top 找进程
系统行已经告诉我们 java 进程 9501 在吃 CPU,但脚本化排查时更推荐 ps:
bash
ps -eo pid,pcpu,args --sort=-pcpu | head
# 按 CPU 降序排列,输出不受终端窗口行数限制小知识:top -b 批处理模式默认受窗口行数限制,可能不显示目标进程------脚本化采样 ps 优于 top。
3.2 第二连:top -Hp 找线程
top 按进程聚合,top -H 按线程展开:
bash
top -Hp 9501
# 按 %CPU 降序,最烧 CPU 的线程排在最上面
两个实战细节:
细节一:%CPU 是采样值,会抖动。 它是两次刷新间的差值,有噪声。更稳的证据是 TIME+ 增速:连续观察 10 秒,累计 CPU 时间涨得最快的线程才是真热点。
细节二:Java 线程名不一定会显示。 老版本 JDK 下线程的 COMMAND 列可能全部显示为 java(自定义线程名没有落到操作系统层)。此时不要慌,继续走第三、四连,线程身份最终在 jstack 里揭晓。
本例 top -Hp 9501 的输出里,%CPU 最高的几个线程名字赫然写着:
yaml
  TID  USER   %CPU  COMMAND
 9583  admin  21.3  java          # 这个 21.3% 只是采样瞬间,看多个线程的聚合
 9576  admin  21.1  java
 ...
3.3 第三连:printf '%x' 转十六进制
拿到线程号(TID)之后,做一件看起来很奇怪的事------转成十六进制:
bash
printf '%x\n' 9583
# 输出: 256f
为什么必须转? 因为同一个线程在两层视角下有两个编号:
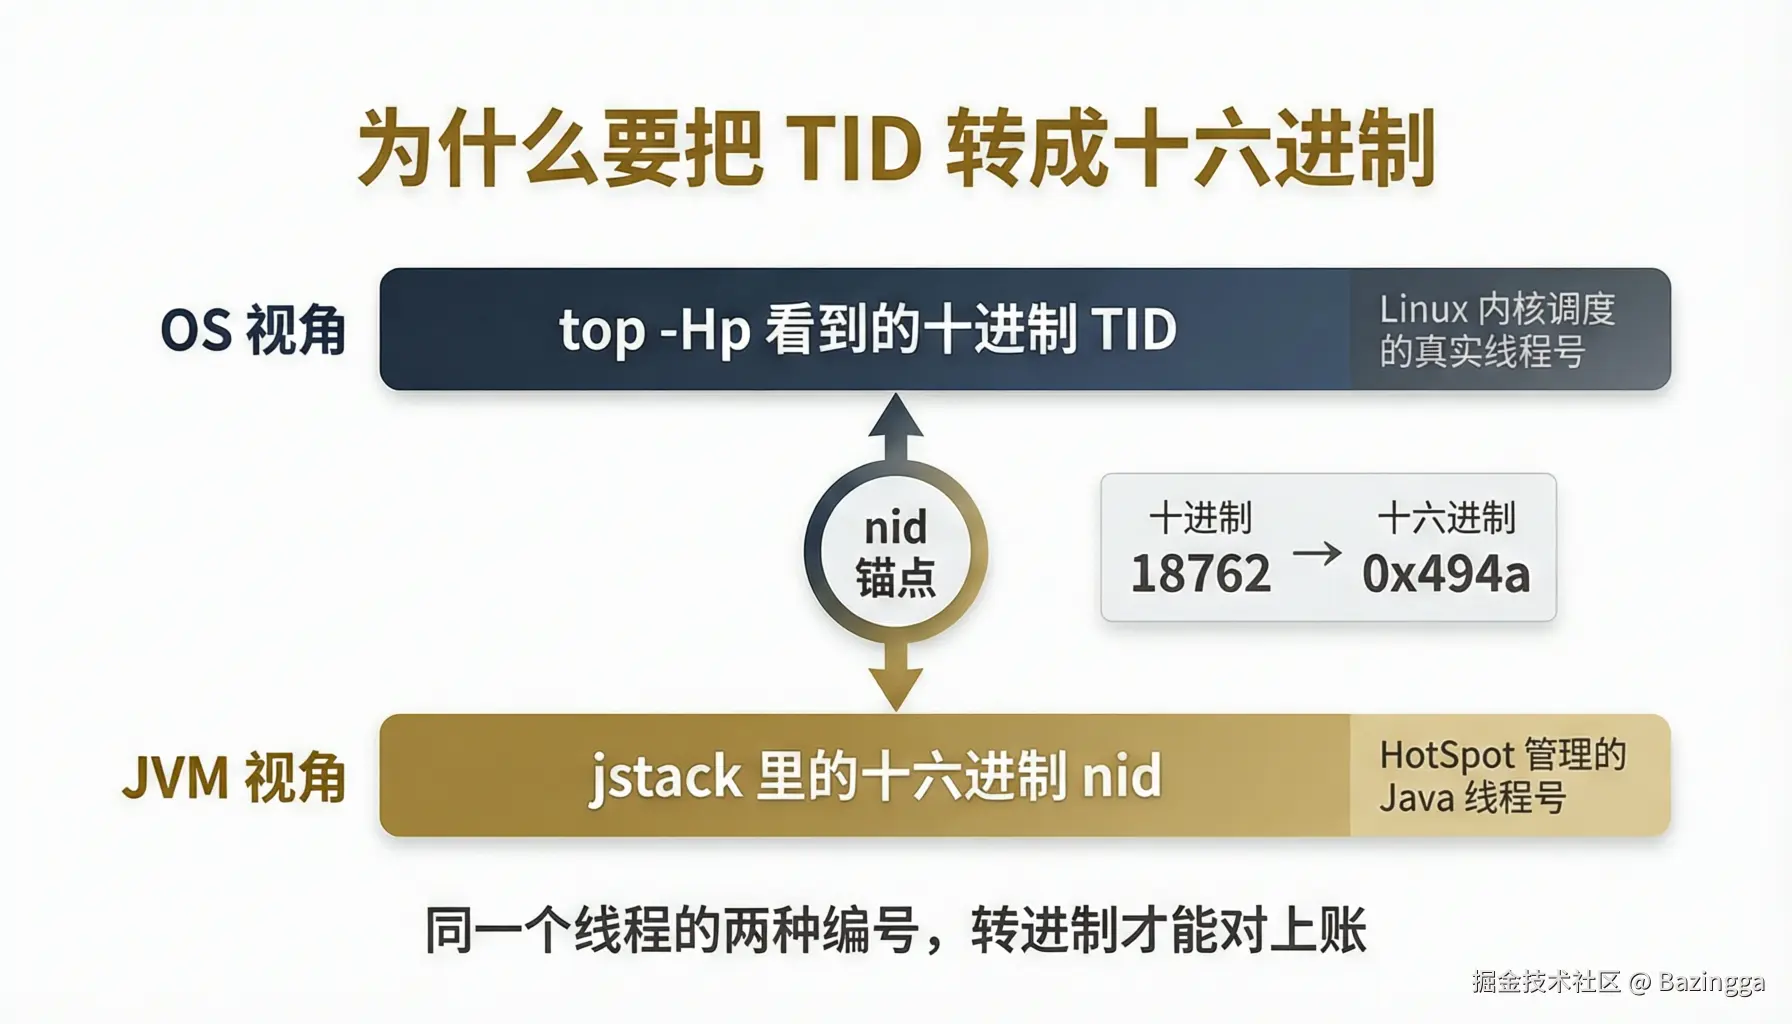
top -Hp给你的是 OS 视角的线程号:Linux 内核调度的真实线程,十进制jstack输出里写的是 JVM 视角 的线程号nid(Native thread ID):同一个线程,十六进制
一个 Java 线程是两层结构:OS 线程是内核调度的实体,JVM 线程是 HotSpot 管理的逻辑单元,nid 就是两层之间的对接锚点。十进制转十六进制这一步,就是让"OS 视角的热点线程"和"JVM 视角的代码栈"对上账。 如果两者没有这个同一性,这套方法就不存在。
3.4 第四连:jstack 反查代码行
bash
# 先落盘,再检索(终端回滚缓冲会截断几万行的输出)
sudo -u admin /opt/java/bin/jstack 9501 > /tmp/stack_9501.log 2>&1

# 用十六进制 nid 精确反查(带前缀,避免地址串误命中)
grep -A 30 'nid=0x256f' /tmp/stack_9501.log落盘三板斧(jstack 输出动辄几万行):
| 板斧 | 命令 | 用途 |
|---|---|---|
| 落盘 | jstack pid > file.log |
终端不刷屏 + 现场留证 |
| 检索 | grep -A 30 'nid=0x...' file.log |
只输出目标线程的栈,几十行 |
| 归类 | `grep 'java.lang.Thread.State' file.log | sort |
为什么不直接 grep '256f'?因为 jstack 输出里全是十六进制------栈帧地址、锁对象地址都可能是 ...256f...。带 nid=0x 前缀的精确匹配,只可能命中线程头一种行。
本案的 grep 结果------真凶第一次露出真容:
arduino
"Gang worker#10 (Parallel CMS Threads)" os_prio=0 tid=0x00007f974c368800 nid=0x256f runnable
"Gang worker#4  (Parallel CMS Threads)" os_prio=0 tid=0x00007f974c327800 nid=0x2568 runnable
3.5 实战插曲:jstack 报错 "Unable to open socket file"
第一次执行 jstack 时,遇到了一个经典的坑:
perl
[root@cainiao ~]# jstack 9501
9501: Unable to open socket file: target process not responding or HotSpot VM not loaded
The -F option can be used when the target process is not responding
报错文字极具误导性。 进程明明活着(top 里 1424%),"not responding"和"VM not loaded"两条都不成立。真实原因:用户身份不匹配。
jstack 通过 /tmp/.java_pid9501 这个 socket 连接目标 JVM,JVM 端的 Attach Listener 会用 SO_PEERCRED 取连接方的 uid/gid,必须与 JVM 自身一致,root 也不豁免(HotSpot 实现里没有 uid==0 的特判)。而这条报错文案是通用兜底串,把"凭证不匹配"和"进程真无响应"混为一谈。
对照实验就在本案里:root 启动的演练进程,root 的 jstack 一次就通;admin 启动的业务进程,root 的 jstack 必被拒------同一个 jstack、同一台机器,差别只在进程属主。
解法(按优先级):
bash
# 首选:同用户身份执行(凭证匹配,完全无害)
sudo -u admin /opt/java/bin/jstack 9501

# 备选:-F 走 Serviceability Agent 的 ptrace 模式,绕过 socket 校验
# 代价:短暂挂起目标进程(一次微小 STW),且输出缺少锁信息
jstack -F 9501通用经验:attach 类工具(jstack/jmap/arthas)报 "Unable to open socket file" 时,先查进程属主,再谈进程无响应。 排查顺序:
bash
ps -o pid,user,comm -p 9501 # 看 USER 列3.6 抗抖补强:三连拍取交集
jstack 是瞬时快照,抓到的是"拍照那一刻"的栈。如果热点线程不稳定(榜首 TID 一直在换),单次快照就可能扑空。生产惯用手法:
bash
for i in 1 2 3; do
  sudo -u admin /opt/java/bin/jstack 9501 >> /tmp/stack_9501_all.log
  sleep 5
done
# 三次栈里每次都出现的调用链,才是真热点(采样取交集思想)
这同时也是重启前"保留现场"的标准动作(见第 5 章)。火焰图(perf 定期采样聚合)就是把"多次采样取交集"自动化了的升级版工具。
4. 真凶分叉:业务热点还是 GC 风暴
4.1 拿到栈之后的第一眼:线程叫什么名字
第 3 章 grep 到 Gang worker (Parallel CMS Threads)------这是 CMS 收集器的并发 GC 工作线程 ,不是业务代码。这正是 CPU 排查里最容易被漏掉的一类根因:排查者习惯了在业务栈里找热点,看到 GC 线程往往一愣。
两种根因的分叉判据:
| 榜首线程形态 | 结论 | 下一步 |
|---|---|---|
| 业务线程名(如 http-nio-8080-exec-x)RUNNABLE | 业务热点 | 看栈顶方法,结合火焰图 |
| Gang worker / GC Thread / VM Thread | GC 风暴 | 转 jstat + GC 日志,本文路径 |
| 大量 WAITING + sy 高 | 阻塞堆积 | 查线程池/连接池,vmstat cs 实锤 |
4.2 判 GC 活跃的三级证据链
从"怀疑"到"定论",证据按置信度分三级:
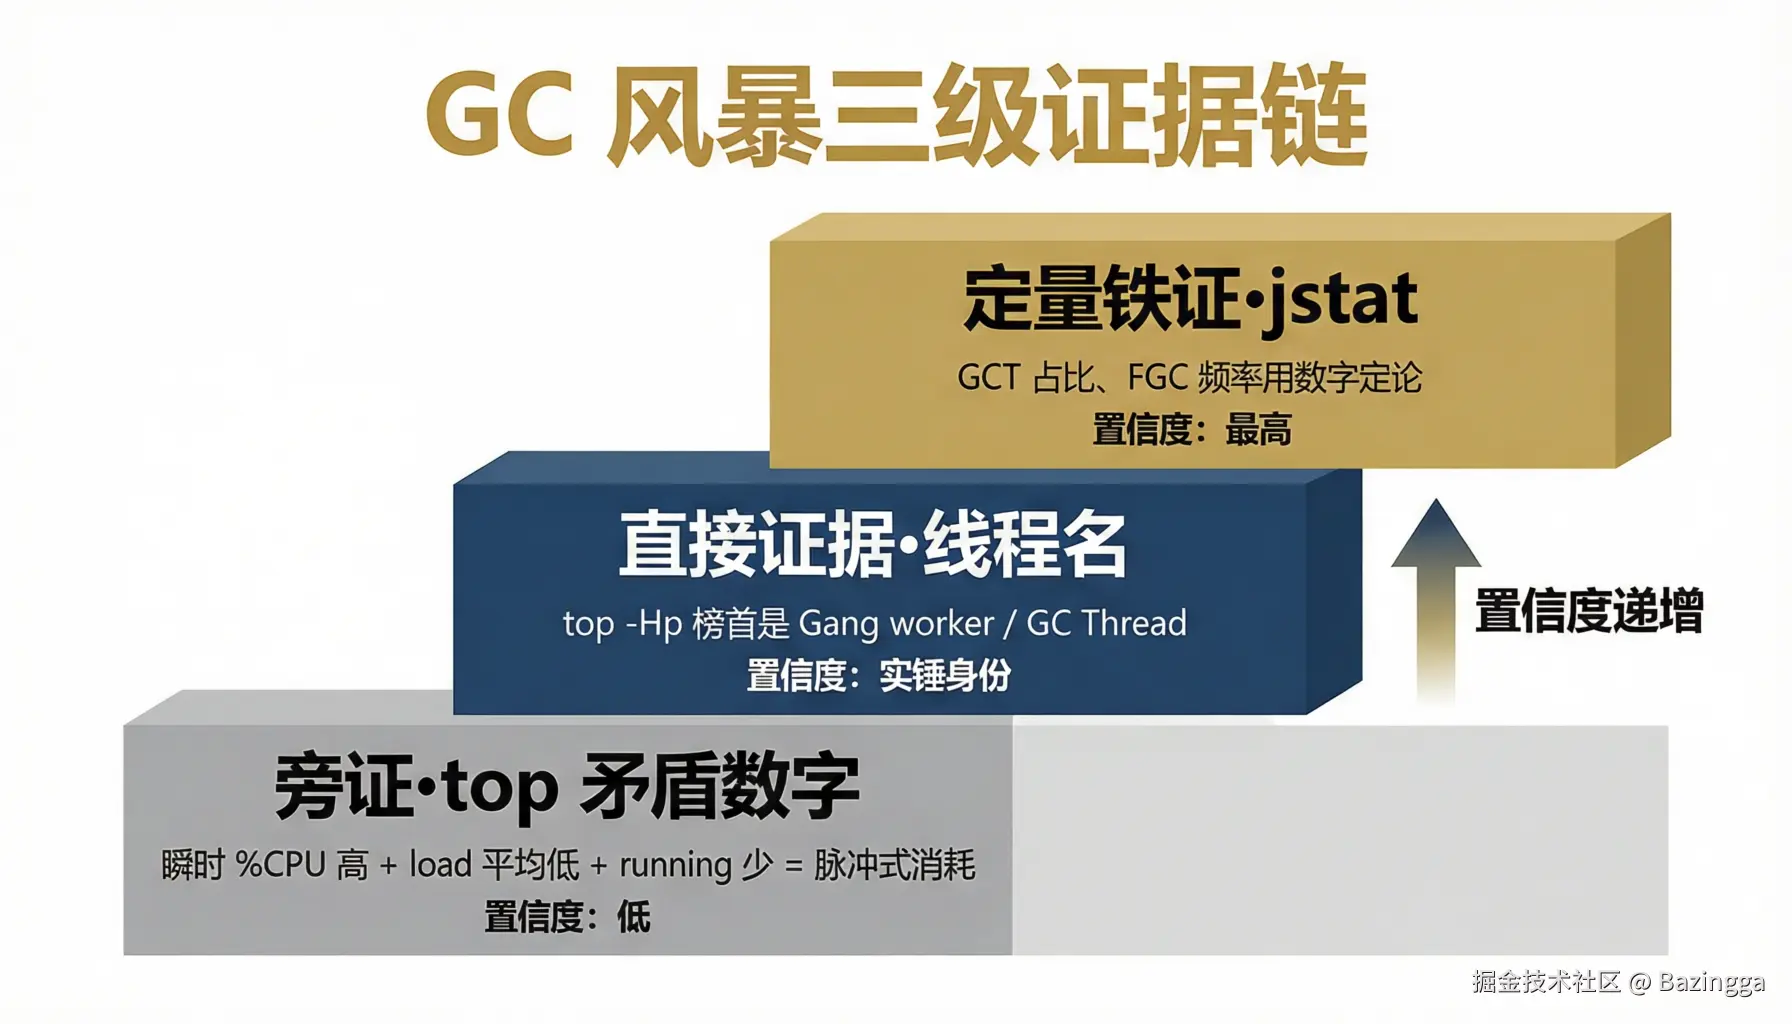
第一级(旁证):2.4 节的三数字矛盾------瞬时 %CPU 高 + load 平均低 + running 少 = 脉冲式消耗。置信度低:定时任务也是这个形态。
第二级(直接证据) :top -Hp 榜首线程名是 Gang worker------top 体系里唯一能直接区分 GC 和业务的地方。置信度高:身份实锤。
第三级(定量铁证):用数字说话:
bash
sudo -u admin /opt/java/bin/jstat -gcutil 9501 1000 5
# 每 1 秒采样一次,共 5 次
输出示例:
yaml
  S0     S1     E      O      M     CCS    YGC     YGCT    FGC    FGCT     GCT
  0.00  62.31  95.32  87.51  96.42  94.71  38421  1521.388  2143  642.851  2164.239
  0.00  61.08  97.85  88.02  96.42  94.71  38453  1522.502  2148  644.212  2166.714
  ...
关键字段判读:
| 字段 | 含义 | 本案判读 |
|---|---|---|
| E | Eden 区使用率 | 95%+ 且反复冲顶 = 对象分配猛烈 |
| O | 老年代使用率 | 88% 且逐秒上升 = 逼近 CMS 触发线 |
| YGC/YGCT | 年轻代 GC 次数/耗时 | 采样间隔内 YGC 疯狂增长 = 分配压力大 |
| FGC/FGCT | Full GC 次数/耗时 | 两次采样间 FGC 增长 = Full GC 正在高频发生 |
| GCT | GC 累计耗时 | 经验参考:GCT ÷ 进程运行时长 > 5% 值得关注,> 20% 基本是 GC 风暴 |
4.3 STW:为什么 GC 风暴会让接口变慢
GC 高消耗的另一个受害者是接口。STW(Stop The World):GC 进行到某些关键步骤时(标记根对象等需要"世界静止"才能安全完成的动作),所有应用线程必须暂停。线程不是被暴力掐断,而是执行到 safepoint(安全点)时主动停下。
一次 Full GC 停顿 1-3 秒,在这 1-3 秒内所有在途请求全部卡住------这就是第 1 章 p99 长尾的完整解释:avg 平稳(大部分请求不受影响)+ p99 飙高(一部分请求恰好撞上停顿窗口)= 周期性 STW。监控侧的伏笔,在这里闭环。
CMS 的陷阱(面试与实战的双料高频点):CMS 号称"并发"收集器,但:
- 初始标记、重新标记(remark)两个阶段仍然 STW
- 老年代碎片化后并发失败,会退化到 Serial Old 的单线程 Full GC------停顿从几十毫秒跳到几秒,CPU 和 RT 同时崩
判停顿来源看 GC 日志的时间戳密度,而不是看收集器的名字:
bash
# 找 Full GC 时间戳密度(本案日志路径在启动参数 -Xloggc 指定)
grep "Full GC" /home/admin/logs/gc.log | tail -20
# 相邻两条时间戳间隔秒级 = 高频 Full GC 实锤
4.4 本案的最终画像
三级证据汇聚,真相完整了:
- 进程脉冲式烧 CPU(瞬时 14 核 / load 均值 3)------CMS 并发周期形态
- top -Hp 榜首全是 Gang worker------GC 线程实锤
- jstat 里老年代 88% 持续逼近触发线,FGC 高频增长------定量铁证
结论:CPU 100% 和接口变慢是同一个根因的两张脸------老年代空间不足引发的 GC 风暴。 业务代码没有死循环,真正的凶手是内存分配压力和 CMS 的并发失败退化。后续优化方向:查老年代增长源(大对象、内存泄漏、缓存无界增长),调整堆配置------但这已经超出本文"排查定位"的范围,属于根因治理的下一篇文章了。
5. 止血、恢复与复盘
5.1 止血决策:影响扩大与影响可控的两条路
定位和止血可以并行,但止血永远优先于定位。分两种情况:
影响在扩大(错误率上升、用户可感知):
- 先摘流量或回滚------如果 30 分钟前刚发布过,第一选择永远是回滚,不在线上查根因
- 无法回滚时:重启是最后的保底手段,但重启前必须完成"保留现场"
影响可控(CPU 高但业务不抖):
- 在线定位,不急于重启
- 定位到根因后小步修复,灰度验证
5.2 重启前的保留现场:三连拍
这是无数事故复盘里最痛的一课:重启之后,证据就没了。重启前必须留三样东西:
bash
# 1. 线程栈三连拍(间隔 5 秒,对比栈是否卡在同一点)
for i in 1 2 3; do
  sudo -u admin /opt/java/bin/jstack 9501 >> /tmp/stack_before_restart.log
  sleep 5
done

# 2. GC 快照与日志
sudo -u admin /opt/java/bin/jstat -gcutil 9501 1000 3 > /tmp/gc_before_restart.txt
cp /home/admin/logs/gc.log /tmp/gc_before_restart.log

# 3. 堆转储(内存相关问题时必留,文件较大需确认磁盘空间)
sudo -u admin /opt/java/bin/jmap -dump:live,format=b,file=/tmp/heap_before_restart.hprof 9501
三样东西对应三种可能的根因方向:线程栈(CPU/死锁)、GC 数据(内存压力)、堆转储(对象分析)。宁可多留,不可缺一门。
5.3 恢复验证:用指标说话
修复动作完成后,按同一套指标验证:
| 验证项 | 命令/来源 | 回到正常的判据 |
|---|---|---|
| CPU | top |
进程 %CPU 回落到历史基线 |
| 接口 RT | 监控大盘 | avg 与 p99 同时回落,长尾消失 |
| GC 节奏 | jstat -gcutil pid 1000 10 |
FGC 不再高频增长,GCT 占比 < 5% |
| 系统负载 | uptime |
load 回到 1/5/15 分钟趋势平稳 |
5.4 复盘五问
事故单上的结论必须带证据,复盘围绕五个问题:
- 为什么发生?(根因链条:老年代增长源 → 分配压力 → CMS 退化)
- 为什么没拦住?(监控阈值是否合理?GC 指标是否纳入了告警?)
- 告警为什么没有更早触发?(p99 告警有吗?还是只有 avg?)
- 止血动作是否可固化?(摘流量预案、回滚开关是否一键化?)
- 如何防止复发?(代码层面 + 配置层面 + 监控层面的三条整改)
6. 工具速查表
6.1 监控侧(不上机器)
| 目的 | 工具/动作 |
|---|---|
| 影响面确认 | APM 大盘:实例 CPU 曲线叠图 |
| 接口慢的形态 | RT 的 avg 与 p99 对比(长尾 = STW 嫌疑) |
| 集群共性排查 | 变更记录、QPS 曲线、缓存命中率、慢 SQL 清单 |
6.2 机器侧(系统视角)
| 目的 | 命令 | 关键判据 |
|---|---|---|
| 系统全景 | top |
us/sy/wa/hi/si/st、load 趋势、Tasks 状态 |
| 进程排序(脚本化) | `ps -eo pid,pcpu,args --sort=-pcpu | head` |
| 切换风暴验证 | vmstat 1 |
cs 每秒上下文切换数 |
| 单进程线程视图 | top -Hp <pid> |
%CPU 榜首线程名 + TIME+ 增速 |
| 线程列表 | ps -T -p <pid> -o tid,pcpu,comm |
线程级 CPU 占用 |
6.3 JVM 侧(进程内部)
| 目的 | 命令 | 注意 |
|---|---|---|
| 线程栈快照 | jstack <pid> > file.log |
落盘再 grep;跨用户加 sudo -u |
| 反查热点线程 | printf '%x\n' <tid> + grep -A 30 'nid=0x<hex>' file.log |
带 nid=0x 前缀精确匹配 |
| GC 实时节奏 | jstat -gcutil <pid> 1000 5 |
盯 FGC 增长与 GCT 占比 |
| 线程状态分布 | `grep 'java.lang.Thread.State' file.log | sort |
| 堆转储 | jmap -dump:live,format=b,file=x.hprof <pid> |
内存方向排查,文件较大 |
| 火焰图 | arthas profiler / perf record | jstack 多帧采样的自动化升级版 |
6.4 高频报错对照
| 报错 | 真实原因 | 解法 |
|---|---|---|
Unable to open socket file |
用户身份与进程属主不一致(root attach admin 进程) | sudo -u <属主> jstack <pid> |
-F option can be used... |
同上(兜底文案误导) | 先查 ps -o user -p <pid> 再决定 |
7. 收束:这题真正的考法
回到开头的三层全景图。这篇文章的排查路径看似是一个案例,实际是三层方法论的闭环:
- 监控侧 :APM 大盘叠图定影响面(单机/集群三分叉)+ p99 分位值预判方向------横向收敛,先知道去哪台机器
- 机器侧 :top 八字段判因果(us/sy 分布 + 线程状态 + 矛盾数字)------判明方向,CPU 花在了哪
- 四连定位 :进程 → 线程 → 十六进制 → jstack 代码行------纵向定位,哪一行在烧
贯穿全程的只有一条纪律:
结论必须带证据。 每一步的"怀疑"都要有下一级的证据坐实------旁证给方向、直接证据实锤身份、定量铁证数字定论。反过来,报错文案可能骗你("not responding"其实是权限),采样值可能抖你(%CPU 是瞬时差),单一字段可能误导你(us/sy 不是因果)。所以每一层都不越界、每一步都求印证,这才是"专家级"和"会敲命令"之间的分水岭。
本文所有命令均在 Linux + HotSpot JVM 8 环境验证。文中的"订单服务"案例数据来自一次真实生产排查,已做脱敏处理。