自动发布做到最后一步,剩下的活看着最没技术含量:把几千字的正文塞进网页编辑器。我在这上面栽过两次,一次是慢,一次是验不出来。慢的那次好查,日志里时间戳明摆着;验不出来那次折腾了很久------稿子明明在编辑器里,程序读回来却说对不上。
这两件事其实是同一个问题的两面:写入通道和校验口径没有配对。下面所有数字都是刚在本机跑探针测的,页面是本地构造的 contenteditable,走 CDP,不联网、不点任何平台按钮。
三条通道,代价差三个数量级
同一个 518 字的正文,三条通道写进同一个 contenteditable:
| 通道 | 518 字耗时 | 每字耗时 | input 事件数 |
|---|---|---|---|
keyboard.type 逐字 |
317 ms | 0.61 ms | 518 |
Input.insertText 逐字 |
744 ms | 1.44 ms | 518 |
Input.insertText 整块 |
27 ms | --- | 1 |
| 直接改 DOM + 派发 input | 1.7 ms | --- | 1 |
先看第二行:insertText 一个字一个字喂,比 keyboard.type 还慢一倍多 。因为每字符一次 CDP 往返,而 type 的按键事件在同一批里更省。所以「用 insertText 逐字就快了」是错觉。
再放到真实长度上,差距才出来。同一段文字按 600 / 3000 / 8000 字三档测:
yaml
chars   type_ms   insert_block_ms   dom_ms
600      262.5          2.0           1.8
3000    1394.7          2.7           2.2
8000    5018.3          2.9           2.7
逐字是线性的,8000 字 5018 ms,约 0.63 ms/字 ;整块写入基本是常数,2~3 ms。8000 字,5.0 秒对 2.9 毫秒,1700 倍。
这 5 秒不只是等待。逐字期间编辑器必须一直保持焦点和可写状态,任何一次抢焦点------平台的引导气泡、上传进度 toast、定时保存的弹窗------都会让后面几百字直接落空。而整块写入只有一次往返,窗口小到几乎不可能被打断。掘金这条线是把 .md 正文整体 typed 进 ByteMD,正文越长这个窗口越宽,道理就在这里。
事件数才是通道真正的差别
上表最后一列比耗时更值得看:518 个事件对 1 个事件。
编辑器不是靠 DOM 里的字符工作的,它靠 input 事件知道「发生了输入」。逐字路径喂给它 518 次变化,整块路径只喂 1 次。这个差别带来两个方向的后果:
- 需要逐字历史的场景,整块写入会让编辑器认为「一次性粘贴」,撤销栈塌成一步、字数统计只跳一次、自动保存可能漏触发。(撤销栈这一条是按事件语义推断的,没有在平台编辑器上逐字验证过,标出来免得被当成实测。)
- 反过来,正文不需要逐字历史。整块写入不触发逐字联想和自动补全,对正文是优点------不会被自动替换成别的词;对标题、标签这类需要联想的地方才是缺点。
所以「哪种通道更高级」这个问题本身是错的,只有「这个输入框需要页面看见多少次输入」。
直接改 DOM 最快,也最容易被抹掉
第四条通道是绕过输入,直接写 DOM。它最快(2.7 ms),也最危险。
我用一个最小的受控组件模型验证了这件事:input 事件更新 state,下一次渲染按 state 覆盖 DOM。这正是 React/Vue 类编辑器的行为。
js
const ctrl = document.getElementById('ctrl');
let state = '';
ctrl.addEventListener('input', () => { state = ctrl.textContent; });
window.rerender = () => { ctrl.textContent = state; };
两种写法,同样的重渲染:
js
// ① 直接改 DOM,不派发事件
ctrl.textContent = '未经事件通道写入的正文';
window.rerender();
// 结果:''            ← 被 state 覆盖回空

// ② 直接改 DOM 并派发 input
ctrl.textContent = '经事件通道写入的正文';
ctrl.dispatchEvent(new Event('input', {bubbles: true}));
window.rerender();
// 结果:'经事件通道写入的正文' ← 保留第一种写法,写进去的内容在下一帧就没了,而且页面当时看起来是对的 ------你截图、你读 textContent,几毫秒内都是对的,只有等框架重渲染才清空。这就是最难查的一类失败。
平台侧早就踩过同样的坑,只是当年记在了另一本账上:百家号的正文 UEditor 必须注入 iframe#ueditor_0 的 contentDocument.body.innerHTML 再 dispatchEvent('input');创作声明那个复选框用 JS 设 checked = true 拿到的是脏值,后脚就被 React 改回去,只能用真实鼠标点。规则是一样的:走事件通道,别只改渲染结果。
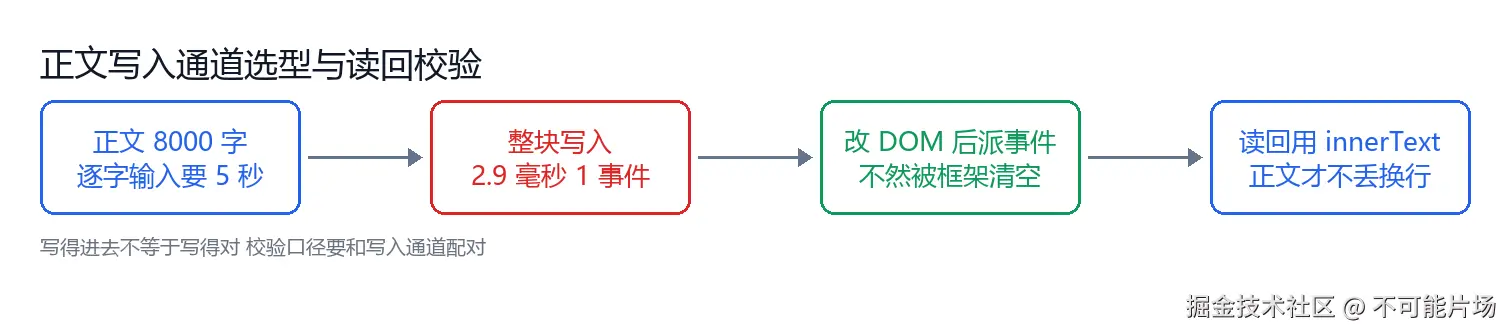
写进去了怎么验:textContent 会把换行吃掉
这是「验不出来」的真正原因。
往 contenteditable 里写带换行的文本,浏览器不会生成 \n 文本节点,而是生成块级节点。实测三种形态:
| 源文本 | 落地 DOM | textContent 长度 / 换行数 | innerText 长度 / 换行数 |
|---|---|---|---|
第一段\n第二段 |
第一段<div>第二段</div> |
6 / 0 | 7 / 1 |
第一段\n\n第二段 |
第一段<div><br></div><div>第二段</div> |
6 / 0 | 9 / 3 |
甲\n\n乙\n\n丙 |
4 个块节点 + 2 个 <br> |
3 / 0 | 9 / 6 |
第一行就够说明问题:源文本 7 个字符,textContent 读回来 6 个,换行数 0。
textContent 是「把 DOM 里所有文本拼起来」,块级边界不产生任何字符。所以任何这样写的校验:
python
assert page.eval_on_selector("#body", "el => el.textContent") == source_text对多段正文永远不可能通过。它不是在报「丢字」,它是在报「我不知道换行也是一段内容」。
正确的读回口径有两条,按需要选:
python
# 口径一:innerText,保留块级边界
got = page.eval_on_selector("#body", "el => el.innerText")

# 口径二:结构化计数,比块节点数和总字数
stat = page.eval_on_selector("#body", """el => ({
    blocks: el.querySelectorAll('div,p').length,
    chars: el.textContent.length,
})""")
口径二更稳:段数对了、字数对了,中间少一个空行也能被 blocks 抓住,而且不吃 innerText 的样式依赖(元素不可见时 innerText 会返回空串,headless 里尤其容易踩)。
顺带一个反直觉的实测:emoji 走两条通道都是安全的。🎬 在 textContent 里长度是 2(UTF-16 代理对),但 DOM 里就是一个完整字符,没有被拆成两半个代理 ------keyboard.type 内部也按一个字符处理。所以校验时别拿字符数比 1,要么比 innerText,要么按 len(text.encode('utf-16-le')) // 2 折算。
落到发布器里的选型
把上面几条并成一张决策表,这就是我现在写适配器的顺序:
| 输入框类型 | 通道 | 理由 |
|---|---|---|
| 大段正文(纯文本/markdown) | 整块 insertText,或注入 innerHTML + 派发 input |
常数耗时,不打断焦点 |
| 富文本正文(UEditor 这类 iframe) | 注入 iframe 内 body.innerHTML + 派发 input |
外层 document 看不到编辑器 |
| 短标题、标签 | 先 Ctrl+A + Delete 清空,再逐字 type |
需要真实按键覆盖预填内容 |
| 受控复选框、发布按钮 | 真实鼠标事件 | JS .click() 不触发 React 合成事件 |
对应的写入封装,关键是「写」和「验」成对出现:
python
def set_body(page, cdp, text, mode="block"):
    page.click("#body")
    if mode == "block":
        cdp.send("Input.insertText", {"text": text})
    elif mode == "type":
        page.keyboard.type(text)
    page.wait_for_timeout(120)          # 给框架一帧回写的机会

def verify_body(page, text):
    stat = page.eval_on_selector("#body", """el => ({
        blocks: el.querySelectorAll('div,p').length,
        chars: el.textContent.length,
    })""")
    return stat["chars"] == len(text), stat
wait_for_timeout(120) 那行不是凑数:受控组件的回写发生在下一帧,写完立刻读是读不准的,这一帧的等待把「脏值」和「真值」分开。
三条原则
- 通道按编辑器类型选,不按「最像真人」选。 逐字只在页面必须看见每一次输入时才用:自动补全、@提及、字数联动、防机器人。纯正文用整块。
- 写入必须走事件通道。 直接改 DOM 只改了渲染结果,框架一次重渲染就抹平,而且抹平之前你读到的一切都是对的。
- 校验口径必须和写入形态配对。 块级编辑器用
innerText或结构计数,textContent只适合单段纯文本。
前一篇写的是「什么时候可以开始写」(页面就绪判据),这篇补的是后半段:怎么写、怎么验。发布流水线里最容易骗过自己的两处,恰好一个在开头一个在结尾。