透明物体的渲染
在三维场景渲染中,矢量、粒子、玻璃等往往是半透明的渲染物体。渲染中对于半透明的计算方法是非常经典的OVER操作,在OpenGL下状态的设置如下所示:
glsl
glEnable (GL_DEPTH_TEST); //允许深度测试
glDepthMask (GL_TRUE); //允许写入深度缓冲
glDisable (GL_BLEND); //不允许混合
glBlendFunc(GL_SRC_ALPHA, GL_ONE_MINUS_SRC_ALPHA)
对应的数学公式为C_out = C_src·α_src + C_dst·(1 − α_src)------GL_SRC_ALPHA 给源加权、GL_ONE_MINUS_SRC_ALPHA 给目标加权
因为OVER操作不符合交换律,需要按照顺序进行计算。但是多个层级操作需要从后向前顺序混合,因为递归地应用数据:
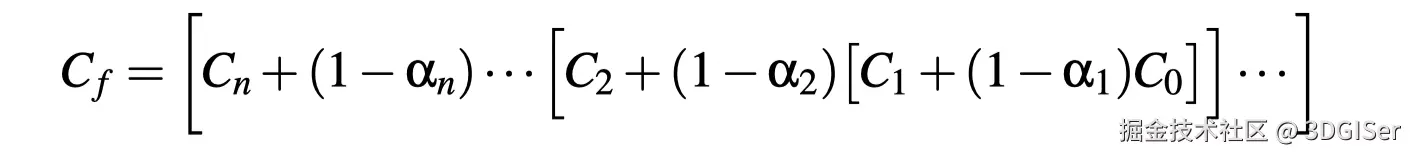 所以解决多层半透明物体的方案,最直接的反应就是按照半透明物体距离相机的从后向前依次渲染。
直观的想法就是在给GPU之前按照层,多Pass渲染
实例约定:两个交叉三角形实例
本节给出两个交叉三角形实例。实例 1 的深度顺序在整片重叠区一致;实例 2 的两个三角形在空间上真正互穿,深度顺序随像素反转------后者正是 CPU 按物体排序必然失败、而深度剥离仍然精确的原因。
一、测试样例统一约定
相机:正交相机,眼空间线性深度 z ∈ 0, 1,z 越小越靠近相机;背景为不透明黑色 C_bg = (0, 0, 0),背景深度 z_bg = 1.0。
三角 A(红色):颜色 c_A = (0.7, 0, 0),α_A = 0.7,预乘色 c_A·α_A = (0.49, 0, 0)。
三角 B(蓝色):颜色 c_B = (0, 0, 0.6),α_B = 0.6,预乘色 c_B·α_B = (0, 0, 0.36)。
渲染规则:A、B 不做远近排序,无序提交绘制;深度剥离由硬件逐像素定序,不需要 CPU 排序。
合成公式(back-to-front,预乘 Alpha):C = Layerk.rgb + C·(1 − Layerk.a),k 从 N−1 递减到 0。
真值参考:按该像素真实深度排序后做标准 Alpha 混合,C_out = C_near·α_near + (C_far·α_far + C_bg·(1−α_far))·(1−α_near)。
二、实例 1:同序交叉(重叠区 A 恒在前)
几何定义(前两列为屏幕 NDC 的 x / y,第三列为眼空间线性深度 z):
| 顶点 | 三角 A | 三角 B |
|---|---|---|
| V0 | (−0.8, −0.5, 0.20) | (−0.8, 0.6, 0.60) |
| V1 | (0.8, −0.5, 0.20) | (0.8, 0.6, 0.60) |
| V2 | (0.0, 0.8, 0.20) | (0.0, −0.7, 0.60) |
A 是朝上的等深平面(z ≡ 0.20),B 是朝下的等深平面(z ≡ 0.60),两者在屏幕投影上交叉重叠,但空间上平行不互穿,因此整片重叠区里 A 恒在前、B 恒在后。
跟踪像素 P(屏幕中心 (0, 0),同时被 A、B 覆盖),逐轮 Peel:
| 轮次 | prevDepth | 通过剔除的片元 | GL_LESS 胜出 | Layerk(预乘色, α) | 写出深度 |
|---|---|---|---|---|---|
| Pass 1 | 0.00 | A(0.20)、B(0.60) | A | Layer0 = ((0.49, 0, 0), 0.7) | 0.20 |
| Pass 2 | 0.20 | B(0.60),A 被 0.20 ≤ 0.20 + ε 剔除 | B | Layer1 = ((0, 0, 0.36), 0.6) | 0.60 |
| Pass 3 | 0.60 | 无,A、B 全被 discard | --- | 本轮 0 片元 → 收敛,N = 2 | --- |
合成:C = C_bg = (0, 0, 0);叠 Layer1(B)→ C = (0, 0, 0.36) + 0·0.4 = (0, 0, 0.36);叠 Layer0(A)→ C = (0.49, 0, 0) + (0, 0, 0.36)·0.3 = (0.49, 0, 0.108)。
真值:C_out = (0.49, 0, 0) + ((0, 0, 0.36) + 0·0.4)·0.3 = (0.49, 0, 0.108) ------ 逐分量一致,无近似误差。这一结果也是后面(4)渲染流程里像素 P 全程跟踪的基准。
本例说明:即使不排序,深度剥离也用「深度下界剔除 + GL_LESS 取最小」把无序片元切成有序层。因为顺序在整片重叠区一致,CPU 按物体中心排序在本例中同样能得到正确结果,尚看不出逐像素定序的必要性。
三、实例 2:真互穿交叉(深度顺序随像素反转)
把两个三角形改为沿 x 方向反向倾斜的斜面,让它们在空间中互相穿过:
| 顶点 | 三角 A | 三角 B |
|---|---|---|
| V0 | (−0.8, −0.5, 0.00) | (−0.8, 0.6, 0.80) |
| V1 | (0.8, −0.5, 0.80) | (0.8, 0.6, 0.00) |
| V2 | (0.0, 0.8, 0.40) | (0.0, −0.7, 0.40) |
三个顶点的深度都落在同一条线性函数上,所以整个三角形内部按重心插值后仍是纯 x 的函数:z_A(x) = 0.40 + 0.50x,z_B(x) = 0.40 − 0.50x。两者在 x = 0、z = 0.40 处相交,即两个三角形沿屏幕中央竖线互穿。
取重叠区内 y = 0 的两个像素 P(−0.4, 0) 与 Q(+0.4, 0),代入上式:
| 像素 | z_A | z_B | 真实顺序(近 → 远) |
|---|---|---|---|
| P (−0.4, 0) | 0.20 | 0.60 | A → B |
| Q (+0.4, 0) | 0.60 | 0.20 | B → A |
CPU 排序在此失效:按物体中心距只能给出一个全局顺序。若取「A 在前」,P 正确而 Q 错;若取「B 在前」,Q 正确而 P 错。两个三角形互穿时不存在全局正确的物体顺序,除非沿相交线把三角形拆成子网格------这正是第一节 CPU 端「对于相互交叉的半透明物体无法实现」的死结。数值上:全局按 A→B 时 Q 得到 (0.49, 0, 0.108),而真值应为 (0.196, 0, 0.36),R 通道偏高 0.294、B 通道偏低 0.252,整块交叉区域颜色反转错误。
深度剥离不按物体定序,而是逐像素独立分层:Layerk 与 Depthk 都是全屏纹理,P 与 Q 在同一轮里各自取自己的最近层,prevDepth 也从上一轮深度纹理的同一像素读取,因此两个像素的下界互不干扰。
| 轮次 | prevDepth(逐像素) | 像素 P 输出 | 像素 Q 输出 |
|---|---|---|---|
| Pass 1 | P: 0.00 / Q: 0.00 | Layer0 = A((0.49, 0, 0), 0.7),Depth = 0.20 | Layer0 = B((0, 0, 0.36), 0.6),Depth = 0.20 |
| Pass 2 | P: 0.20 / Q: 0.20 | Layer1 = B((0, 0, 0.36), 0.6),Depth = 0.60 | Layer1 = A((0.49, 0, 0), 0.7),Depth = 0.60 |
| Pass 3 | P: 0.60 / Q: 0.60 | 0 片元 → 收敛 | 0 片元 → 收敛 |
合成结果:P 与实例 1 相同,C = (0.49, 0, 0.108);Q 先叠远层 A → C = (0.49, 0, 0) + 0·0.3 = (0.49, 0, 0),再叠近层 B → C = (0, 0, 0.36) + (0.49, 0, 0)·0.4 = (0.196, 0, 0.36)。两者与各自真值逐分量一致。P、Q 的层数都是 N = 2,所以在第 3 轮同时收敛,Peel 轮数由最坏重叠层数决定,与几何是否交叉无关。
四、两实例对照与结论
| 维度 | 实例 1 同序交叉 | 实例 2 真互穿交叉 |
|---|---|---|
| 重叠区深度顺序 | 处处 A → B | P 为 A → B,Q 为 B → A |
| CPU 按物体排序 | 可得正确结果 | 无全局正确顺序,必然出错 |
| WBOIT / MBOIT | 近似,存在权重或矩拟合偏差 | 顺序反转时无法区分前后,偏差更明显 |
| 深度剥离 | 精确 | 精确,逐像素独立分层 |
| 开销 | N = 2,2 轮 Peel + 1 轮合成 | 同左,与深度顺序无关 |
关键结论:
精度来源是把排序下沉到像素级------Layerk 存的是每个像素的第 k 层,而不是某个物体的第 k 层,因此交叉互穿不引入任何顺序歧义,也就不存在 WBOIT 的经验权重偏差与 MBOIT 的矩拟合误差。
代价只与最坏重叠层数 N 有关,与三角形个数、是否交叉无关;实例 2 里两个像素都是 N = 2,故同时收敛。
剔除判据 z ≤ prevDepth + ε 必须带 ε:相交线 x = 0 附近 z_A ≈ z_B ≈ 0.40,缺了 ε 会把两层合并成一层或整层丢失,表现为交叉线闪烁,对应文末踩坑清单第 2 条。
接下来的(2)资源分配给出实现上述两实例所需的全部缓冲;(4)渲染流程与(6)GLSL Shader 代码给出逐轮状态与完整 shader。
CPU端
在CPU端,经过视锥体剔除等方案,获取所有需要渲染的物体;
第一步:将半透明物体和不透明物体分成两类,先渲染不透明物体;
第二步:对半透明物体按照离相机的距离,从大向小分成多层;
第三步:多个pass,从后向前依次渲染半透明物体。
优点:完全符合物理规律
缺点:多pass慢、排序慢、对于相互交叉的半透明物体无法实现(除非拆分,但是更不友好)
GPU端
深度剥离(Depth Peeling)
深度剥离说白了就是在GPU端,先将不透明物体进行渲染,再将对半透明物体按照离相机的距离多Pass渲染,最后将多个pass多个离屏目标进行按照over合并。
优点:完全符合物理规律
缺点:多pass慢
(1)资源分配
2 张 DEPTH_COMPONENT32F 深度纹理(ping-pong:Depth0 / Depth1),逐轮交替充当「上一轮剥离深度」与「本轮深度附件」
1 组颜色层纹理(推荐 sampler2DArray,每层一个 slice,RGBA16F 或 RGBA32F),存放每层的预乘颜色 c·α 与 α
1 张不透明背景颜色纹理 + 1 张不透明深度纹理(阶段 0 输出,与 WBOIT / MBOIT 完全共用)
(2)核心定义
第 k 轮只保留「深度严格大于第 k−1 轮剥离深度」的片元,再靠深度测试在其中取最近的一层
物理根基:不构造任何统计量,直接按真实几何深度把每个像素的透明片元切成有序层,再用标准 Alpha 混合从后往前累加
结果:层数 N 覆盖该像素全部透明片元时,结果与手工排序渲染逐分量一致,无近似误差
代价:Pass 数 = N + 1,颜色缓冲随 N 线性增长,帧耗时由场景最坏重叠层数决定,无法用固定开销封顶
(3)渲染流程
阶段 0:不透明渲染 → 输出背景颜色 + 不透明深度缓冲
↓
Pass1:Peel 第 0 层(以不透明深度为下界,取最靠近相机的一层透明片元,颜色写 Layer0,深度写 Depth1)
↓
Pass2...PassN:逐轮以上一轮深度纹理为下界剔除,取下一层,写入 Layerk
↓
收敛判定:本轮无任何片元写入(遮挡查询 / 深度最大值检查)则停止
↓
合成 Pass:按 z 从远到近(back-to-front)对 LayerN−1...Layer0 做标准 Alpha 混合
↓
输出最终画面(与第一节真值参考完全一致)
Pass 0:不透明物体渲染通道
OpenGL 状态:
glsl
glEnable (GL_DEPTH_TEST); //允许深度测试
glDepthMask (GL_TRUE); //允许写入深度缓冲
glDisable (GL_BLEND); //不允许混合
输入:所有不透明模型、纹理
绘制:全部不透明物体
输出:
主帧缓冲颜色(本案例像素 P 为黑色背景)
深度缓冲 DepthBuffer(记录每个像素最近不透明物体深度)
作用:
渲染背景与不透明物体,作为透明物体的底层底色;
生成深度遮挡关系:后续透明片元如果 z 大于深度缓冲值,代表被不透明物体挡住,直接丢弃,不参与 OIT 累加。
本案例像素 P:无遮挡,A、B 两个三角的片元全部保留,进入透明通道。
Pass1:Peel 第 k 层(每轮形式相同,以第 0、1 轮为例)
OpenGL 状态:
glsl
glEnable (GL_DEPTH_TEST);
glDepthFunc (GL_LESS); // 关键:本轮内取最靠前的一层
glDepthMask (GL_TRUE); // 关键:与 WBOIT / MBOIT 相反,必须写深度
glDisable (GL_BLEND); // 关键:禁止混合,每层是独立完整片元,不能累加
FBO 绑定 Layerk 颜色附件 + Depthk%2 深度附件;深度清为 1.0;上一轮深度纹理 Depth(k+1)%2 以只读方式绑定
绘制:无序提交三角 A、三角 B(定序由深度测试完成,仍不需要 CPU 排序)
片元 Shader 逻辑:
用 gl_FragCoord.xy * uScreenRcp 采样上一轮深度 prevDepth(第 0 轮 prevDepth = 0.0)
若 gl_FragCoord.z <= prevDepth + 1e-5,discard(前几轮已剥掉的层)
读取片元 α 与预乘颜色 c·α,直接输出 vec4 (c·α, α)
本轮最近片元的 gl_FragCoord.z 由硬件 GL_LESS 自动写入深度附件
像素 P 第 0 轮结果:
prevDepth = 0,A(z=0.2)与 B(z=0.6)都通过剔除
GL_LESS 保留更近的 A → Layer0 = ((0.49, 0, 0), 0.7),Depth1 = 0.2
像素 P 第 1 轮结果:
prevDepth = 0.2,A 被 discard(0.2 <= 0.2 + 1e-5),B(0.6)通过
GL_LESS 保留 B → Layer1 = ((0, 0, 0.36), 0.6),Depth0 = 0.6
像素 P 第 2 轮结果:
prevDepth = 0.6,A、B 全部被 discard → 本轮 0 片元,收敛,N = 2
本阶段作用:
用「深度下界剔除 + 深度测试取最小」两步,把无序提交的透明片元按真实深度切成有序层;
不做加权、不做矩拟合,因此既没有 WBOIT 的经验权重偏差,也没有 MBOIT 的矩拟合误差
Pass2:全屏合成 Pass(全屏 Quad 覆盖屏幕)
OpenGL 状态:
glsl
glDisable (GL_DEPTH_TEST);
glDepthMask (GL_FALSE);
glDisable (GL_BLEND);
混合单元
输入纹理:不透明背景颜色纹理、Layer0..N−1(sampler2DArray)
Shader 逻辑:
C = 背景颜色;令 k 从 N−1 递减到 0,逐层做 back-to-front 标准 Alpha 混合
C = Layerk.rgb + C·(1 − Layerk.a)
输出 vec4 (C, 1.0)
像素 P 计算:
C = C_bg = (0, 0, 0)
叠 Layer1(B):C = (0, 0, 0.36) + (0, 0, 0)·0.4 = (0, 0, 0.36)
叠 Layer0(A):C = (0.49, 0, 0) + (0, 0, 0.36)·0.3 = (0.49, 0, 0.108)
与第一节真值参考 C_out = C_A・α_A + (C_B・α_B + C_bg・(1−α_B))・(1−α_A) 逐分量一致
本阶段作用:
按真实远近关系还原标准 Alpha 混合,唯一「精确」的 OIT;
代价是合成循环次数等于层数 N,而 N 由最坏重叠度决定,帧耗时不具备固定上界
(4)OpenGL C++ 状态配置片段
glsl
// ========== 不透明渲染状态 ==========
glEnable (GL_DEPTH_TEST);
glDepthMask (GL_TRUE);
glDisable (GL_BLEND);
glsl
// ========== 累加 Pass 通用状态 ==========
glEnable (GL_DEPTH_TEST);
glDepthFunc (GL_LESS); // 关键:本轮内取最靠前的一层
glDepthMask (GL_TRUE); // 关键:与 WBOIT / MBOIT 相反,必须写深度
glDisable (GL_BLEND); // 关键:禁止混合,每层是独立完整片元,不能累加
// ========== Resolve 合成 Pass 状态 ==========
glEnable (GL_DEPTH_TEST);
glDepthMask (GL_FALSE);
glEnable (GL_BLEND);
glBlendFunc (GL_SRC_ALPHA, GL_ONE_MINUS_SRC_ALPHA);
(5)GLSL Shader 代码
说明:OpenGL 330 core,颜色层用 sampler2DArray 一次绑定 N 层以避免动态 sampler 索引;深度纹理为 DEPTH_COMPONENT32F;Peel 阶段使用硬件深度 gl_FragCoord.z 即可,因为它只做相对比较、不参与任何权重或矩的数值计算;颜色层存预乘 Alpha(rgb 即 c·α),
Depth Peeling 累加 Pass 顶点着色器 peel_accum.vert
glsl
#version 330 core
layout (location = 0) in vec3 aPos;
layout (location = 1) in vec2 aUV;
out vec2 vUV;
uniform mat4 uModel;
uniform mat4 uView;
uniform mat4 uProj;
void main ()
{
vec4 worldPos = uModel * vec4 (aPos, 1.0);
vec4 eyePos = uView * worldPos;
vUV = aUV;
gl_Position = uProj * eyePos;
}
Depth Peeling 累加 Pass 片元着色器 peel_accum.frag
glsl
#version 330 core
layout (location = 0) out vec4 oLayerColor;
in vec2 vUV;
uniform sampler2D uTex; // 输入为预乘 Alpha 纹理,rgb 即 c·α
uniform sampler2D uPrevDepthTex; // 上一轮剥离深度,ping-pong 中的另一张
uniform vec2 uScreenRcp; // 1.0 / 屏幕宽高
uniform int uFirstPass; // 第 0 轮为 1,跳过深度纹理采样
void main()
{
float prevDepth = 0.0;
if (uFirstPass == 0)
{
prevDepth = texture (uPrevDepthTex, gl_FragCoord.xy * uScreenRcp).r;
}
if (gl_FragCoord.z <= prevDepth + 1e-5)
{
discard; // 前几轮已经剥离过的层
}
vec4 texRGBA = texture (uTex, vUV);
float alpha = texRGBA.a;
if (alpha < 1e-6) discard;
oLayerColor = vec4 (texRGBA.rgb, alpha); // 保留预乘颜色,供合成阶段直接累加
}
Depth Peeling 全屏合成 Quad 顶点着色器 peel_composite.vert
glsl
#version 330 core
layout (location = 0) in vec2 aPos;
out vec2 vUV;
void main ()
{
vUV = aPos * 0.5 + 0.5;
gl_Position = vec4 (aPos, 0.0, 1.0);
}
Depth Peeling 全屏合成 Quad 片元着色器 peel_composite.frag
glsl
#version 330 core
in vec2 vUV;
out vec4 oFinalColor;
uniform sampler2D uOpaqueTex; // 阶段 0 的不透明背景
uniform sampler2DArray uLayerTex; // slice k 存放第 k 层
uniform int uLayerCount; // 收敛时得到的层数 N
void main()
{
vec3 C = texture (uOpaqueTex, vUV).rgb;
for (int k = uLayerCount - 1; k >= 0; k--)
{
vec4 layer = texture (uLayerTex, vec3 (vUV, float (k)));
C = layer.rgb + C * (1.0 - layer.a); // back-to-front 标准 Alpha 混合
}
oFinalColor = vec4 (C, 1.0);
}
逐轮调度 C++ 伪代码
glsl
glBindFramebuffer (GL_FRAMEBUFFER, fboOpaque);
// 阶段 0:先渲染不透明物体,得到背景色与不透明深度
int k = 0;
while (k < MAX_LAYERS)
{
glBindFramebuffer (GL_FRAMEBUFFER, fboPeel);
glFramebufferTexture2D (GL_FRAMEBUFFER, GL_COLOR_ATTACHMENT0, GL_TEXTURE_2D, layerColor[k], 0);
glFramebufferTexture2D (GL_FRAMEBUFFER, GL_DEPTH_ATTACHMENT, GL_TEXTURE_2D, depthTex[k % 2], 0);
glClearDepth (1.0); glClear (GL_COLOR_BUFFER_BIT | GL_DEPTH_BUFFER_BIT);
setUniform (uPrevDepthTex, depthTex[(k + 1) % 2]);
setUniform (uFirstPass, k == 0 ? 1 : 0);
drawAllTransparentGeometryUnsorted (); // 仍无需排序
if (occlusionQuerySamplesPassed () == 0) break; // 本轮无片元,收敛
k++;
}
setUniform (uLayerCount, k);
drawFullScreenQuadWithCompositeShader ();
十二、深度剥离 配套 OpenGL C++ 状态配置片段
// ========== 阶段 0:不透明渲染状态(与 WBOIT / MBOIT 共用) ==========
glEnable (GL_DEPTH_TEST);
glDepthMask (GL_TRUE);
glDisable (GL_BLEND);
// ========== Peel 逐轮状态(关键:与两种 OIT 累加 Pass 完全不同) ==========
glEnable (GL_DEPTH_TEST);
glDepthFunc (GL_LESS);
glDepthMask (GL_TRUE); // 写本轮深度,供下一轮做下界
glDisable (GL_BLEND); // 每层独立完整片元,禁止加法累加
// 每轮:FBO 绑定 Layer[k] + Depth[k%2],清深度 1.0,只读绑定 Depth[(k+1)%2]
// ========== 全屏合成 Pass 状态 ==========
glDisable (GL_DEPTH_TEST);
glDepthMask (GL_FALSE);
glDisable (GL_BLEND); // shader 内完成 back-to-front 混合,不依赖硬件混合
由上面可以知道,虽然深度剥离能够完美解决半透明物体的渲染,且保证结果完全正确,但是需要渲染多次,渲染代价大。在追求性能的时代,这个算法有时候不满足实际的功能需要。于是就有了我们是不是用最小的渲染代价模拟出来看起来也正确的方法,接下来的WBOIT和MBOIT就是基于这个原理实现的。
WBOIT
WBOIT(Weighted Blended Order-Independent Transparency )是一种非常实用的顺序无关半透明渲染技术。它通过在着色器中对每个片元的颜色和透明度进行加权求和,巧妙地避免了传统半透明渲染中复杂且耗时的排序问题,在性能和效果之间取得了很好的平衡。WBOIT算法的实现主要包含两个Pass:Accumulation Pass 和 Composite Pass。
(1)实例约定
下面我们以两个交叉重叠半透明三角形为演示案例。
一、测试样例统一约定(全程跟踪同一个重叠像素 P)
相机:眼空间线性深度 z ∈ 0, 1,z 数值越小越靠近相机
像素 P:屏幕上同时被两个三角形覆盖的重叠像素
三角 A(红色,靠前):预乘颜色 C_A=(0.7,0,0),α_A=0.7,z_A=0.2
三角 B(蓝色,靠后):预乘颜色 C_B=(0,0,0.6),α_B=0.6,z_B=0.6
背景:黑色 C_bg=(0,0,0),背景深度 z_bg=1.0
渲染规则:两个三角形不做远近排序,任意顺序提交绘制(OIT 核心目标:免除排序)
真值参考(正确排序渲染:先 B 后 A,标准 Alpha 混合):
C_out = C_A・α_A + (C_B・α_B + C_bg・(1−α_B))・(1−α_A)
(2)资源分配
2 张 FP32 浮点离屏 RT
RT0_AccumColor:RGB FP32,存储 ∑ c_i w_i
RT1_AccumWeight:R FP32,存储 ∑ w_i
经典权重函数:w (α,z) = α・e^(-8z)
设计思路:近处 z 小的片元权重更大,人为近似模拟从前到后的贡献
渲染流程
总流程
阶段 0:不透明渲染 → 输出背景颜色 + 深度缓冲
↓
Pass1:透明累加 Pass(无序绘制 A、B 三角,加法混合累加)
↓
Pass2:Resolve 全屏合成 Pass(读取两张累加 RT,计算平均颜色)
↓
标准 Alpha 混合和背景融合 → 输出最终画面
Pass 0:不透明物体渲染通道
OpenGL 状态:
glsl
glEnable (GL_DEPTH_TEST); //允许深度测试
glDepthMask (GL_TRUE); //允许写入深度缓冲
glDisable (GL_BLEND); //不允许混合
输入:所有不透明模型、纹理
绘制:全部不透明物体
输出:
主帧缓冲颜色(本案例像素 P 为黑色背景)
深度缓冲 DepthBuffer(记录每个像素最近不透明物体深度)
作用:
渲染背景与不透明物体,作为透明物体的底层底色;
生成深度遮挡关系:后续透明片元如果 z 大于深度缓冲值,代表被不透明物体挡住,直接丢弃,不参与 OIT 累加。
本案例像素 P:无遮挡,A、B 两个三角的片元全部保留,进入透明通道。
Pass1:透明累加 Pass
OpenGL 状态:
glsl
glEnable (GL_DEPTH_TEST);
glDepthMask (GL_FALSE); // 关键:透明物体禁止写入深度,避免互相遮挡
glEnable (GL_BLEND);
glBlendFunc (GL_ONE, GL_ONE); // 加法混合,天然顺序无关
FBO 绑定 RT0、RT1,清空两张 RT 初始值 = 0
绘制:无序提交三角 A、三角 B(A 先 B 后 / B 先 A 后结果一致)
片元 Shader 逻辑:
读取片元 α、线性眼深度 z、预乘颜色 c
计算权重 w = α * exp (-8.0*z)
输出到 RT0:c * w
输出到 RT1:w
像素 P 累加结果:
w_A=0.7e^(-1.6)≈0.1413,w_B=0.6e^(-4.8)≈0.00494
∑cw = C_A w_A + C_B w_B ≈ (0.0989, 0, 0.00296)
∑w = w_A + w_B ≈ 0.14624
本阶段作用:
不排序收集所有未被遮挡透明片元的加权颜色总和、权重总和;只做数据累加,不生成最终可见颜色。
Pass2:WBOIT Resolve 全屏合成 Pass(全屏 Quad 覆盖屏幕)
OpenGL 状态:
glsl
glEnable (GL_DEPTH_TEST);
glDepthMask (GL_FALSE);
glEnable (GL_BLEND);
glBlendFunc (GL_SRC_ALPHA, GL_ONE_MINUS_SRC_ALPHA);
输入纹理:RT0_AccumColor、RT1_AccumWeight,背景为主帧缓冲
Shader 逻辑:
读取 accumColor、accumW;若 accumW 极小,无透明片元,直接保留背景
平均颜色:avgColor = ∑cw / ∑w
等效 Alpha:outAlpha = clamp (∑w, 0, 1)
输出 avgColor 与 outAlpha,交给混合管线和背景融合
像素 P 计算:
avgColor≈(0.676,0,0.0202),outAlpha≈0.14624
C_final=avgColor・outAlpha + C_bg・(1-outAlpha)
本阶段作用:
把加权求和的统计量还原成单一平均颜色,再和背景做常规透明混合;
本质是经验近似算法,权重是人为设计指数函数,没有物理透射依据,多层交叉透明容易色偏。
(4)OpenGL C++ 状态配置片段
glsl
// ========== 不透明渲染状态 ==========
glEnable (GL_DEPTH_TEST);
glDepthMask (GL_TRUE);
glDisable (GL_BLEND);
glsl
// ========== 累加 Pass 通用状态(WBOIT / MBOIT 共用) ==========
glEnable (GL_DEPTH_TEST);
glDepthMask (GL_FALSE);
glEnable (GL_BLEND);
glBlendFunc (GL_ONE, GL_ONE);
// ========== Resolve 合成 Pass 状态 ==========
glEnable (GL_DEPTH_TEST);
glDepthMask (GL_FALSE);
glEnable (GL_BLEND);
glBlendFunc (GL_SRC_ALPHA, GL_ONE_MINUS_SRC_ALPHA);
(5)GLSL Shader 代码
说明:OpenGL 330 core,使用 FBO 双渲染目标,透明物体使用预乘 Alpha 纹理,z 为眼空间线性深度
WBOIT 累加 Pass 顶点着色器 wboit_accum.vert
glsl
#version 330 core
layout (location = 0) in vec3 aPos;
layout (location = 1) in vec2 aUV;
out vec2 vUV;
out float vEyeZ;
uniform mat4 uModel;
uniform mat4 uView;
uniform mat4 uProj;
void main ()
{
vec4 worldPos = uModel * vec4 (aPos,1.0);
vec4 eyePos = uView * worldPos;
vEyeZ = -eyePos.z; // 眼空间线性深度,z>0,离相机越远越大
gl_Position = uProj * eyePos;
vUV = aUV;
}
WBOIT 累加 Pass 片元着色器 wboit_accum.frag
glsl
#version 330 core
layout (location = 0) out vec4 oAccumColor;
layout (location = 1) out float oAccumWeight;
in vec2 vUV;
in float vEyeZ;
uniform sampler2D uTex;
void main ()
{
vec4 texRGBA = texture (uTex, vUV);
// 输入纹理为预乘 Alpha
vec3 premulColor = texRGBA.rgb;
float alpha = texRGBA.a;
if(alpha < 1e-6) discard;
float w = alpha * exp(-8.0 * vEyeZ);
oAccumColor = vec4(premulColor * w, 1.0);
oAccumWeight = w;
}
WBOIT Resolve 全屏 Quad 顶点着色器 wboit_resolve.vert
glsl
#version 330 core
layout (location = 0) in vec2 aPos;
out vec2 vUV;
void main ()
{
vUV = aPos * 0.5 + 0.5;
gl_Position = vec4 (aPos, 0.0, 1.0);
}
WBOIT Resolve 全屏 Quad 片元着色器 wboit_resolve.frag
glsl
#version 330 core
in vec2 vUV;
out vec4 oFinalColor;
uniform sampler2D uAccumColorTex;
uniform sampler2D uAccumWeightTex;
void main()
{
vec3 sumCW = texture(uAccumColorTex, vUV).rgb;
float sumW = texture(uAccumWeightTex, vUV).r;
if (sumW < 1e-6)
{
discard; // 没有透明片元,直接保留背景帧缓存
}
vec3 avgColor = sumCW /sumW;
float outAlpha = clamp (sumW, 0.0, 1.0);
oFinalColor = vec4 (avgColor, outAlpha);
}
MBOIT
(1)实例约定
以两个交叉重叠三角形为演示案例
一、测试样例统一约定(全程跟踪同一个重叠像素 P)
相机:正交相机,眼空间线性深度 z ∈ 0, 1,z 数值越小越靠近相机
像素 P:屏幕上同时被两个三角形覆盖的重叠像素
三角 A(红色,靠前):预乘颜色 C_A=(0.7,0,0),α_A=0.7,z_A=0.2
三角 B(蓝色,靠后):预乘颜色 C_B=(0,0,0.6),α_B=0.6,z_B=0.6
背景:黑色 C_bg=(0,0,0),背景深度 z_bg=1.0
渲染规则:两个三角形不做远近排序,任意顺序提交绘制(OIT 核心目标:免除排序)
真值参考(正确排序渲染:先 B 后 A,标准 Alpha 混合):
C_out = C_A・α_A + (C_B・α_B + C_bg・(1−α_B))・(1−α_A)
二、通用前置阶段(WBOIT / MBOIT 共用)
阶段 0:不透明物体渲染通道
OpenGL 状态:
glsl
glEnable (GL_DEPTH_TEST); //允许深度测试
glDepthMask (GL_TRUE); //允许写入深度缓冲
glDisable (GL_BLEND); //不允许混合
输入:所有不透明模型、纹理
绘制:全部不透明物体
输出:
主帧缓冲颜色(本案例像素 P 为黑色背景)
深度缓冲 DepthBuffer(记录每个像素最近不透明物体深度)
作用:
渲染背景与不透明物体,作为透明物体的底层底色;
生成深度遮挡关系:后续透明片元如果 z 大于深度缓冲值,代表被不透明物体挡住,直接丢弃,不参与 OIT 累加。
本案例像素 P:无遮挡,A、B 两个三角的片元全部保留,进入透明通道。
(2)资源分配
2 张 FP32 浮点离屏 RT
RT_Moment:RGBA FP32,4 通道依次存放 m0,m1,m2,m3(4 个幂矩)
RT_Sc:RGB FP32,存储 S_c=∑ c_i a_i
核心定义:吸收度 a_i = −ln (1−α_i)
物理根基:多层透射率是相乘关系,取对数后吸收度转为加法,适合累加统计。
T_total=e^(−∑a_i)
(3)渲染流程
总流程
阶段 0:不透明渲染 → 输出背景颜色 + 深度缓冲
↓
Pass1:矩累加 Pass(无序绘制 A、B 三角,加法混合累加矩与颜色项)
↓
Pass2:Resolve 拟合 + 积分合成 Pass(读取 Moment RT + Sc RT)
↓
标准 Alpha 混合和背景融合 → 输出最终画面
Pass 0:不透明物体渲染通道
OpenGL 状态:
glsl
glEnable (GL_DEPTH_TEST); //允许深度测试
glDepthMask (GL_TRUE); //允许写入深度缓冲
glDisable (GL_BLEND); //不允许混合
输入:所有不透明模型、纹理
绘制:全部不透明物体
输出:
主帧缓冲颜色(本案例像素 P 为黑色背景)
深度缓冲 DepthBuffer(记录每个像素最近不透明物体深度)
作用:
渲染背景与不透明物体,作为透明物体的底层底色;
生成深度遮挡关系:后续透明片元如果 z 大于深度缓冲值,代表被不透明物体挡住,直接丢弃,不参与 OIT 累加。
本案例像素 P:无遮挡,A、B 两个三角的片元全部保留,进入透明通道。
Pass1:MBOIT 矩累加 Pass
OpenGL 状态(和 WBOIT 累加 Pass 完全相同):
glsl
glEnable (GL_DEPTH_TEST);
glDepthMask (GL_FALSE);
glEnable (GL_BLEND);
glBlendFunc (GL_ONE, GL_ONE);
FBO 绑定 RT_Moment、RT_Sc,清空初始值全部为 0
绘制:无序提交三角 A、三角 B,顺序无关
片元 Shader 逻辑:
读取 α、线性眼深度 z、预乘颜色 c
计算吸收度 a = -log (1.0−α)
计算 4 个矩项:
m0 = a,m1 = a・z,m2 = a・z²,m3 = a・z³
输出到 RT_Moment:(m0,m1,m2,m3)
输出到 RT_Sc:c・a
像素 P 累加结果:
a_A=−ln (0.3)≈1.20397,a_B=−ln (0.4)≈0.91629
m0 = a_A+a_B ≈ 2.12026
m1 = a_A z_A + a_B z_B ≈ 0.79057
m2 = a_A z_A² + a_B z_B² ≈ 0.37802
m3 = a_A z_A³ + a_B z_B³ ≈ 0.20443
S_c = C_A a_A + C_B a_B ≈ (0.84278, 0, 0.54977)
本阶段作用:
顺序无关累加吸收度的 0~3 阶幂矩 + 颜色乘吸收度之和;
矩记录【吸收量在深度轴上的统计分布】,不是人为权重;同样只收集统计数据,不生成画面。
Pass2:MBOIT Resolve 拟合积分合成 Pass(全屏 Quad)
OpenGL 状态:
glsl
glEnable (GL_DEPTH_TEST);
glDepthMask (GL_FALSE);
glBlendFunc (GL_SRC_ALPHA, GL_ONE_MINUS_SRC_ALPHA);
输入纹理:RT_Moment、RT_Sc,背景主帧缓冲
Shader 分 4 步逻辑:
读取 m0,m1,m2,m3 和 S_c;m0 接近 0 则无透明片元,保留背景;使用 4 个幂矩,用有理多项式拟合连续吸收函数 A (z):A (z) 代表深度 z 处累计吸收总量,沿着深度从前到后积分透射函数 T (z)=e^(−A (z)),重建物理透射叠加(光线先穿过靠前 A,再穿过靠后 B)
结合 S_c 积分,求解最终透明合成颜色与等效 Alpha
输出颜色 + Alpha,和背景做标准 Alpha 混合
像素 P 行为:
拟合出的吸收函数自动区分 z=0.2(红 A)、z=0.6(蓝 B)两个吸收位置,结果高度贴近手动排序的真值。
本阶段作用:
从矩统计量还原深度上的吸收分布,基于物理透射模型积分,不是简单加权平均;多层交叉透明、厚体积透明失真远小于 WBOIT;代价是拟合代码复杂、算力更高。
(4)OpenGL C++ 状态配置片段
glsl
// ========== 不透明渲染状态 ==========
glEnable (GL_DEPTH_TEST);
glDepthMask (GL_TRUE);
glDisable (GL_BLEND);
glsl
// ========== 累加 Pass 通用状态(WBOIT / MBOIT 共用) ==========
glEnable (GL_DEPTH_TEST);
glDepthMask (GL_FALSE);
glEnable (GL_BLEND);
glBlendFunc (GL_ONE, GL_ONE);
// ========== Resolve 合成 Pass 状态 ==========
glEnable (GL_DEPTH_TEST);
glDepthMask (GL_FALSE);
glEnable (GL_BLEND);
glBlendFunc (GL_SRC_ALPHA, GL_ONE_MINUS_SRC_ALPHA);
(5)GLSL Shader 代码
说明:MBOIT 4 阶幂矩实现,论文 MKKP18 有理拟合版本,必须 FP32 纹理,线性眼深度,预乘 Alpha
MBOIT 累加 Pass 顶点着色器 mboit_accum.vert
glsl
#version 330 core
layout (location = 0) in vec3 aPos;
layout (location = 1) in vec2 aUV;
out vec2 vUV;
out float vEyeZ;
uniform mat4 uModel;
uniform mat4 uView;
uniform mat4 uProj;
void main()
{
vec4 worldPos = uModel * vec4(aPos,1.0);
vec4 eyePos = uView * worldPos;
vEyeZ = -eyePos.z;
gl_Position = uProj * eyePos;
vUV = aUV;
}
MBOIT 累加 Pass 片元着色器 mboit_accum.frag
glsl
#version 330 core
layout (location = 0) out vec4 oMoment;
layout (location = 1) out vec4 oSc;
in vec2 vUV;
in float vEyeZ;
uniform sampler2D uTex;
void main()
{
vec4 texRGBA = texture(uTex, vUV);
vec3 premulColor = texRGBA.rgb;
float alpha = texRGBA.a;
if(alpha < 1e-6) discard;
float a = -log(1.0 - alpha);
float z = vEyeZ;
float m0 = a;
float m1 = a * z;
float m2 = a * z * z;
float m3 = a * z * z * z;
oMoment = vec4(m0, m1, m2, m3);
oSc = vec4(premulColor * a, 1.0);
}
MBOIT Resolve 全屏 Quad 顶点着色器 mboit_resolve.vert
glsl
#version 330 core
layout (location = 0) in vec2 aPos;
out vec2 vUV;
void main ()
{
vUV = aPos * 0.5 + 0.5;
gl_Position = vec4 (aPos, 0.0, 1.0);
}
MBOIT Resolve 全屏 Quad 片元着色器 mboit_resolve.frag
glsl
#version 330 core
// MBOIT 4-Moment Resolve,MKKP18 有理拟合实现
in vec2 vUV;
out vec4 oFinalColor;
uniform sampler2D uMomentTex;
uniform sampler2D uScTex;
// 有理多项式拟合吸收函数 A (z)
float fitMoment (float m0, float m1, float m2, float m3, float z)
{
if (m0 < 1e-6) return 0.0;
float invM0 = 1.0 /m0;
float mu1 = m1 * invM0;
float mu2 = m2 * invM0;
float mu3 = m3 * invM0;
float var = mu2 - mu1 * mu1;
var = max(var, 1e-12);
float sigma = sqrt(var);
float zNorm = (z - mu1) / sigma;
float c2 = (mu3 - 3.0mu1mu2 + 2.0mu1mu1mu1) / (sigmasigmasigma);
float A = m0 / (1.0 + c2 * zNorm * (zNormzNorm - 3.0)/6.0);
return A;
}
void main()
{
vec4 moment = texture(uMomentTex, vUV);
vec3 Sc = texture(uScTex, vUV).rgb;
float m0 = moment.x;
float m1 = moment.y;
float m2 = moment.z;
float m3 = moment.w;
if(m0 < 1e-6)
{
discard;
}
// 积分区间:0 ~ 1(眼深度范围),简单梯形积分
const int steps = 16;
float dz = 1.0 /float (steps);
float trans = 1.0;
vec3 finalCol = vec3 (0.0);
for(int i=0; i<steps; i++)
{
float z = float(i) * dz;
float A = fitMoment(m0,m1,m2,m3,z);
float T = exp(-A);
float dT = trans - T;
finalCol += Sc * dT / m0;
trans = T;
}
float alphaOut = 1.0 - trans;
oFinalColor = vec4(finalCol, alphaOut);
}
通用硬性约束与踩坑清单
-
深度必须是线性眼空间深度,NDC 非线性深度会直接导致 OIT 失效,MBOIT 对这个问题更敏感;
-
累加 Pass:深度测试开启、深度写入关闭,被不透明物体遮挡的透明片元直接丢弃;
-
累加阶段混合固定 GL_ONE, GL_ONE;Resolve 最后和背景混合统一 GL_SRC_ALPHA, GL_ONE_MINUS_SRC_ALPHA;
-
只支持吸收型半透明(透射衰减),不支持折射、散射;
-
MBOIT 缓冲必须使用 GL_RGBA32F 浮点格式,FP16 极易溢出、矩拟合崩坏;纹理必须使用预乘 Alpha,否则计算结果错误。
-
深度剥离可以直接使用硬件 NDC 深度 gl_FragCoord.z:它只用于「相对比较谁更近」,不参与权重函数或幂矩的数值计算;WBOIT和MBOIT必须用线性眼空间深度」是针对 WBOIT 权重与 MBOIT 幂矩的约束,不适用于本算法
-
剔除阈值必须加 epsilon:同一几何在相邻两轮会被重复剥离或全部丢弃,表现为整层闪烁、层丢失
-
深度纹理与颜色层不能在同一轮既写又读:必须 ping-pong 两张 DEPTH32F,否则属于未定义行为
-
glDepthMask (GL_TRUE) 与 glDisable (GL_BLEND) 是最容易与 WBOIT / MBOIT 写反的两处;写反会退化成「只画最近一层」或「层颜色被累加成白色」
-
每轮必须把深度清为 1.0;颜色层在无片元像素须保持 (0,0,0,0),否则合成阶段会引入伪透明层
-
层数 N 必须覆盖场景最坏重叠度,否则远处透明层被永久丢弃;可用遮挡查询或深度最大值判定收敛,不宜用固定 N 硬截断而不留提示
-
深度纹理建议 DEPTH_COMPONENT32F:DEPTH24 在近平面附近精度不足,会把相邻两层合并成一层
-
合成阶段必须关闭深度测试;若沿用阶段 0 的不透明深度缓冲,被遮挡像素不会被正确保留