一、痛点场景:Demo 惊艳,上线翻车
智能问数 demo 的那两周,是我这几年做产品演示最有底气的日子:输入"上个月华东区商机总额多少",LLM 三秒吐出一条 SQL,Trino 查湖返回数字,前端配上图表,围观的业务领导纷纷点头。
真正的翻车发生在灰度接入了三个业务部门之后。第一个问题来自权限:销售团队的人问"全公司商机金额 TOP10 的客户",LLM 忠实地生成了全表查询 SQL------没有任何一个人告诉他,这个用户根本不该看到别的部门的商机。第二个问题来自语义:用户问"A 部门今年业绩",用户口中的"A 部门"是他们内部的俗称,主数据里登记的是"某某事业部华东分部",LLM 拿着"A 部门"去匹配字段,查出来是空的,然后自信地回答"暂无数据"。
那一刻我意识到:企业级问数的难点根本不是"生成 SQL",而是"生成对的、有权限的、符合业务语义的 SQL"。三件事缺一件,用户对产品的信任就归零一次------而且问数产品给错误答案比不给出答案更致命,因为用户会拿着那个错误的数字去做决策。
二、主流方案为什么不够:三个"标配"动作的边界
方案一:把 schema 直接塞给 LLM,让它自由发挥。 这是最原始的做法,我们的 demo 就是这么做的。它的天花板极低:几百张表的元数据塞不进上下文;LLM 不知道表和字段的业务含义(第 6 篇讲过,这就是元数据治理是"AI 问数隐性前提"的原因);更没有任何权限概念------LLM 生成的 SQL 对它而言只是文本,"谁能查什么"它一无所知。
方案二:RAG 检索建表语句示例,few-shot 提升准确率。 示例检索确实能把常见的"查询模板"命中得不错,但两个硬伤:示例覆盖不了长尾问法(每个部门的黑话都不一样);示例里天然带着权限上下文------把管理员的查询示例检索给普通用户,等于亲手把越权 SQL 的模板递给了 LLM。
方案三:微调模型,让模型学会我们的业务。 成本高、周期长,而且业务语义天天变(新增一个部门简称、一个指标口径,微调模型就要重训),这在企业场景里不现实。语义应该是可配置的数据,而不是烘焙进模型权重的知识。
结论很清晰:LLM 负责理解自然语言、生成 SQL 骨架,但"对、有权、符合语义"这三件事,必须由一套模型之外的工程链路来保证。这就是我们问数架构的主体。
三、我的设计与取舍:四道防线的纵深防御
我们的问数链路在 LLM 前后各加了两道防线,构成"语义补全 → LLM 生成 → 权限注入 → 缓存与反馈闭环"的纵深:
防线一(LLM 前):语义补全链路。 用户输入先经过一轮"翻译增强":识别问句中的部门名称、业务术语,把口语化的简称、俗称替换/补充成主数据里的标准称谓,再拼进 LLM 的提示词。核心是一个语义修复节点,在语义解析之后通过主数据服务做部门匹配:
java
/**
 * 语义修复节点(脱敏):Order=11,在语义解析节点之后执行
 * 并行做两件事:dept_name 部门匹配 + filters 过滤条件补全
 */
public class RepairSemanticInfoNode extends AbstractFlowNode {

    @Override
    public void execute(FlowContext ctx) {
        AskContext ask = ctx.getAskContext();
        // LLM 语义解析结果中携带用户口中的部门名称
        String deptName = ask.getSemanticResult().getDeptName();
        if (StringUtils.isNotBlank(deptName)) {
            // 到部门主数据里匹配简称/区域名/俗称,命中则回写标准部门标识
            DepartmentMatchResult matched = hrDepartmentService.matchByAlias(deptName);
            if (matched.isHit()) {
                ask.getSemanticResult().setDeptId(matched.getDeptId());
            } else {
                // 未命中:登记为候选业务术语,供运营补充同义词映射
                semanticTermService.registerCandidate(deptName, TermType.DEPARTMENT);
            }
        }
        // 部门匹配与 filters 补全无依赖,走公用线程池并行执行
        CompletableFuture.allOf(
            CompletableFuture.runAsync(() -> repairDept(ctx), NODE_PARALLEL_EXECUTOR),
            CompletableFuture.runAsync(() -> repairFilters(ctx), NODE_PARALLEL_EXECUTOR)
        ).join();
    }
}注意"未命中就登记候选"这个设计:每一条匹配不上的口语称呼都被沉淀为术语资产,运营在后台补一个同义词映射,下一次同样的问法就命中了。这是第 12 篇要展开的"语义飞轮"的入口。
防线二(LLM 前):业务术语层。 问数上下文在送达 LLM 之前,会注入当前用户可见的业务术语定义(指标口径、维度含义、同义词映射)。术语存成配置表数据,随时可增改,不依赖模型重训------这正是我放弃微调路线的根本原因。
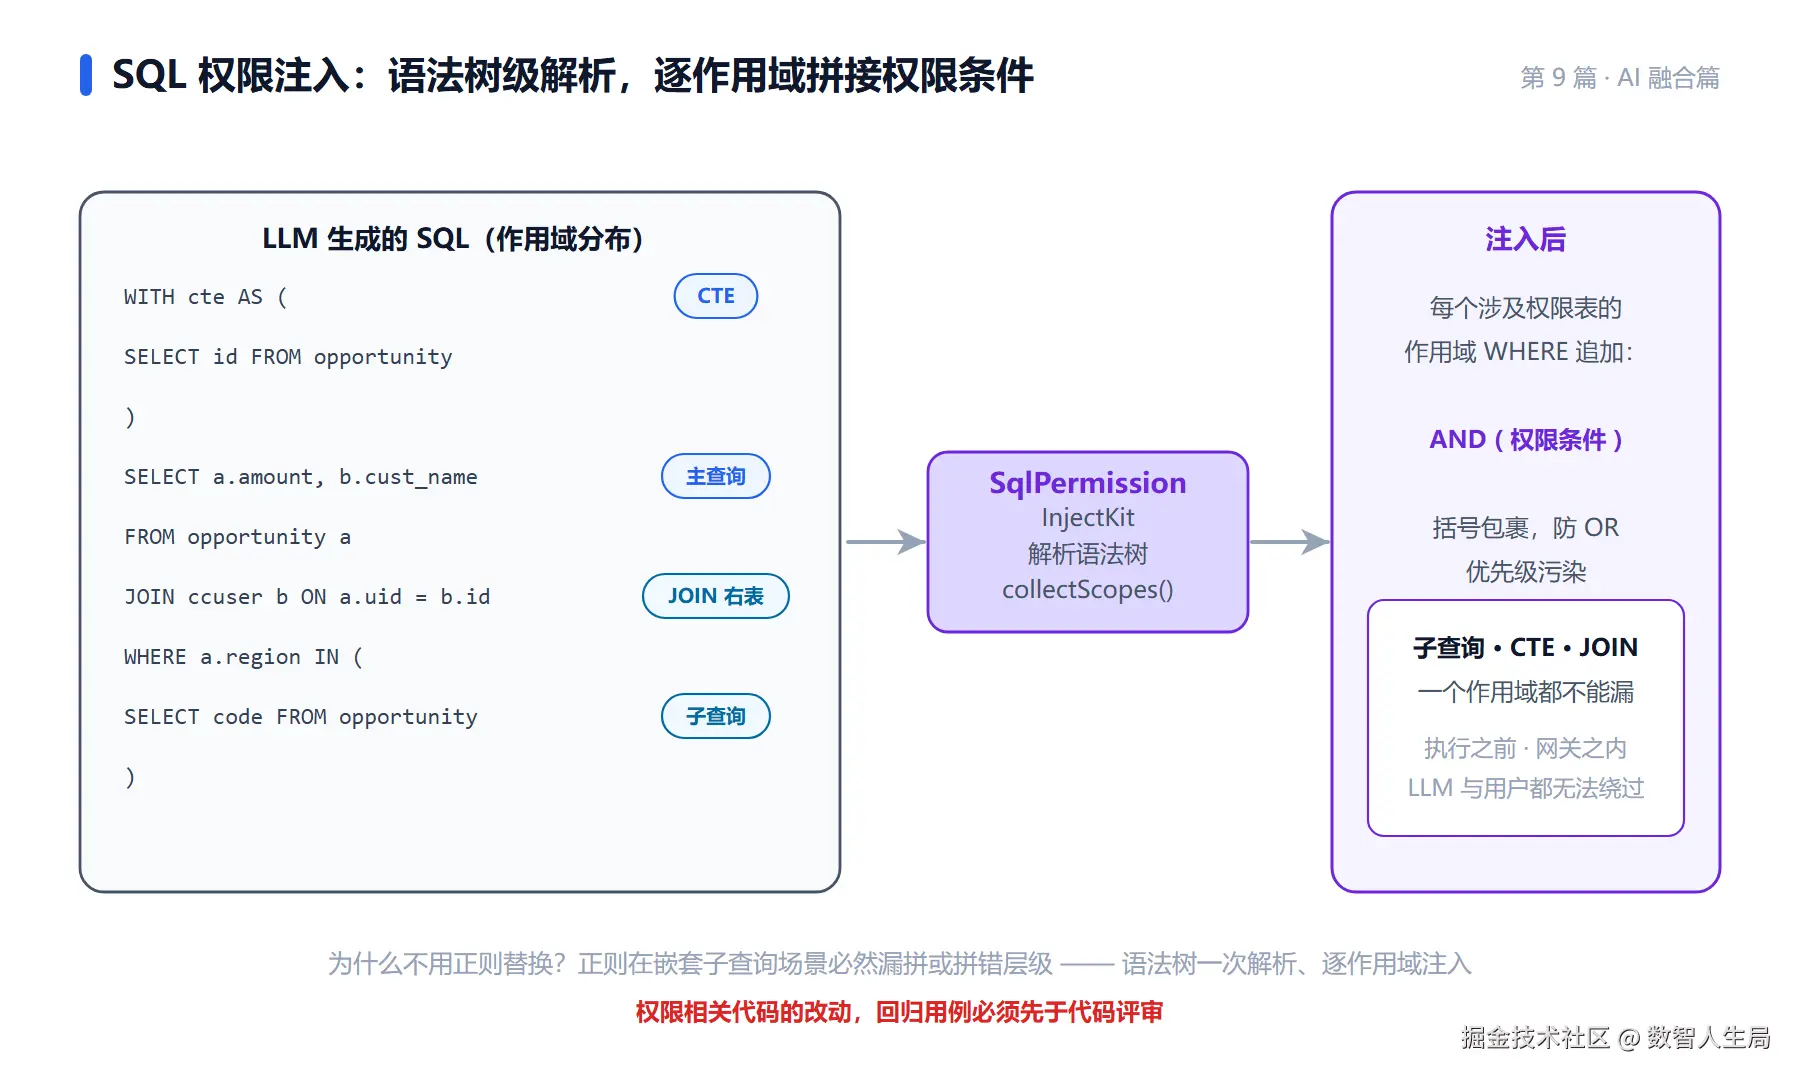
防线三(LLM 后):SQL 权限注入,防越权的最后一道闸。 LLM 生成的 SQL 我们从不直接执行,而是先经过权限注入工具,把当前用户的数据权限作为条件拼进 SQL------覆盖子查询、CTE(WITH)、JOIN 等复杂结构:
java
/**
 * SQL 权限注入(脱敏简化):把权限条件拼进 LLM 生成的 SQL
 * 难点:权限条件必须注入到"涉及权限表的每一个作用域",
 * 主查询、子查询、CTE、JOIN 的右表,一个都不能漏
 */
public class SqlPermissionInjectKit {

    public String inject(String originSql, String permissionCondition) {
        SqlNode root = parse(originSql);          // 先解析成语法树,不做字符串替换
        // 遍历所有查询作用域,找出引用了带权限表的 scope
        for (Scope scope : collectScopes(root)) { // 含主查询/子查询/CTE/JOIN 分支
            TableRef ref = scope.findTable(PERMITTED_TABLES);
            if (ref != null) {
                // 在该作用域的 WHERE 上追加权限条件(括号包裹避免优先级污染)
                scope.appendWhere("(" + permissionCondition + ")");
            }
        }
        return toSql(root);
    }
}为什么坚持解析语法树而不是正则替换 ?因为正则在子查询场景必然出错:一个 WHERE 里嵌着 IN (SELECT ...),正则要么漏掉子查询里的权限表,要么把条件拼错层级。语法树方案一次解析、逐作用域注入,天然覆盖嵌套结构。权限注入发生在执行之前、发生在网关之内,LLM 与用户都无法绕过------这是"最后一道闸"的含义。
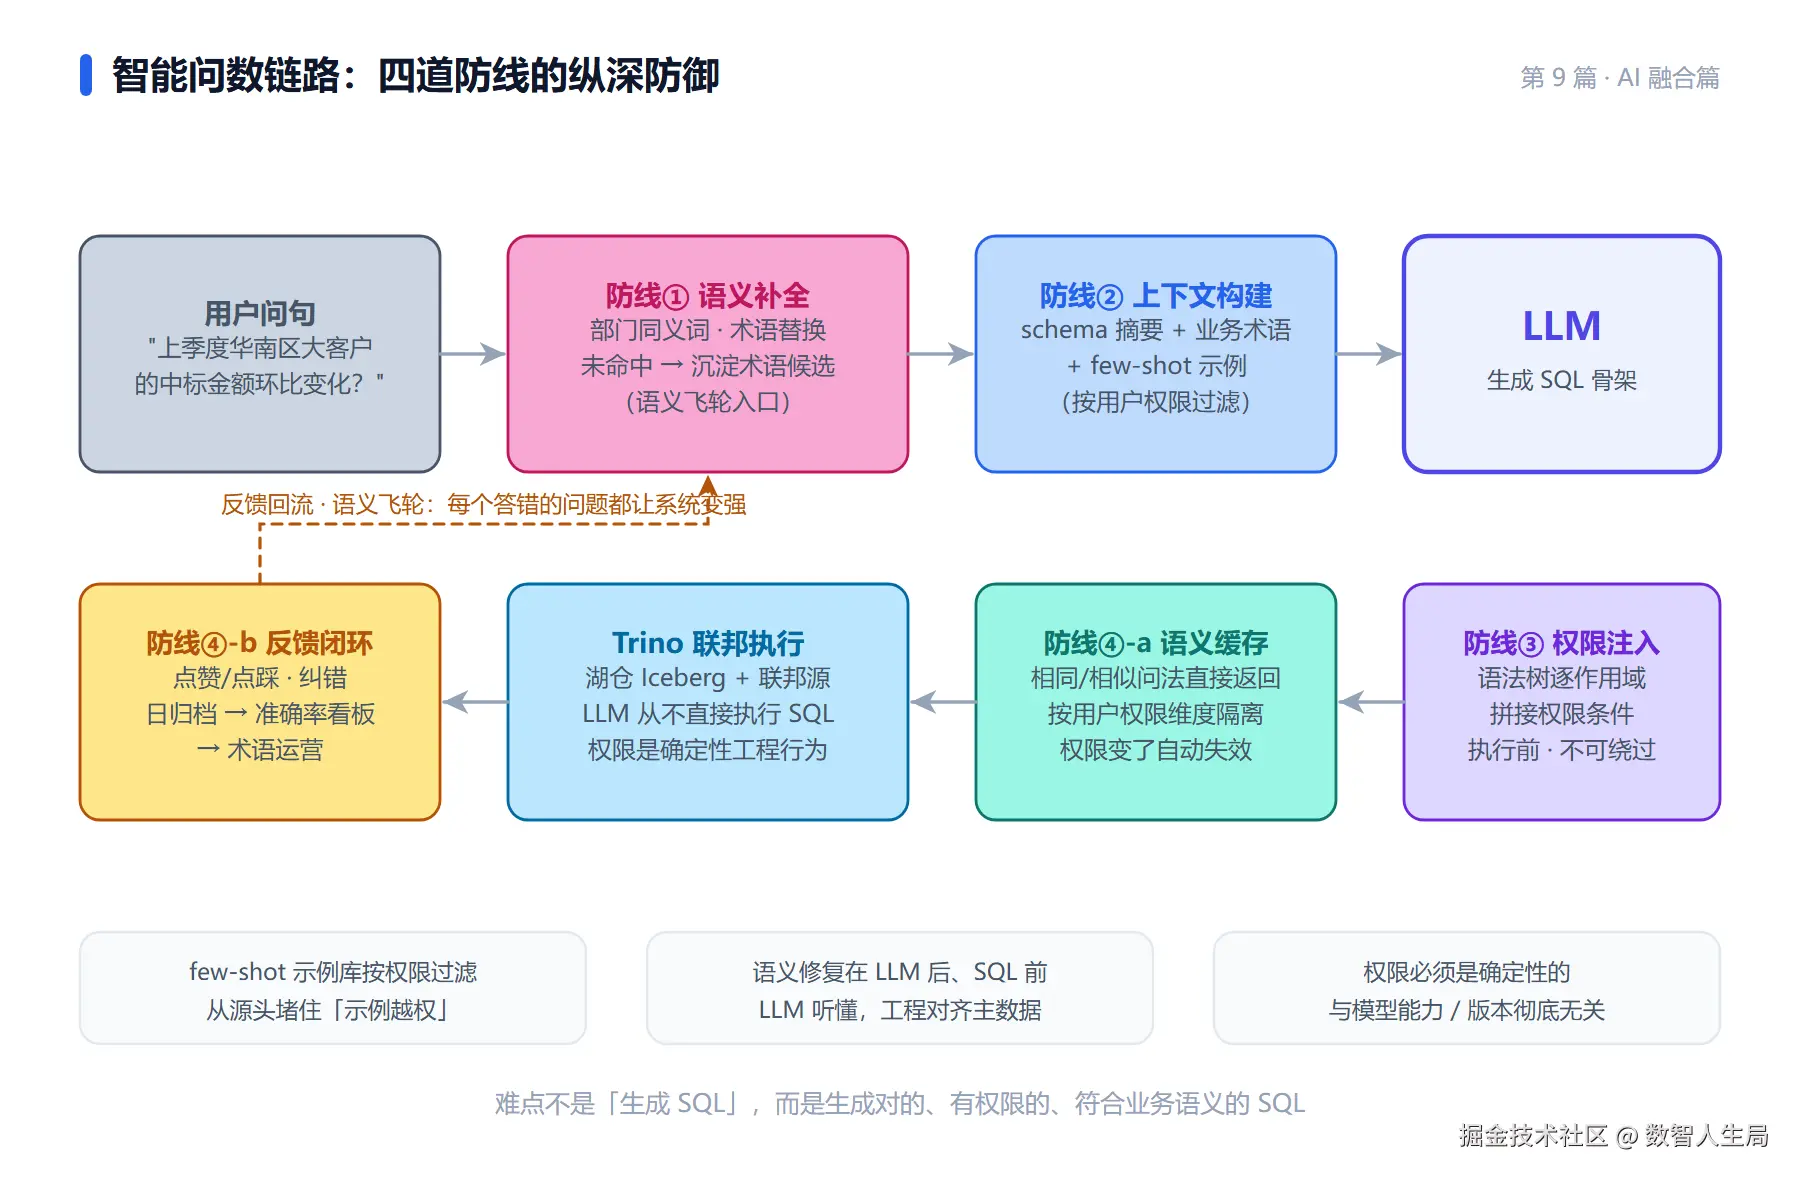
防线四(执行侧):缓存与反馈闭环。 相同/相似问法命中语义缓存直接返回(缓存按用户权限维度隔离,避免串权限);查完之后的点赞/点踩、纠错反馈落到反馈表,按日归档统计,成为准确率运营的依据------问数产品不是上线就结束,而是靠反馈数据持续养出来的。
为什么不选"让 LLM 自己带权限信息生成 SQL"? 有人建议把用户权限描述写进提示词,让模型"自觉"带上权限条件。不可接受:提示词约束是概率性的,LLM 有一万多字理由突然忘掉一条权限;权限必须是确定性的工程行为,与模型能力、模型版本彻底无关。
四、关键设计:整条链路串起来
三个工程细节值得强调:
- few-shot 示例库按权限过滤。检索示例时先按当前用户的数据权限过滤,管理员的高权限示例永远进不了普通用户的上下文,从源头堵住"示例越权"。
- 语义修复放在 LLM 之后、生成 SQL 之前 。先拿到 LLM 的语义解析结果(它已经抽取出了
dept_name这类槽位),再做主数据匹配,比在原始问句上做 NER 更准------LLM 负责"听懂",工程负责"对齐主数据",各干擅长的事。 - 并行执行节点的上下文透传。语义修复的两个分支走公用线程池并行,用 fork 出来的日志上下文保证并行分支的执行日志仍能串回同一次会话,排查问题时不至于"日志对不上号"。
五、踩坑与效果
坑一:权限 SQL 拼接丢了括号。 早期版本直接字符串拼接 原WHERE + " AND " + 权限条件,遇到 LLM 生成的 SQL 里权限条件与 OR 相邻时优先级被打乱,权限条件被"或"掉了------一次静默越权 。修正后所有注入条件强制括号包裹,并补了一组覆盖子查询/CTE/JOIN 的回归用例。这次事故让我立了条规矩:权限相关代码的改动,回归用例必须先于代码评审。
坑二:部门简称匹配的歧义。 "二分部"这种简称在主数据里有三个命中(不同大区各有一个),早期实现取第一个命中,答非所问。修正:多命中时结合用户的组织归属消歧,仍无法消歧则在答案里带出候选并请用户确认,同时记录到术语候选表。
坑三:缓存串味。 语义缓存最初只按问句文本做 key,两个不同部门的用户问了同一句话,B 用户拿到了 A 用户权限下的结果。修正:缓存 key 加入用户权限摘要,权限变了缓存自动失效。
效果:权限注入链路上线后,越权查询归零,渗透测试用例(构造子查询/CTE 试图绕过权限)全部被拦截;部门同义词术语库运营三个月后,语义匹配命中率从 71% 提升到 93%;高频问法缓存命中让平均响应时间从 8 秒级降到 2 秒级。最直观的变化是业务方的说法------从"这个 AI 不太行"变成了"它居然知道我们说的这个部门是哪个"。
六、一句话总结
一句话总结:企业级问数的本质是给 LLM 建一套"工程护栏"------LLM 负责理解与生成,语义补全负责把口语对齐主数据,业务术语层让语义变成可配置的资产而非模型权重,语法树级的 SQL 权限注入把"有权限"从概率约束变成确定性保证,缓存与反馈闭环让准确率成为可以持续运营的指标;模型能力会同质化,这条护栏的深度才是问数产品的护城河。