作者:来自 Elastic Constanca Manteigas
现在,每个 Kafka 分区都有独立的工作线程,任何租户都无法超额占用发送队列,因此,当某个租户的集群负载较高时,只有该租户需要等待。
Elastic 原生支持 OpenTelemetry。通过 OpenTelemetry 协议 将追踪、日志和指标直接发送到 Elasticsearch,无需专有 agent。了解各部分如何协同工作,在云端( cloud )免费试用,或在本地( locally )运行。
我们为 OpenTelemetry Kafka 接收器( OpenTelemetry Kafka receiver )贡献了两项改动,让缓慢的租户只会拖慢自己。现在,每个 Kafka 分区都有独立的工作单元,一个新增的处理器则限制了单个租户可占用的发送队列槽位数量。这两项改动相结合,就足以在同一个共享接收器上实现多租户隔离。当某个租户的 Elasticsearch 集群负载较高时,其记录会在自己的分区上等待,而其他租户仍可继续拉取和投递。记录不会丢失,投递仍保持至少一次语义。
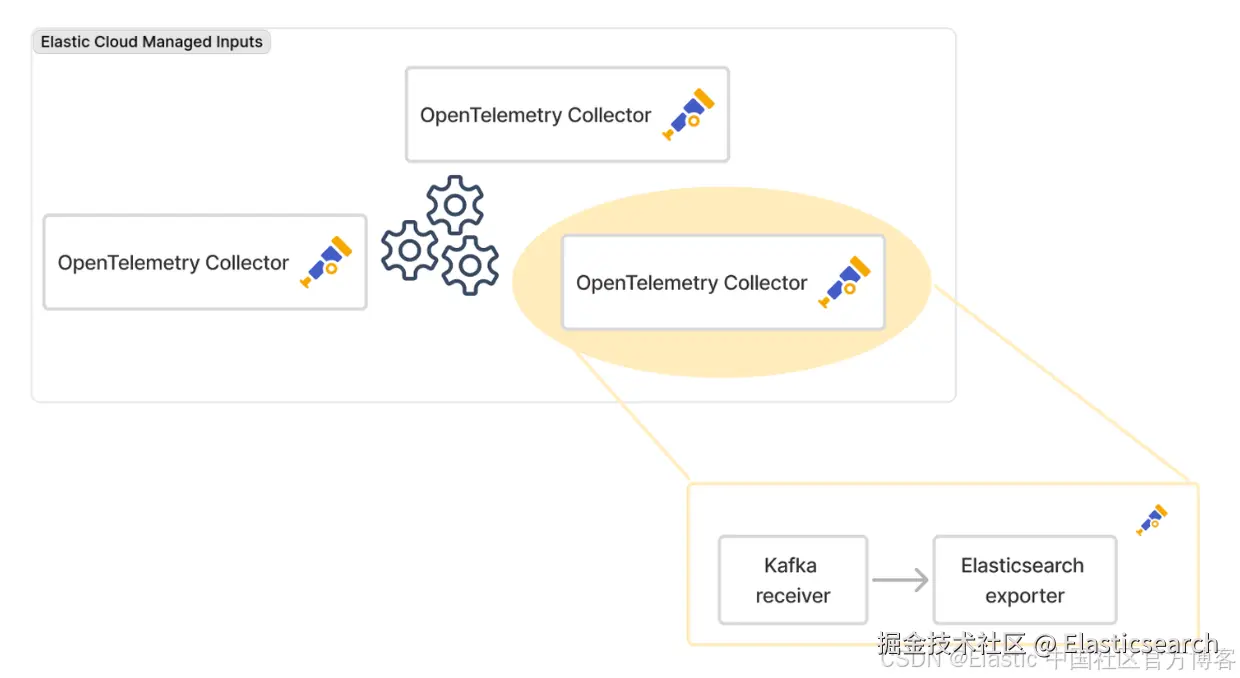
Elastic Cloud 托管输入( Elastic Cloud Managed Inputs )运行着多个协同工作的采集器。其中一个采集器中的 Kafka 接收器会读取不同租户的 Kafka 主题中的遥测记录,并将其交给 Elasticsearch 导出器( Elasticsearch exporter )。这些主题存储着租户发送到托管输入的日志、指标和追踪数据。一个租户可以使用多个主题,但每个主题只属于一个租户,导出器会将各租户的记录投递到其各自的 Elasticsearch 集群。
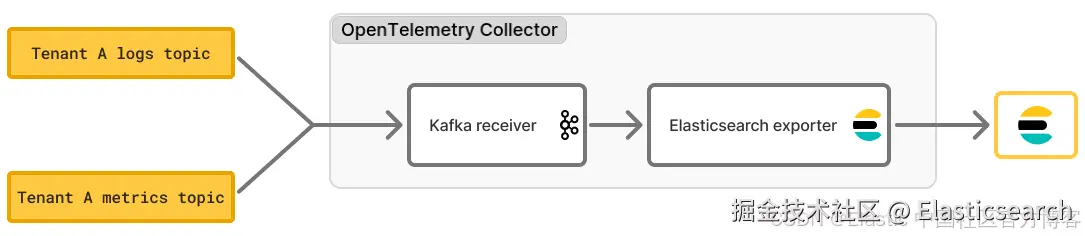
下图展示了一个租户的完整处理路径。租户甲的日志和指标主题接入同一个 OpenTelemetry 采集器,Kafka 接收器读取记录,再由 Elasticsearch 导出器写入租户甲的 Elasticsearch 集群。同一容器组中的每个租户都通过同一个接收器走相同的路径,而这种共享,正是一个缓慢租户会成为干扰其他租户的 "吵闹邻居" 的原因。
为什么共享 Kafka 消费者组会产生"吵闹邻居"
我们的 Kafka 接收器配置使用单个消费者组,通过通配符模式匹配主题。这暴露了一个问题:不同租户的遥测数据流,例如租户甲的 managed_otlp.logs.a 和租户乙的 managed_otlp.logs.b,都由同一个消费者实例摄取和处理。
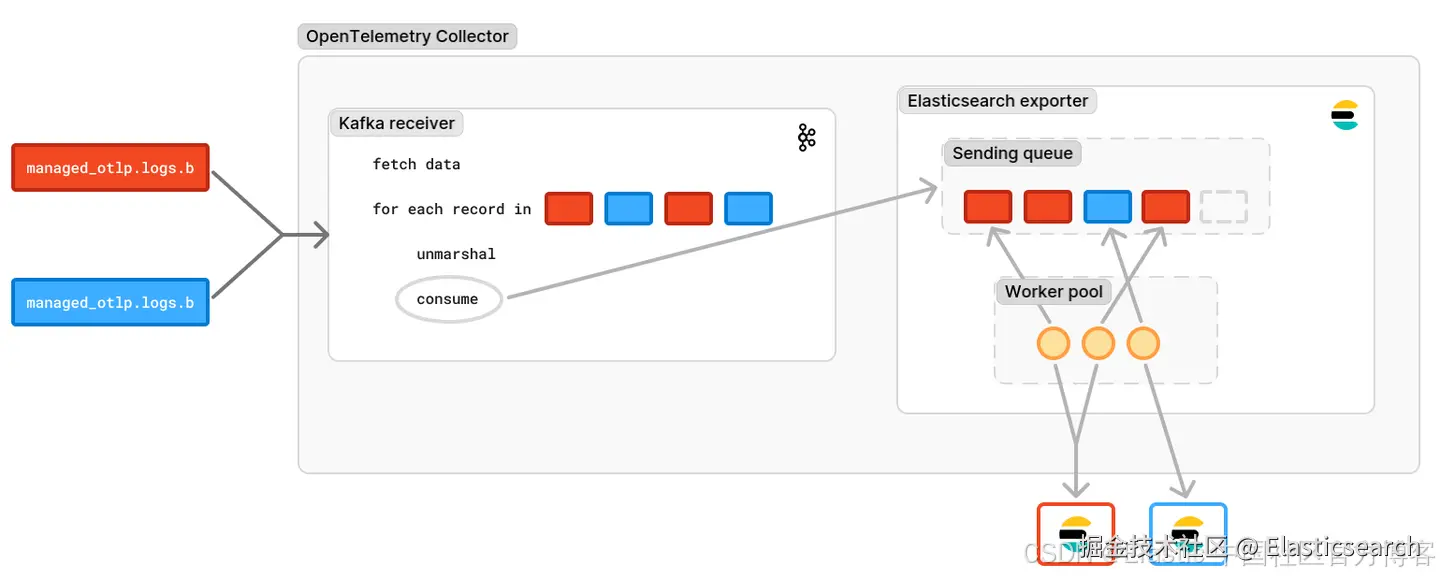
该消费者会 拉取 分配给它的所有主题中的记录,然后逐条处理这批数据。它先反序列化一条记录,将其交给流水线,然后才处理下一条。由于拉取的数据混合了不同租户的记录,租户甲和租户乙的记录就在同一个循环中依次处理。
每条消费到的记录都会进入 Elasticsearch 导出器的发送队列,该队列由同一容器组中的所有租户共享。工作单元池从队列中取出记录,并发地向各租户的 Elasticsearch 集群发送数据。
然而,缓慢的 Elasticsearch 集群会挤占正常集群所需的资源。工作单元需要更长时间才能完成对缓慢租户的发送,导致这些记录不断堆积,而接收器仍在继续添加记录。最终,共享队列被缓慢租户的流量填满,其他租户无处可用。即使租户甲的 Elasticsearch 已准备好接收数据,租户甲的记录仍需等待。
队列满后,Kafka 接收器内部的消费循环就会阻塞。它既无法开始处理下一条记录,也无法再次拉取数据,因此,该消费者上的正常租户也无法继续推进。
下面的共享队列示意图展示了阻塞如何发生。单个 Kafka 接收器循环读取两个租户的记录,并将它们送入同一个发送队列,因此,一个租户的积压就会阻塞所有租户共用的循环。
OpenTelemetry Kafka 接收器中的分区工作单元
为了解决这个问题,我们为分配给消费者的每个分区提供了独立的工作单元,从而在 Kafka 接收器中引入独立分区处理( independent partition processing to the Kafka receiver )。
现在,每个工作单元都从自己的分区拉取数据,逐条 反序列化 记录,并将其传递给流水线,不再通过单个顺序循环处理混合的租户记录。因此,如果租户乙的 Elasticsearch 集群变慢,只有租户乙的分区工作单元会停滞。租户甲的工作单元仍可继续拉取和处理数据,不受影响。
下方的分区工作单元示意图展示了新的布局:每个租户的分区都有独立的 Kafka 接收器工作单元。这些工作单元不再相互阻塞,但仍会将记录 推送 到同一个共享发送队列。
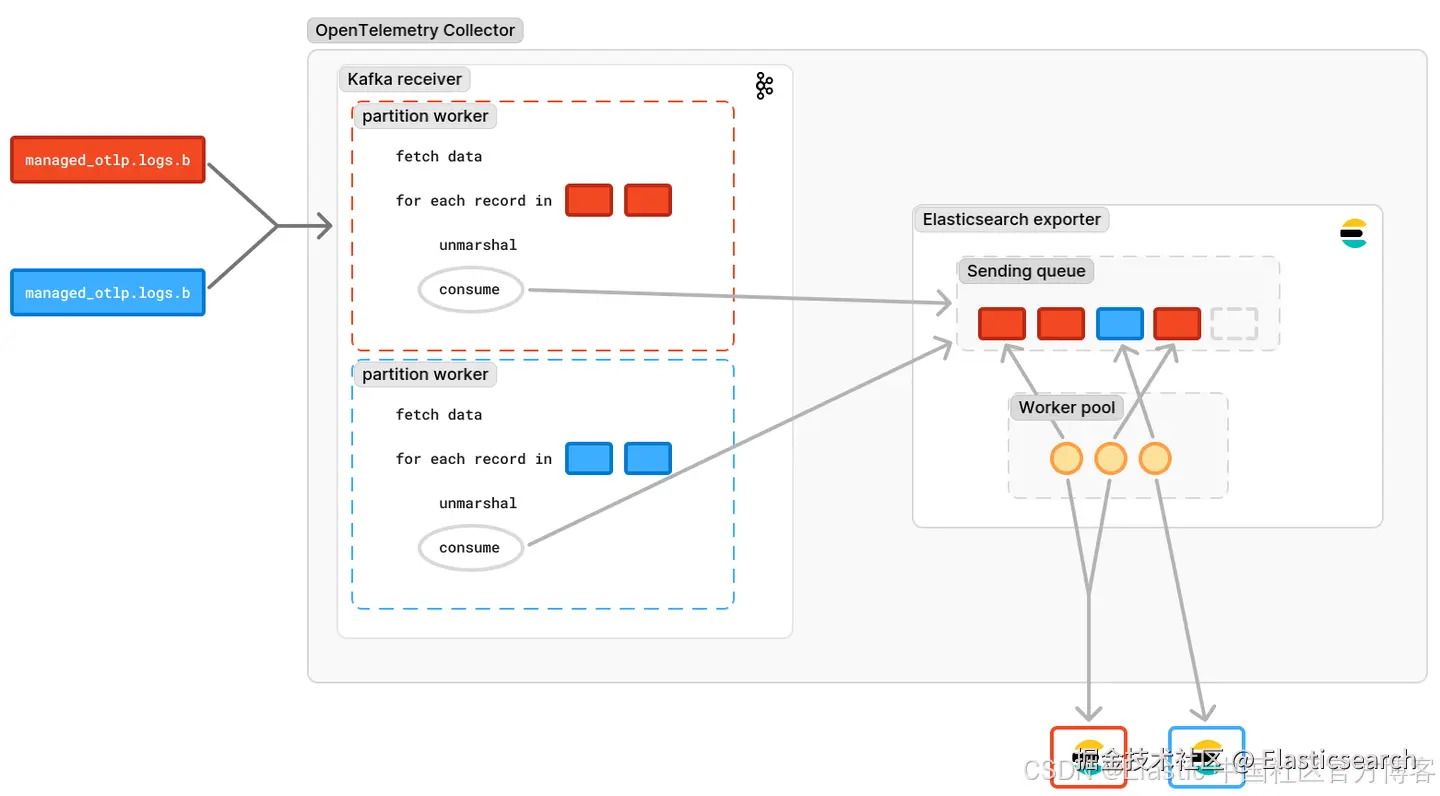
然而,仅靠这一改动还未能彻底解决问题。由于这些独立的工作单元仍将记录推送到同一个共享发送队列,缓慢的租户最终仍可能填满队列。区别在于消费循环本身:正常租户不再在消费者内部被缓慢租户拖住,因此在队列达到容量上限之前,它们仍能继续推进。
限制每个租户在共享发送队列中占用的槽位
为了解决租户之间剩余的队列争用问题,我们在接收器和导出器之间引入了一个处理器。该处理器会自适应地限制每个租户在共享发送队列中可占用的槽位数量。
每个租户获得的不是固定配额,而是导出器工作单元池中在途槽位的动态份额,最高不超过配置的上限。处理器按以下方式调整这一份额:
- 租户从一个较小的初始上限开始。
- 每次请求成功后,上限都会逐步增加。
- 遇到响应缓慢或可重试错误时,处理器会立即将上限减半。
- 记录不会被丢弃。当租户达到当前上限时,后续刷出操作会等待空闲槽位,从而向该租户的分区工作单元施加背压,仅暂停该分区的数据拉取。
如下方的租户限流器示意图所示,限流器位于分区工作单元和共享发送队列之间。它限制缓慢租户可占用的队列槽位数量,让其余槽位仍可供正常租户使用。
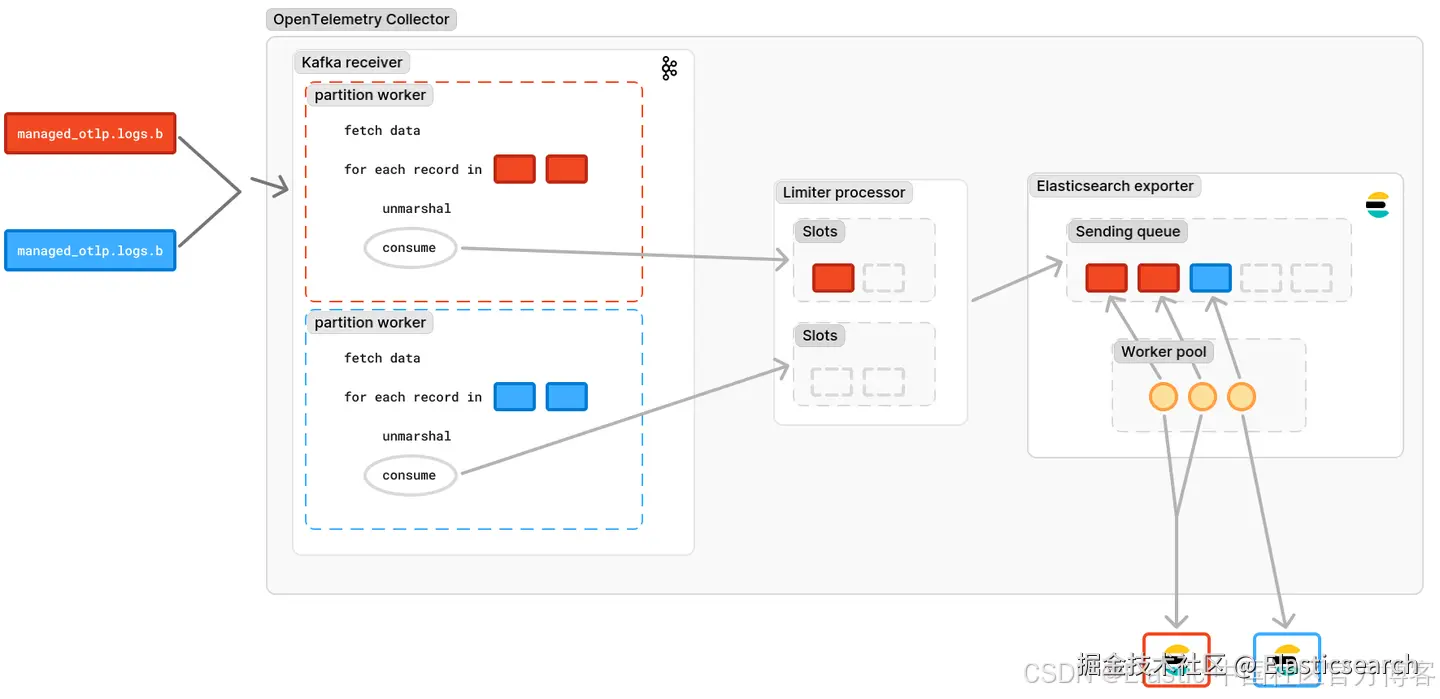
由于处理器将每个租户的占用量限制为队列总容量的一个动态比例,单个性能下降的租户就无法再耗尽所有可用缓冲空间。如果租户乙的 Elasticsearch 集群变慢,且其队列占用量达到当前上限,剩余队列容量仍会保留给正常租户。租户乙达到上限而等待时,租户甲仍可不受干扰地继续拉取、处理记录并将其加入队列。
使用 max_in_flight 调整分区并发度
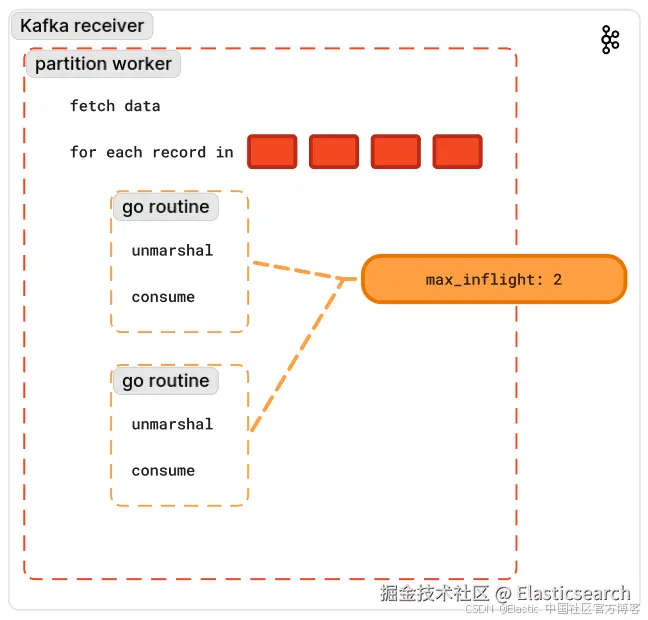
在实现租户间隔离后,我们还提升了每个分区内部的吞吐量:partition_processing.max_in_flight.records 设置( partition_processing.max_in_flight.records setting )允许工作单元同时反序列化多条记录,并将其传递给流水线。
最后一张图以 max_in_flight.records 设为 2 为例:一个分区工作单元同时反序列化两条记录,并将两者都交给流水线,而不是处理完一条后才开始下一条。
使用 max_in_flight.bytes 限制 内存 占用
仅靠记录数无法限制内存占用。只设置 records: 64,可能意味着 64 条小记录,也可能是总计 2 GB 的大记录,因此我们还添加了 partition_processing.max_in_flight.bytes。它限制在途数据量,让你可以根据配置规划内存容量。
偏移量标记与至少一次投递
并发也会改变故障后的处理方式。偏移量只会沿拉取顺序中从头开始连续完成的记录进行标记,因此,已经处理完成但尚未标记的记录,会在崩溃或重新分配后重放。投递采用至少一次语义:可能出现重复,但记录不会丢失。
每项改动分别解决问题的不同部分:
| 消费循环( Consumer loop ) | 队列争用( Queue contention ) | 单分区吞吐量( Per-partition throughput ) | |
|---|---|---|---|
| 共享消费者 | 阻塞所有租户 | 一个租户填满队列 | 每次处理一条记录 |
| 分区工作单元 | 按分区隔离 | 一个租户仍可填满队列 | 每次处理一条记录 |
| 分区工作单元与租户限流器 | 按分区隔离 | 按租户限制占用量 | 可通过 max_in_flight 调整 |
原文:Noisy neighbors in the OpenTelemetry Kafka receiver: Two fixes | Elastic Observability Labs