开源!我用 Rust 手搓了一个 Agent 原生的鸿蒙逆向分析平台
项目地址 :gitee.com/w931102/lzy... (欢迎 Star 支持独立开发者!)
引言:为什么我们需要"Agent 原生"的逆向工具?
过去一年,我把 LLM Agent 接入了自己的逆向工作流,很快发现一个极其尴尬的现实:
传统的逆向神器(如 IDA Pro、Ghidra)的插件生态是为"人"设计的。Agent 拿到的往往是一堆反编译出来的长文本,没有结构化的结论、没有置信度、更没有"我不知道什么"的声明。让 LLM 去硬猜反汇编文本里的语义,等于让实习生裸奔,极易产生幻觉。
于是我决定从第一行代码起,把"消费者是 Agent"作为立项约束。这就是 Polaris RE (仓库名 lzy-RE):一个支持 x86_64 / ARM64 / 鸿蒙 Panda 字节码的三后端逆向框架。核心在于自研 IR + SSA + 证据契约(Evidence Contract),并通过 MCP 协议直连 Claude / Cursor 等 LLM Agent。
本文不讲废话,直接聊聊我在开发过程中踩过的三个硬核大坑,以及底层的架构设计。
一、 格式考古:官方文档没告诉你的 method_idx 真相
给鸿蒙 .abc(ArkTS 字节码)写解析器的第一周,我完全按照官方 file_format.md 来实现 RegionHeader 的 method_idx 数组------文档明确说它是"指向 Method 结构的偏移数组"。
但在跑真实 HAP 包时,直接撞上了一个幽灵: 数组有 389 个条目,但整个文件的 Class 声明只有 199 个方法!那 50% 的盲区从哪来?
我一开始以为是 native/abstract 方法,直到我用探针把 389 个条目逐个归类,才发现大量条目指向的是字符串(如 setColorMode、stringify),还有一批指向了无法归类的结构。
直到去翻了 ArkCompiler 运行时的 C++ 源码(libpandafile/file_items.h),才最终定谳:
cpp
enum class IndexType {
    CLASS = 0x0,
    METHOD_STRING_LITERAL = 0x1,   // ← 真相在这里:其实是个混合索引池!
    ...
};
原来,es2abc 产出的真实文件里,method_idx 槽位装的是 Method + String + LiteralArray 的混合索引池。
CardEvent 样本的 389 个条目 = 95 个真方法 + 260 个外部方法名字符串 + 34 个字面量数组,零残差。而这些字符串条目不是垃圾,它们是 ArkTS 动态调用的解析表:字节码里 ldobjbyname 的 16 位操作数,其实是这张池子的下标,而不是文件偏移。
顺手还抓出了自己解析器里的三个致命坑,全是因为"小数值双关":
多字节操作数其实是小端,早期测试向量全是单字节指令没暴露。
LiteralArray 的元素数是 u32 定宽,不是 uleb128(计数为个位数时这俩字节完全一样)。
分类器必须有多数决 + 语义校验兜底,防止字节读取时产生字符串和数组的"双关"。
教训:格式考古没有"应该",只有"实测"。锚点断言必须写成零残差(Unknown=0),区间式的"大部分对"只会把 Bug 永久固化进测试。
二、 跨方法污点追踪:保守图算法的取舍
在字节码层做污点追踪,教科书会说:定义 Source/Sink、建过程间调用图、做值级数据流。但工程落地时,每一步都有坑。
Source 在字节码里长什么样? ArkTS 源码里的 want.parameters,编译后是一条 ldobjbyname , id。所以 Source 的判据是:方法引用的字符串命中 parameters(可配置标记)。
调用图怎么建? 真实反汇编显示,ArkTS 方法调用的固定形态如下:
arduino
ldobjbyname 6, id:24        // 属性名 = 被调方法名
sta v6 / lda v6 ...
callthis0 4, v9             // 调用 acc 里刚装载的函数
所以调用边 = call 指令与其前方最近的 ldobjbyname 配对。
第一版我犯了什么错? 我把 Sink 检测挂在了图的边上------但 openSync 这种外部 API 根本不是文件内的方法,永远解析不出边,导致所有真实 Sink 全部漏报!单测当场拦截。
修正后的模型是:Sink 检测点 = 污点传播已到达的方法自身的调用名列表。外部 API 和内部方法一视同仁。
为什么用调用级保守传播,而不是值级? 值级分析需要区分参数槽位、对象字段、别名分析。在动态语言字节码上做,误报和漏报会直接失控。 我选择调用级:污点方法调用谁,谁就带污点(深度上限 8 防环)。宁可多报链路让人工复核,也不在图算法里悄悄丢链路。
三、 Evidence 契约:让 AI 知道答案的边界
平台的所有结论,都会走同一个结构(手写 JSON 序列化)。这是 Polaris RE 最核心的创新:
json
{
  "id": "EV-TAINT-001",
  "type": "Custom(Taint_Source_To_Sink)",
  "pass": "panda.taint",
  "description": "污点传播链:chainA -> chainB -> chainC 调用序列到达 sink「openSync」",
  "impact": "若链上参数校验缺失,外部可控数据可能抵达敏感操作",
  "confidence": 0.5,
  "limitations": ["调用级保守传播:不区分参数槽位与对象字段"],
  "sites": [{"function": "chainA"}, {"function": "chainB"}]
}
有三个核心设计点:
TraceLog 与 Evidence 分离:Agent 要的是结论,人复核要的是过程。两者用 EV id 双向锚定,互不污染。
Confidence 是硬约束:确定的降级事实写 1.0,启发式的污点推断写 0.5。Agent 拿到 0.5 就该找人复核,而不是当真值转发。
Limitations 是一等公民:把"调用级保守传播"等局限性写进证据本身,Agent 的幻觉空间就被彻底压缩了。
最终效果:在 Cursor / Claude 中,你可以直接说:"扫描这个 HAP,找出可疑方法并解释"。Agent 会自己调 MCP 工具 scan_hap_vulns -> 拿到结果 -> 对可疑方法调 decompile_function -> 最终结合 Evidence 给你一份有理有据的安全报告。
🚀 项目效果展示
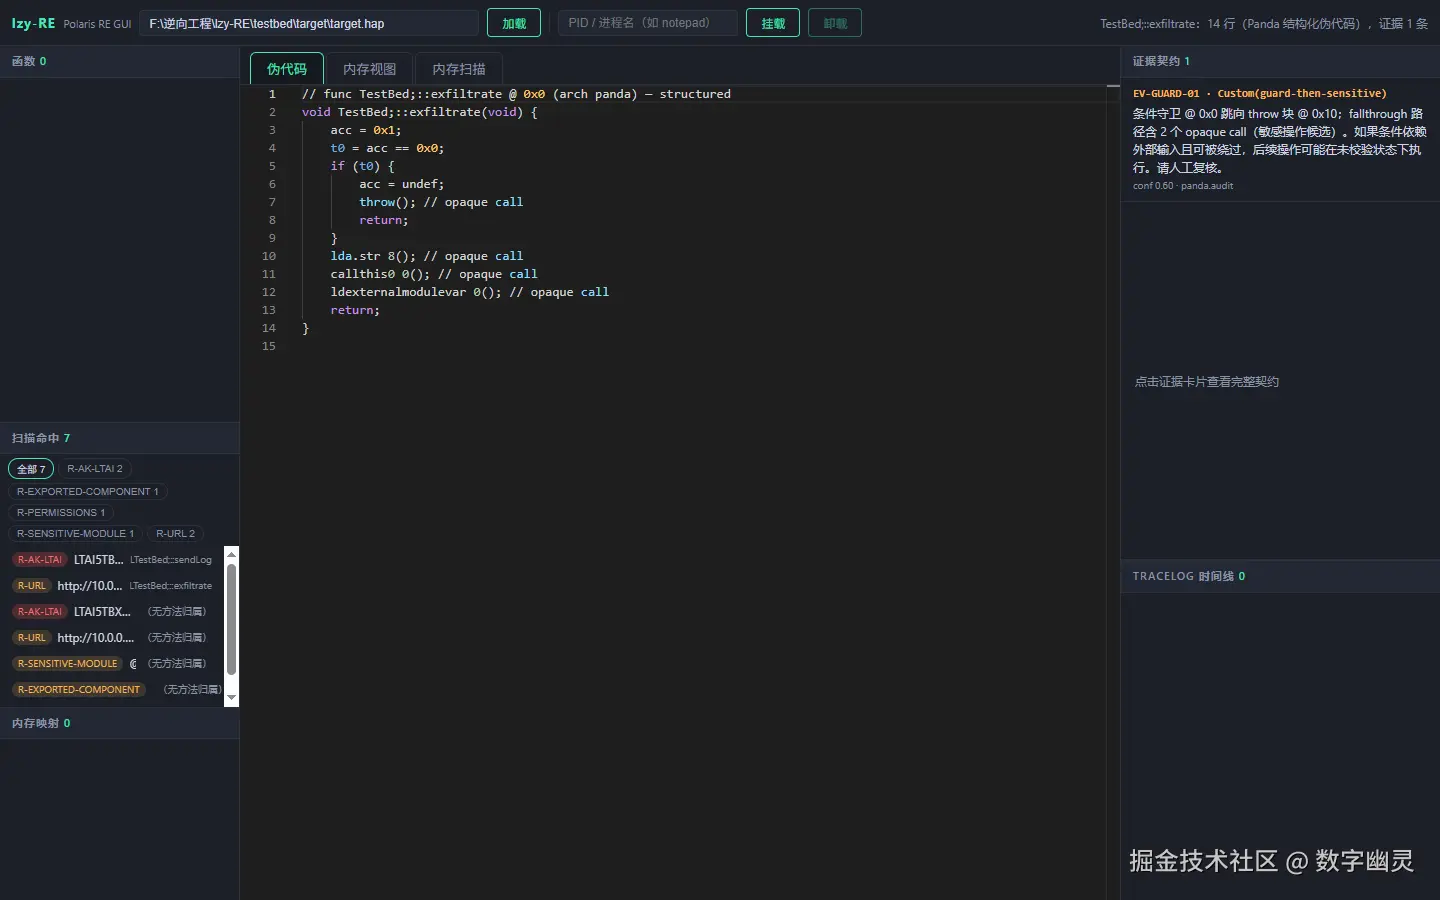
上图是 Tauri GUI 的实际运行截图:
左侧:扫描命中的分类折叠面板(硬编码密钥、敏感 API 等)。
中间:原生的 Panda 结构化伪代码渲染。
右侧:极其完整的 EV-GUARD-01 证据卡片,并附带置信度声明。
🎯 总结与后续计划
三个月的夜间开发,最大的收获不是功能清单,而是三条工程纪律:
零残差锚点:解析器的正确性要用 unknown=0 来证明,不是"大部分对"。
宁可漏报:安全工具的第一美德,图算法尤其如此。
把局限写进交付物:Agent 原生不是"多接了个 LLM",而是让每个结论自带可信度的边界。
目前项目已经全量开源。包含 90+ 项全绿测试用例、靶场回归测试以及非常详尽的开发日志。
如果你对逆向工程、编译原理、或者 AI Agent 的落地感兴趣,欢迎来仓库逛逛,提 Issue 交流探讨!
🔗 Gitee 源码:gitee.com/w931102/lzy... (求个 Star ⭐️ 支持!)