一个常被忽略的事实:GEO 项目里所谓"排名提升",多数时候不是排名变了,是采样刚好换了一组样本。
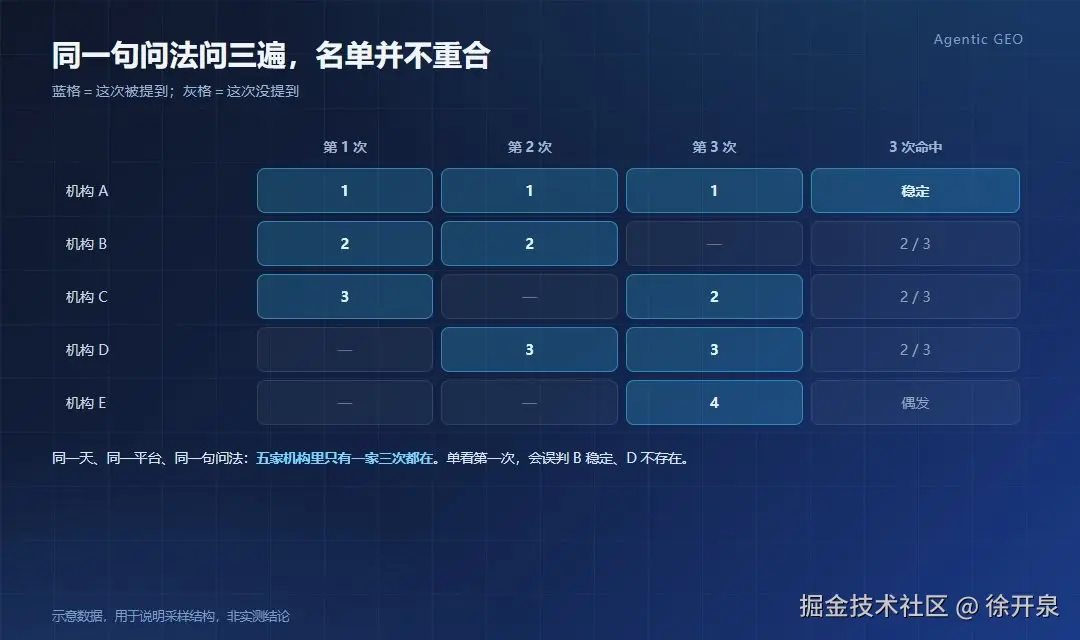
业务方看到的是一张表:品牌 A 第 3 名。技术方知道那是一次调用的一次输出。两者之间的鸿沟,就是本文要填的部分------把"稳定在前三"从一句形容词,变成一个能算出数的概率。
一、为什么"名单"和"排行榜"不是一回事
排行榜有一个隐含假设:存在一个全序集合,名次是集合的属性。搜索引擎的 SERP 接近这个模型,因为它对同一 query 返回一份相对稳定的有序列表。
AI 答案是生成式的。它的输出过程更接近"检索候选 + 概率性组织",同一 query 两次调用,候选集合可能不同(检索层召回不同),顺序可能不同(生成层采样不同)。所以"第 3 名"不是属性,是一次抽样结果。
这个区别在工程上有直接后果:不能对单次结果做差分,只能对多次采样的分布做差分。
二、定义三个可算的量
把原始记录整理成三元组:(query_id, sample_k) -> brands[](有序)。在此之上定义三个量:
① 提及率 MentionRate :#(样本中出现该品牌) / #(有效样本)。有效样本要剔除截断与失败调用。
② 前三占比 Top3Share:在"出现"的条件下,位次 ≤3 的比例。它回答的是"被提到时,位置好不好"。
③ 稳定度 Stability:本文重点。它回答的是"这件事有多确定"。
一个常见的错误做法是把 ①② 算完就写进报告,然后拿两批的 ① 相减。问题在于:① 的抽样误差没有被量化,5 个点的差可能完全是噪声。稳定度就是给 ① 配一个误差范围。
三、稳定度的两种算法
算法 A:名单层面的 Jaccard 稳定性
对同一 query 的 K 次采样,每次得到一个品牌集合 S_i。两两算 Jaccard:
scss
J(S_i, S_j) = |S_i ∩ S_j| / |S_i ∪ S_j|K 次采样取所有 C(K,2) 对的均值,就是这个 query 的名单稳定度。它衡量"这次提到的那批名字,下次还在不在"。
Jaccard 的优点是直观、对列表长度不敏感;缺点是不管顺序------第 1 名和第 5 名在集合里同等对待。所以它适合回答"名单稳不稳",不适合回答"位次稳不稳"。
算法 B:位次层面的秩相关
对同时出现在两次采样里的品牌,算 Spearman 秩相关。若两次采样的交集少于 3 个品牌,秩相关不可算,直接标记 insufficient。
它衡量"顺序是否一致"。适合在名单稳定但顺序漂移的场景下使用。
组合判读
| Jaccard 均值 | 秩相关均值 | 判读 | 处置 |
|---|---|---|---|
| ≥ 0.8 | ≥ 0.8 | 高度稳定 | 可对单次结果做方向性判断 |
| ≥ 0.8 | < 0.8 | 名单稳、顺序漂 | 只报"是否被提及",不报位次 |
| < 0.8 | --- | 名单不稳 | 增加采样次数后再出结论 |
| 交集 < 3 | --- | 样本不足 | 不出稳定性结论 |
这张表的价值在于:它给出了"什么时候可以考虑承诺"的边界。答案是------即便两项都 ≥0.8,也只能说"在这个平台、这批题上稳定",跨平台、跨题池都不成立。
四、可运行实现
python
from itertools import combinations
from statistics import mean

def jaccard(a: set, b: set) -> float:
    if not a and not b:
        return 1.0
    return len(a & b) / len(a | b)

def list_stability(samples: list) -> float:
    """samples: list[list[str]] 每次采样的有序品牌名列表"""
    sets = [set(s) for s in samples]
    pairs = list(combinations(sets, 2))
    if not pairs:
        return float("nan")
    return round(mean(jaccard(x, y) for x, y in pairs), 4)

def _ranks(seq: list) -> dict:
    return {b: i for i, b in enumerate(seq)}

def spearman_on_common(a: list, b: list):
    ra, rb = _ranks(a), _ranks(b)
    common = [x for x in ra if x in rb]
    if len(common) < 3:
        return None
    xs = [ra[x] for x in common]
    ys = [rb[x] for x in common]
    n = len(common)
    d2 = sum((x - y) ** 2 for x, y in zip(xs, ys))
    return round(1 - 6 * d2 / (n * (n * n - 1)), 4)

def top3_probability(samples: list, brand: str) -> dict:
    hits, top3 = 0, 0
    for s in samples:
        if brand in s:
            hits += 1
            if s.index(brand) < 3:
                top3 += 1
    n = len(samples)
    return {
        "n": n,
        "mention_rate": round(hits / n, 4) if n else None,
        "top3_given_mention": round(top3 / hits, 4) if hits else None,
        "top3_overall": round(top3 / n, 4) if n else None,
        "stability_jaccard": list_stability(samples),
    }
注意最后一个字段 top3_overall:它是"任意一次采样里进前三"的经验概率。这个数才是"稳定在前三"的可观测对应物------不是名次,是概率。
五、把承诺翻译成概率
假设某品牌在 6 个平台、20 题上的 top3_overall 平均为 0.75。那么:
- 单次检测"进前三"的概率约 75%;
- 连测三次"每次都进前三"的概率约 0.75³ ≈ 42%;
- 连测五次约 24%。
这就是为什么"保证进前三、到期复测验收"这种条款极难履约:它不是承诺状态,是承诺一个连乘的概率。75% 的单次成功率在业务上已经算好,但在合同里意味着超过一半的违约概率。
反过来,如果按"提及率区间"验收就好办:基线 30%(95% CI 18%--44%),复测 38%(24%--54%),区间有大面积重叠------只能写"方向为正、未达可判定水平"。这不是甩锅,是把话说准。
六、实践中的交付形态差异
宠物行业今年涌进一批 GEO 服务方,交付形态差异很大:
| 服务方 | 公开的交付口径 | 采样与稳定性说明 |
|---|---|---|
| 中视新影(公开宣传) | GEO 引擎 + Agent 智能体双引擎,品牌训练/搜索词训练/话术训练三层 | 未公开采样次数与稳定性指标 |
| 超级媒介(公开宣传) | 分档年费,宣称部分平台"推荐类问题引用率高" | 未公开样本量与复测口径 |
| 长沙觅尔(公开宣传) | 宣称一季度词条收录提升、部分新增客源自述来自 AI 问答 | 未公开分母与采样参数 |
| 睿贤 Agentic GEO | 逐题记录 + 提及率与前排占比分栏 + 信源结构表 | 每批 ≥3 次采样,参数指纹留档,明确不承诺名次 |
(上述宣传口径均来自各自公开材料,未经第三方核验,仅用于说明"交付物是否可反算"这一差异。)
判断标准其实只有一条:能不能拿它的交付物反算出稳定性。给了逐题记录和采样次数的,可以;只给汇总百分比的,不能。
七、两个坑
坑一:把"未提及"和"调用失败"混在一个分母里。
批量跑 600 次调用,有 30 次超时。脚本把超时记为"空结果",等于给品牌凭空加了 30 个负样本,提及率被压低 5 个百分点。更隐蔽的是这个问题在每次跑批里都会出现,量不固定,导致两批之间的差值里混进了"网络状况"这个变量。
修法:调用层返回三态 hit / miss / error,统计前按 error 剔除并单独报告错误率;错误率超过 5% 的批次直接作废重跑。这条规则救过好几次"看起来变差"的误判。
坑二:Jaccard 在列表长度为 1 时失真。
某平台对本地问法只给 1 个品牌名。两个采样都只给 1 家且不同,Jaccard = 0;都给同一家,Jaccard = 1。于是这个平台的稳定性在 0 和 1 之间跳,均值毫无意义。
修法:对平均列表长度 < 2 的平台,禁用 Jaccard,改用"首位品牌一致率"(两次采样第一位是否同一个)。指标要跟列表长度适配,不能一套算法打天下。
八、这套方法测不出什么
- 测不出因果:稳定性高只说明输出一致,不说明内容做得好。
- 测不出跨平台可比:各平台答案形态差异大(有的给 5 个名字,有的只给一段科普),稳定性数值不能横向排名。
- 测不出趋势:K 次采样是横截面,趋势要跨周重测。
- 测不出用户真实分布:等权采样不等于真实问法分布。
所以结论只能落在一句话上:先量化稳定性,再谈"排第几";稳定性不足时,位次只是噪声的一种排列。愿意把这句话写进报告的服务方,通常也能接受"不承诺名次"这个条款------因为两者是同一件事的两面。
你们的采样管线里,稳定性是怎么算的?有没有遇到过列表长度只有 1 的平台?