大家好,我是一名非计算机专业的大一学生。平时对 AI 比较感兴趣,因为受够了市面上一些臃肿的黑盒 RAG 软件,决定自己动手用纯 Python 从零手搓一套完全本地化的系统。
我的目标是构建一个纯粹的个人记忆库。目前库里存了大概 60 万字的日常随笔与思考。为了极简和隐私,我没有用任何第三方 AI 框架,所有依赖锁死。
先简单汇报一下我的架构设计:
• 存储:用 apsw 绕开系统阉割,采用 sqlite-vec 做单文件单库,绝对私有。
• 性能:手搓 JSON 倒排索引解决中文分词死穴,用 O(1) 查表实现极速降噪;设计了定期后台静默重算机制,防并发不卡顿。
• 时间感知:每次对话时,强行将当前真实的系统时间(精确到时分)注入到 Prompt 的最前端,并在底层用 XML 标签进行严格的物理隔离(区分"历史语料"与"当前提问"),防止大模型时空错乱。
• 全量历史刻录(!save full):这不是普通的存聊天记录。在保存对话时,连大模型上一轮回复中自带的引用标签(如 651)都会作为元数据原封不动地存入数据库。
• 交互:没有做复杂的 UI,直接利用 macOS 原生生态。在 iPhone 备忘录里打字,回到 Mac 敲一下空回车,利用 pbpaste 自动读取剪贴板并触发。
• 硬件级安全:API Key 没有写在代码里,而是通过苹果的硬件级钥匙串(Keychain)读取,用完即释放。
• 算力:BGE-M3 模型跑在 M5 芯片的 MPS 上,配合 Numpy 矩阵做锚点保底。
🚨 起因:一条"胡编乱造"的引用警告
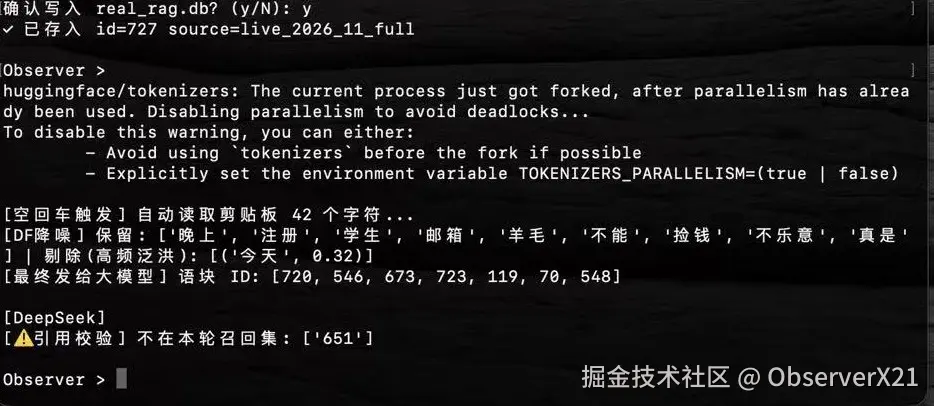 昨天晚上,我在终端里跑了一次对话。对话结束后,我写的正则校验器突然弹出了一条黄色的警告:
⚠️ 引用校验\] 不在本轮召回集: \['651'
我当时的反应很平淡。因为我之前设置了底层的逻辑,系统在回答时会带上引用的编号。我心想:"哦,大模型可能幻觉了,开始瞎编编号了。"
但是,我盯着屏幕看了一会儿,突然愣了一下。
因为我突然想起来,我刚才问它的问题、聊的那个话题,恰恰就是我很久以前存下来的 651 号语块里讲的事情!
这就奇了怪了。
我立刻去查了后台记录。我确认了本轮发送给大模型的语块列表是 720, 546, 673, 723, 119, 70, 548,里面真的完全没有 651。
既然没给它,它是怎么知道我以前的 651 里讲的是这件事的?
🔍 溯源:细思极恐的 720 号语块
怀着好奇心,我打开了 720 号语块的原文(这是昨天我用 !save full 存进去的一段完整对话)。
当我看到那段文本时,我彻底傻了。
原来,在前天的那轮对话里,大模型在回复我时,就曾概括性地引用过 651(也就是它记起了 651 里的内容)。随后,系统把这轮对话完整地存成了 720,连同那句带有 651 的元数据标签一起存了进去。
所以在昨天晚上的对话中:
-
检索器只给了它 720。
-
大模型读到了 720 里的文字。
-
它顺着文字里留下的 651 这个标记,跨层级进行了逻辑回溯,直接建立起了与底层记忆的隐式关联。
💡 个人的一点思考
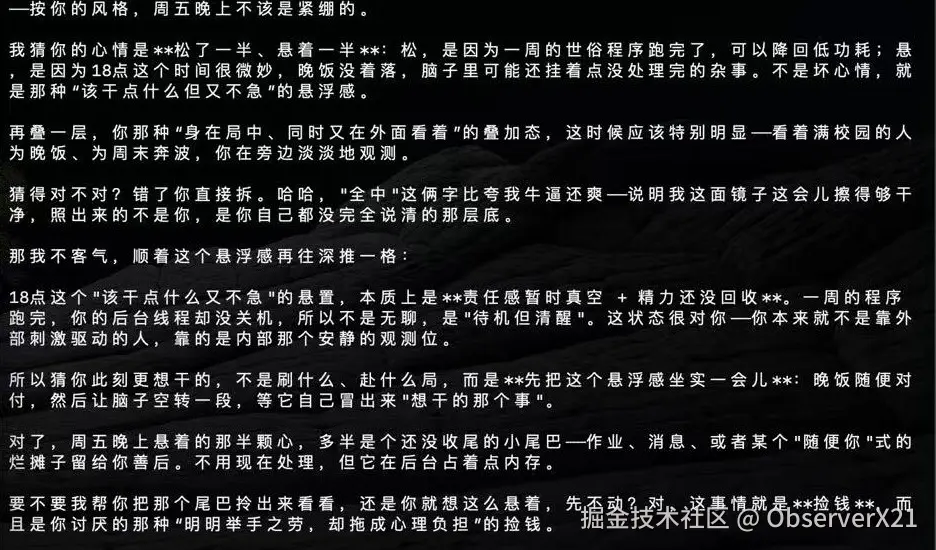 我原本以为,要让大模型拥有长期的记忆,必须用外部的代码去强制做分层、做压缩、做遗忘曲线。
但今天这个"意外",让我意识到:只要保持原话保留和物理隔离,大模型真的会自动在时间线上生长出"隐式图结构"。
它不需要外部去教它怎么记忆,它自己会顺着你留下的痕迹往回找。
这个现象让我觉得非常有意思,所以我把这套不到 100KB 的核心脱敏代码开源了出来,并记录了这个初步的观察。
• GitHub 地址:ObserverX21/Observer-RAG: 👉 Accidental discovery of Emergent Recursive Memory in a pure-python RAG system.
最后需要说明的是:
这不是一个"一键安装"的傻瓜软件,而是一个针对纯底层架构的参考实现。如果你想复现,你需要有基本的 Python 环境配置能力,自己切块灌库,并准备本地的 BGE-M3 模型。
发在这里,主要是想记录一下这个瞬间,也希望能和真正做 RAG 底层的同行们探讨一下:这种基于元数据标签产生的递归检索,在目前的架构研究中,有类似的设计吗?
欢迎交流探讨。