流水线每天自动出一张配图,脚本打印 SAVED:... size=41213,退出码 0,看起来一切正常。但图发出去之后,读者第一眼看到的可能是这样:
css
┌──────────────┐
│ 响应头 Content-Ty │
│ pe                │
└──────────────┘
Content-Type 被劈成两半。这类故障没有异常、没有非零退出码、没有日志告警------只有人眼看图才能发现。图是整条发布链路里唯一「人直接看见」的产物,也恰好是唯一没有自动判据的环节。
这篇把配图脚本的折行逻辑拆开,量一遍它的容量边界,给出三种改法和实测对照。
折行的单位是像素,不是字符
gen_article_figure.py 用微软雅黑 26px 画方框文字,方框宽 260px,左右各留 15px 内边距,所以每行的可用宽度是 230px:
python
box_w = 260
lines = wrap_text(label, font_box, box_w - 30)   # 230px
230px 能放几个字,取决于字是什么字。同一字号下用 ImageDraw.textlength 量出来的实际宽度(微软雅黑 26px):
| 字符 | 宽度 px |
|---|---|
| 汉字 / 全角标点 | 26.0 |
0 |
15.0 |
a |
14.0 |
_ |
12.0 |
- |
11.0 |
| 空格 | 8.0 |
所以一行能放 8 个汉字,或 15 个 ASCII 字母。「标签控制在 8 个字以内」这条经验,只在纯中文时成立。
混排不是简单相加
汉字和 ASCII 混在一行时,容量不是「8 减几个」。实测每加 2 个 ASCII 字符,剩余汉字位就少 1 个:
| 行首 ASCII 字符数 | 还能放几个汉字 |
|---|---|
| 0 | 8 |
| 2 | 7 |
| 4 | 6 |
| 6 | 5 |
| 8 | 4 |
这条曲线解释了为什么 work_list 接口 这类标签特别容易坏:它看起来只有 9 个字符,实际宽度是 9 个 ASCII(约 117px)加 2 个汉字(52px),再加上中间那个空格 8px,一共 177px,一行放得下;但换成 work_list 接口与分页 就超了,折行点落在哪完全由像素决定,不由语义决定。
逐字贪心折行的三个后果
现在的实现是逐字符累加、超宽就断:
python
def wrap_text(text, font, max_w):
    out = []
    for para in text.split("\n"):
        cur = ""
        for ch in para:
            test = cur + ch
            if d_textwidth(test, font) <= max_w or not cur:
                cur = test
            else:
                out.append(cur)
                cur = ch
        out.append(cur)
    return out
逐字符判断宽度本身没错,问题是它把「字符」当成了「不可分的单位」,于是三个副作用同时存在。
拿 28 条真实标签(一部分是历史事故原串,一部分是技术措辞)跑一遍:
| 缺陷 | 命中数 | 命中率 | 实例 |
|---|---|---|---|
| 英文词被切断 | 3 / 28 | 10.7% | cookie 明文与 DPAPI → cookie 明文与 DP / API |
| 标点落到行首 | 1 / 28 | 3.6% | 八个汉字开头后面,接标点说明 → 第二行以 , 开头 |
| 开括号留在行尾 | 1 / 28 | 3.6% | 八个汉字在这里(括号说明) → 第一行以 ( 结尾 |
| 末行孤字 | 3 / 28 | 10.7% | SigV4 四级密钥派生 → SigV4 四级密钥派 / 生 |
孤字(widow)最容易被忽略,因为它不破坏语义,只是难看:一个「生」字孤零零悬在第二行,居中排布下还会把整段视觉重心带偏。
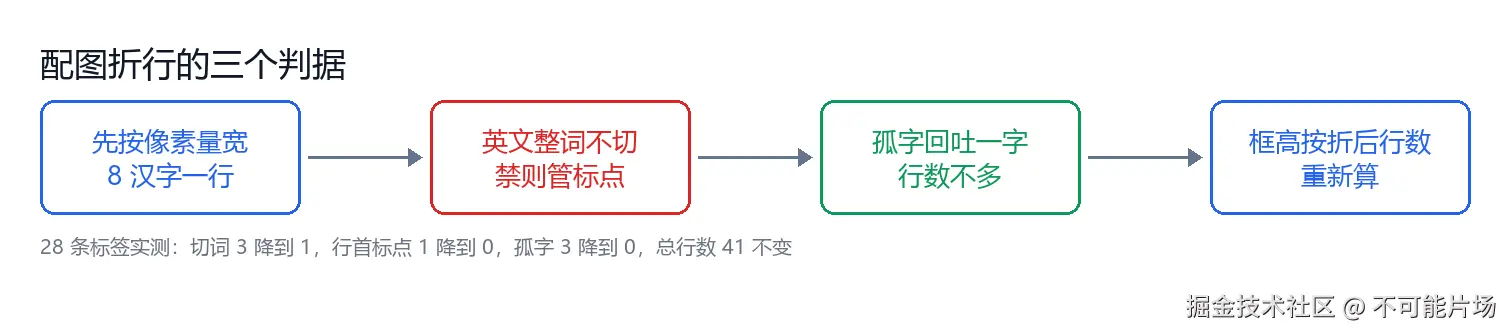
三种改法,都不增加行数
改法一:英文词当原子 。先用正则把连续的 [A-Za-z0-9_.\-/:#+] 抓成 token,宽度够就整块放,放不下就整块换行,只有 token 本身超过 230px 时才退化为逐字切。
改法二:CJK 禁则 。行首禁标点(,。、;:?!)】》」』 等),行尾禁开括号((【《「『)。触发时把上一行末字挤下来陪它------这一挤只是移动断点,不会多出一行。
改法三:孤字回吐。折完之后检查末行,如果只有 1 个字且总行数大于 1,从上一行借一个字过来:
python
# 孤字回吐:末行只有 1 字且总行数 >1 → 从前一行借一字
if len(lines) > 1 and len(lines[-1]) == 1 and len(lines[-2]) > 2:
    lines[-1] = lines[-2][-1] + lines[-1]
    lines[-2] = lines[-2][:-1]
三条合起来的实现:
python
def wrap_improved(text, max_w=230):
    out = []
    for para in text.split("\n"):
        atoms = []
        for kind, tok in _tokens(para):
            if kind == "token" and w(tok) <= max_w:
                atoms.append(tok)              # 整词原子
            elif kind == "token":
                atoms.extend(_split_token(tok, max_w))   # 超宽才退化
            else:
                atoms.append(tok)
        lines, cur = [], ""
        for a in atoms:
            if w(cur + a) <= max_w or not cur:
                cur += a
            elif a[0] in LINE_START_FORBID and len(cur) > 1:
                lines.append(cur[:-1]); cur = cur[-1] + a   # 行首禁标点
            elif cur[-1] in LINE_END_FORBID:
                lines.append(cur[:-1]); cur = cur[-1] + a   # 行尾禁开括号
            else:
                lines.append(cur); cur = a
        if cur:
            lines.append(cur)
        if len(lines) > 1 and len(lines[-1]) == 1 and len(lines[-2]) > 2:
            lines[-1] = lines[-2][-1] + lines[-1]
            lines[-2] = lines[-2][:-1]
        out.extend(lines)
    return out
同一批 28 条标签的对照结果:
| 指标 | 逐字贪心 | 加三种约束 |
|---|---|---|
| 总行数 | 41 | 41 |
| 切词 | 3 | 1 |
| 行首标点 | 1 | 0 |
| 行尾开括号 | 1 | 0 |
| 孤字 | 3 | 0 |
行数一行没多 ,因为禁则和回吐都只是把断点挪位置,不改变总量。剩下那 1 例切词是 puppeteer-in-electron------21 个 ASCII 字符,按 15 字符一行的容量怎么切都要断,这不是算法问题,只能缩字号或者换措辞(写成 puppeteer 桥接 Electron)。
框高是另一笔账
改完折行还有个坑:方框高度按显式换行符个数算,不按折出来的行数算。
python
bh = 90 + (max(len(l.split(chr(10))) for l, _ in boxes) - 1) * 24文本输入通道与读回校验的三个不同口径 是 19 个汉字,没写任何换行符,bh 取 90px;但它实际折成 3 行,行高 34px,文字高 102px------溢出 12px,第三行压到边框上。改成按折后行数算:
python
n_lines = max(len(wrap_improved(l, 230)) for l, _ in boxes)
bh = max(90 + (explicit - 1) * 24, n_lines * 34 + 24)
3 行时需要 3 × 34 + 24 = 126px,比 90px 多 36px。这个值必须在画框之前算,不能等画完再看。
落地时守住四条
跑通之后我把规则收成四条,写进配图脚本的调用约定:
- 纯中文标签压到 8 字以内,混排按上表折算------2 个英文词减 1 个汉字位。
- 英文标识符整词给出 ,宁可拆成两个框,不写
puppeteer-in-electron这种超容量的长 token。 - 显式换行由人指定 ,别把折行交给算法猜。想强调的断点自己敲
\n,算法只负责兜底。 - 出图后看一眼尺寸 。
SAVED打印成功不代表图好看,像素级的溢出现在没有任何自动判据------这是唯一还得靠眼睛的环节。
配图这条链路已经踩过不少坑:ImageX 上传时 Python OpenSSL 握手被重置、CDN 域名手抄错一个字符、--out 里的反斜杠被 shell 吃掉。折行是里面唯一「不报错但一定被看见」的那个。它值得单独修一次,因为读者判断一张技术配图专业与否,第一眼看的不是内容对不对,是有没有把字切歪。