一、引言
Flink 提供了状态计算、事件时间、Checkpoint、Savepoint、Exactly-Once 语义以及 DataStream、Table、SQL 等能力。但把一段 Flink 代码变成长期稳定运行的生产作业,还要处理很多计算引擎之外的问题:
- 不同项目重复维护 Flink 启动参数和配置文件;
- Kafka、JDBC 等 Connector 依赖容易发生版本冲突;
- 开发、测试、生产环境的提交参数不一致;
- Standalone、YARN、Kubernetes 的提交方式各不相同;
- 作业构建、发布、启动和回滚依赖脚本及人工操作;
- Savepoint、告警和运行状态散落在多个系统;
- 多个 Flink 版本并存,升级过程难以统一;
- SQL 作业和 Java、Scala JAR 作业缺少统一管理入口。
团队只有几个作业时,可以用 Shell 脚本、Flink CLI 和 CI/CD 解决。随着作业数量增加,这种模式会形成大量分散的脚本和隐式约定。
markdown
少量作业阶段
============

开发者
  |
  +-- flink run ...
  +-- yarn application ...
  +-- kubectl ...
  +-- 手工维护参数
  +-- 手工查看日志

问题尚可控制

规模化阶段
==========

多个团队 × 多个 Flink 版本 × 多种部署环境 × 大量作业
                         |
                         v
              配置、发布和运维复杂度快速上升
Apache StreamPark 正是为解决这类工程化问题而产生的。它不是新的流计算引擎,而是构建在 Flink、YARN、Kubernetes 等基础设施之上的开发与运维平台。
二、StreamPark 的定位
StreamPark 是面向流处理应用的开发框架与生命周期管理平台,底层计算仍由 Flink 或 Spark 执行。
它主要负责控制面工作:
- 规范应用开发与配置;
- 构建和发布应用;
- 向目标集群提交作业;
- 管理启动、停止和 Savepoint;
- 跟踪状态、指标和告警;
- 统一不同 Flink 版本与部署环境。
它不负责替代:
- Flink 或 Spark 计算引擎;
- YARN 或 Kubernetes 资源调度;
- Kafka、数据库、HDFS、对象存储;
- 底层集群的网络、安全和高可用设计。
lua
+-----------------------------------------------------+
|                  StreamPark 控制面                  |
|                                                     |
|  开发规范 | 项目构建 | 发布 | 提交 | 监控 | 告警  |
+--------------------------+--------------------------+
                           |
          +----------------+----------------+
          |                |                |
          v                v                v
 +----------------+ +---------------+ +----------------+
 | Flink          | | Flink on YARN | | Flink on K8s   |
 | Standalone     | |               | |                |
 +----------------+ +---------------+ +----------------+
          |                |                |
          +----------------+----------------+
                           |
                           v
            Kafka / DB / HDFS / Data Lake
三、整体架构:Core 与 Console
StreamPark 的概念架构可以划分为 StreamPark Core 和 StreamPark Console 两部分。
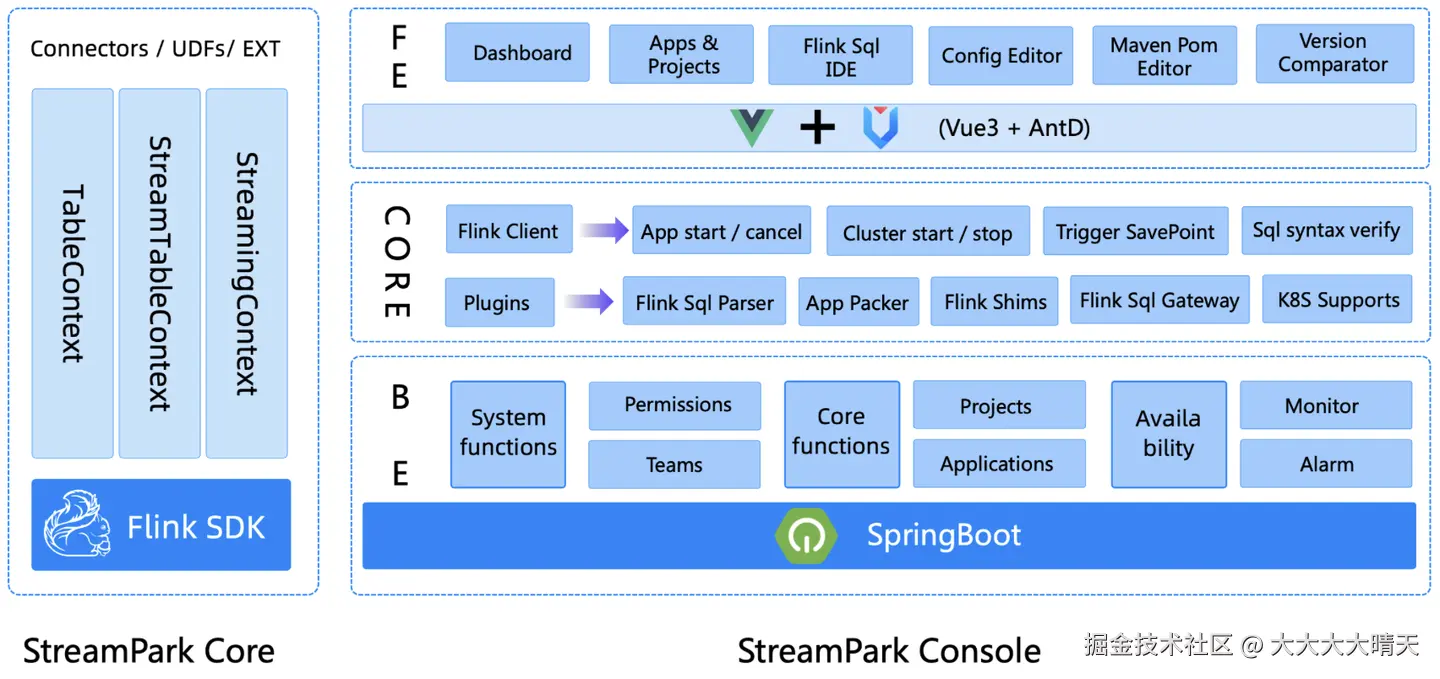
3.1.StreamPark Core:开发框架层
Core 主要面向应用开发阶段,目标是减少重复的工程配置,让开发者聚焦业务逻辑。
其核心思路包括:
- 约定优于配置;
- 统一应用配置;
- 提供运行上下文 RuntimeContext;
- 封装常用 Connector;
- 支持 Flink DataStream 与 Flink SQL;
- 减少重复的初始化、参数读取和环境装配代码。
可以把 Core 理解成 Flink 之上的工程脚手架,而不是另一个执行引擎。
lua
传统 Flink 应用
---------------

业务逻辑
配置解析
ExecutionEnvironment 初始化
Connector 初始化
参数转换
部署参数
公共工具代码

使用 StreamPark Core
--------------------

业务逻辑
   |
   v
StreamPark 约定与封装
   |
   +-- RuntimeContext
   +-- 配置解析
   +-- Connector 支持
   +-- DataStream / SQL 集成
   |
   v
Apache Flink
3.2.StreamPark Console:管理控制面
Console 提供 Web 管理入口,覆盖 Flink 应用的构建、发布与运行维护。官方资料列出的能力包括:
- 项目构建与发布;
- Flink SQL 作业管理;
- 自定义 JAR 作业管理;
- Flink 版本和集群管理;
- 运行参数配置;
- 作业启动与停止;
- Savepoint 管理;
- 作业状态和指标监控;
- 告警;
- Flink Web UI 代理;
- Flame Graph 等诊断能力。
典型的作业生命周期如下:
sql
代码仓库 / SQL / JAR
          |
          v
+-------------------+
| 创建应用与配置参数 |
+-------------------+
          |
          v
+-------------------+
| 构建 Build         |
| Maven / 项目依赖   |
+-------------------+
          |
          v
+-------------------+
| 发布 Release       |
| 固化产物与运行配置 |
+-------------------+
          |
          v
+-------------------+
| 启动 Start         |
| 提交到目标环境     |
+-------------------+
          |
          v
 Standalone / YARN / Kubernetes
          |
          v
  状态跟踪、指标、日志、告警
          |
          v
 Stop / Savepoint / Restart / Upgrade
这里需要区分 Release 与 Start :
- Release 负责准备待提交的应用版本、构建产物和配置;
- Start 才会把已发布版本提交到目标 Flink 环境。
这种分离有助于减少"代码刚构建完就直接进入生产"的随意操作,也方便团队在发布阶段增加审批或检查。
3.3.代码模块
javascript
streampark
├── streampark-common
├── streampark-scala
├── streampark-flink
│   ├── flink-shims
│   ├── flink-client
│   ├── flink-sqlclient
│   ├── flink-packer
│   └── flink-kubernetes
├── streampark-spark
└── streampark-console
其中:
flink-shims处理不同 Flink 版本的兼容适配;flink-client负责与 Flink 集群及提交过程相关的客户端能力;flink-sqlclient服务于 Flink SQL;flink-packer处理作业构建、打包相关能力;flink-kubernetes负责 Kubernetes 集成;console提供管理平台服务。
四、StreamPark 支持哪些 Flink 部署模式
| 部署模式 | 是否预先创建集群 | 适用特点 |
|---|---|---|
| Local | 否 | 本地验证,不建议作为正式生产模式 |
| Remote | 是 | 向已有 Standalone 集群提交作业 |
| YARN Session | 是 | 多作业共享 Session,启动快但隔离性较弱 |
| YARN Per-Job | 否 | 每个作业创建独立集群,源码已出现未来弃用意图 |
| YARN Application | 否 | 应用运行于独立 YARN Application |
| Kubernetes Native Session | 是 | 多个作业共享 Kubernetes Session 集群 |
| Kubernetes Native Application | 否 | 每个应用创建独立 Kubernetes Flink 集群 |
markdown
                    是否需要强隔离?
                      /        \
                    否          是
                    |           |
             Session Mode   Application Mode
                    |           |
          多作业共享集群       每个应用独立集群
          启动成本较低         隔离性较强
          故障影响范围较大     资源开销相对更高
对于稳定性要求较高的生产作业,Application Mode 往往更容易控制故障边界。大量短作业或资源紧张的环境,可以评估 Session Mode,但必须接受共享 JobManager 和共享资源带来的影响。
YARN Per-Job 需要谨慎使用。当前代码仍保留该模式,但源码中已经出现未来移除相关能力的意图。新系统应优先评估 YARN Application Mode,并在升级前检查目标版本的迁移说明。
五、主要功能特性
5.1.Flink SQL 与代码作业统一管理
StreamPark 可以管理:
- 平台内编写的 Flink SQL;
- 已构建的自定义 JAR;
- 由 Git 和 Maven 构建的工程;
- 使用 StreamPark Core 开发的应用。
SQL 开发者和 Java、Scala 开发者可以使用同一套发布及运维流程,减少不同团队各建一套平台的成本。
5.2.多 Flink 版本管理
企业通常不会一次性完成全部 Flink 作业升级。StreamPark 可以登记多个 Flink 版本,让不同应用选择对应版本。
这项能力解决的是"管理多个版本",而不是"保证任意版本组合都兼容"。团队仍要核对:
- Flink 与 JDK 的兼容关系;
- Scala 二进制版本;
- Connector 与 Flink 版本;
- 状态序列化兼容性;
- Savepoint 跨版本恢复能力。
5.3.构建、发布和运行配置统一
平台可以集中维护:
- Main Class;
- Program Arguments;
- Flink Dynamic Options;
- 并行度及资源参数;
- Maven 依赖;
- 部署模式;
- Savepoint 恢复参数。
统一配置能减少散落在 Shell 脚本、Wiki 和个人电脑中的隐式知识。
5.4.Savepoint 与作业生命周期管理
StreamPark 将启动、停止、Savepoint、恢复和重新发布纳入统一操作流程。对于状态型流作业,这比简单执行 flink cancel 更有价值,因为版本升级通常需要:
yaml
运行中作业
    |
    v
触发 Savepoint
    |
    v
停止旧版本
    |
    v
发布新版本
    |
    v
从 Savepoint 恢复
    |
    v
检查状态、延迟与数据一致性
但平台只能调用 Flink 的能力。Savepoint 是否可以恢复,仍取决于算子 UID、状态序列化、拓扑变化和 Flink 版本兼容性。
5.5.监控、告警与诊断
Console 可以聚合作业状态、指标、告警和 Flink Web UI 入口,部分版本还提供 Flame Graph 等诊断能力。
这能缩短运维路径,但不建议把 StreamPark 当成唯一可观测性系统。生产环境仍应保留:
- Flink 原生 Web UI;
- JobManager、TaskManager 日志;
- Prometheus、Grafana 等指标系统;
- YARN 日志或 Kubernetes Pod 日志;
- Kafka、数据库及存储端指标。
六、StreamPark 的优势与适用场景
主要优势:
- 降低多环境提交成本
- 形成标准化作业生命周期
- 兼顾 SQL 与工程化作业
- 支持多版本渐进升级
- 降低中小团队的平台建设门槛
推荐使用:
- 已有几十个以上 Flink 作业,需要统一管理;
- 同时存在 Flink SQL 和 Java、Scala 作业;
- 多个 Flink 版本需要长期并存;
- 作业分布在 Standalone、YARN 或 Kubernetes;
- 需要统一管理发布、启停、Savepoint、监控和告警;
- 希望减少手工提交命令与 Shell 脚本;
- 希望以开源项目为基础建设内部实时计算平台。
需要谨慎评估:
- 只有一两个简单 Flink 作业;
- 已有成熟的内部 Flink 平台和 SDK;
- 要求完整的数据治理、血缘和质量体系;
- 平台无法获得 YARN、HDFS 或 Kubernetes 必要权限;
- 安全制度不允许管理平台持有集群凭据;
- 希望平台完全代替底层集群运维。
lua
                         作业数量与管理复杂度
                                  ^
                                  |
               StreamPark 价值高  |  多版本、多集群、多团队
                                  |
                                  |
        原生 CLI / CI/CD 足够      |  少量作业、环境单一
                                  +------------------------>
                                      平台化治理需求
七、部署与使用
python
# 1. 从 Apache 官方下载页获取目标版本并校验签名、SHA-512

# 2. 解压
tar -zxvf apache-streampark_<scala-version>-<version>-bin.tar.gz

# 3. 进入目录
cd apache-streampark_<scala-version>-<version>-bin

# 4. 检查并修改 conf 下的配置

# 5. 启动
bin/startup.sh
默认 Web 端口通常为 10000,默认用户名密码为admin/streampark。快速体验可以使用默认数据库配置,生产环境建议使用外部 MySQL 或 PostgreSQL。
登录 Console 后,在设置中心登记 Flink Home。该目录应是完整的 Flink 发行目录,至少保证bin 、conf 和lib可用。
bash
StreamPark 所在节点
├── /opt/streampark
└── /opt/flink-1.xx.x
    ├── bin
    ├── conf
    └── lib
创建并运行应用:
sql
创建应用
  |
  +-- 选择 Flink SQL / 自定义 JAR / 项目构建
  +-- 选择 Flink 版本
  +-- 选择部署模式
  +-- 配置入口类、参数和资源
  |
  v
Build
  |
  v
Release
  |
  v
Start
  |
  v
查看状态、日志、指标和 Flink Web UI
如果使用 YARN,还要确保 StreamPark 运行账号能读取 Hadoop 配置并访问 HDFS、ResourceManager。
如果使用 Kubernetes,还要准备:
- StreamPark 运行账号可访问的 kubeconfig;
- Namespace 与 ServiceAccount;
- 最小化 RBAC 权限;
- 可推送、拉取的镜像仓库;
- Pod Template;
- StreamPark 到 Kubernetes API Server 的网络;
- StreamPark 到 Flink REST Service 的网络。
八、常见问题
8.1.StreamPark 服务无法启动
yaml
Java 与配置格式
      |
      v
端口是否冲突
      |
      v
本地 workspace 是否存在且可写
      |
      v
数据库是否可达、表是否初始化
      |
      v
JDBC 驱动是否存在
      |
      v
Hadoop / Kerberos 环境是否完整
      |
      v
查看 StreamPark logs
8.2.点击 Start 后立即失败
这通常属于提交阶段故障,应检查:
- 是否执行过 Release;
- 最近一次 Build 是否成功;
- Main Class 是否正确;
- JAR 是否存在;
- Flink Home 是否完整;
- Connector 依赖是否匹配;
- YARN 队列和 HDFS 权限;
- kubeconfig、RBAC 和镜像推送权限。
先看 StreamPark 的启动日志,再判断请求是否已经进入 Flink、YARN 或 Kubernetes。
8.3.已创建 YARN Application 或 Kubernetes Pod,但作业失败
这已经进入运行阶段。继续只看 StreamPark 服务日志通常得不到根因,应转到:
- Flink JobManager 日志;
- Flink TaskManager 日志;
- YARN ApplicationMaster 及聚合日志;
- Kubernetes Pod events;
- 容器日志;
- Flink Web UI 的异常和 Checkpoint 页面。
lua
是否创建了 Application / Pod?
          |
     +----+----+
     |         |
    否         是
     |         |
提交阶段排查   运行阶段排查
StreamPark     Flink / YARN / K8s
8.4.Flink SQL 出现 ClassNotFoundException
常见原因是 SQL 使用了 Kafka、JDBC 等 Connector,但对应依赖没有加入应用,或者 Connector 与 Flink、Scala 版本不兼容。
markdown
Flink 主版本
    ×
Scala 二进制版本
    ×
Connector artifact
    ×
Connector 版本
    ×
依赖加载位置
不要通过向 Flinklib 目录不断复制 JAR 来碰运气。重复类和版本冲突可能让问题更隐蔽。
8.5.Kubernetes 作业 ImagePullBackOff
重点检查:
- 镜像地址和 tag;
- 镜像是否已经推送;
- Registry Secret 是否存在;
- Secret 与 Pod 是否位于同一 Namespace;
- Pod Template 是否配置
imagePullSecrets; - 节点是否能够连接镜像仓库。
生产环境建议使用不可变版本 tag 或镜像 digest,不要长期复用latest 。
8.6.平台状态与实际集群状态不一致
先以 Flink、YARN 或 Kubernetes 中的真实状态为准,然后检查:
- StreamPark 是否能访问 Flink REST API;
- Kubernetes API 和 REST Service 网络是否可达;
- 状态轮询是否超时;
- 目标版本是否存在相关状态跟踪缺陷;
- 作业是否被平台外部命令修改。
在状态不明确时不要连续点击 Start,避免重复提交同一业务作业。