上个月开年度容量规划会,有个同事提了一句。说明年新上的订单中台,要不要直接上分布式数据库?就这一句话,会开了四十多分钟,没结论。散会之后,领导给我派了个活。他说,你把集中式与分布式这个选择题,写成一页纸的东西出来,下次会上要拍板。
我干了十几年 DBA,这种问题见过很多轮了。说实话,到了 2026 年,这个问题反而比以前更难回答。因为国产数据库发展到现在,集中式也分好几种,分布式也分好几种。名字都叫"分布式",里面的差别大得很。
写这页纸的过程,就是把公司 11 套业务系统重新过一遍秤的过程。这篇就记录一下我是怎么做的,给有同样困惑的朋友一个参考。
@toc
一、先把"分布式"这三个字拆开
接到任务以后,我干的第一件事不是看产品。而是把词拆开。
通常来说,大家嘴里说的"分布式",其实至少混着四种东西:
- 原生分布式:数据真的做了分片,分布在多个节点上。跨节点事务由数据库自己搞定。
- 分库分表型:底层还是单机库。上面加一个中间层来做路由和聚合。
- 租户模式:用一个分布式集群,开出很多租户。每个租户装一套业务。数据可以分片,也可以不分。
- 单机模式:买了分布式数据库,但是把它当单机用,不做分片。
后两种用法,业界有个说法叫"伪分布式"。这个说法我不是很喜欢。但现象是真实存在的。我接触过的团队里,说"我们上了分布式"的,有一半其实是租户模式。把原来散落的几十套单机库收拢到一个集群里,数据压根没分片。
这不一定是坏事。租户模式能统一技术栈,也能把底层资源用起来。但是它有代价。资源有冗余、管理灵活性差、集群内的故障会蔓延、扩展性也没有想象中那么强。关键是,你要知道自己买的是什么。花了分布式的钱,用的是单机的用法。那这个账,就要摊开算。
集中式这边也一样,至少分三种。单机、主备、共享存储。共享存储就是类似 Oracle RAC 那种架构,多个实例挂同一份存储。以前国产库里这种方案少,大家用的都是主备。这两年不一样了。部分厂商开始发力,比如金仓数据库的共享存储集群,对标 Oracle RAC 的场景,达梦的 DMDSC,都是这一类。 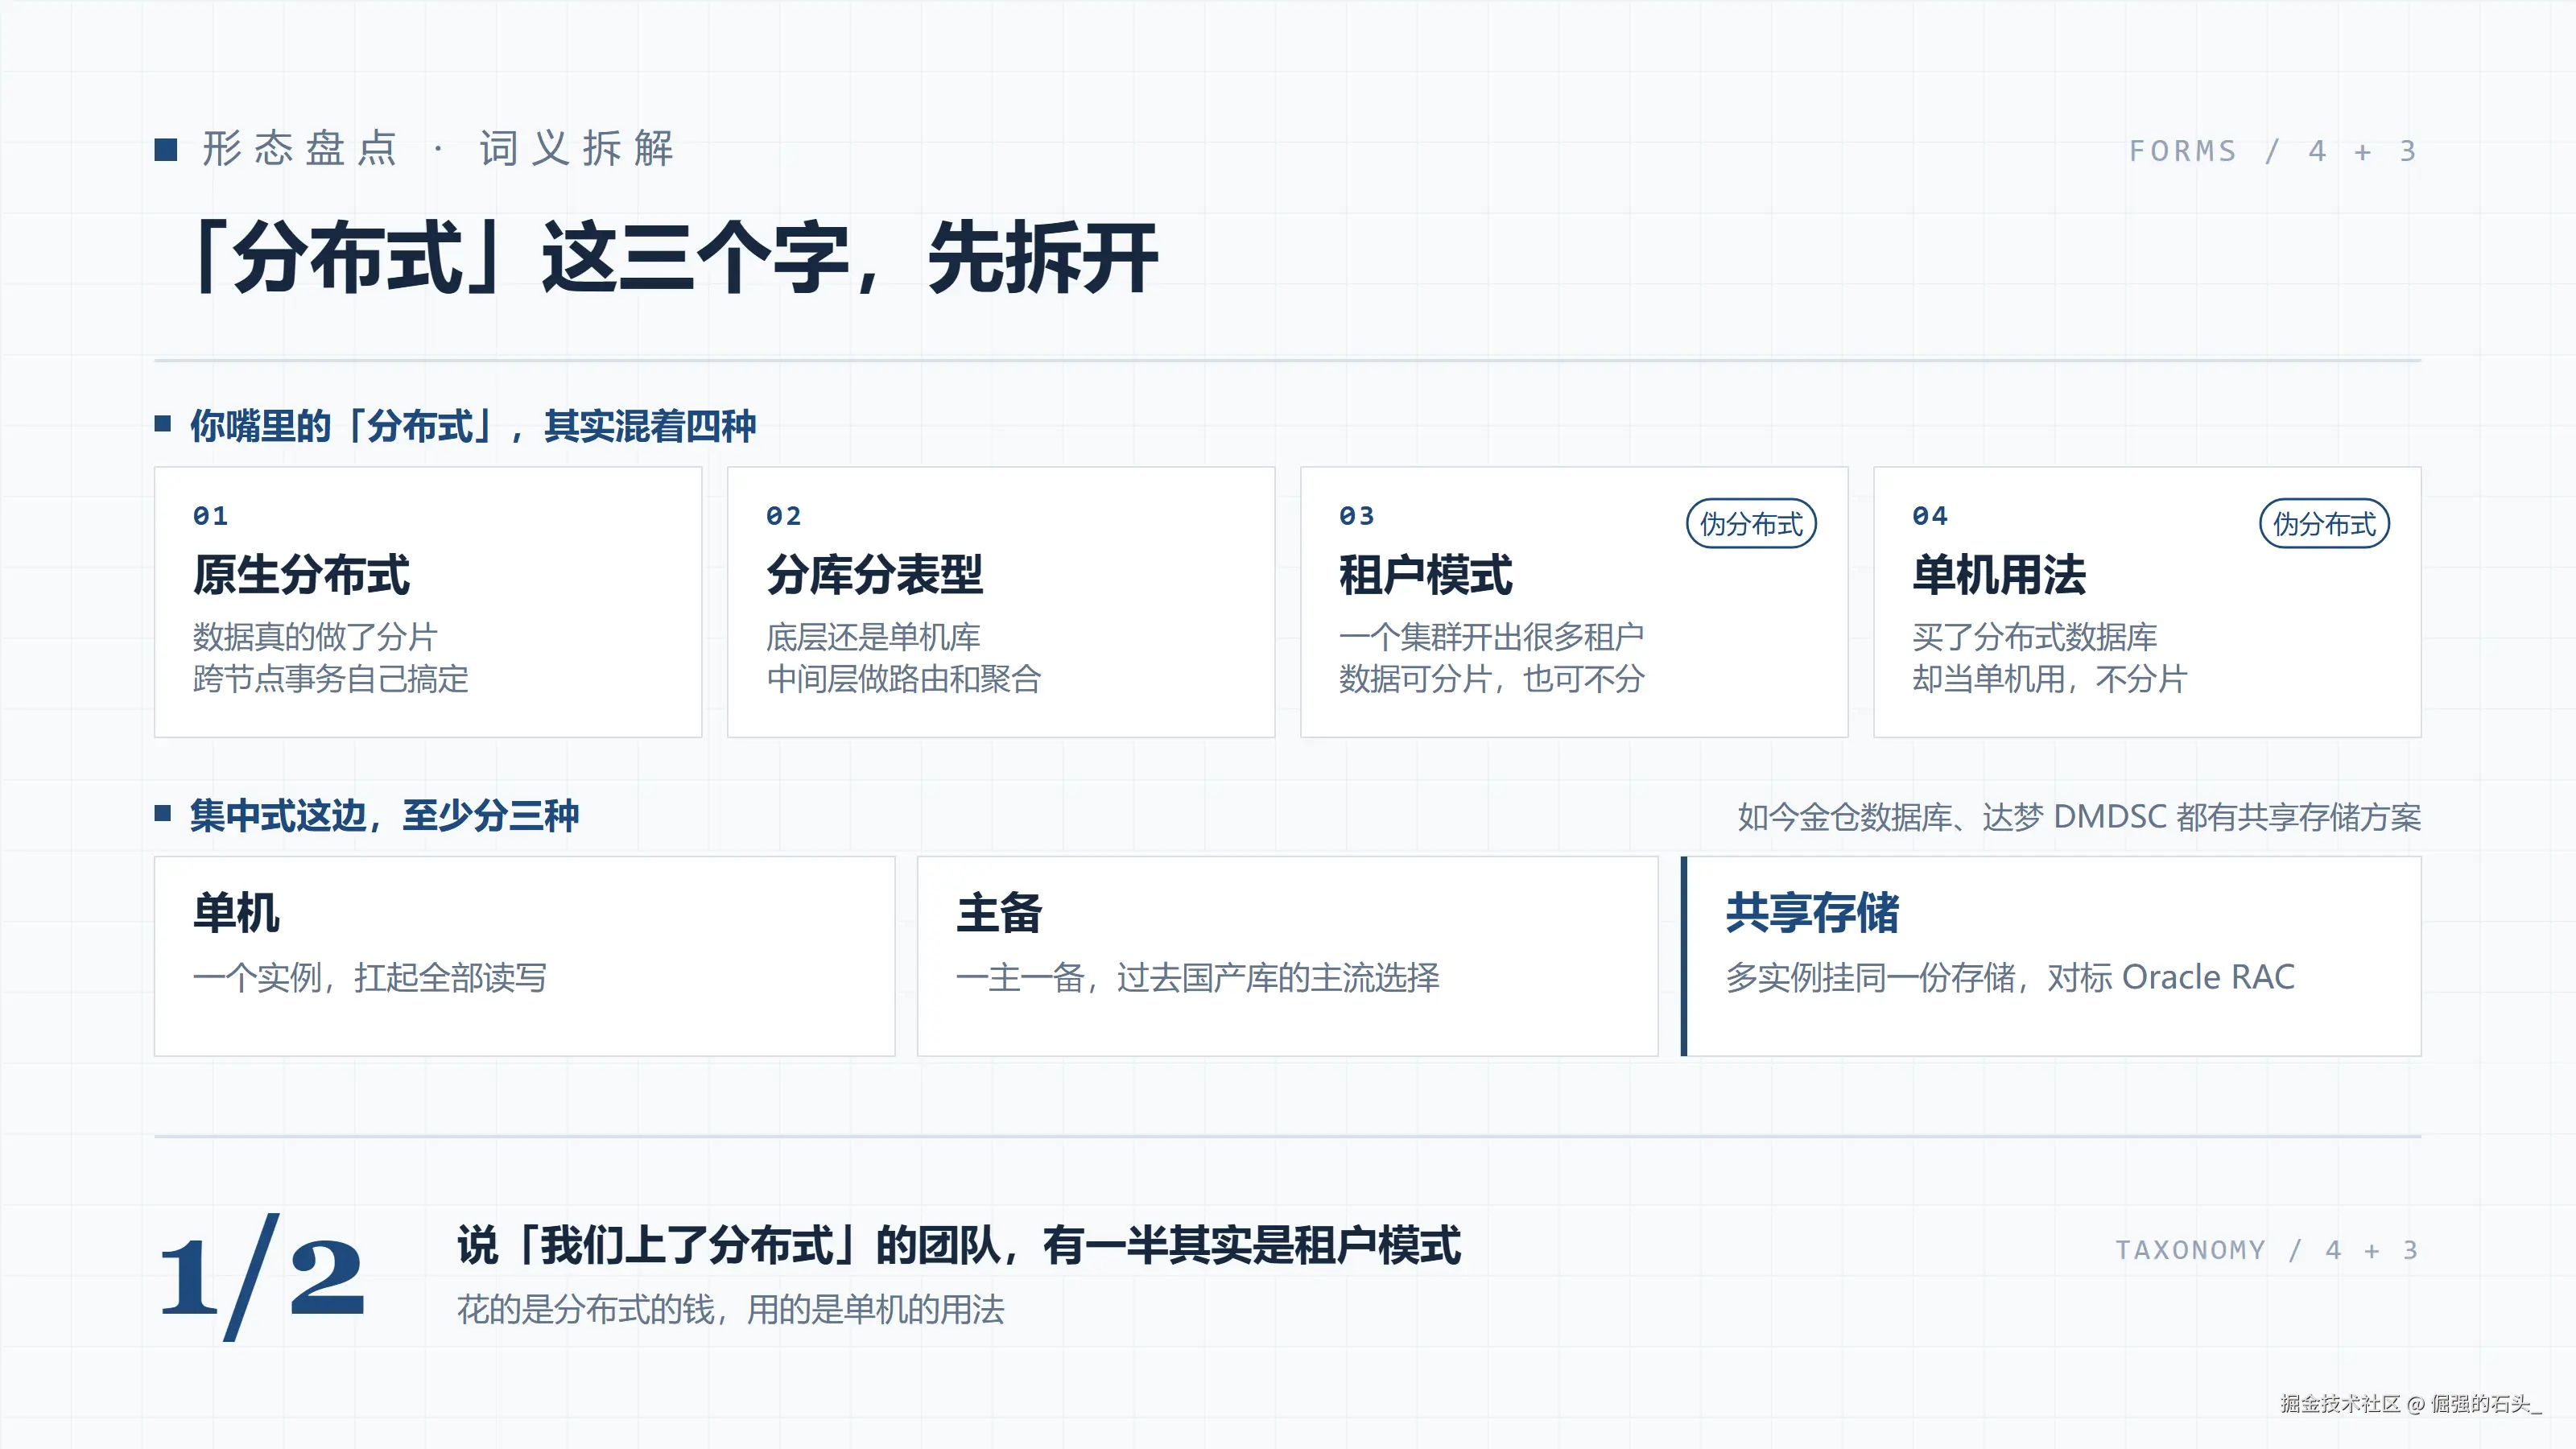
二、把账摊开:一张对比表
词拆完以后,我做了一张对比表。形态太多,全列出来太乱。我挑了四种有代表性的。
| 维度 | 分布式(原生) | 分布式(租户/单机用法) | 集中式(共享存储) | 集中式(主备) |
|---|---|---|---|---|
| 读扩展 | 高 | 中 | 高 | 高/中 |
| 写扩展 | 高 | 中/低 | 高(Scale Up) | 低 |
| 时延 | 不占优(层次多、路径长) | 中 | 低 | 低 |
| 数据一致性 | 中/高 | 中 | 极高(单一副本) | 中 |
| 可靠性 | 高 | 中/低 | 极高 | 中 |
| 设计开发适配 | 要考虑分片键、跨节点问题 | 低 | 低 | 低 |
| 综合成本 | 高 | 高 | 中 | 中/低 |
这张表里,我认为最容易被忽略的是两行。时延 和一致性。
先说时延。大家聊分布式的时候,聊的都是吞吐和扩展性。很少有人聊时延。分布式架构层次多、路径长。一条 SQL 从应用进来,要经过路由、协调、跨节点传输。时延天然就不占优。对绝大多数业务,这几毫秒没感觉。但对核心交易这种对时延极度敏感的场景,跨节点事务的毫秒级抖动,就是不可接受的。
再说一致性。什么样的数据一致性最好?其实是数据不复制。只有一个副本,读写都打在它上面,就不存在副本之间的同步问题。集中式共享存储就是这个思路。严格来说数据也在存储层做了冗余,但那是更低层次解决的。对数据库这一层来说,就是一个单一副本。所以你会发现,共享存储架构的一致性和可靠性都能做到"极高"。这不是巧合。
还有一个账要算,就是钱。我听过不止一家团队抱怨。上了分布式以后,整体成本比以前 IOE 架构还贵。硬件节点多、软件许可贵、开发适配要投入、运维队伍要扩编。加起来数字就上去了。这两年很多分布式厂商开始提供"单机一体化"能力。本质上就是在给这个账找补。
写完我自己那张表,我索性把七种用法也摆进了同一张表里再比一轮,从架构、性能、一致性一直比到成本。放在这里,跟我那张对照着看,会更直观: 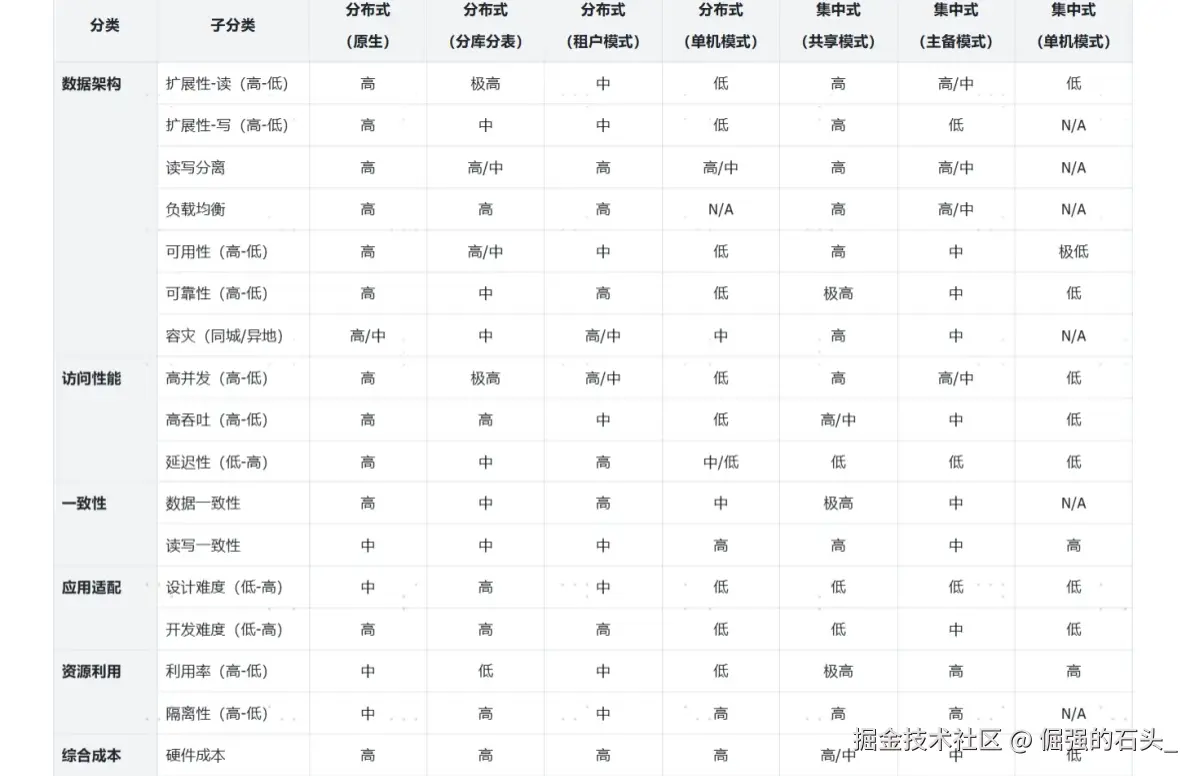
三、给业务分类,别给产品站队
表有了,接下来是关键一步。把公司自己的系统,一套一套放上去称。
我参考了业界对典型业务场景的抽象,做了这个场景-架构匹配表:
| 场景 | 并发 | 语句复杂度 | 延迟要求 | 适合的架构 |
|---|---|---|---|---|
| 核心交易 | 高 | 简单 | 极低 | 分布式(分库分表)/ 集中式(共享、主备) |
| 电子商务 | 高 | 简单 | 低 | 分布式 / 集中式 |
| CRM / SCM / ERP | 中 | 复杂 | 中 | 集中式(共享、主备),量不大也可用租户 |
| 数据仓库 | 低 | 极复杂 | 高 | 分布式(原生)/ 中小规模集中式 |
| HTAP | 中 | 复杂 | 中 | 分布式(原生)/ 集中式(共享) |
注意,"适合"不等于"必须"。核心交易系统的超大规模,才真正用得上分布式的扩展能力。中大规模用集中式也完全成立,其中共享模式安全性更高。反过来,CRM、ERP 这类系统,数据量和并发都中等,业务计算反而复杂。集中式的优势就很明显。库内计算能力用得越多,越不该把数据拆得到处都是。 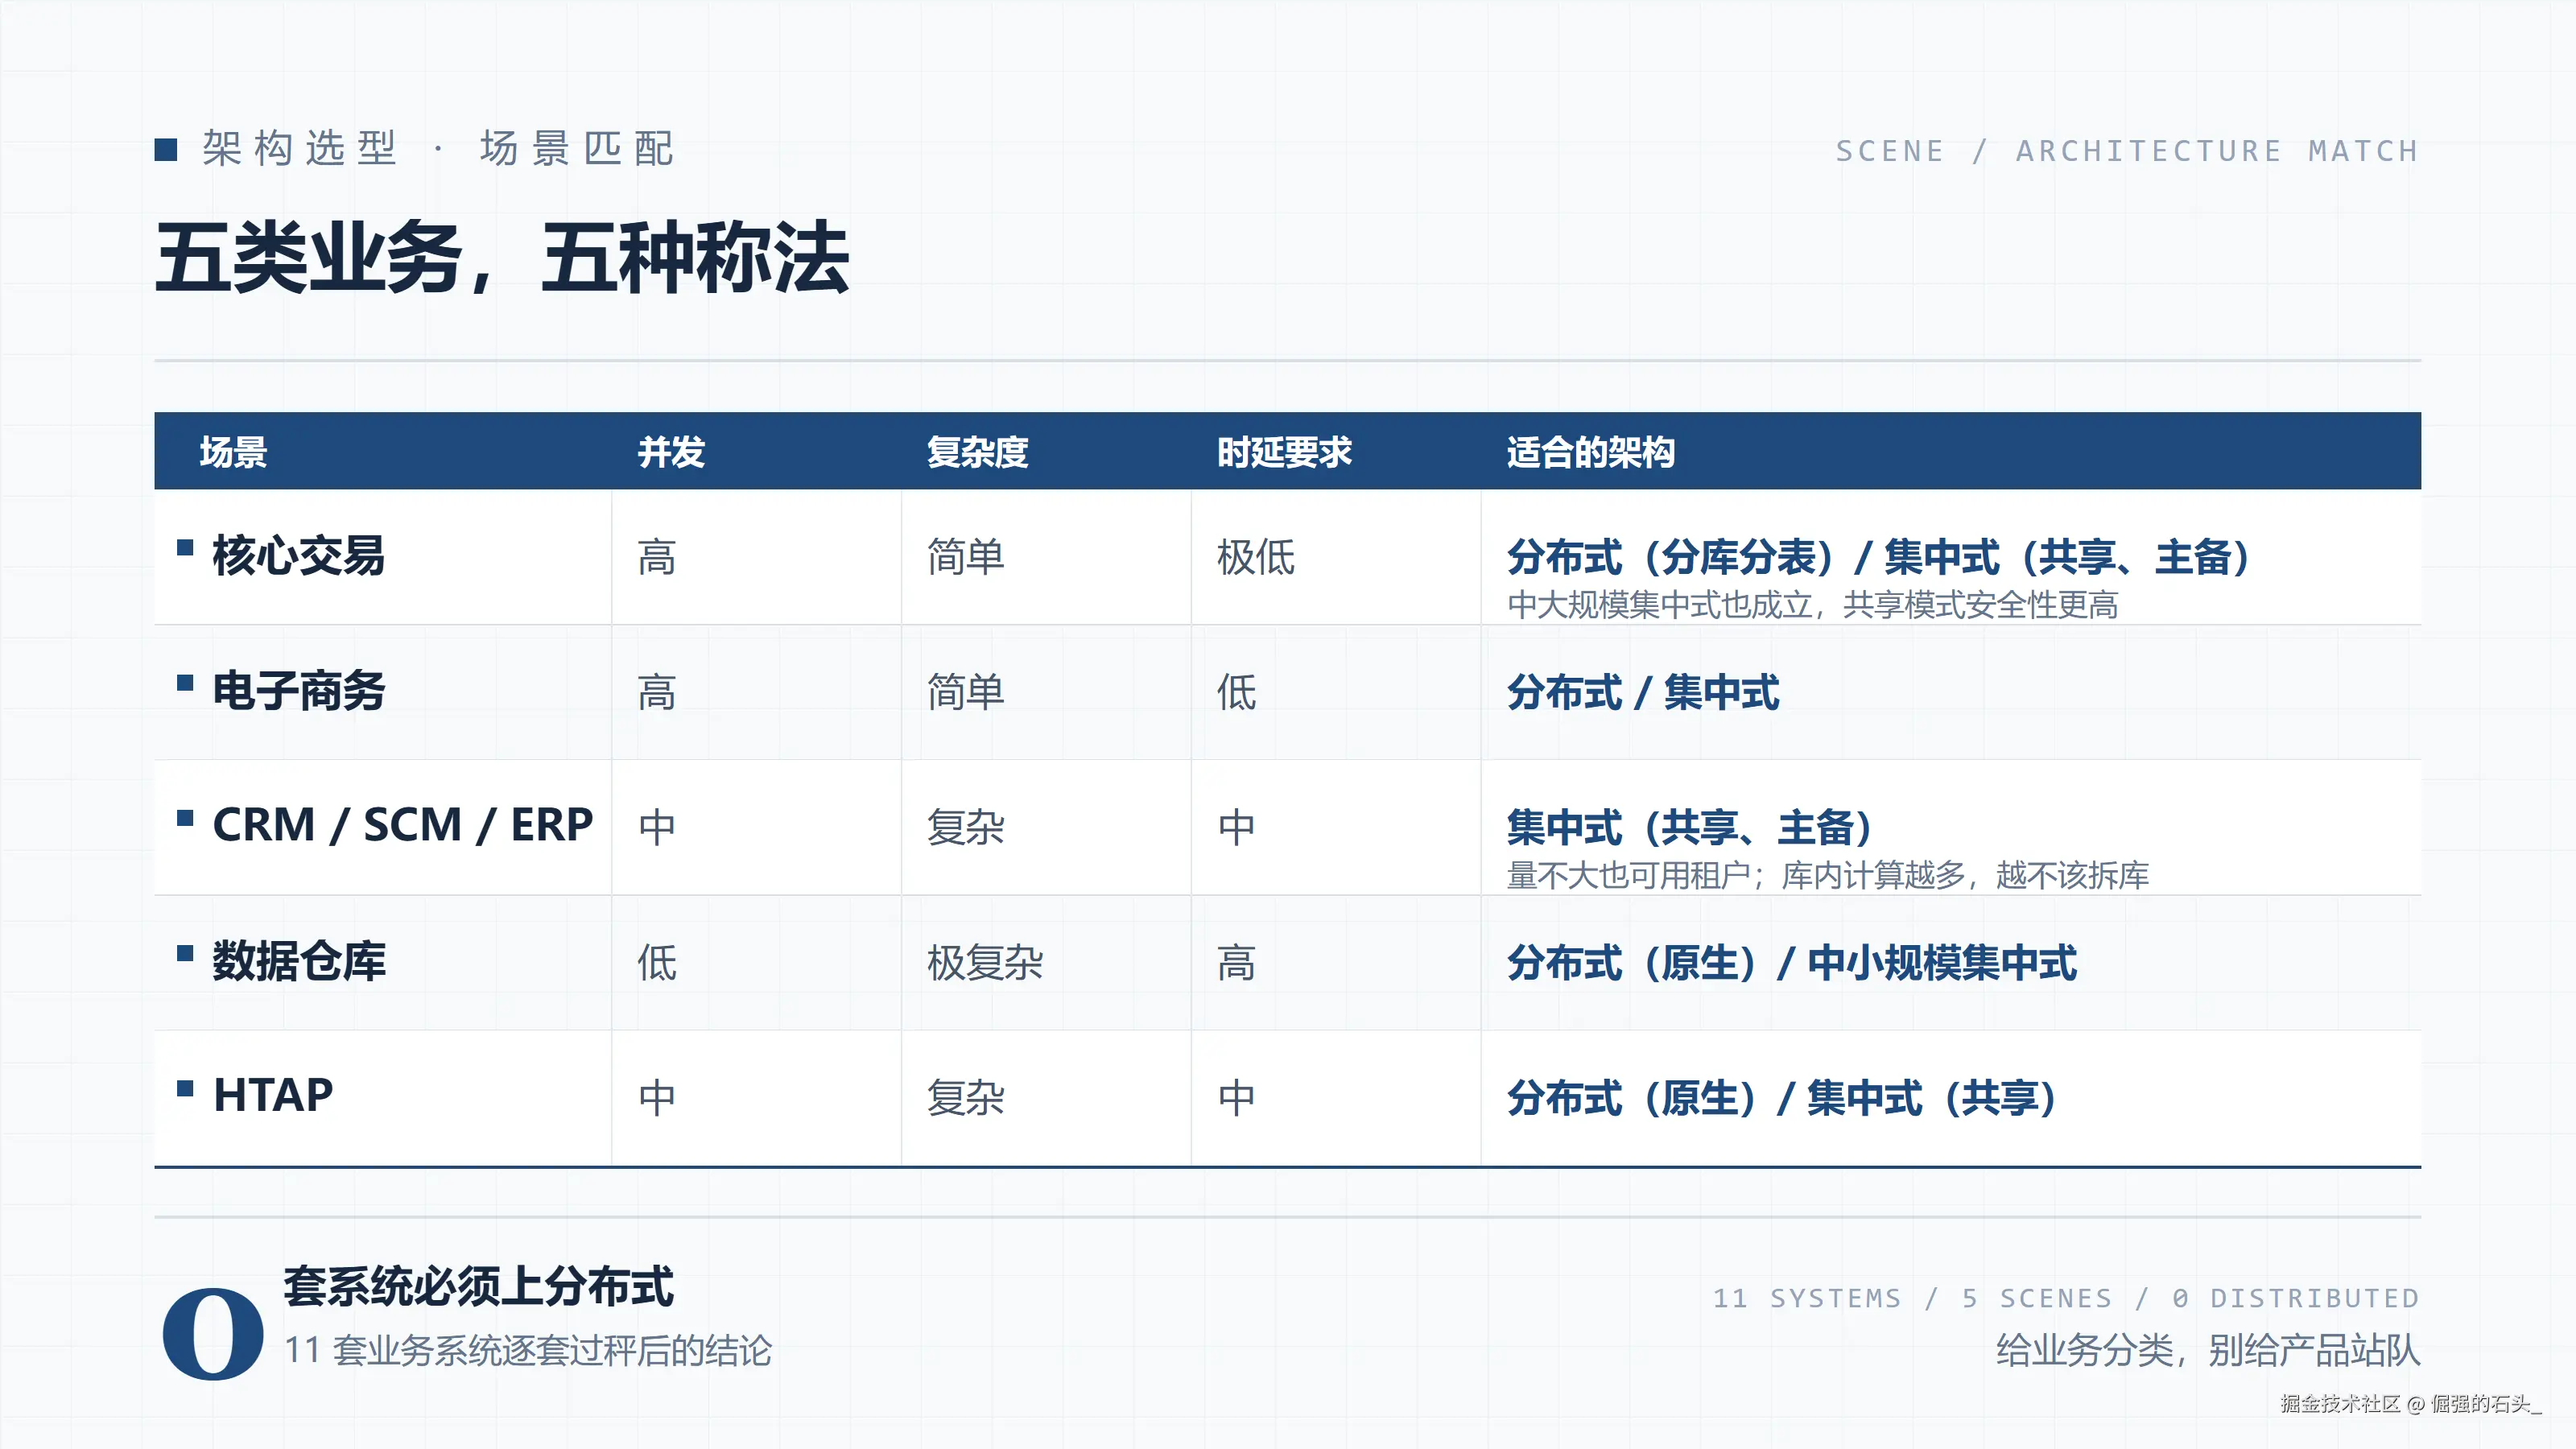
然后我把公司的 11 套系统逐套过了一遍。这里给两个例子:
核心交易库:两个库,都是 TB 级以下,峰值并发 3000 左右。过去五年没出过容量问题。归类结论:集中式,预算给 Scale Up,不上分布式。明明集中式够用还硬上分布式,多花的钱就等于扔掉了。
计划中的订单中台 :预期三年内数据量 2TB,峰值并发 8000。这两项都摸不到分布式的起点。业界通常的说法是,TB 级数据、万级并发,是评估分布式的起点,不是终点。都达不到的话,集中式是更理性的选择。 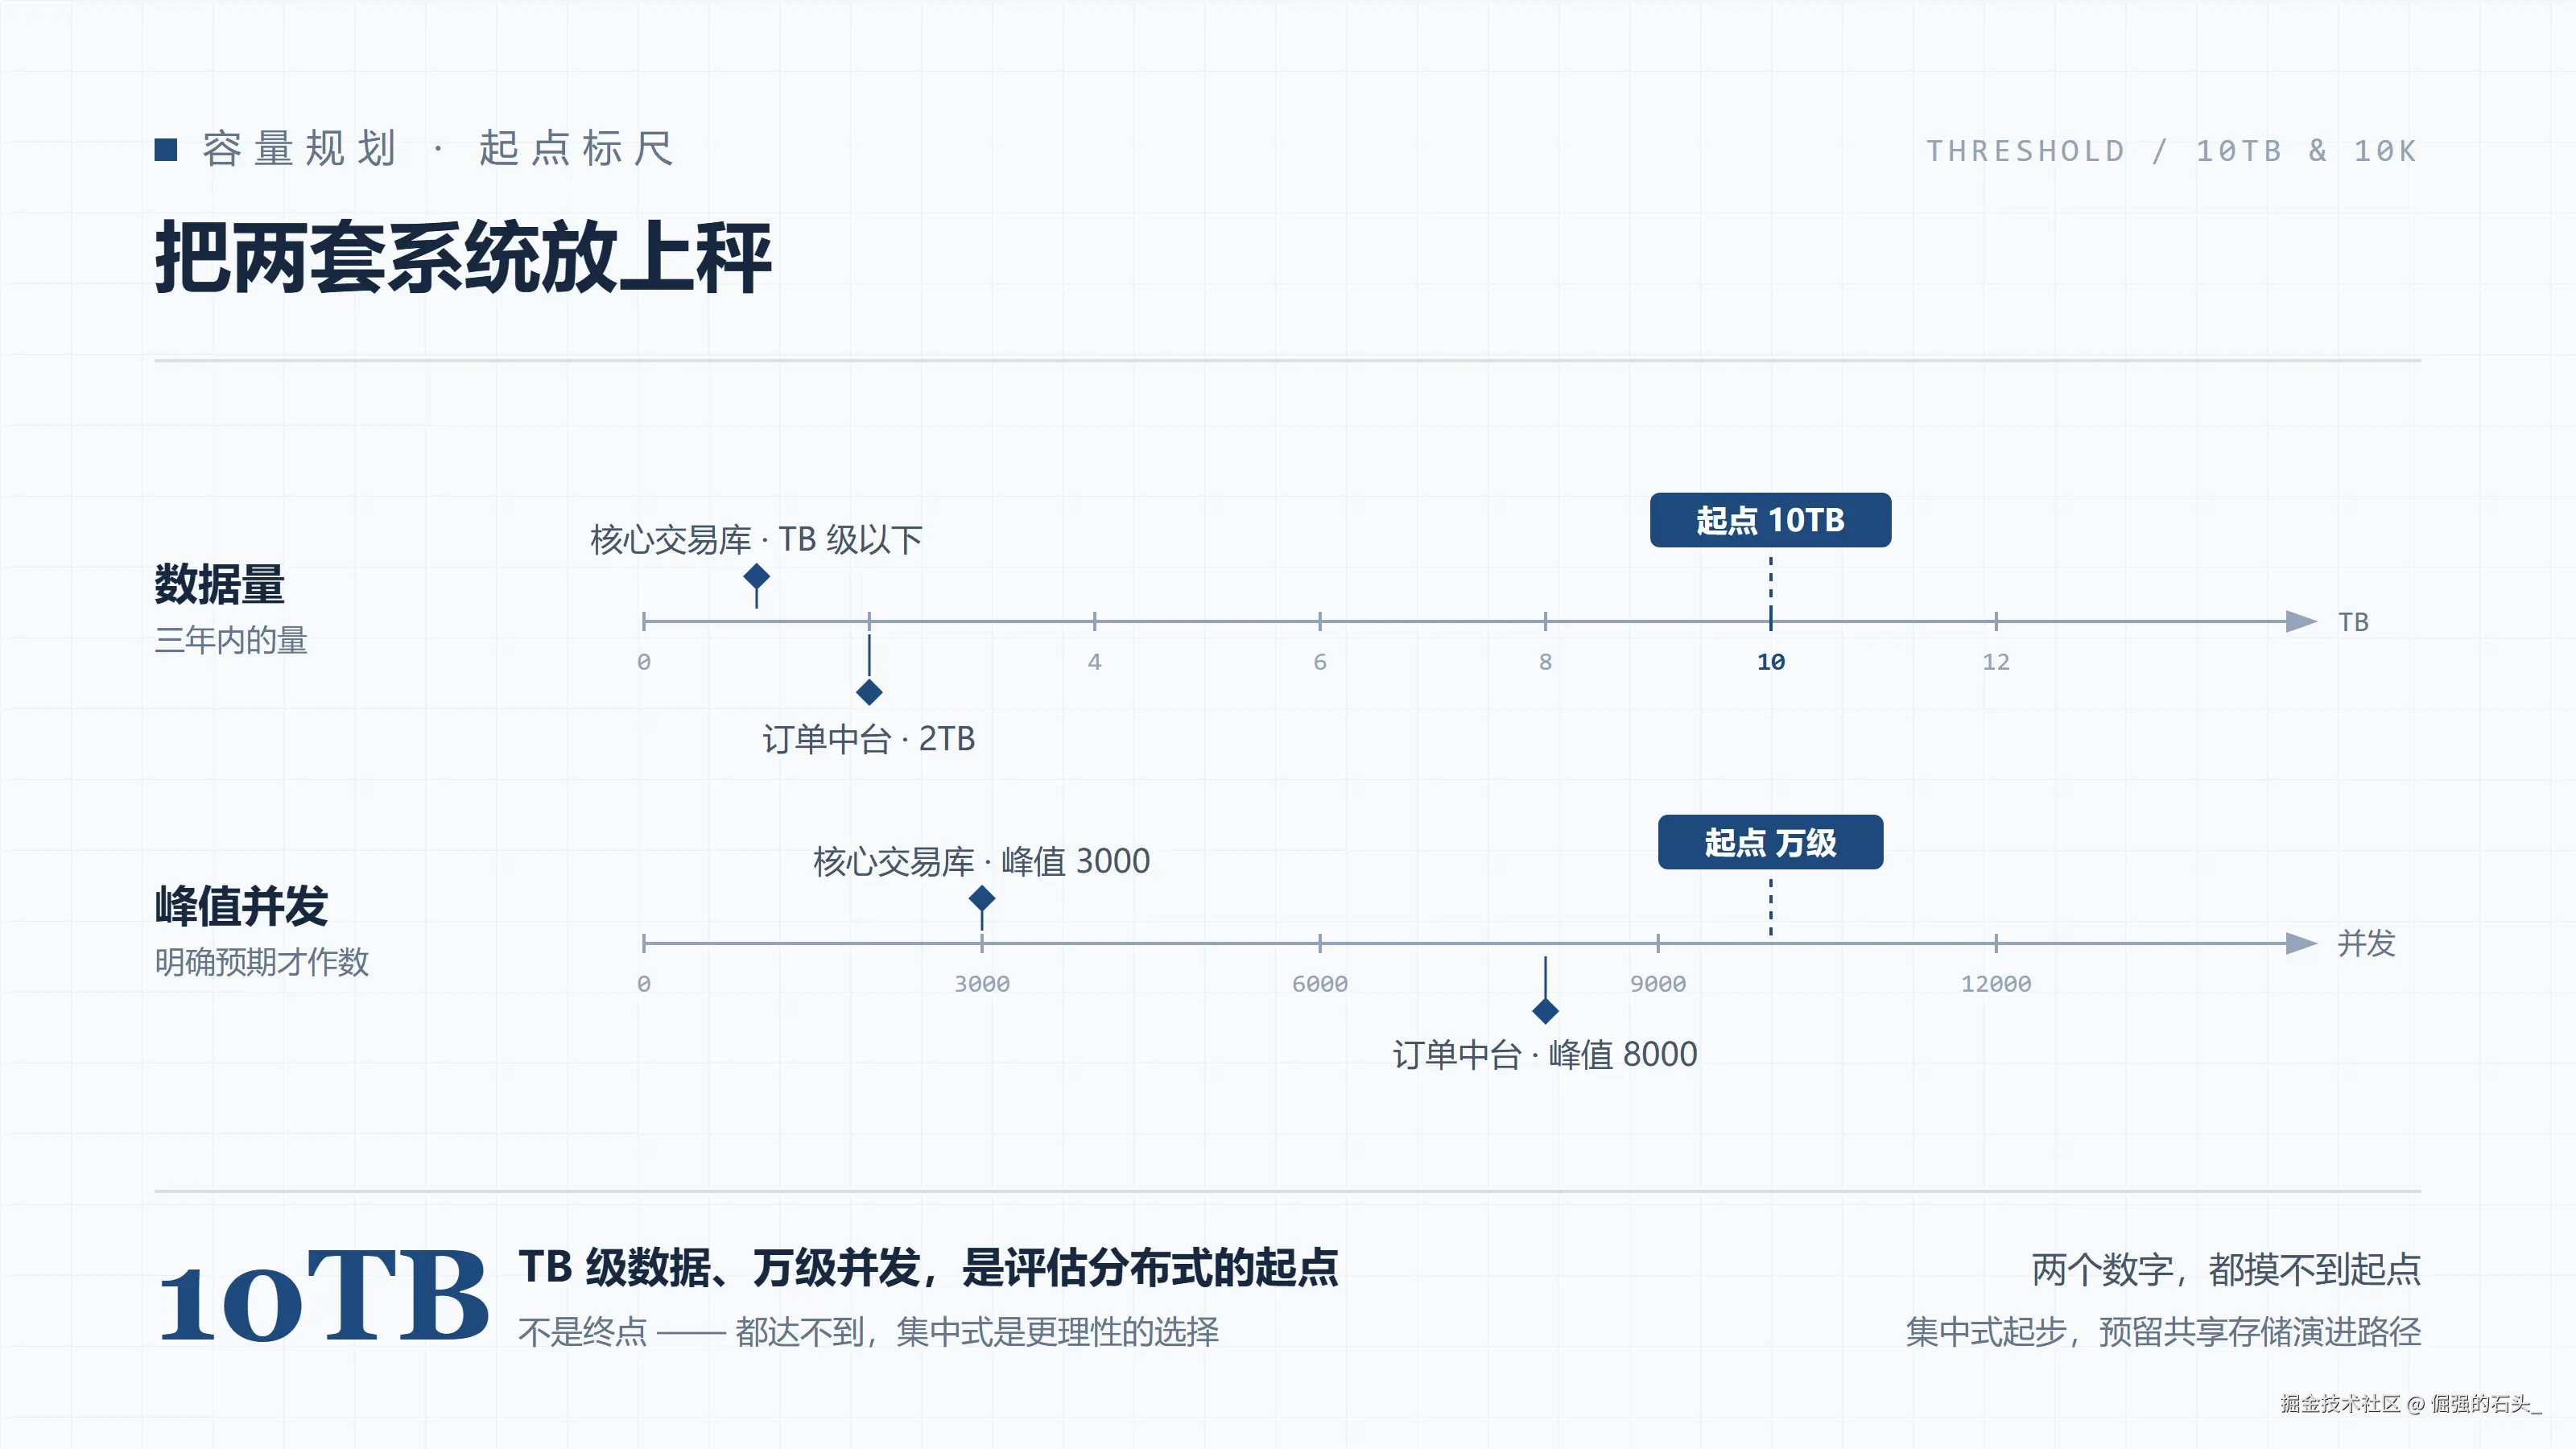
11 套系统过完秤,结论其实已经出来了。没有一套必须上分布式。 真正要研究的是,集中式内部怎么选。普通主备够不够,要不要上共享存储集群。
四、在金仓 KES 上做的功课
业务归类完,产品层面我重点看了金仓数据库 KingbaseES(下文简称 KES)。原因很简单。前面说过,我们这次要解决的是集中式内部怎么选的问题。而金仓一套产品线里,集中式、分布式、共享存储集群三种形态都有。选型空间都在一个体系里,这对我们是有实际价值的。
几个我看中的点,按我们团队的实际情况说:
一是迁移成本。 我们的老系统一半在 Oracle 上。选国产库,Oracle 兼容能力直接决定迁移的工作量。公开资料里提到的口径是,金仓 KES 对 PL/SQL 包、自治事务、游标循环这些关键特性支持得比较完整。实际迁移项目里,超过 95% 的存储过程经过少量调整就能直接运行。这个数字我们没法照抄,得在 POC 里自己验。但它至少说明方向是对的。
二是共享存储集群。 我们有个支付相关的系统,将来要替代 Oracle RAC。这个需求在集中式框架内就能解决。金仓 RAC 这类共享存储集群,本来就是对标 RAC 使用习惯做的。时延特性和运维习惯都能延续。这也是我这次写页纸的一个重要结论。有 RAC 替代需求,不构成上分布式的理由。它是集中式里的一个技术分支。
三是业务形态杂。 我们公司除了关系型数据,还有文档类的客服记录、设备上报的时序数据。AI 那边这两年还要做向量检索。金仓在多模融合上走得比较靠前。关系、文档、时序、向量在一个产品体系里。业务形态杂的公司,这个能力可以少维护好几套专用库。
四是信创适配面。 国产 CPU 方面,鲲鹏、飞腾、海光、龙芯都有覆盖。操作系统方面,银河麒麟、统信 UOS 也都在适配清单里。我们下游客户里政企多。这个不是加分项,是及格线。
顺手附上我盘点库体量用的两个 SQL。金仓 KES 下可以直接跑:
sql
-- 每个库的体量,从大到小排
SELECT datname,
       sys_size_pretty(sys_database_size(datname)) AS db_size
FROM sys_database
ORDER BY sys_database_size(datname) DESC;

-- 当前库里最大的 10 张表
SELECT relname,
       sys_size_pretty(sys_total_relation_size(oid)) AS total_size
FROM sys_class
WHERE relkind = 'r'
ORDER BY sys_total_relation_size(oid) DESC
LIMIT 10;
这俩 SQL 看着简单。但在容量规划会上,它们产出的数字,比我准备的任何 PPT 都管用。
五、三问拍板
最后那页纸,我把决策压缩成了三个问题:
- 数据量三年内会不会稳定超过 10TB?并发有没有明确的万级以上预期? 都没有,走集中式,不用犹豫。
- 有明确的 Oracle RAC 替代需求吗? 有,在集中式框架内评估共享存储集群。不要因此跳到分布式。
- 业务已经稳定在云上了吗?负载波动大吗? 是的话可以看云原生。不是的话,云原生的弹性你用不上,反而多背一层复杂度。
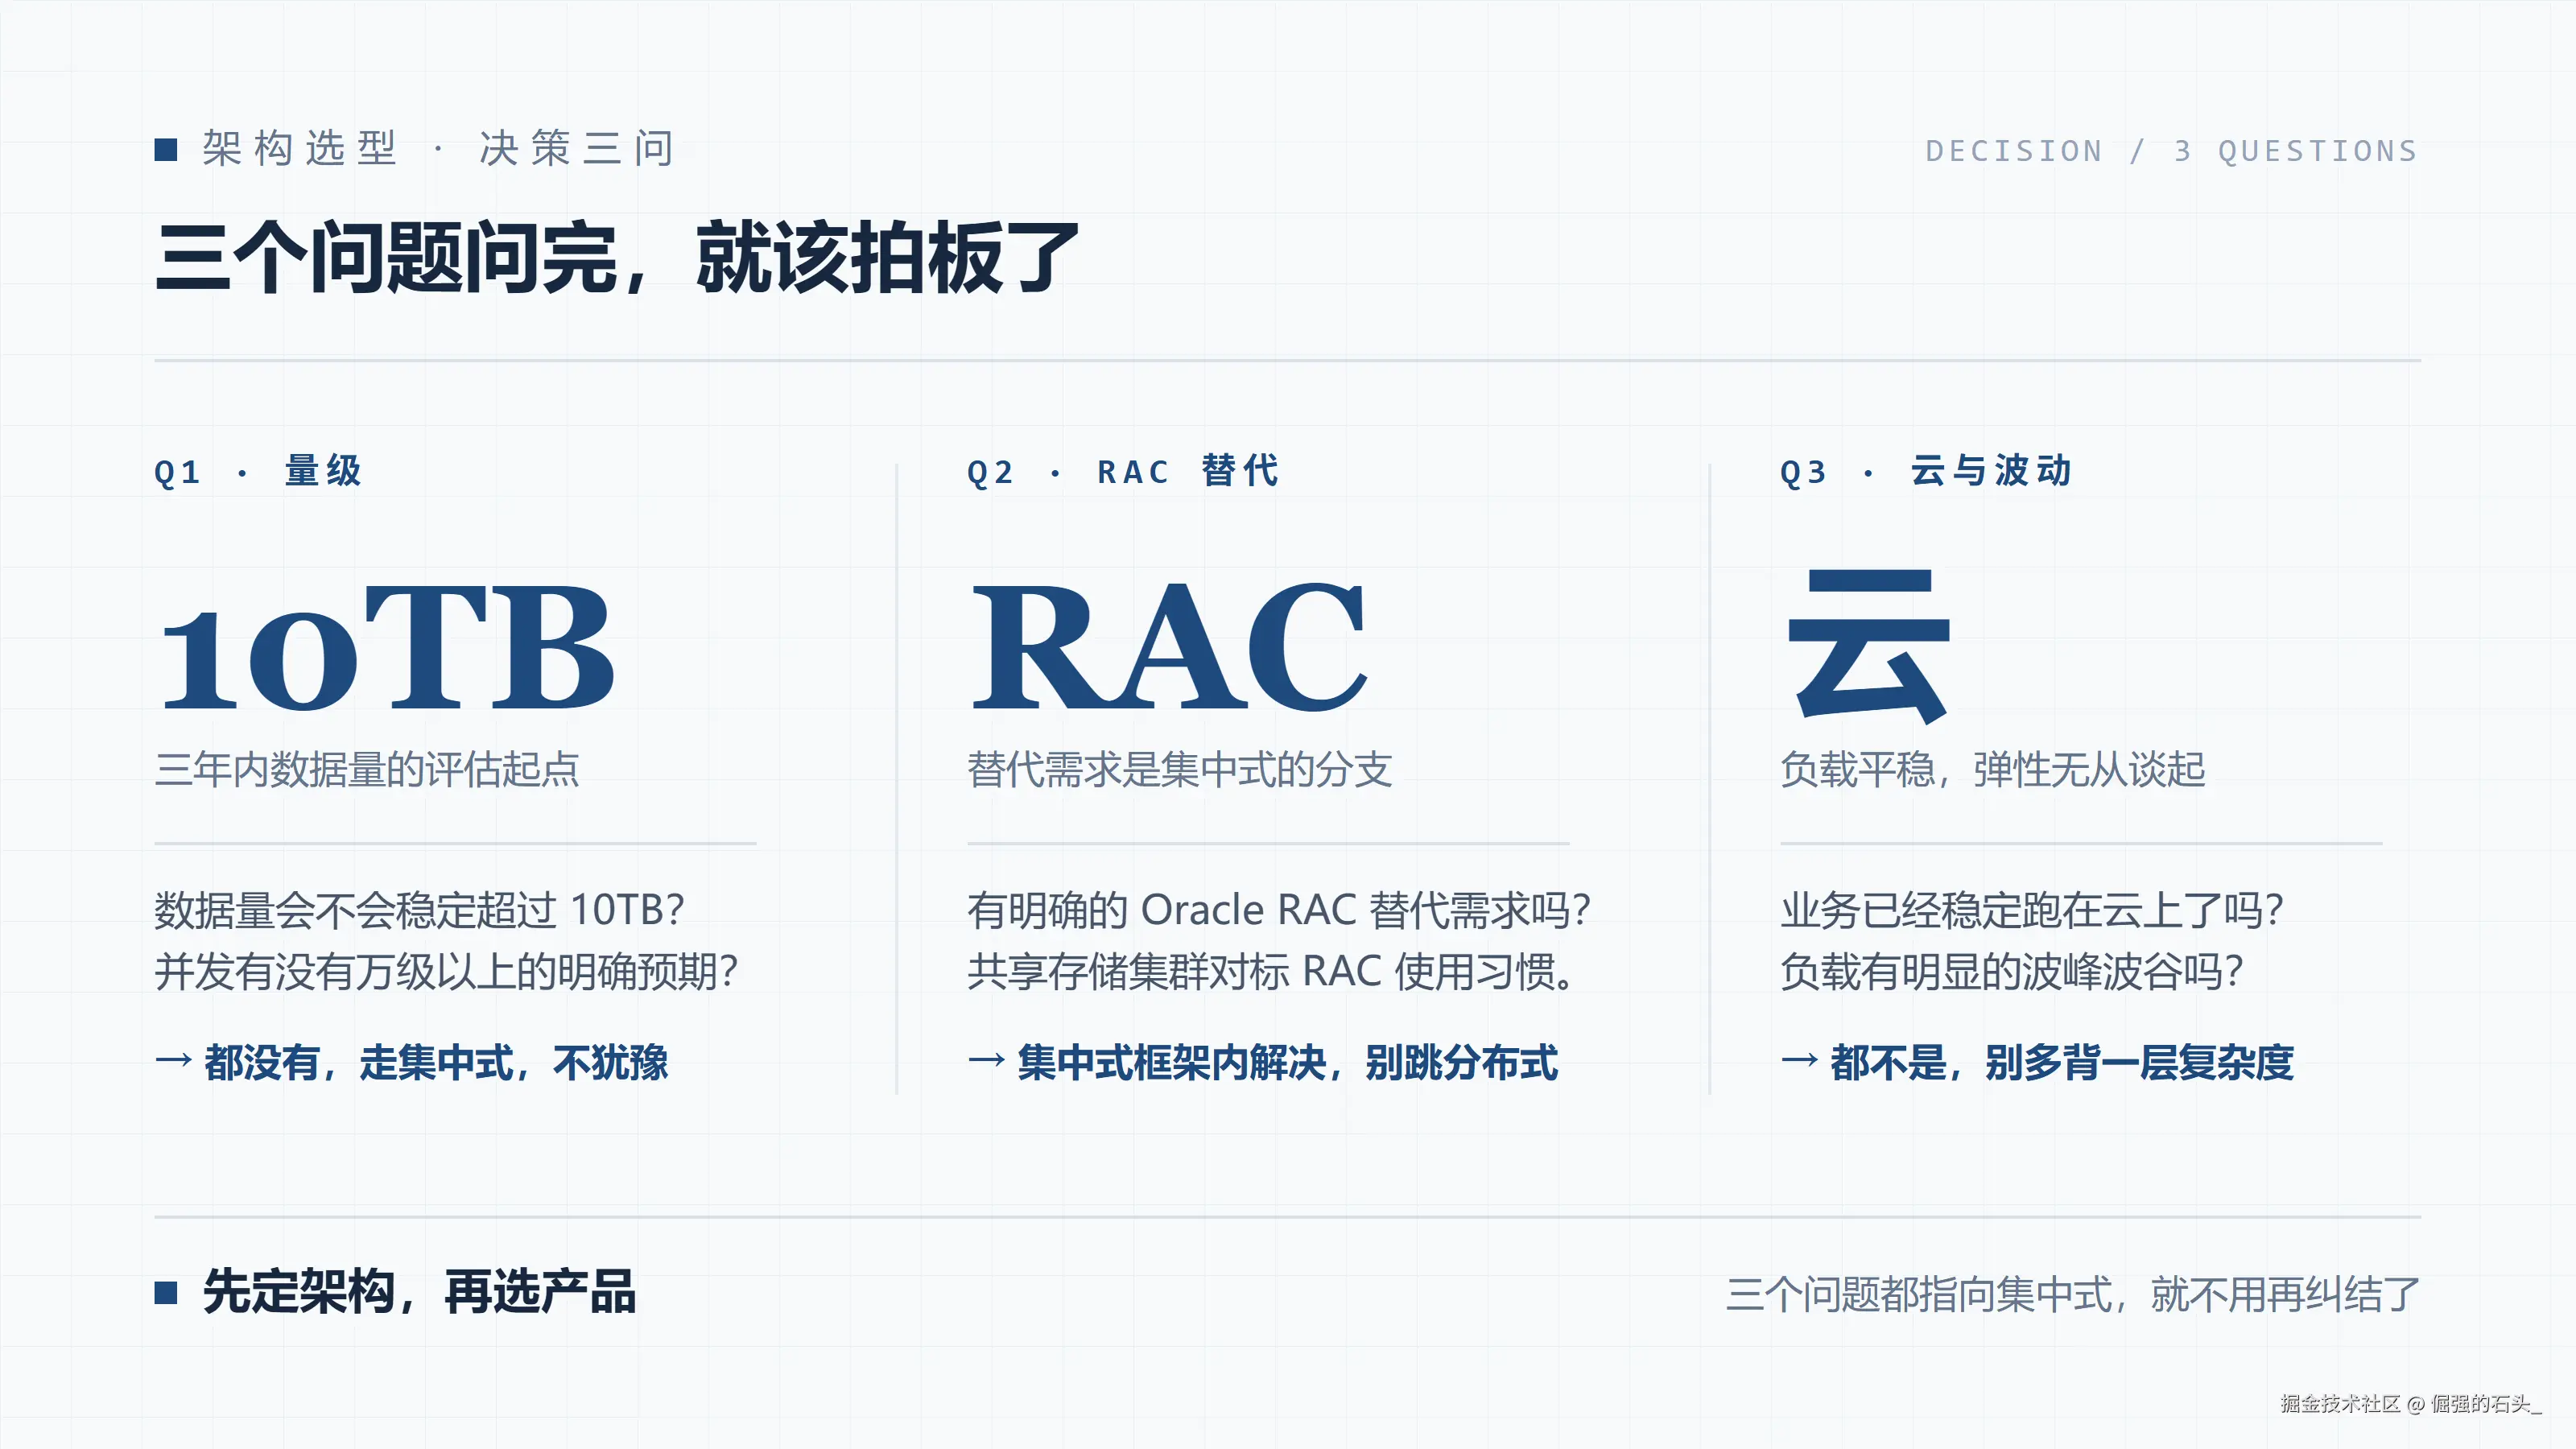
三个问题问完,订单中台的结论就定了。集中式起步,预留往共享存储集群演进的路径。会上基本没有争议。因为每一个数字,都是从我们自己的系统里称出来的。
那天散会以后,我记了一句话在笔记本上。今天也送给正在纠结的同行。先定架构,再选产品。架构选错了,后面所有的参数对比、POC 测试、迁移实施,都是白费。
没有最好的数据库。只有跟你未来三年业务形态最匹配的数据库。