导语:
在单细胞免疫组库(scBCR-seq)分析中,我们通常能获得成千上万对精准配对的 IGH(重链)和 IGL(轻链)的 V(D)J 序列。然而,序列只是字母的排列,真正决定抗体能否特异性结合抗原的,是它们折叠成的三维(3D)空间结构。
今天,我们将跨越序列到结构的鸿沟,手把手教你如何从 scBCR-seq 数据出发,使用最前沿的深度学习工具 IgFold 预测抗体 Fv 区结构,并结合 PyMOL 进行从基础着色、插件注释到高阶界面美化与分子对接的全套实战操作,助力你的课题研究与 SCI 文章发表!
一、 工具选型:为什么是 IgFold?
抗体的 Y 字型结构由两条重链和两条轻链组成,但在单个 B 细胞中,由于等位基因排斥,scBCR-seq 通常只能测出一对匹配的 H 链和 L 链序列(注意:预测时输入完整可变区序列即可,无需 CDR3 区)。
由于抗体结构的特殊性(尤其是高度变异的 CDR 环区),选择专门针对抗体训练的模型至关重要:
- 专用深度学习工具(首选)
- IgFold:专为抗体设计,预测速度快,对 CDR H3 环区预测准确性较好,是目前最常用的基线工具。
- HeavyBuilder :基于 ImmuneBuilder 架构,专注重链高通量预测,速度极快,适合大规模筛选(官网:
https://opig.stats.ox.ac.uk/webapps/HeavyBuilder)。
- 通用 AI 预测平台
- AlphaFold3 (AF3):在抗体-抗原复合物预测上有优势,但单抗体预测并非其最强项(对 CDR H3 的预测精度存在一定物理上限)。
- AlphaFold2 (AF2.3-M):抗体专用版本在 CDR H3 精度上与 IgFold 相近。
- 专业免疫学建模服务器
- LYRA (通过 IEDB 访问)、RosettaAntibody 、DIGIT 等,适合作为自动化同源建模的交叉验证。
提醒:CDR H3 环区在溶液中可能本身具有高度动态灵活性,任何预测模型(哪怕是 AF3)都存在物理上限。如果条件允许,最终需通过实验(如晶体衍射)验证。
二、 Windows 10 下的 IgFold 安装避坑指南
在原生 Windows 上运行 IgFold,最大的痛点在于其可选优化工具 PyRosetta 无法在 Windows 原生环境安装 。为了追求最快捷的流程(接受结构不进行极致的侧链几何优化),我们直接采用 Anaconda + Pip 的原生安装方案。
核心安装步骤(在 Anaconda Prompt 中执行)
bash
#创建并激活环境:
conda create -n igfold python=3.8 -y
conda activate igfold

#安装 CPU 版本 PyTorch(建议用 pip 替代 conda,绕过 conda 的缓存解压报错):
pip install torch --index-url https://download.pytorch.org/whl/cpu

#安装 IgFold 及防冲突依赖:
pip install igfold
pip install transformers==4.25.1 huggingface-hub==0.11.1 tokenizers==0.13.2
#验证安装:
python -c "from igfold import IgFoldRunner; print('IgFold 导入成功')
三、 跑通第一个预测脚本
新建一个 test_igfold.py 文件,填入你的 scBCR-seq 提取出的序列:
bash
from igfold import IgFoldRunner

# 1. 准备一对示例序列(请替换为你自己 scBCR-seq 提取的 VH 和 VL 序列)
# 注意:只需要氨基酸序列,不需要包含信号肽或恒定区(只保留可变区即可)
sequences = {
    "H": "EVQLVQSGPEVKKPGTSVKVSCKASGYTFTNYWITWVRQAPGQGLEWMGDIYPGSGNTNYNEKFKGRVTITRDTSASTAYMELSSLRSEDTAVYYCARGRDYYGSSYWYFDLWGRGTLVTVSS",
    "L": "DIVMTQSPDSLAVSLGERATINCKSSQSVLYSSNNKNYLAWYQQKPGQPPKLLIYWASTRESGVPDRFSGSGSGTDFTLTISSLQAEDVAVYYCQQYYSTPWTFGGGTKVEIK"
}

# 2. 初始化 IgFoldRunner
print("正在初始化 IgFoldRunner (首次运行会自动下载几百MB的预训练权重,请耐心等待)...")
igfold = IgFoldRunner()

# 3. 执行结构预测
print("开始预测 3D 结构...")
igfold.fold(
    "my_antibody.pdb",       # 预测结果保存的文件名
    sequences=sequences,     # 传入序列字典
    do_refine=False,         # 原生 Windows 下无 PyRosetta,必须设为 False
    do_renum=False           # 设为 False,避免连接 AbNum 服务器时网络超时
)
print(" 预测成功!请用 PyMOL 或 ChimeraX 打开 my_antibody.pdb 查看结构。")
运行 python test_igfold.py,几秒钟后你就会得到抗体的 Fv 区 PDB 结构文件!
四、 PyMOL 基础着色与选择
将生成的 my_antibody.pdb 导入 PyMOL。隐藏杂乱的线条,输入 show cartoon 显示骨架。通过 util.cbc 命令,PyMOL 会自动按链分配颜色。
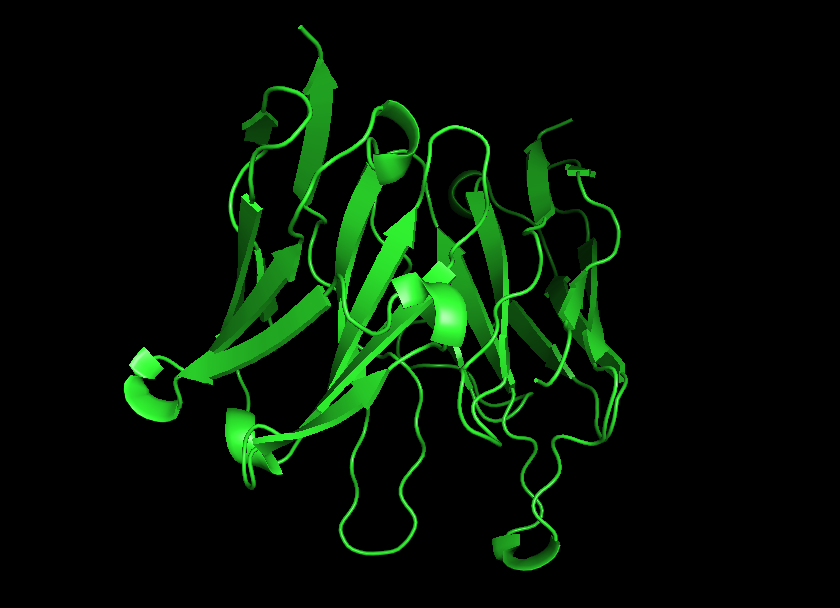
你也可以手动指定:
bash
color red, chain H
color blue, chain L
为了方便后续操作,使用 select 命令单独选中重链:select HeavyChain, chain H。
五、 核心进阶:使用 Annotate_v 插件进行 CDR 注释
这是抗体分析中最常用的功能,我们需要标记出 FR(骨架区)和 CDR(互补决定区)。
1. 插件安装与避坑
从 PyMOL Wiki 的 Annotate_v 页面(或 GitHub)下载 annotate_v.py 文件。
- 方法一 :在 PyMOL 菜单栏
Plugin->Plugin Manager->Install New Plugin中导入。 - 手动放置 :将文件复制到
C:\Users\你的用户名\AppData\Roaming\pymol\startup\目录下。
踩坑预警 :有时插件管理器提示安装成功,但调用时报错 NameError: name 'annotate_v' is not defined。这是因为脚本未自动加载。只需在命令行手动运行一次:
bash
run C:\Users\1\AppData\Roaming\pymol\startup\annotate_v.py2. 执行注释(关键:一次只选一条链)
bash
# 注释重链
select VH, chain H
annotate_v("VH", "kabat")
# 注释轻链
select VL, chain L
annotate_v("VL", "kabat")
报错排查 :如果出现 Selector-Error: Invalid selection name 或 AttributeError: 'NoneType' object has no attribute 'keys',说明:1. 你没有先 select 创建选区;2. 你的网络连不上 AbNum 服务器;3. 你选的链不完整。
运行成功后,控制台会打印出 FR1~4 和 CDR1~3 的序列,右侧面板会生成 H-CDR1 等选择对象。
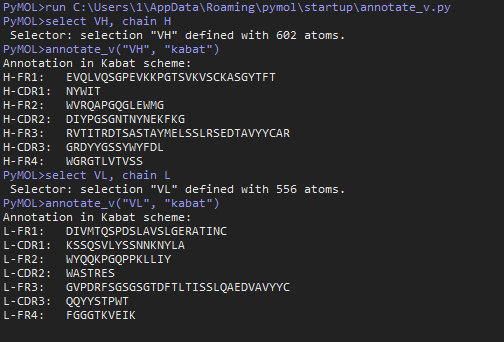
3. 高亮结合核心
bash
# 将 CDR3 区域染成显眼的红色
color red, H-CDR3
color red, L-CDR3
# 显示侧链
show sticks, H-CDR3
六、 界面分析与氢键网络可视化
VH 和 VL 的相互作用界面构成了抗原结合口袋。使用 around 命令找出 4.0 Å 范围内的界面残基:
bash
select interface_VH, chain H and byres (chain L around 4.0)
select interface_VL, chain L and byres (chain H around 4.0)
show sticks, interface_VH or interface_VL
bash
dist polar_contacts, chain H, chain L, 4.0
color red, polar_contacts
set dash_radius, 0.3, polar_contacts
show dashes, polar_contacts
此时,重链和轻链之间的氢键网络就会以清晰的红色线呈现出来。
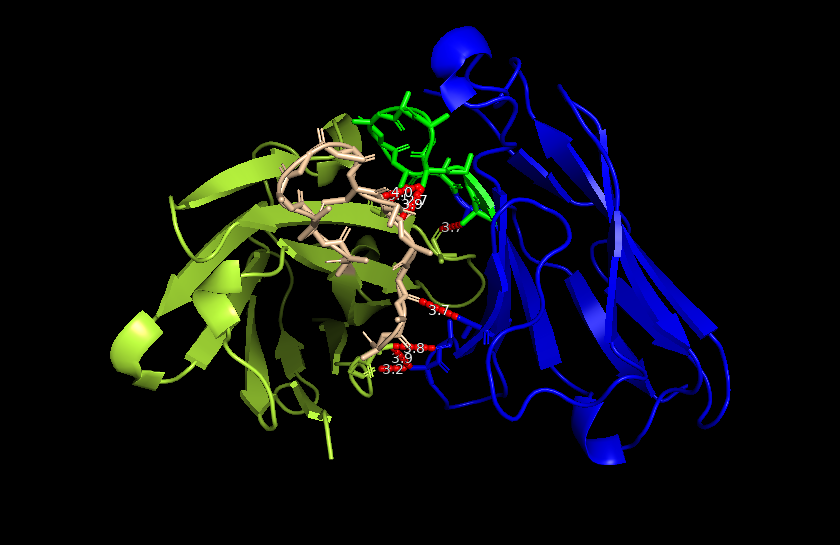
七、 高阶出图:复刻 OPIG 风格的高颜值界面
为了让你的图达到发表级别,我们需要结合半透明表面、球体模型和高阶光影。复制以下脚本一键渲染:
bash
# ================= 1. 基础清理与环境 =================
hide everything
bg_color white
set ray_shadows, 1        # 开启阴影,增强立体感

# ================= 2. 渲染半透明外壳(Surface) =================
# 生成整个抗体的表面
show surface, all
# 设置透明度(0.5-0.7之间,越接近1越透明)
set transparency, 0.6, all
# 提高表面平滑度
set surface_quality, 2
# 赋予表面一个偏冷的浅蓝/青色系,模拟参考图的背景质感
color palecyan, all
set surface_color, palecyan, all

# ================= 3. 生成"巨型球体"(核心步骤) =================
# 显示所有原子为球体(或者如果你想只显示界面,把 all 换成 interfaceRes)
show spheres, all

# 核心参数:调整球体大小
# 默认是 1.0(原子的真实范德华半径)。如果你想要更大更夸张,可以改到 1.2
set sphere_scale, 0.5, all
set sphere_quality, 2     # 让球体边缘非常圆润

# ================= 4. 配色与重点突出 =================
# 把重链(H)染成深紫/紫罗兰色
color violetpurple, chain H
# 把轻链(L)染成偏暗的青蓝色
color deepskyblue, chain L
color red, H-CDR3
color brightorange, L-CDR3
# 找出 H-CDR3 周围 4.0 Å 内的轻链原子
distance cdr3_contacts, H-CDR3, chain L, 4.0

# 隐藏杂乱的数字标签
hide labels, cdr3_contacts

# 把连线染成高对比度的亮黄色,并加粗
color yellow, cdr3_contacts
set dash_radius, 0.25, cdr3_contacts
set dash_gap, 0.15, cdr3_contacts
set dash_length, 0.25, cdr3_contacts

# ================= 5. 光影增强(出图必看) =================
set specular, 0.6         # 球体表面的高光反光(塑料感)
set shininess, 50         # 高光锐度
set ambient, 0.2          # 降低环境光,让阴影更重
set direct, 0.6           # 主光源强度
调整好视角后,在命令行输入 ray 2400, 1800 进行高清渲染,并导出为 PNG。
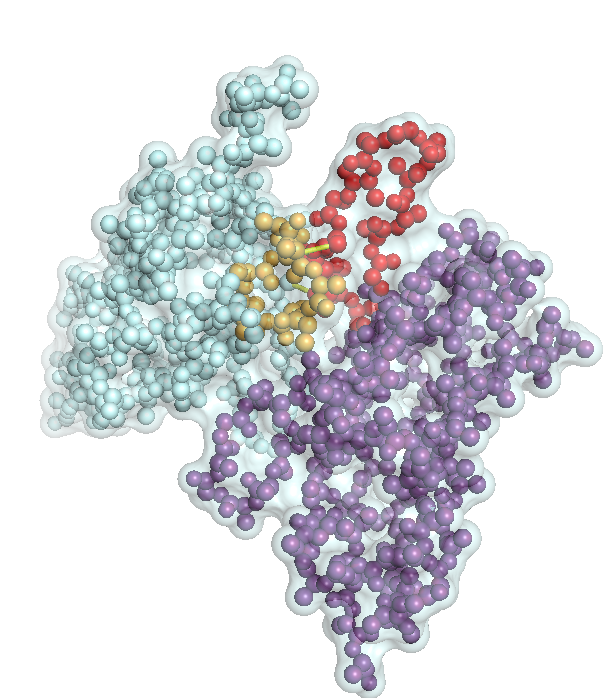
八、 延伸拓展:抗体与抗原的分子对接
如果你手头有抗原的 PDB 结构,想看看它们是怎么结合的?请注意:PyMOL 本身不具备完整的分子对接计算引擎,它主要用于对接前的准备和对接后的分析。
最佳策略:HADDOCK 服务器 + PyMOL 分析
- 在 PyMOL 中去水、清理你的抗体和抗原 PDB 文件。
- 提交至 HADDOCK 服务器(它有针对抗体-抗原的专属教程)。定义抗体侧 CDR 区域为活性残基,抗原侧定义表位残基。
- 计算完成后,下载排名靠前的复合物模型,回到 PyMOL 中,用
around和dist命令分析结合界面的疏水作用和氢键。
结语
从一长串的 V(D)J 序列,到最终跃然纸上的三维立体抗原结合口袋,生物信息学与结构生物学的结合让我们能以更直观的视角去理解免疫系统的精妙。掌握了 IgFold + PyMOL (Annotate_v) 的组合拳,你已经具备了独立挖掘单细胞免疫组库结构特征的核心能力。快去开启你的科研发现之旅吧!