Agent 处理一个跨模块缺陷,通常需要多轮读取代码、修改实现和运行测试。进入下一轮时,项目约束、历史事实和已经确认的线索仍然需要保留,相关的检索、上下文组装和模型输入也会持续产生开销。
PowerContext v1.5.0 将 token 效率工程作为本次更新的重点之一。 具体做了三件事:复用已经准备好的上下文,减少记忆与经验处理中的重复输入,并提供评测工具,检查这些优化是否降低了完成任务的实际消耗。
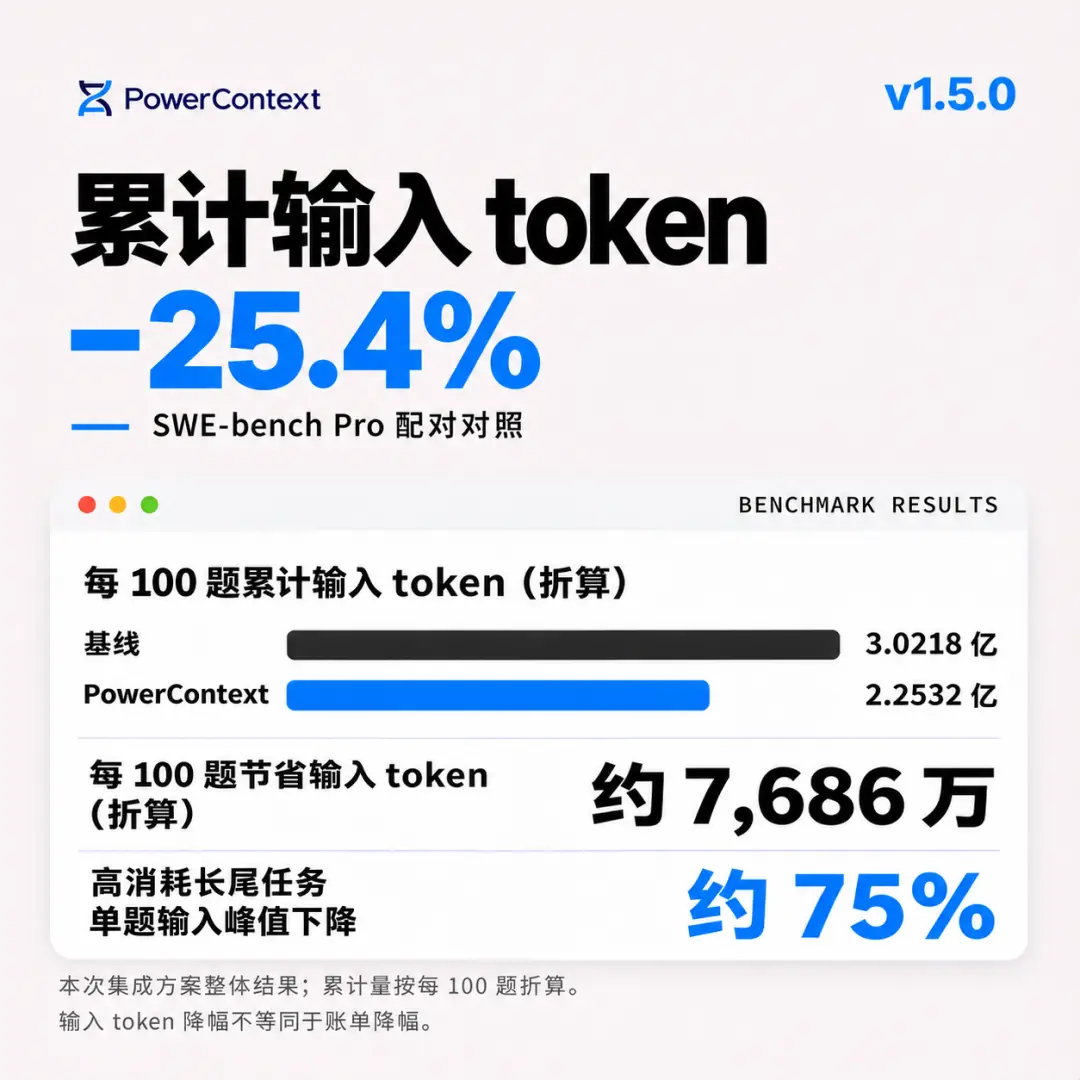
在本次 SWE-bench Pro 配对对照中,PowerContext 集成方案在任务完成效果未下降的情况下,累计输入 token 减少约 25.4%。
欢迎大家关注 OceanBase 社区公众号 "老纪的技术唠嗑局"。在这里,我们会持续为大家更新与 #数据库 和 #OceanBase 相关的技术内容~
每 100 题,少用约 7,686 万输入 token
SWE-bench Pro 是 Scale AI 提出的软件工程评测,任务来自真实的软件仓库。Agent 拿到代码和问题描述后,需要提交修改,再由测试检查问题是否解决、原有功能是否受到影响。它关注需要持续排查和修改的复杂任务,常常涉及多个文件,与我们关心的长程编码场景相契合。
下表比较了这组任务的通过率和输入消耗,累计量按每 100 题折算。(详见:官方论文1 · 评测代码2)。
| 指标 | 基线 | PowerContext 集成方案 |
|---|---|---|
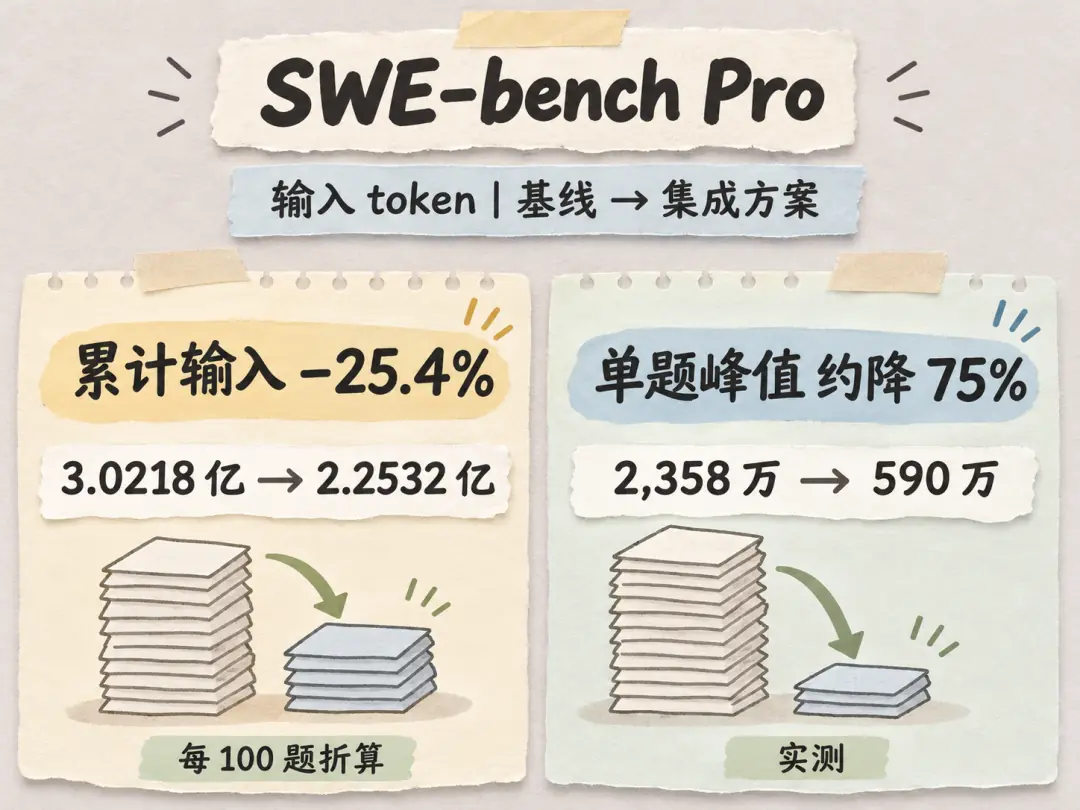
| 每 100 题累计输入 token(折算) | 约 3.0218 亿 | 约 2.2532 亿 |
| 每 100 题节省输入 token(折算) | --- | 约 7,686 万 |
| 输入 token 降幅 | --- | 约 25.4% |
| 实测单题输入峰值 | 约 2,358 万 | 约 590 万 |
本次节省主要来自高消耗长尾任务,单题输入峰值下降约 75% 。
持续排查、多轮验证会不断消耗上下文,少数高消耗任务可能占去整组任务的大量预算。降低这部分开销,是我们关注长程任务的一个重点。这次对照中,累计输入减少的同时,通过率也有所提高。
统计口径:累计量与等效通过题数按每 100 题等比例折算,单题峰值为实测值。数据反映集成方案的整体表现,各任务收益有差异,输入 token 降幅不等同于最终账单降幅。
减少记忆处理中的重复输入
Agent 使用记忆之前,系统需要从资料中提取事实、处理新旧事实的变化,并生成可复用的经验。这些步骤同样需要调用模型。
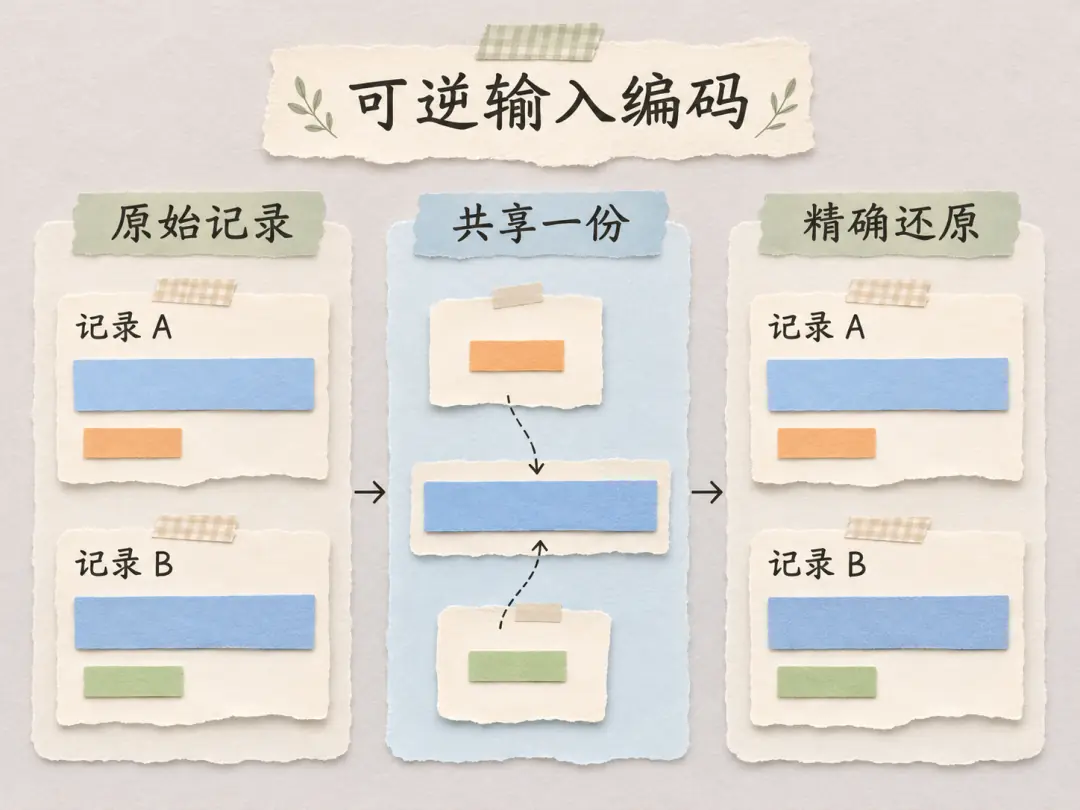
重复内容经常出现在这些输入中。例如,多条来源记录分别描述不同的问题,却附带完全相同的项目背景或元数据。逐条展开后,相同内容会在一次请求中出现多遍。
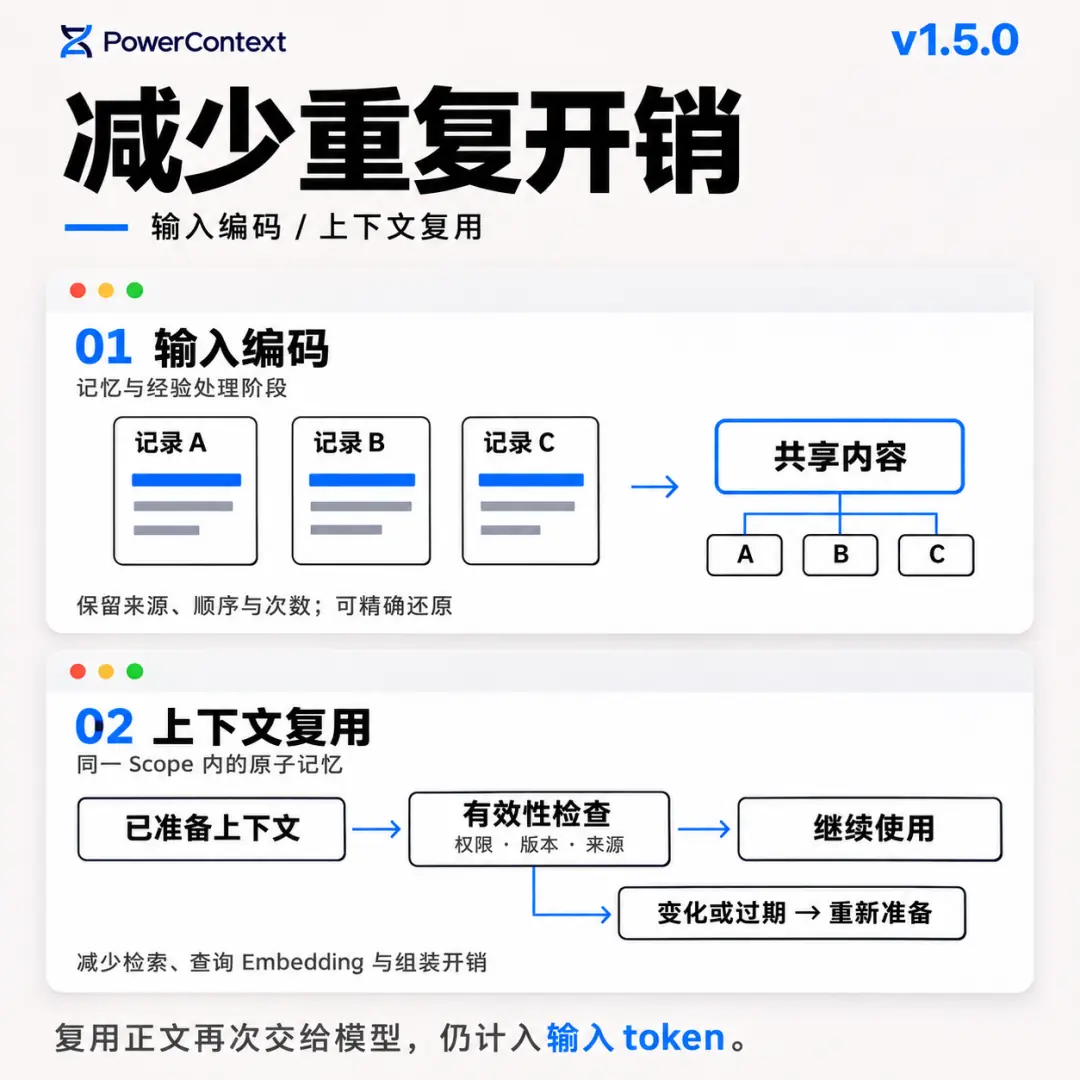
v1.5.0 引入了 可逆 shared-JSON 编码。严格相同的长内容保存一份,各条记录在原来的位置引用他。来源身份、记录顺序、重复次数和数据类型仍然保留。
例如,两条记录都包含同一段接口约束。编码可以共享这段约束,但两条记录仍各自保留来源、时间和具体内容,不会因为正文相同就被合并。
目前,这项编码用于:
- Atomic Memory 提取与协调,即事实提取和新旧事实处理。
- Experience 生成与孵化,即可复用经验的生成和完善。
它作用于 PowerContext 内部这些处理阶段的模型输入。
发送前,PowerContext 会在本地解码候选,检查能否精确还原原始输入,并将解码说明、共享值表和引用的开销一起计入估算。只有字节数更少,且估算 token 至少减少 32 个、降幅至少达到 5% ,才采用编码结果;不满足条件就继续发送原文。
这些门槛用于筛选候选。实际能节省多少 token,仍以模型供应商返回的用量为准。配置和适用范围见:输入编码文档3。
已经准备好的上下文,可以经过检查后复用
另一个优化点在上下文准备过程。
假设 Agent 已经检索到相关事实,完成查询 Embedding 和上下文组装。下一轮继续处理同一个问题时,如果资料和权限都没有变化,就有机会复用这份结果,避免重复准备。
v1.5.0 支持在同一个 Scope 内复用已准备的 Atomic Memory 上下文 。复用依赖短期凭据,每次使用都会重新检查当前权限、记忆版本和来源有效性。记忆发生修订、被遗忘,或者权限撤销、凭据过期,都需要停止复用旧结果。
这部分优化减少的是检索、查询 Embedding 和上下文组装开销。复用的正文再次发送给主模型时,仍然计入模型输入。 他与模型供应商的输入缓存是不同的机制。
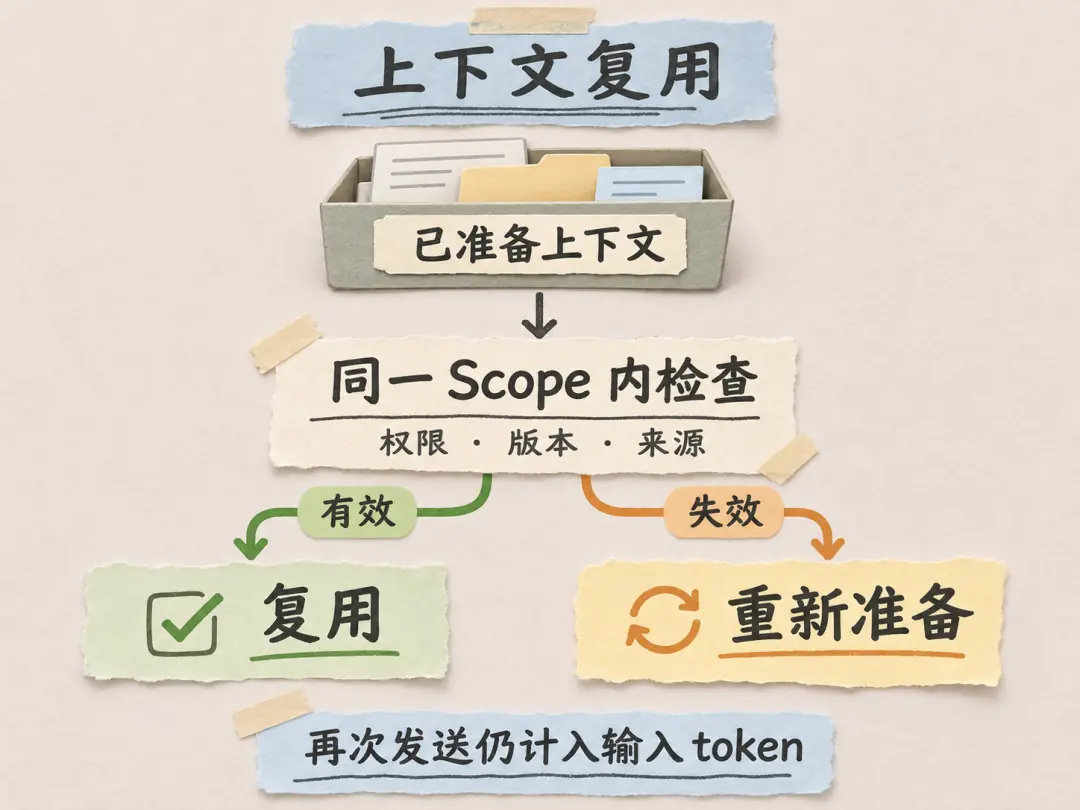
本次发布的 alpha 版 Rust Gateway 将这项能力接入连续请求:在启用记忆注入、能够识别会话的情况下,新用户消息触发一次上下文准备;同一会话中符合条件的工具续轮或重试,可以在凭据有效期内重用准备结果。每次发送和交付仍需经过检查。
对于一次用户请求引发多轮工具调用的工作流,这能减少上下文准备环节的重复工作。具体范围见:上下文复用文档4和 Gateway 文档5。
优化是否有效,要用完整任务验证
编码可以精确还原,不代表模型理解编码输入后一定能保持同样的质量。
模型可能混淆记录归属、遗漏引用关系,也可能消耗更多输出 token 来理解输入。如果因此增加重试,单次输入的节省就可能被后续调用抵消。
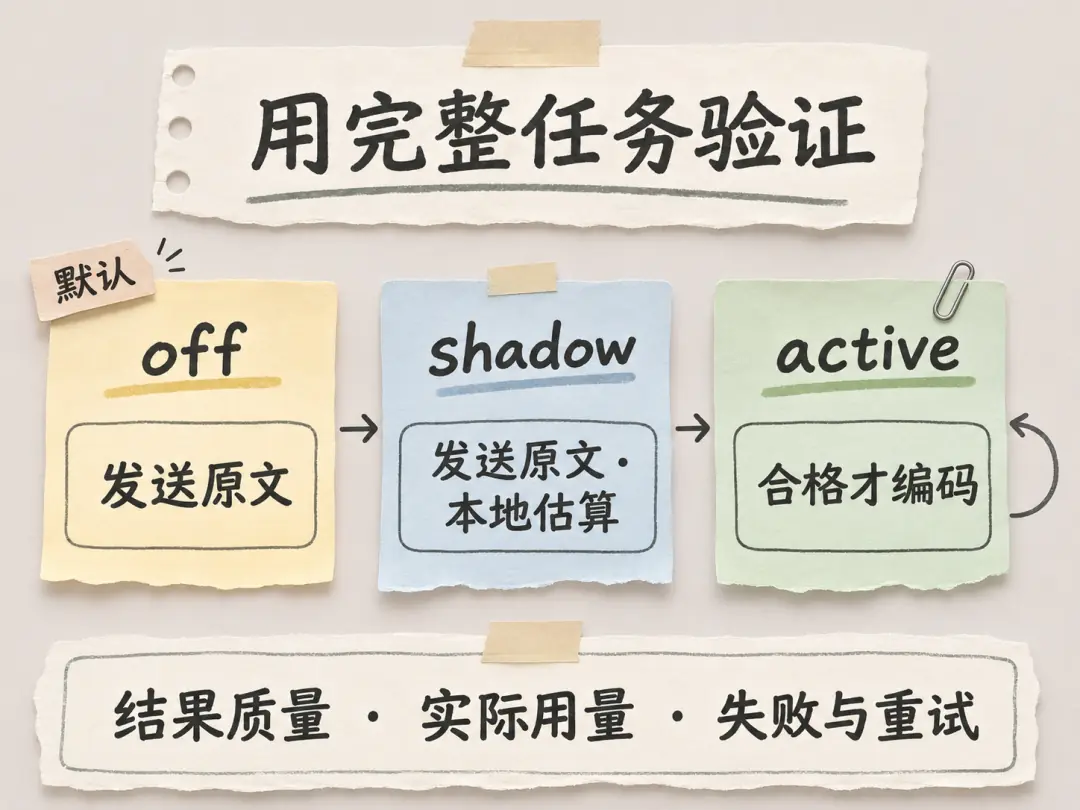
因此,v1.5.0 的输入编码默认关闭,提供三个模式:
| 模式 | 用途 |
|---|---|
off |
使用原始输入 |
shadow |
继续发送原文,只在本地计算编码候选和预估收益 |
active |
试验性使用符合条件的编码输入,否则回退原文 |
实际接入时,可以先用 shadow 观察自己的资料是否存在足够的重复,再对具体操作和目标模型进行对照评测。
评测需要同时检查事实与引用、任务结果、输入与输出用量,以及失败和重试。失败调用只要取得了用量,也要计入;没有取得的用量保留为未知。
判断依据是完成任务的总消耗和结果质量。 本地估算用于选择候选,不能代替真实调用的用量记录。
v1.5.0 的其他更新
除了 token 效率工程,本次版本还补充了数据接入、上下文诊断和部署能力。
Source 与 Artifact 插件体系。 Source 插件支持同步写入与持续采集;Artifact 插件支持定义、生成、检索和管理业务产物,并提供事故报告、工单摘要等示例。业务可以按自己的资料来源和输出要求扩展处理流程。
上下文选择回执。 准备上下文时,可通过 include_receipt 查看选中的精确版本、检索与回退方式、遗漏原因和阶段耗时,便于排查某条资料为什么被选中或没有进入上下文。
推理保护与 Gateway。 显式启用推理保护后,可在发送前检查最终请求,在交付前检查完整响应。Rust Gateway 提供兼容 OpenAI 的 Chat Completions 与 Responses 入口,目前仍为 alpha,缓冲完整响应后再放行,不提供实时逐 token 输出。
此外,版本还完善了 Desktop、受管本地 Server 和 Agent 集成,新增 Helm 部署支持,并扩展历史 Server 数据库迁移工具。完整范围与限制见正式发布说明6。
开发者致谢
感谢参与 PowerContext v1.5.0 的开发者,感谢大家在功能实现、代码 review、测试、文档和兼容性修复上的投入。也感谢社区用户提供问题和使用反馈,帮助我们在实际工作流中验证这些改进。
欢迎对 PowerContext 项目感兴趣的朋友们,点击文末的"阅读原文",访问 github 中的 PowerContext 项目~
有奖征文
邀请大家参与 PowerContext 有奖征文,把接入过程、实际效果和遇到的问题写下来。你可以从一个具体的开发任务出发,分享自己如何使用 PowerContext,
一篇有参考价值的实践,可以从一个问题、一段接入过程和一组真实结果开始。 欢迎附上关键配置、代码片段或脱敏后的运行记录,让其他开发者能够理解。尚未解决的问题、效果不及预期的尝试,也值得分享。
我们希望通过这次征文,收集更多真实工作流中的使用经验,帮助大家找到适合自己的接入方式。
活动时间:元旦前每周评选三位
活动奖励:社区限量马克杯
参与方式:
有公众号的同学:在自己的微信公众号发布原创实践文章,并提交文章链接。
没公众号的同学:在 GitHub 提交 blog pr,在审核通过后发布至 PowerContext 官方 Blog。
期待你的实践与反馈,帮助 PowerContext 持续改进。❤️
参考资料
1
官方论文: arxiv.org/abs/2509.16...
2
评测代码: github.com/scaleapi/SW...
3
输入编码文档: github.com/oceanbase/p...
4
上下文复用文档: github.com/oceanbase/p...
5
Gateway 文档: github.com/oceanbase/p...
6
正式发布说明: github.com/oceanbase/p...

相关内容推荐
了解更多
添加社区小助手,加入微信交流群~