作者:桑绍情
本文以 React v19.2.8 稳定版为准
在开发构建中,当 React 使用数组或可迭代对象渲染一组同级子节点时,如果直接生成的子节点没有提供 key,React 会在控制台输出:
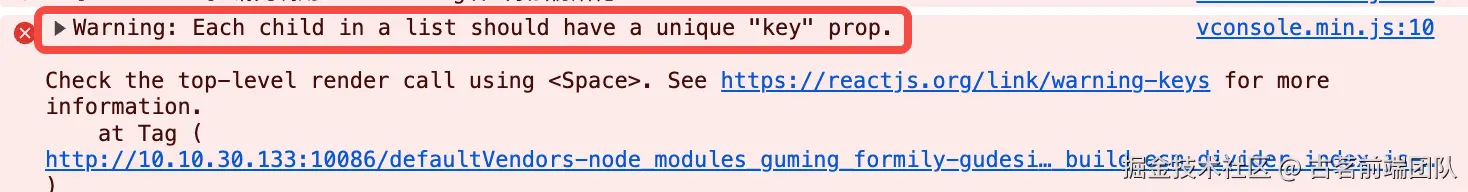
react的官方解释是这样说的:
你需要给数组中的每个元素指定一个唯一标识符key------1个字符串或数字,用于在数组中的其他元素之间唯一标识该元素:
<li key={person.id}>...</li>key告诉 React 每个组件对应哪个数组项,以便后续进行匹配。如果数组项可以移动(例如由于排序)、插入或删除,这一点就显得尤为重要。精心选择的key可以帮助 React 推断究竟发生了什么,并对 DOM 树进行正确的更新。
官方总结笼统解释了一下key是用来干什么,但是没告诉我们key究竟是什么,以什么样的形式存在于react中。
既然key主要用来diff,那diff的过程又是怎样的呢?
所以这篇文章就让我们一起去深入解析一下react内部的key。
初识 key
抛开其他不谈,我们先解决一个基础的问题:写在 JSX 上的 key,最后到底去了哪里?
例如下面这段代码:
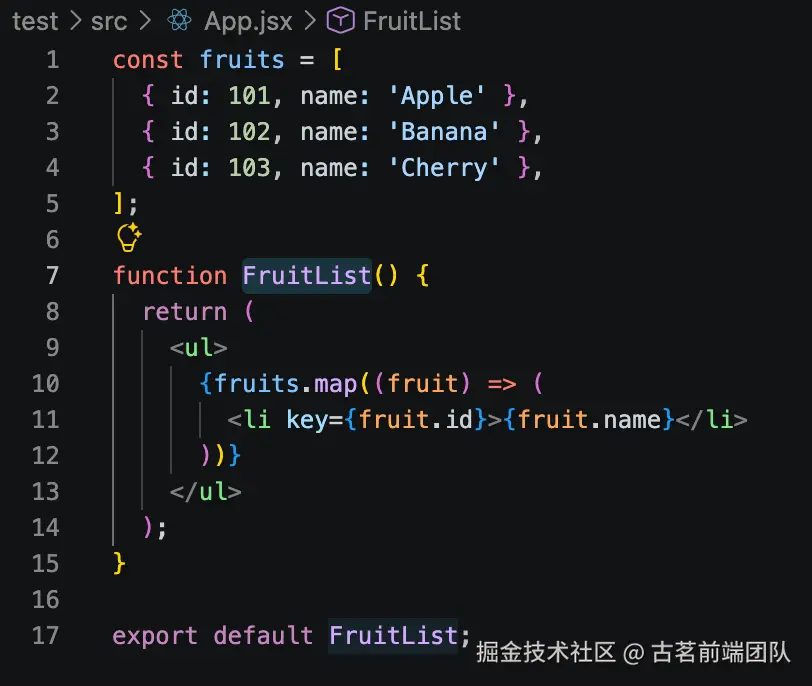
我们在<li>上写了一个 key,但打开浏览器的 Elements 面板,并不会看到这样的 DOM:
<li key="101">Apple</li>
实际生成的 DOM 仍然只是:<li>Apple</li>
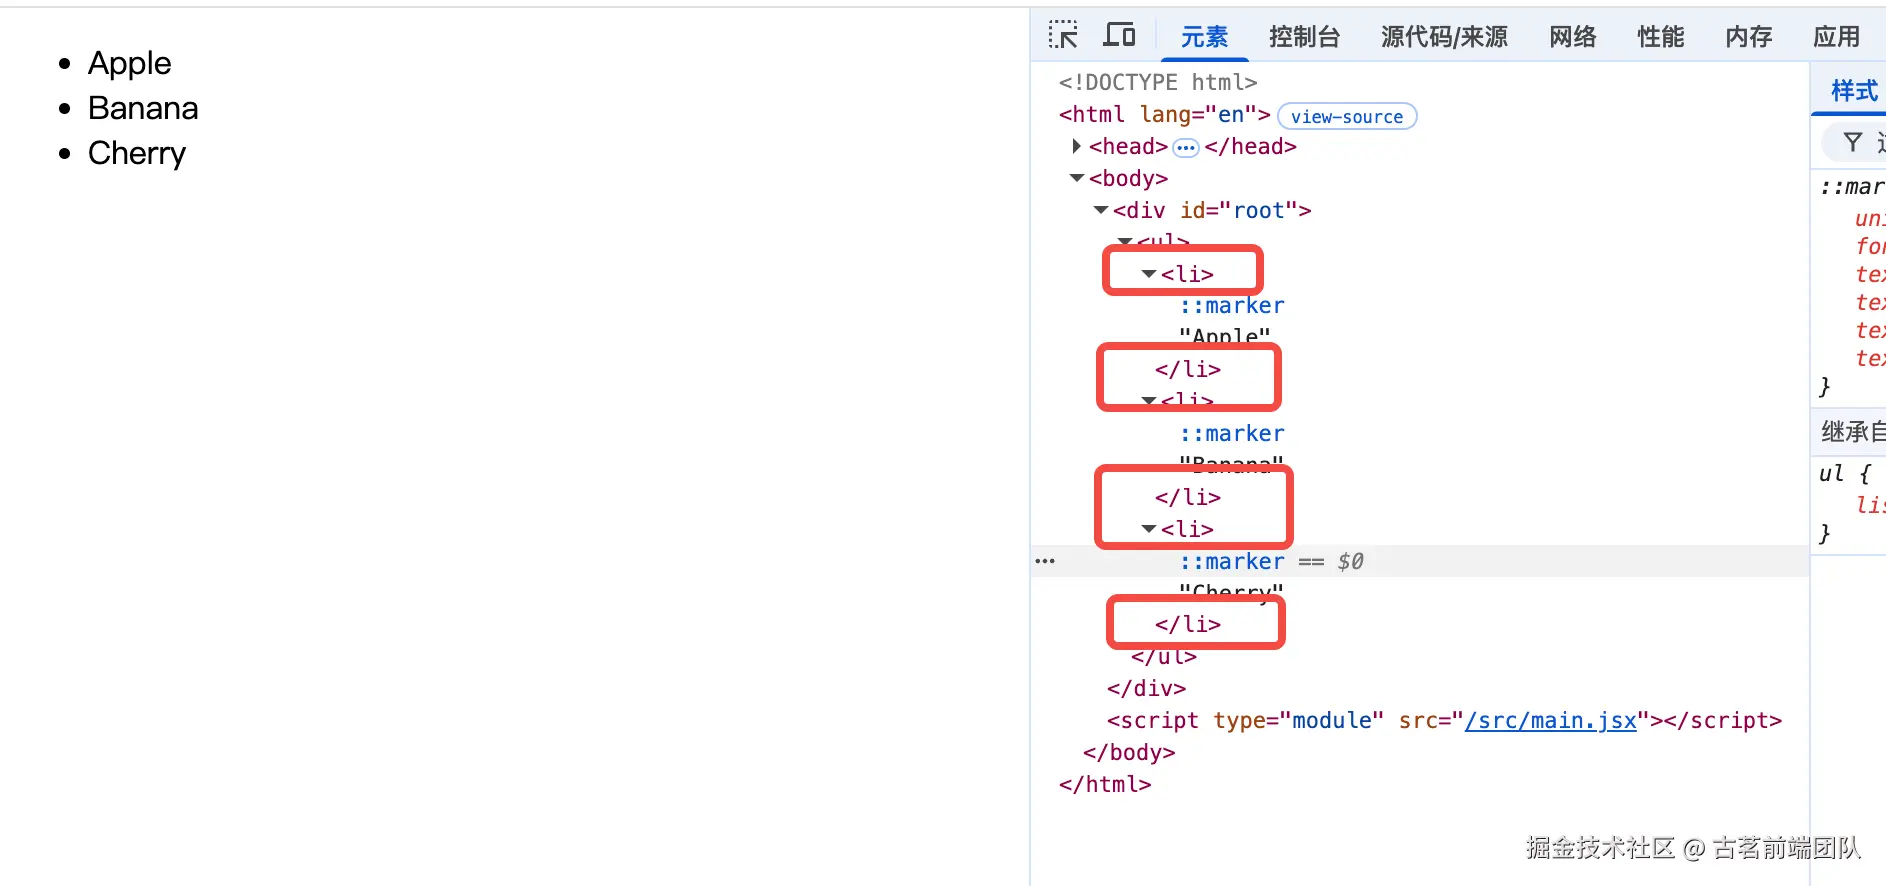
这说明 key 并不是传给浏览器使用的 HTML 属性。
key 不是普通 props
虽然我们把 key 写在组件标签上,但它不会像普通属性那样交给子组件:
xml
<li key={fruit.id}>{fruit.name}</li>在组件中不能依赖props.key,因为 key 是 React 的保留字段,不是普通的props。开发环境中读取 props.key,React 会给出提示。如果组件内部需要使用这个 id,应该另外传一份。
那么 React 把它保存在哪里呢?主要有两个地方:ReactElement 和 Fiber。
key 首先被保存在 ReactElement 中
JSX 只是我们编写 React 代码的一种语法。经过编译之后,JSX 通常会被转换成 jsx 或 jsxs 函数调用。
根据 JSX 创建一个 ReactElement 对象:
css
jsx(
  'li',
  { children: fruit.name },
  fruit.id,
);
ReactElement 的核心结构可以简化成下面这样:
php
function ReactElement(
  type,
  key,
  props,
  owner,
  debugStack,
  debugTask,
) {
  return {
    $$typeof: REACT_ELEMENT_TYPE,
    type,
    key,
    props,

    // 开发环境中的调试信息
    _owner: owner,

    // React 还包含 ref、_store、_debugInfo
    //
  };
}
React 对外允许 key 使用字符串或数字,但在创建 ReactElement 时通常会将其规范化为字符串。未提供 key 时,ReactElement.key 仍然是 null,React 并不会真的把数组下标写入 key 字段。
key 随后会进入 Fiber
ReactElement 描述的是"这一次 render 想要得到什么界面",React 还需要一套能够记录组件状态、更新关系和工作进度的数据结构,这就是 Fiber。
FiberNode 的核心结构可以简化成:
ini
function FiberNode(tag, pendingProps, key, mode) {
  this.tag = tag;
 this . key = key;

  this.elementType = null;
 this . type = null ;
  this.stateNode = null;

  //......
}
这里可以看到,Fiber 上也有一个 key 字段。这个值是从 ReactElement 中取出来的。创建 Fiber 时,源码会做类似下面的处理:
javascript
function createFiberFromElement(element, mode, lanes) {
  let owner = null;

  //......

  const fiber = createFiberFromTypeAndProps(
    element.type,
element. key ,
    element.props,

    //......
  );

    //......

  return fiber;
}
后续 React 更新列表时,便可以利用它寻找新旧节点之间的对应关系。
到这里,key 的保存位置已经清楚了。更新发生时,上一次渲染留下的 Fiber 中保存着旧 key,这一次渲染生成的 ReactElement 中带着新 key。React 接下来要做的,就是在同一个父节点下,利用这些信息建立新旧节点之间的对应关系,再结合元素类型判断哪些内容可以继续复用。
不过,key 只是判断节点身份的重要条件之一,并不是"key 相同就一定复用"。React 后面还会继续判断元素类型等信息。至于具体怎么比较,我们进行接下来的讲解。
利用 key
两次渲染之间,React 需要把Fiber 树和新的描述进行比较,再决定哪些内容保留、更新、移动、插入或删除。这个过程通常叫 reconciliation(协调);大家常说的 React Diff,可以理解成其中用于比较新旧结构的那部分工作。
React 19.2.8 的协调过程可以从以下角度理解:
- React 主要协调同一父节点下的子节点,不会自动推断任意层级之间的节点移动。
- 对于 React Element,React 会先比较 key,再结合元素类型判断旧 Fiber 是否可以复用。
- 没有显式 key 时,未设置 key 的子节点会使用当前位置作为匹配依据,因此插入、删除或排序时可能出现状态错配。
接下来结合源码,我们一起分析一下协调的过程:
入口函数
在 React 的 diff 中,key 的作用是用于判断节点是否可复用,从而减少不必要的diff,提高 diff 的效率。最终执行diff是在reconcileChildFibers 函数中,在该函数中,分别对单节点和多节点进行了新旧节点的diff比较。通过 key 判断节点是否可复用就发生在单节点和多节点的diff比较中。
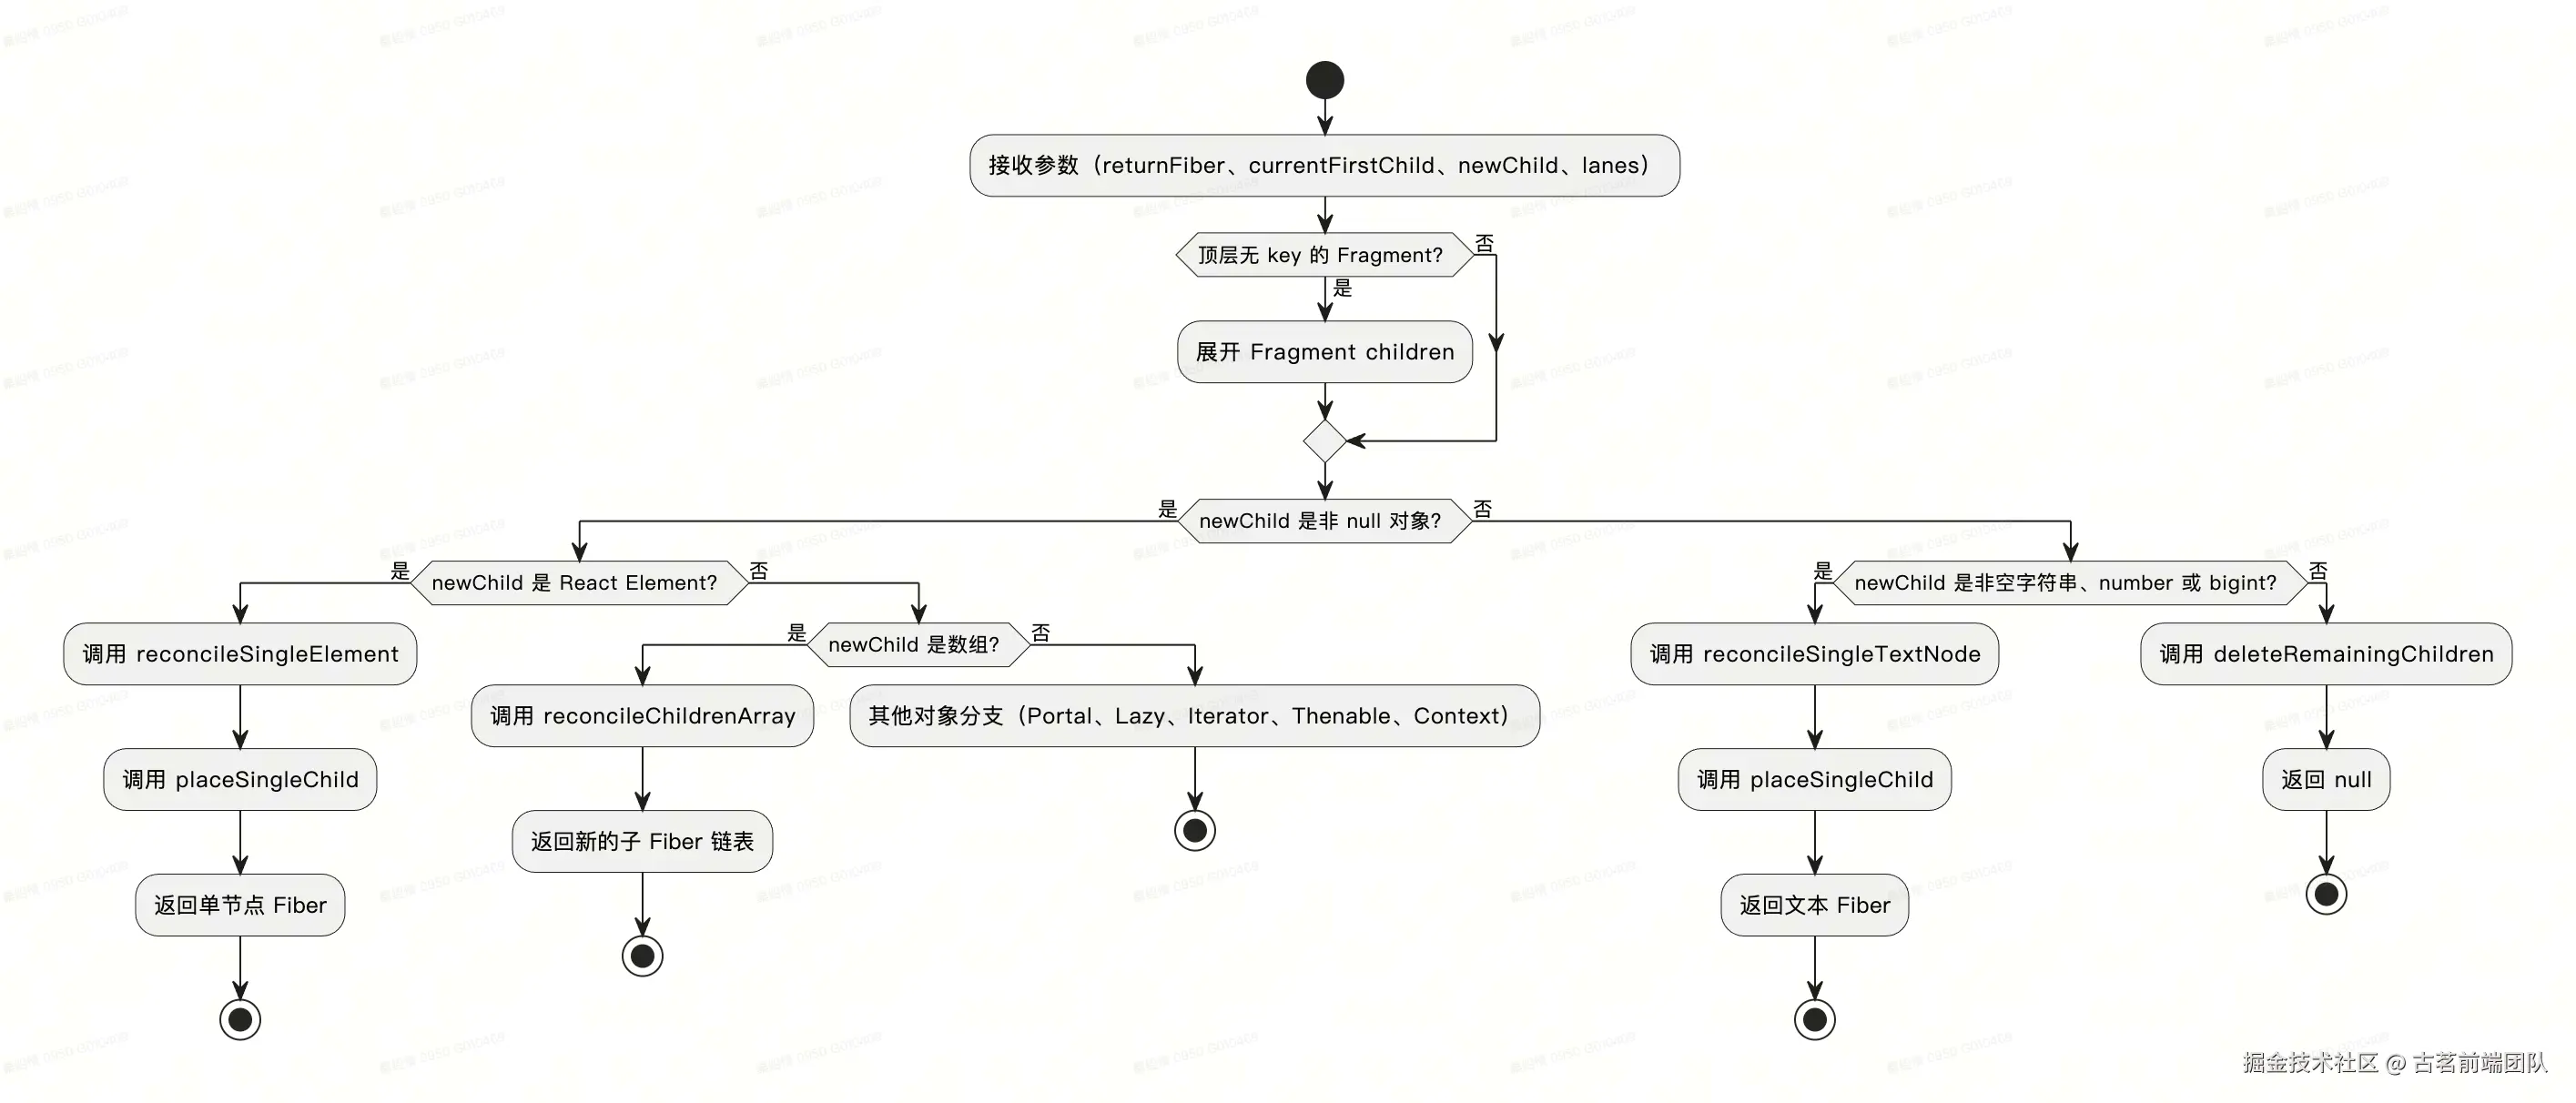
单节点对比
单节点 Diff 首先需要判断是否存在对应的旧 Fiber,然后判断旧 Fiber 对应的 DOM 节点是否可以复用。React 如何找到对应的旧 Fiber,以及如何判断节点能否复用,通过 reconcileSingleElement 函数的源码进行分析,梳理出流程如下:
这里的"单节点",指本次需要协调的新子节点是一个 ReactElement。上一次渲染留下的子节点仍然可能有多个,因此 React 需要沿着旧 Fiber 的兄弟链查找对应节点。
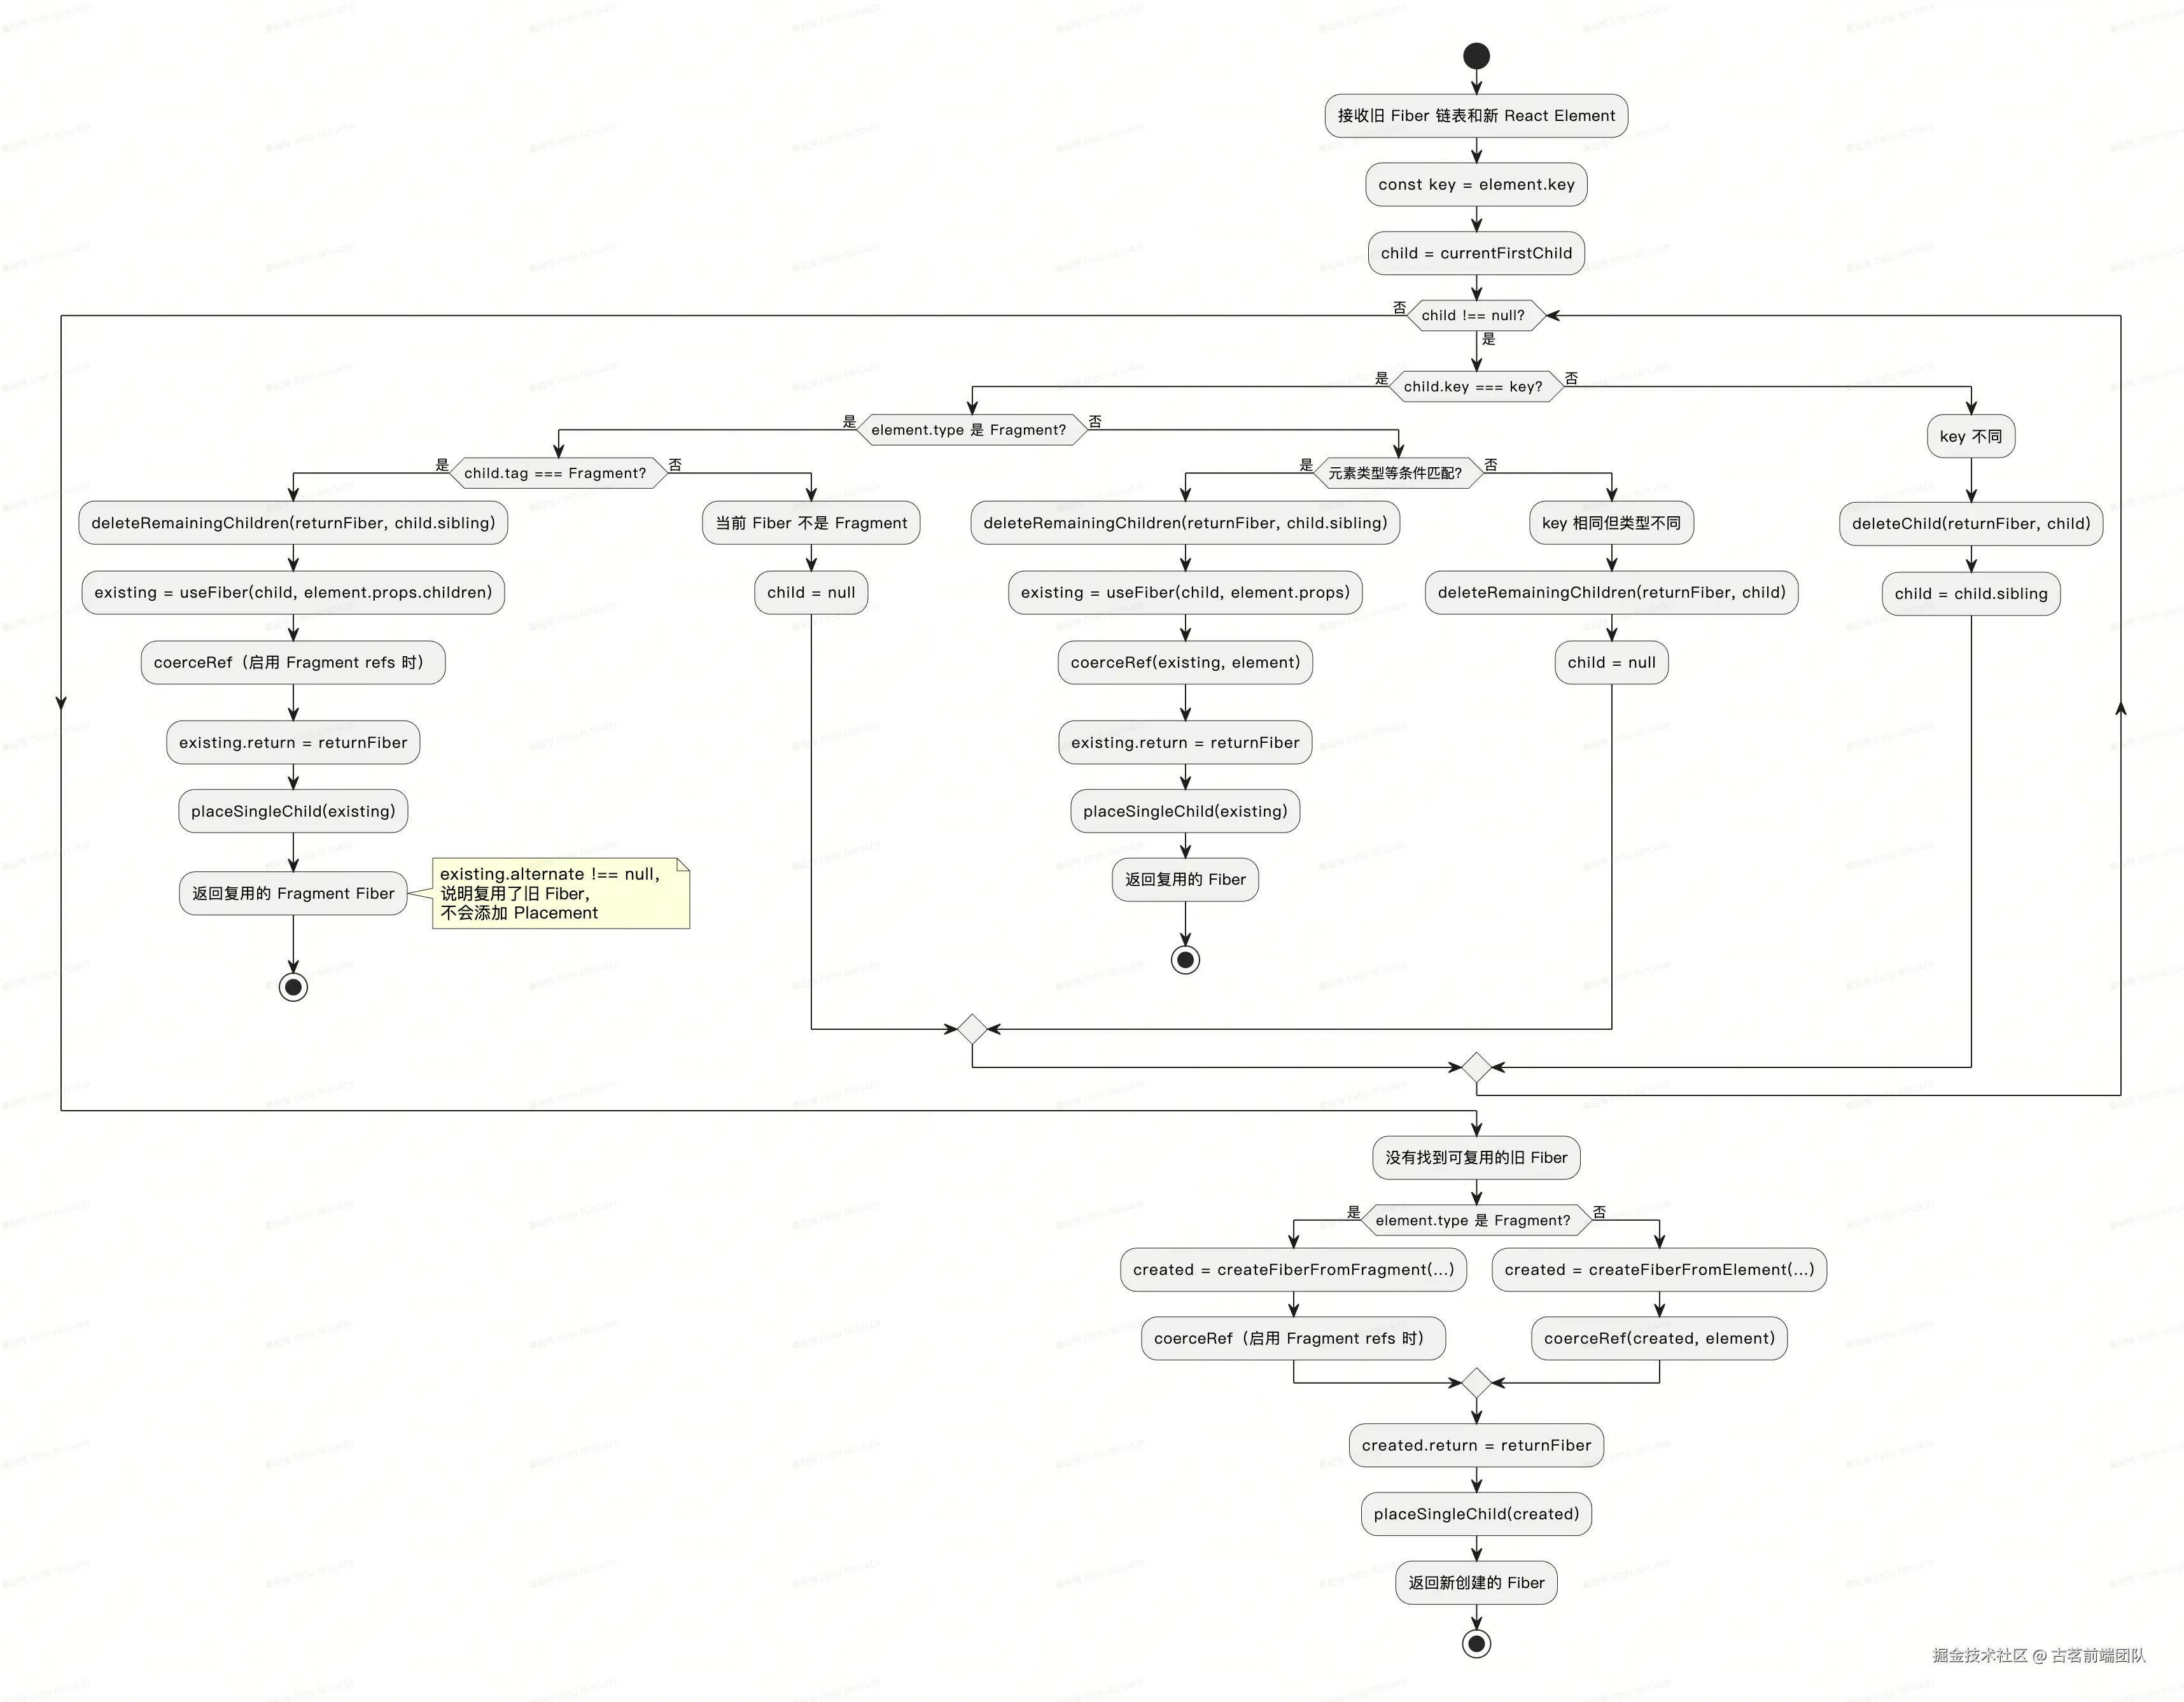
从中就可以知道,它会拿新 React Element 的 key 去旧的兄弟 Fiber 中查找:
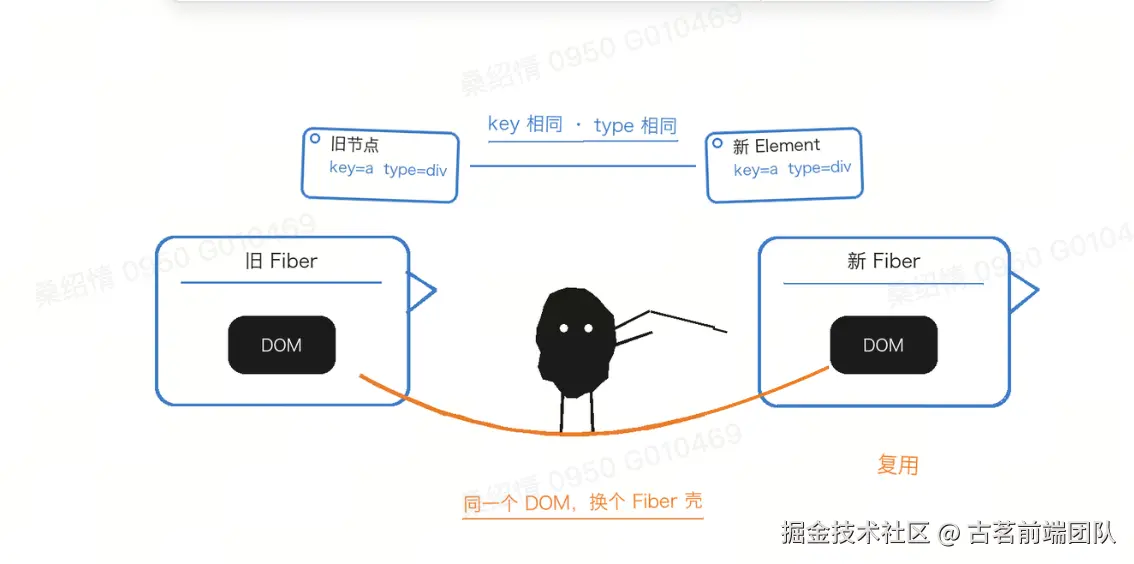
找到相同 key 后,再比较 type;
- key 和 type 都能对应上,就基于旧 Fiber 创建本次工作的 Fiber,保留可复用的节点和状态;
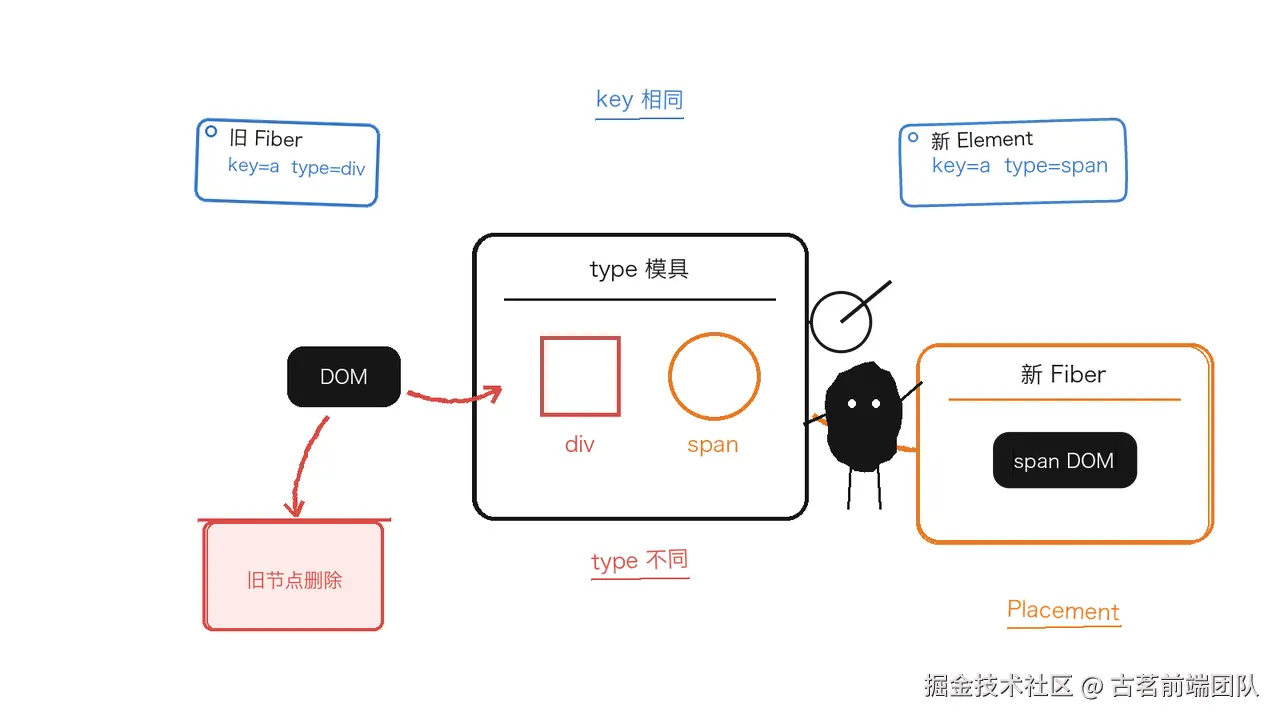
- key 相同但 type 不同,旧节点不能继续复用,需要删除旧结构并创建新结构;
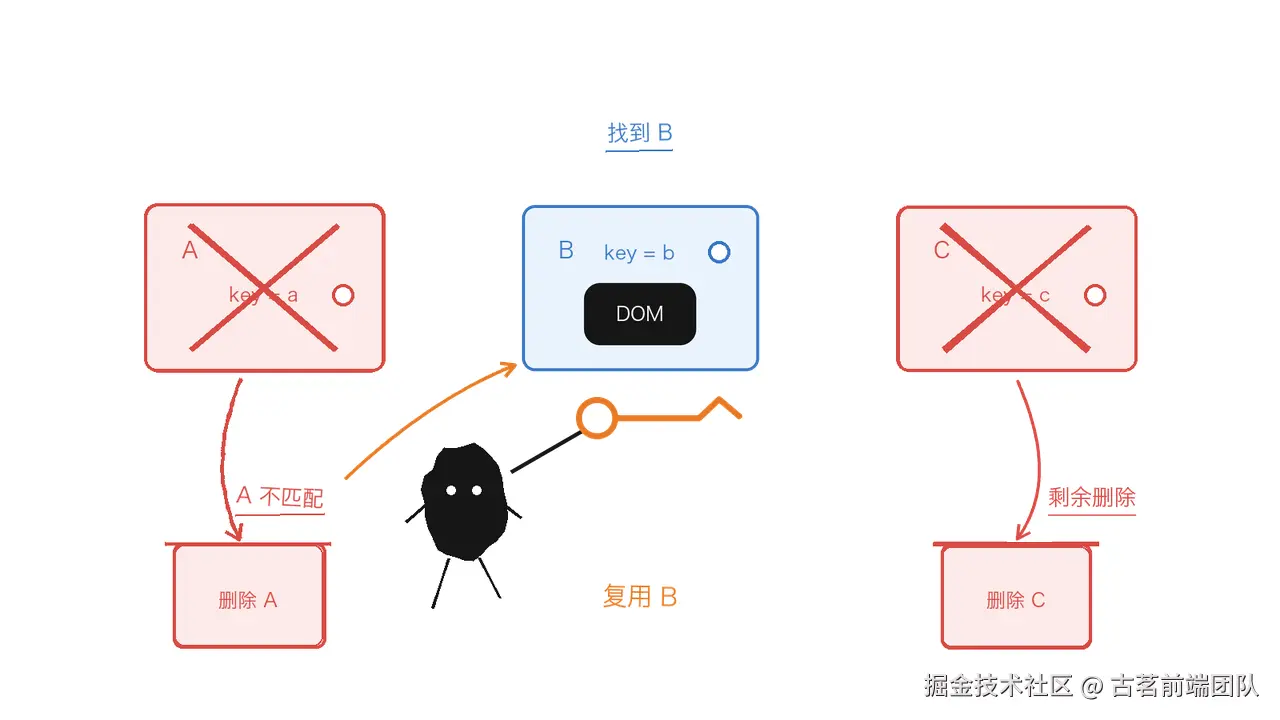
- 当前旧 Fiber 的 key 不匹配时,会继续查看后面的兄弟 Fiber,同时把已经确认不再需要的旧节点删除。
多节点对比
单个新节点的处理,主要是在旧节点中寻找一个可以延续的对象。当新子节点变成一整个列表时,React 就需要为列表中的每一项寻找对应关系,同时处理新增、删除和顺序变化。
多个子节点更新时,通常需要处理以下几种变化:
- 节点的属性或内容发生更新;
- 节点被新增或删除;
- 节点之间的相对位置发生变化。
一次更新可能只包含其中一种变化,也可能同时包含多种变化。
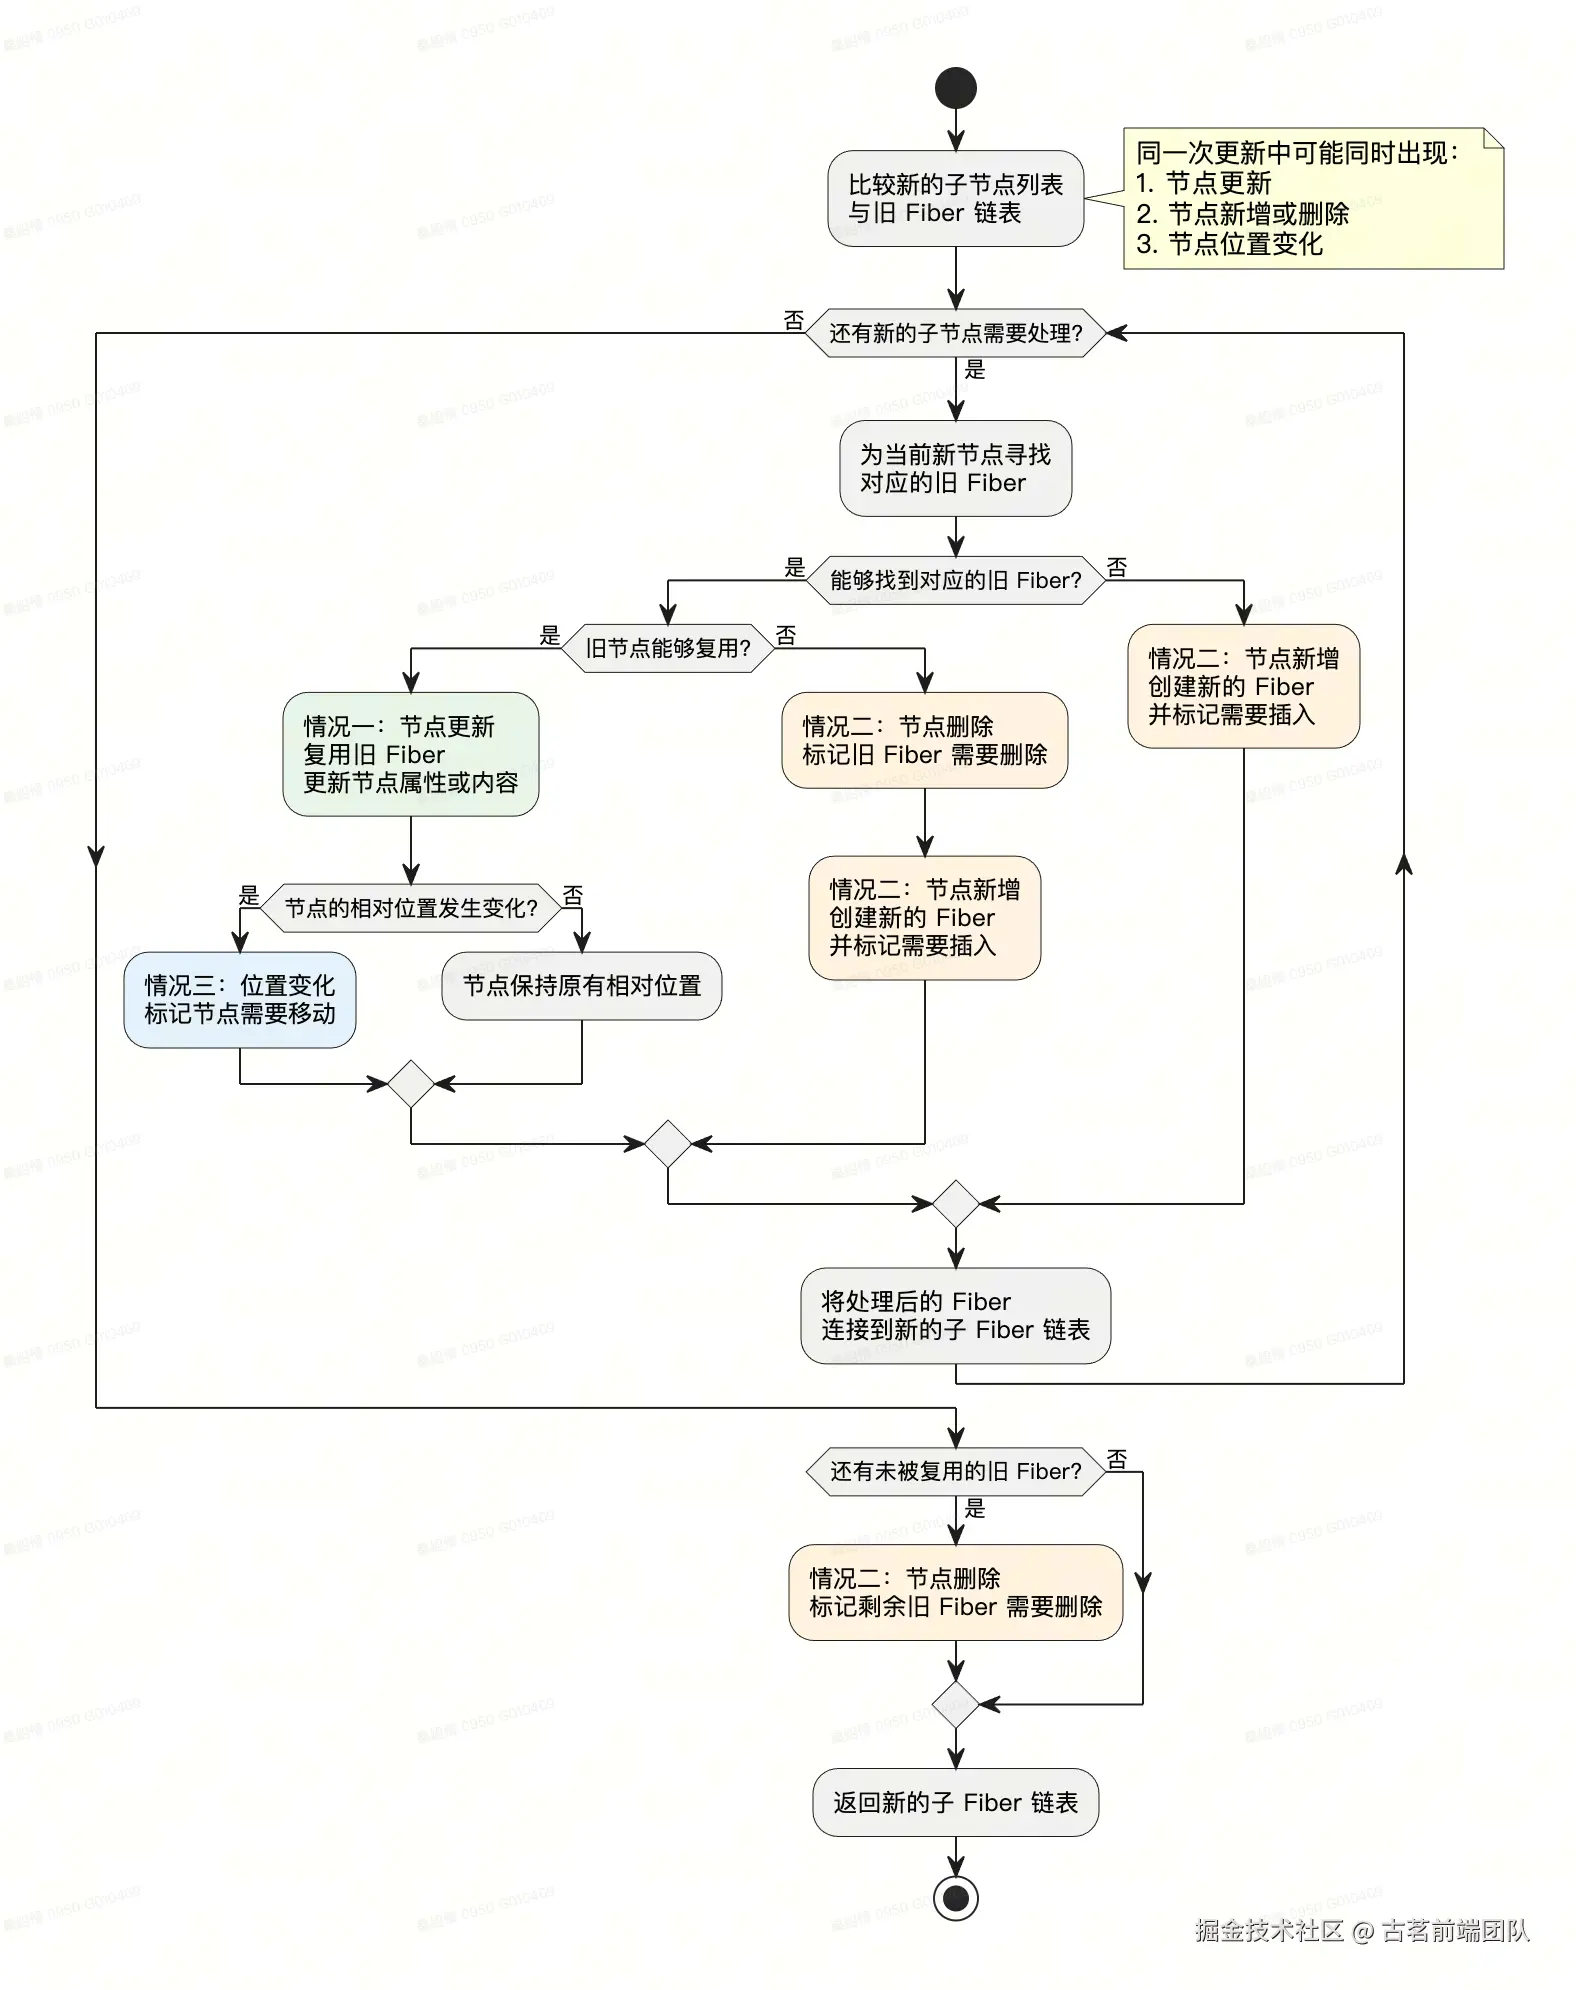
当新节点是数组时,React 可以通过索引访问新节点;旧子节点则通过 Fiber 的 sibling 指针连接成单向链表。由于 Fiber 没有方便的反向指针,React 的 reconcileChildrenArray 主要采用从左到右的顺序扫描。
整个的流程可以分成三个阶段:
- 从左到右顺序比较新旧节点;
- 判断新数组或旧 Fiber 链表是否已经遍历完;
- 如果双方都还有剩余节点,则使用 Map 查找可复用的旧 Fiber。
第一阶段:从左到右顺序比较
React 会同时遍历新节点数组和旧 Fiber 链表:
css
newChildren[0]  对比  currentFirstChild
newChildren[1]  对比  currentFirstChild.sibling
newChildren[2]  对比  下一个 sibling
这一阶段会调用 updateSlot,尝试让当前位置的新节点与旧 Fiber 匹配。
对于 React Element,updateSlot 首先比较 key。
- key 不相同
如果新旧节点的 key 不相同,说明当前位置无法直接匹配:
php
function updateSlot(
  returnFiber: Fiber,
  oldFiber: Fiber | null,
  newChild: any,
  lanes: Lanes,
): Fiber | null {
  const key = oldFiber !== null
    ? oldFiber.key
    : null;

  // 以下只展示 React Element 分支
  if (
    typeof newChild === 'object' &&
    newChild !== null &&
    newChild.$$typeof === REACT_ELEMENT_TYPE
  ) {
    if (newChild.key !== key) {
      return null;
    }

    return updateElement(
      returnFiber,
      oldFiber,
      newChild,
      lanes,
    );
  }

  // 文本、Portal、Lazy、数组、Iterator 等分支略过
  return null;
}
updateSlot 返回 null 后,当前的顺序扫描会停止。
这里要注意:
顺序扫描停止,只能说明当前位置无法继续匹配,并不代表剩余节点全部发生了移动。
- key 相同
如果 key 相同,React 会继续调用 updateElement 判断元素类型。
ini
function updateElement(
  returnFiber: Fiber,
  current: Fiber | null,
  element: ReactElement,
  lanes: Lanes,
): Fiber {
  const elementType = element.type;

  // Fragment 需要单独处理
  if (elementType === REACT_FRAGMENT_TYPE) {
    const updated = updateFragment(
      returnFiber,
      current,
      element.props.children,
      lanes,
      element.key,
    );

    if (enableFragmentRefs) {
      coerceRef(updated, element);
    }

    validateFragmentProps(
      element,
      updated,
      returnFiber,
    );

    return updated;
  }

  /*
   * current 不为空,说明存在旧 Fiber
   *
   * 类型匹配时,基于旧 Fiber 创建新的 workInProgress,
   * 从而保留组件状态和已有 DOM
   */
  if (
    current !== null &&
    (
      // 普通元素类型匹配
      current.elementType === elementType ||

      // 开发环境下支持 Hot Reload
      (__DEV__
        ? isCompatibleFamilyForHotReloading(
            current,
            element,
          )
        : false) ||

      // Lazy 组件比较解析后的实际类型
      (typeof elementType === 'object' &&
        elementType !== null &&
        elementType.$$typeof === REACT_LAZY_TYPE &&
        resolveLazy(elementType) === current.type)
    )
  ) {
    const existing = useFiber(
      current,
      element.props,
    );

    // 更新 ref 和父 Fiber 关系
    coerceRef(existing, element);
    existing.return = returnFiber;

    // 复用旧 Fiber
    return existing;
  }

  /*
   * 没有旧 Fiber,或者元素类型不匹配
   * 此时创建新的 Fiber
   */
  const created = createFiberFromElement(
    element,
    returnFiber.mode,
    lanes,
  );

  coerceRef(created, element);
  created.return = returnFiber;

  return created;
}
在 reconcileChildrenArray 中,如果 key 相同但类型不同,updateElement 会返回一个新的 Fiber。由于新 Fiber 的 alternate 为空,React 会将当前位置的旧 Fiber 标记为删除,然后继续扫描后面的节点:
ini
if (
  shouldTrackSideEffects &&
  oldFiber !== null &&
  newFiber.alternate === null
) {
  deleteChild(returnFiber, oldFiber);
}
整体概括为:
- key 相同、type 相同:复用旧 Fiber;
- key 相同、type 不同:不能复用旧 Fiber,创建新的 Fiber,并标记旧 Fiber 删除。
因此,类型不同会替换当前节点,但不会必然终止整个顺序扫描。
第二阶段:判断哪一边先遍历完
顺序扫描结束后,React 会根据新数组和旧 Fiber 链表的遍历情况进入不同分支。
- 新数组已经遍历完
如果:
ini
newIdx === newChildren.length说明新节点已经全部处理完,但旧 Fiber 链表仍有剩余节点。这些旧节点在新列表中已经不存在,需要删除:
ini
if (newIdx === newChildren.length) {
  deleteRemainingChildren(
    returnFiber,
    oldFiber,
  );

  return resultingFirstChild;
}- 旧 Fiber 已经遍历完
如果:
ini
oldFiber === null说明后面的新节点都没有旧 Fiber 可以复用,因此会依次创建:
ini
if (oldFiber === null) {
  for (; newIdx < newChildren.length; newIdx++) {
    const newFiber = createChild(
      returnFiber,
      newChildren[newIdx],
      lanes,
    );

    if (newFiber === null) {
      continue;
    }

    lastPlacedIndex = placeChild(
      newFiber,
      lastPlacedIndex,
      newIdx,
    );

    // 连接到新的 Fiber 链表
  }

  return resultingFirstChild;
}
这些新创建的 Fiber 会被 placeChild 标记为需要插入。
- 新旧两边都有剩余节点
如果新数组和旧 Fiber 链表都还有未处理节点,说明仅靠当前位置已经无法继续匹配。React 会把剩余旧 Fiber 放入 Map,进入下一阶段。
第三阶段:使用 Map 查找旧 Fiber
React 首先调用 mapRemainingChildren,把剩余旧 Fiber 放入 Map中:
typescript
function mapRemainingChildren(
  currentFirstChild: Fiber,
): Map<string | number, Fiber> {
  const existingChildren = new Map<
    string | number,
    Fiber
  >();

  let existingChild = currentFirstChild;

  while (existingChild !== null) {
    const mapKey =
      existingChild.key !== null
        ? existingChild.key
        : existingChild.index;

    existingChildren.set(
      mapKey,
      existingChild,
    );

    existingChild = existingChild.sibling;
  }

  return existingChildren;
}
存储规则可以简化为:
存在显式 key → 使用 key 作为 Map 的 key 没有显式 key → 使用旧 Fiber 的 index
接下来,React 遍历剩余的新节点,并调用 updateFromMap去查找是否匹配:
typescript
function updateFromMap(
  existingChildren: Map<string | number, Fiber>,
  returnFiber: Fiber,
  newIdx: number,
  newChild: any,
  lanes: Lanes,
): Fiber | null {
  if (
    typeof newChild === 'object' &&
    newChild !== null &&
    newChild.$$typeof === REACT_ELEMENT_TYPE
  ) {
    const mapKey =
      newChild.key === null
        ? newIdx
        : newChild.key;

    const matchedFiber =
      existingChildren.get(mapKey) || null;

    return updateElement(
      returnFiber,
      matchedFiber,
      newChild,
      lanes,
    );
  }

  return null;
}
新节点的查找规则是:
新节点有显式 key → 使用 key 查找
新节点没有 key → 使用 newIdx 查找
找到旧 Fiber 后,React 还会继续比较类型:
- key 和类型都匹配:复用旧 Fiber;
- key 相同但类型不同:创建新 Fiber;
- 没有找到对应 key:创建新 Fiber。
如果旧 Fiber 被成功复用,React 会将它从 Map 中删除:
ini
if (
  shouldTrackSideEffects &&
  newFiber.alternate !== null
) {
  existingChildren.delete(
    newFiber.key === null
      ? newIdx
      : newFiber.key,
  );
}
所有新节点处理完后,Map 中剩余的旧 Fiber 就是没有被复用的节点,需要统一删除。
补充
每得到一个新的 Fiber 后,React 会调用 placeChild 判断节点是否需要插入或移动,再通过 sibling 将它连接到新的 Fiber 链表。对于需要执行的插入和移动,React 都会添加 Placement 标记。
要区分这两种情况,首先需要判断:本次工作的 Fiber,是否有可以复用的旧 Fiber? 这里就需要用到 alternate。更新时,React 会为可以复用的旧 Fiber 准备本次工作的 Fiber,两者通过 alternate 相互关联。因此,可以通过 newFiber.alternate 找到它对应的旧 Fiber。如果没有可复用的旧 Fiber,而是直接创建一个新的 Fiber,它的 alternate 就是 null。
在需要追踪变更的列表更新中,可以据此分成两种情况:
alternate === null:本轮新建的节点,需要添加Placement标记,安排插入。这里也包括旧节点无法复用、需要重新创建的情况。alternate !== null:存在对应的旧 Fiber,可以继续复用,但还需要判断是否应该移动。
因此,新增的判断比较直接,接下来主要关注第二种情况:
节点虽然可以复用,但它在新列表中的相对顺序可能已经发生变化。
React如何判断它是否需要改变位置呢,这部分主要由 placeChild 完成。
ini
function placeChild(
  newFiber: Fiber,
  lastPlacedIndex: number,
  newIndex: number,
): number {
  newFiber.index = newIndex;

  if (!shouldTrackSideEffects) {
    // 会记录 Forked 信息
    newFiber.flags |= Forked;
    return lastPlacedIndex;
  }

  const current = newFiber.alternate;

  if (current !== null) {
    const oldIndex = current.index;

    if (oldIndex < lastPlacedIndex) {
      // 已存在的节点发生移动
      newFiber.flags |= Placement;
      return lastPlacedIndex;
    }

    // 节点可以保持原来的相对顺序
    return oldIndex;
  }

  // 没有旧 Fiber,说明是新增节点
  newFiber.flags |= Placement | PlacementDEV;
  return lastPlacedIndex;
}
其中有两个重要的值:
oldIndex:当前复用节点在旧列表中的位置;
lastPlacedIndex:目前已经确认不需要移动的节点中,最大的旧位置。
判断规则可以概括为:
- oldIndex < lastPlacedIndex
说明当前节点的旧位置落在已经确认顺序的节点之前,无法继续保持原有相对顺序,需要移动:
oldIndex < lastPlacedIndex → 标记 Placement
- oldIndex >= lastPlacedIndex
说明当前节点仍然保持递增的相对顺序,不需要移动:
oldIndex >= lastPlacedIndex → 不标记 Placement → lastPlacedIndex = oldIndex
通过例子理解多节点对比
假设列表发生了下面的变化:
旧列表:A B C D 新列表:A C D B
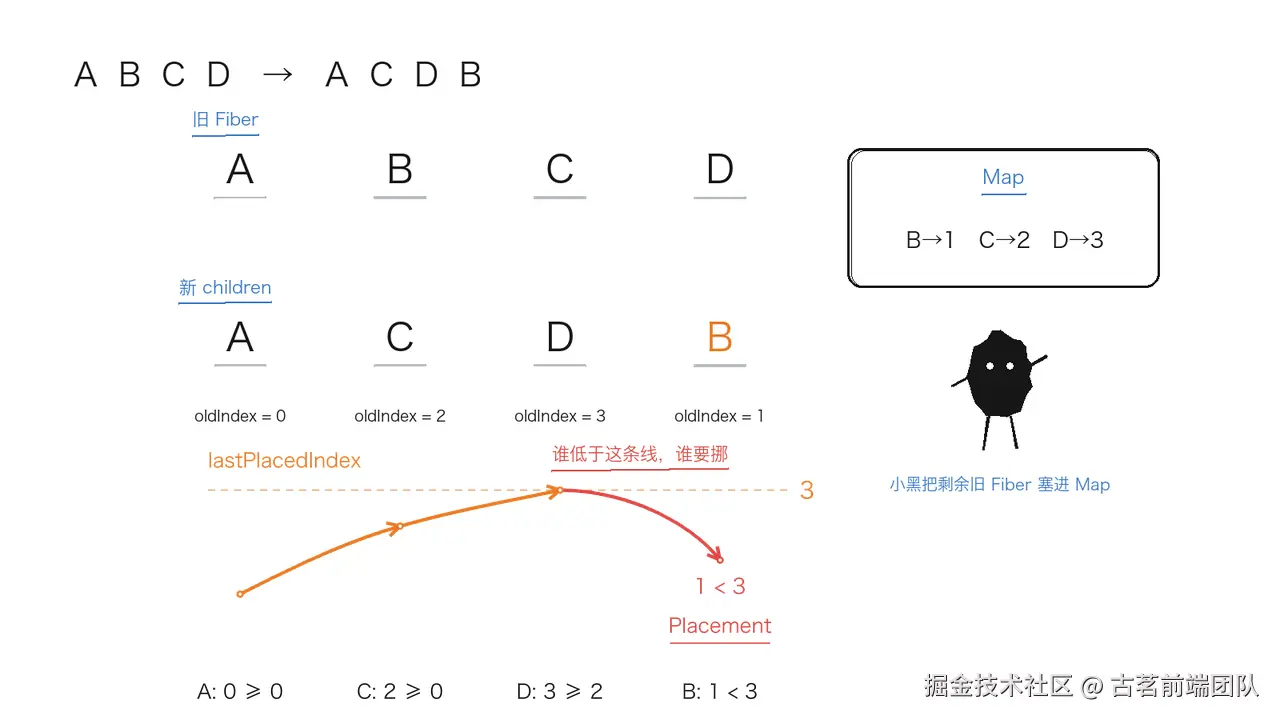
首先处理 A:
A 的 oldIndex = 0 lastPlacedIndex = 0 0 >= 0 A 不需要移动
接下来,新列表中的 C 与旧列表当前位置的 B 无法按照 key 匹配,快速顺序扫描停止。剩余的旧 Fiber B、C、D 会被放入 Map。
从 Map 中找到 C:
C 的 oldIndex = 2 lastPlacedIndex = 0 2 >= 0 C 不需要移动 lastPlacedIndex 更新为 2
然后找到 D:
D 的 oldIndex = 3 lastPlacedIndex = 2 3 >= 2 D 不需要移动 lastPlacedIndex 更新为 3
最后找到 B:
B 的 oldIndex = 1 lastPlacedIndex = 3 1 < 3 B 需要移动 标记 Placement
最终,A、C、D 都不需要移动,B 被标记为需要放置到新的位置。
lastPlacedIndex 的判断方式关注的是:当前节点能否继续保持旧位置递增的相对顺序。它并不保证每一次都得到理论上的最少移动次数。
例如:
旧列表:A B C D 新列表:D A B C
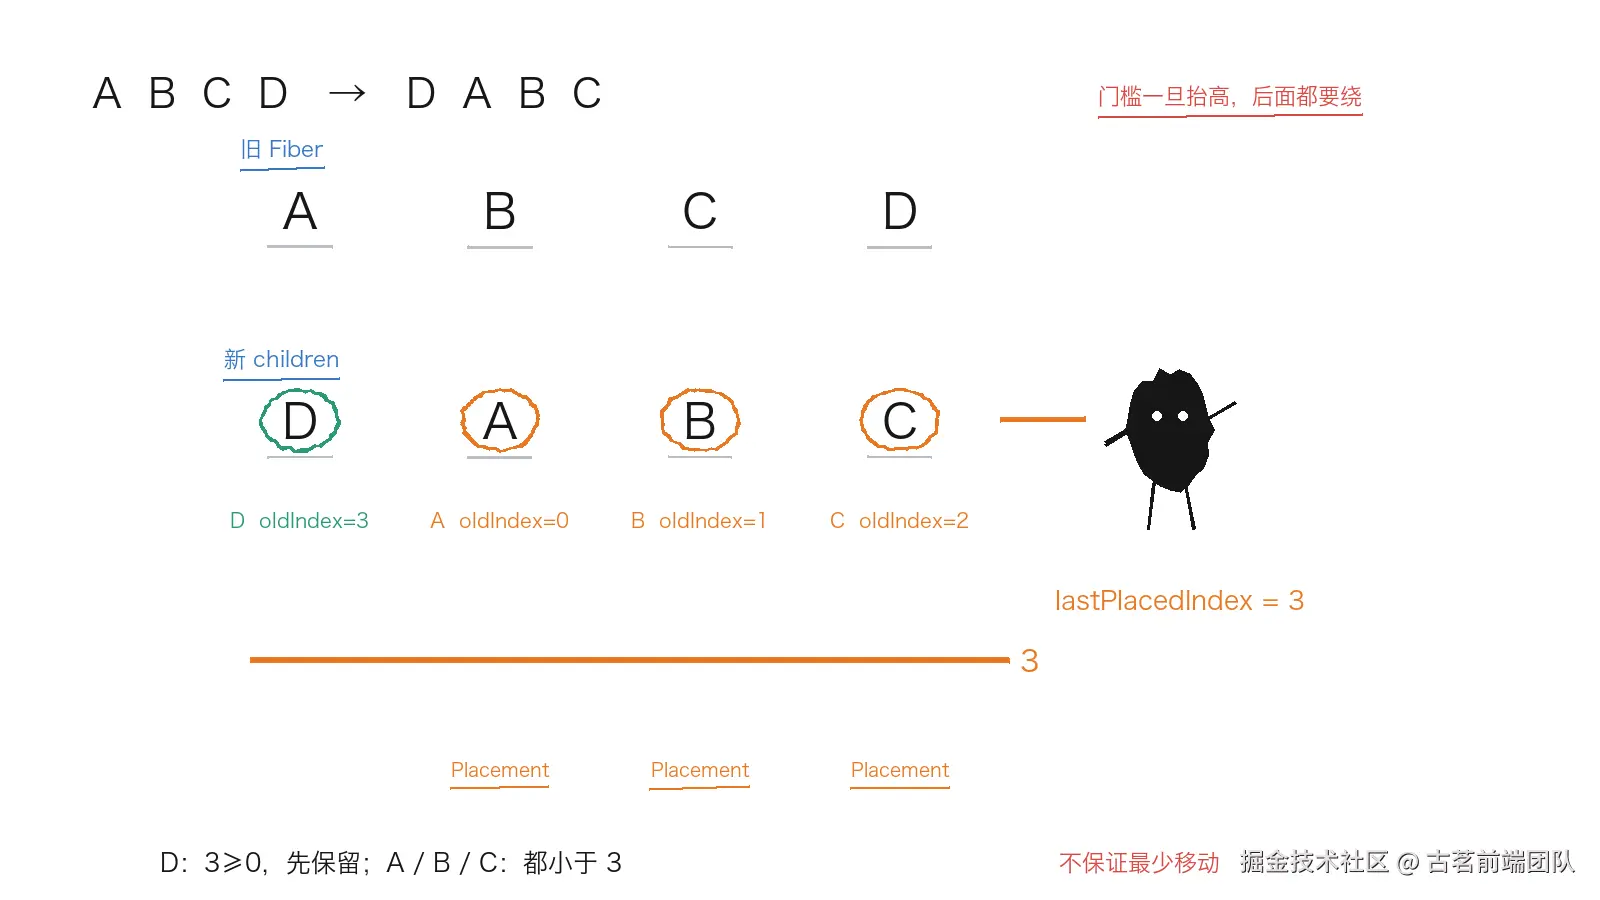
D 首先被匹配到,它的 oldIndex 是 3,因此 lastPlacedIndex 会更新为 3。
随后:
A:oldIndex = 0,小于 3,标记 Placement B:oldIndex = 1,小于 3,标记 Placement C:oldIndex = 2,小于 3,标记 Placement
从直觉上看,只移动 D 似乎更简单,但按照当前的前向扫描规则,React 会把 A、B、C 标记为需要移动。
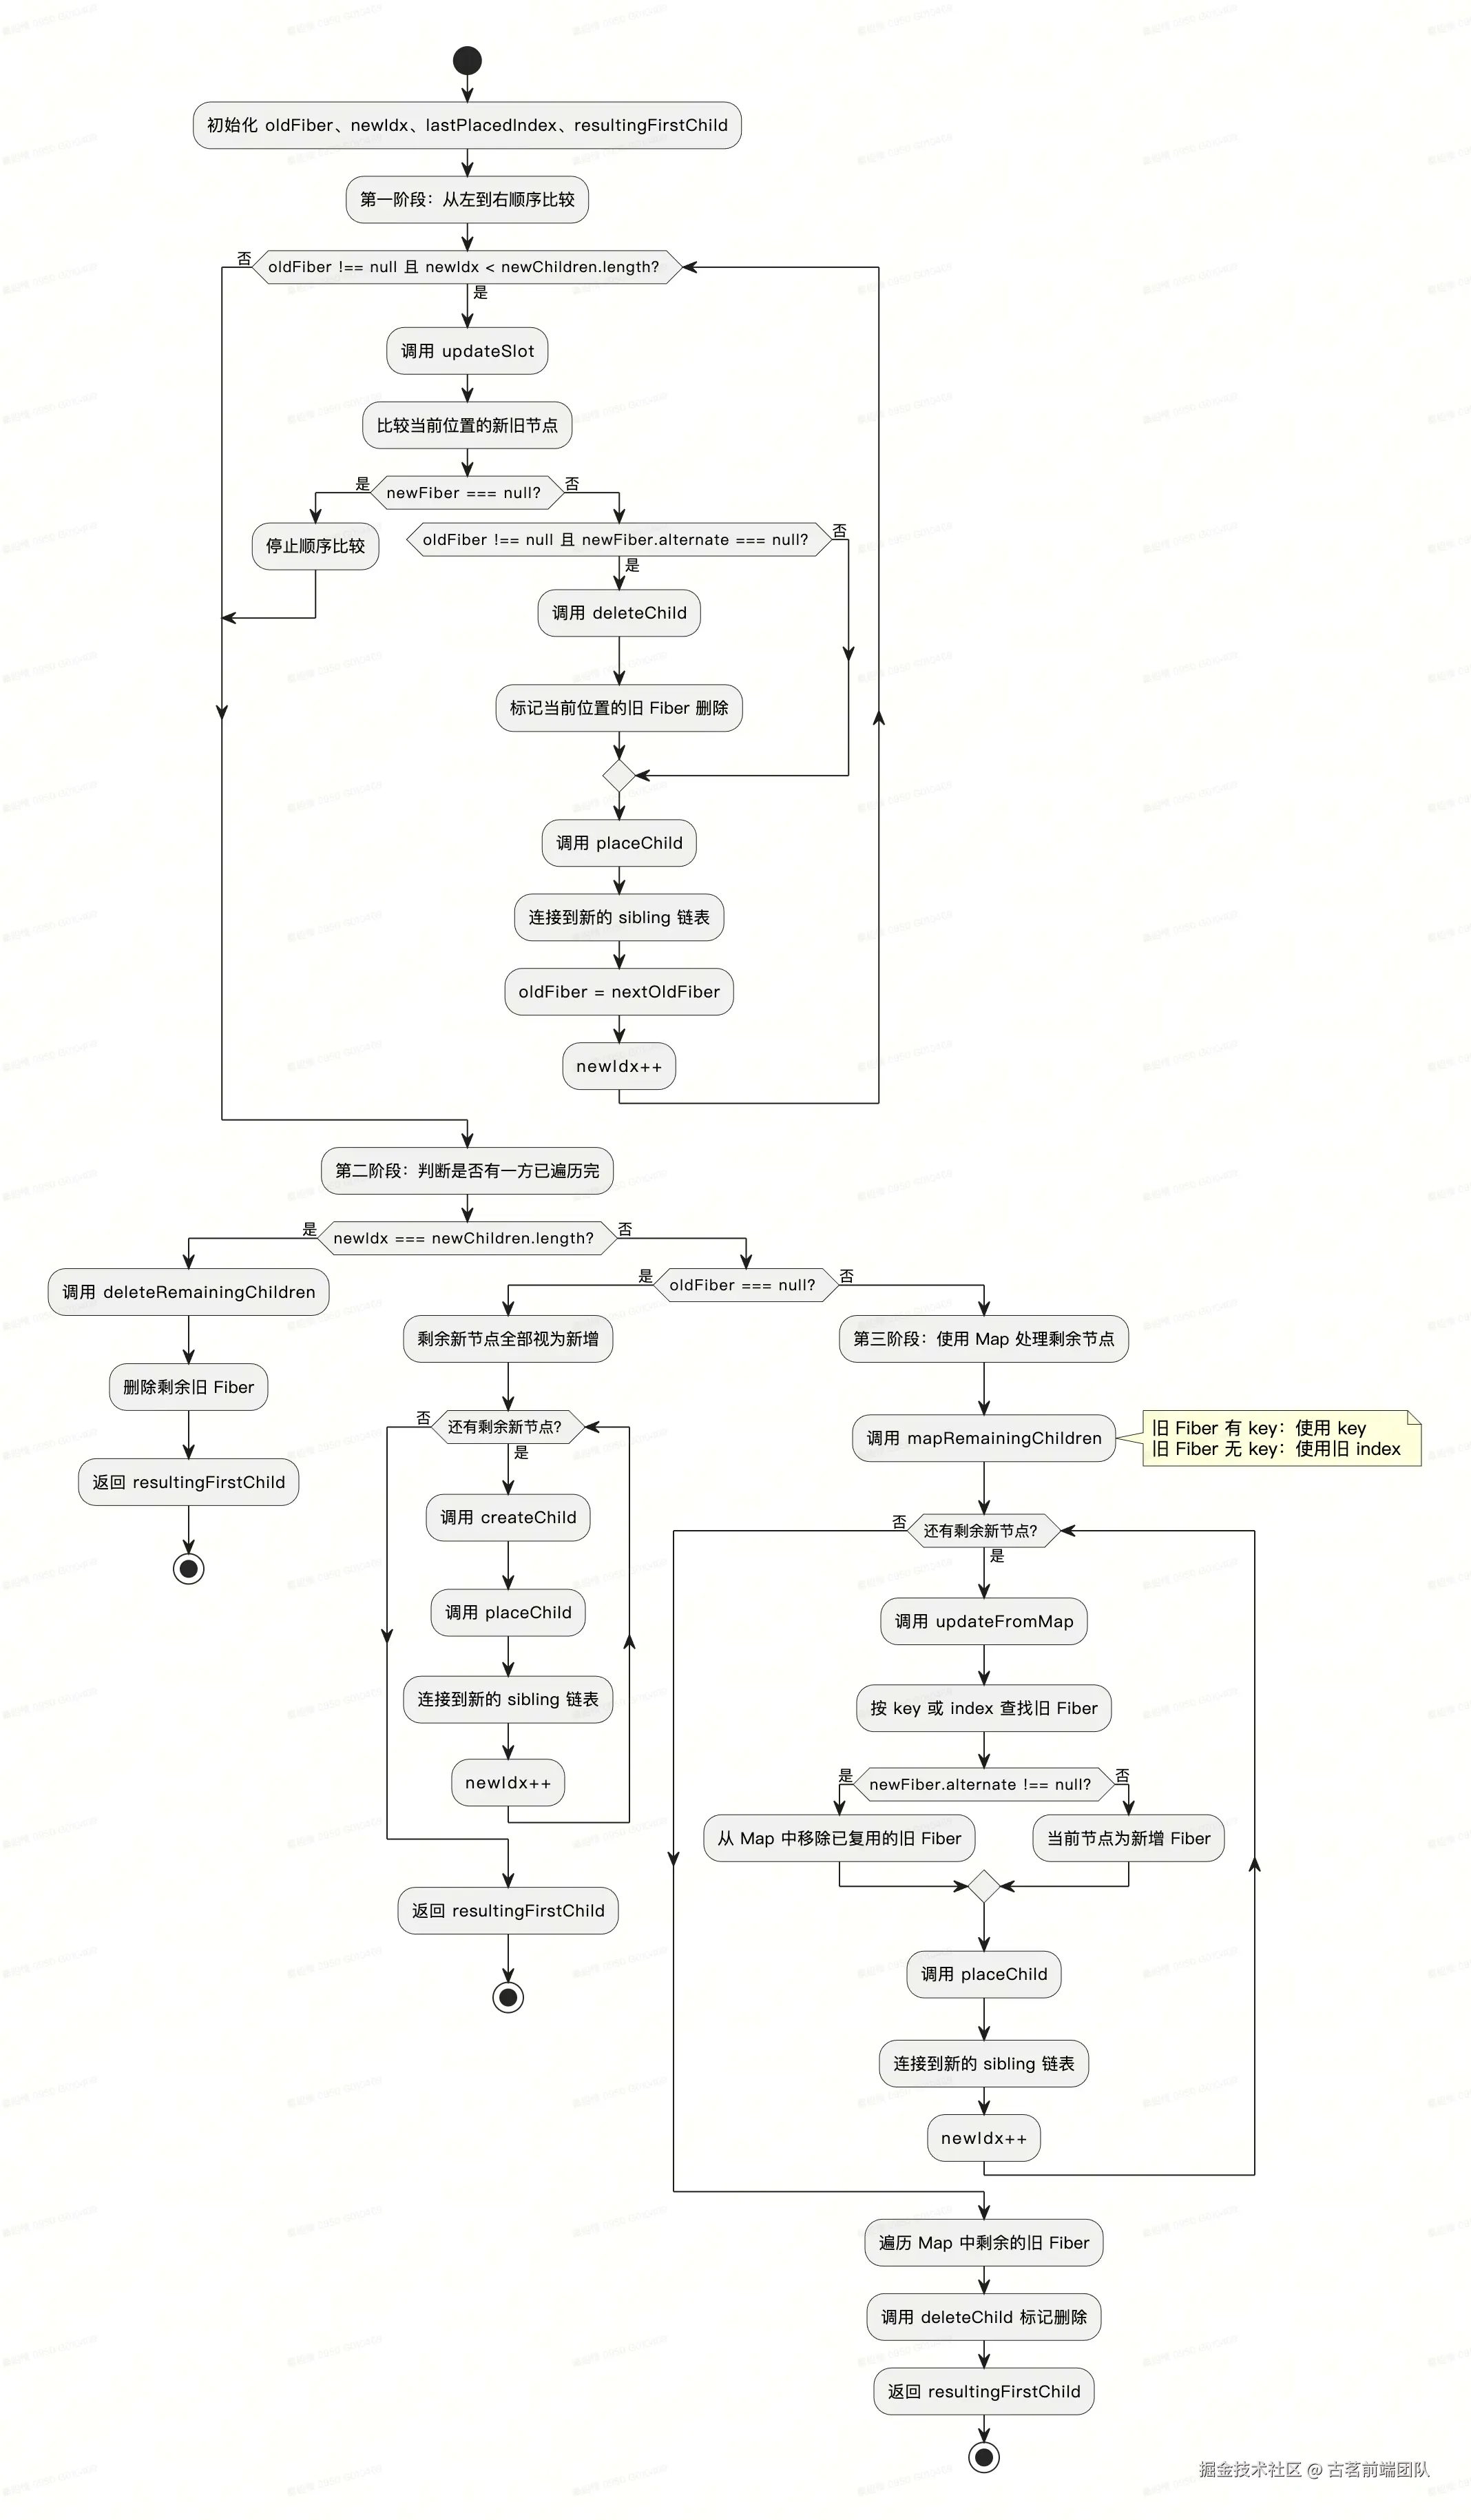
多节点 Diff 总结
回过头看,reconcileChildrenArray 的整体流程可以概括为:
使用 key
看完匹配过程,再回头看 key 的使用要求,就容易理解了。React 需要根据 key 找到对应的旧节点,因此一个合格的 key 应满足两个条件:
- 同级唯一:同一个列表中的兄弟节点不能重复;
- 跨渲染稳定:同一条数据重新渲染、排序或移动后,
key不能变化。
优先使用后端提供的业务 ID
如果后端返回的 ID 在当前列表中唯一,并且同一条记录的 ID 不会随重新渲染、排序或移动而变化,直接使用它即可:
xml
<UserItem key={user.id} user={user} />这里要求的是同级节点之间唯一,不需要整个应用中的所有 key 都不重复。
ID 只在特定业务范围内唯一时,可以使用组合键
有些 ID 只在某个租户、分组或数据源内部唯一。当不同范围的数据出现在同一个列表中时,就可能发生重复。例如:
bash
const users = [
  { tenantId: 'A', id: 1, name: 'Tom' },
  { tenantId: 'B', id: 1, name: 'Jerry' },
];
这两条记录的 id 相同,但所属租户不同,因此可以将 tenantId 和 id 组合起来,作为完整的身份标识:
ini
{users.map(user => (
  <UserItem
    key={`${user.tenantId}:${user.id}`}
    user={user}
  />
))}
同样的思路也适用于订单与明细、商品与规格等场景:
ini
key={`${orderId}:${lineId}`}
key={`${productId}:${variantId}`}
组合字段需要共同标识一条业务记录,并在这条记录身份不变时保持稳定。如果同一业务范围内本应唯一的 ID 仍然重复,则应先确认是否存在重复数据,或者寻找其他能够稳定区分记录的字段。
什么时候可以使用 index?
数组下标表示的是位置。使用 index 作为 key,相当于让 React 根据位置识别节点。当列表插入、删除或排序后,同一个位置可能已经换成另一条数据,但这个位置对应的 key 没有变化。类型匹配时,React 就可能继续复用原来的组件,使它的输入内容或内部状态留给另一条数据。因此,会发生增删或重排的列表,应优先使用稳定的业务标识。
对于内容和顺序固定的静态列表,可以考虑使用 index。判断的关键是:同一条数据与它所在位置的对应关系,是否会在更新中发生变化。 列表项包含输入框、动画或组件状态时,位置变化造成的错配往往更容易被用户感知。
总结
从 JSX 到 ReactElement,再到 Fiber,key 始终参与着节点身份的识别。更新列表时,React 利用它建立新旧节点之间的对应关系,再结合类型和位置决定后续处理。选择 key 时,最重要的是让同一条业务数据在多次渲染中保持稳定的身份。