你在 DeepSeek 里问:"为什么大海看起来是蓝色的?"
页面上,回复会一段一段出现,而不是等整句话都写完后一起显示。假设模型给出这样一句回答:
海水会吸收较多红光,蓝光更容易被散射回来,所以大海常呈蓝色。
这句回答可以用来理解三个问题:文字怎样变成模型能处理的内容,模型怎样利用前面的文字,后面的内容又怎样逐步产生。
一、模型不是一次确定整句话,而是逐个生成 Token
这句话本身是构造的示例,但下面的切分是用 DeepSeek-V4-Pro-Base 官方 Tokenizer 对这串文字实际运行的结果:
text
海水 | 会 | 吸收 | 较多
红光 | , | 蓝 | 光
更容易 | 被 | 散射 | 回来
, | 所以 | 大海 | 常
呈 | 蓝色 | 。
一共是 19 个 token。
这里很容易产生一个误解:四个汉字就是四个 token,或者一个词语就是一个 token。实际都不是。例如,在这套 Tokenizer 中:
较多红光会切成较多、红光,是 2 个 token;较多蓝光会切成较多、蓝、光,是 3 个 token。
所以,token 是模型处理文本的单位,但它不等于一个汉字,也不等于我们日常说的一个词。
模型每一步会从候选 token 中选出一个。为了方便观察,图 1 每一步只画三个候选;候选分数和选择规则在第四节继续解释。
图 1:每一步从三个候选中选出一个 token,再加入回复。选中序列和 ID 来自官方 Tokenizer;候选只用于展示选择动作,不是模型实测概率。
模型生成时会先得到"海水",把它放进当前内容;再得到"会",放在"海水"后面;然后继续"吸收""较多""红光",直到最后的句号。
这种"根据已经有的内容,生成下一个 token;再把它加入已有内容,继续生成"的方式,叫自回归生成。
二、文字怎样变成模型能计算的数字
计算机不能直接拿"海水"两个字去做模型里的数值计算。文字需要经过下面几步转换。
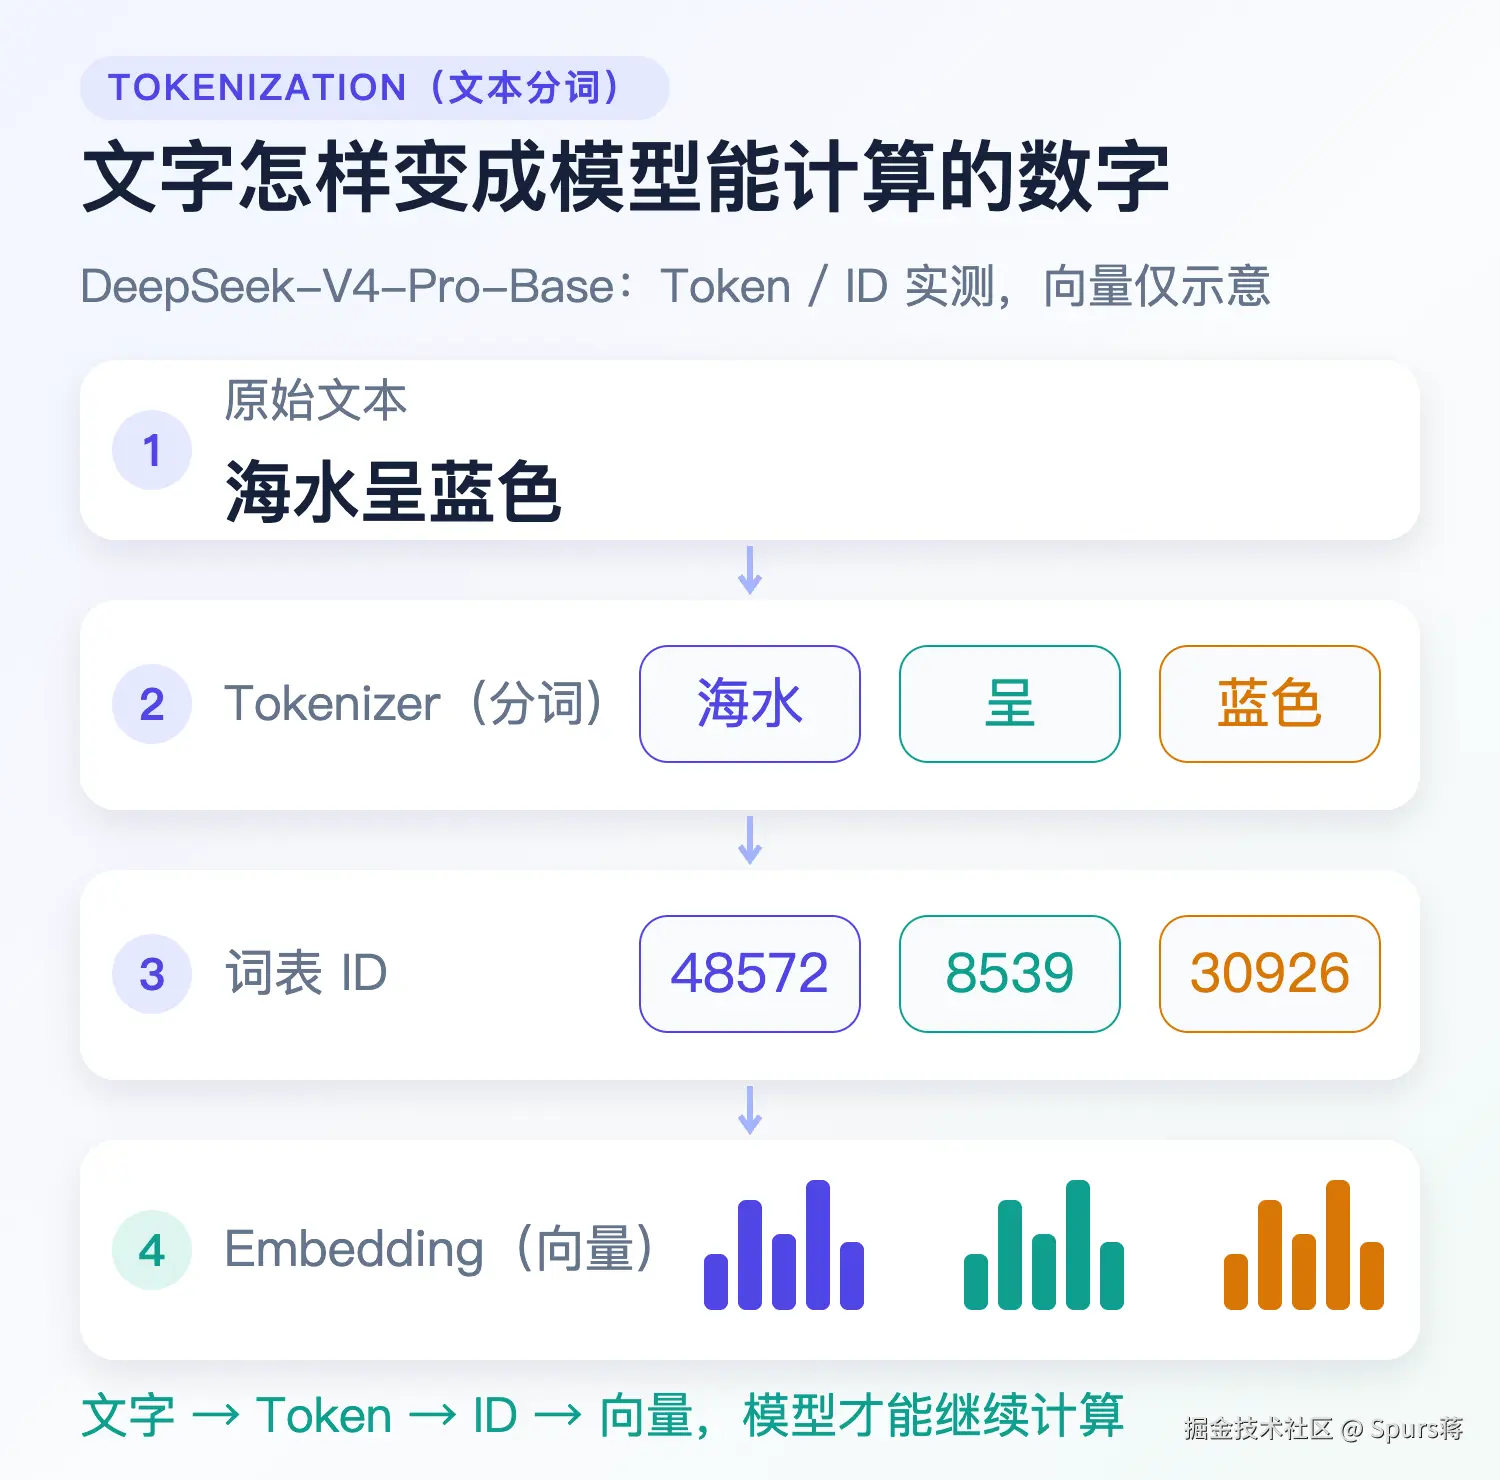
图 2:token 和 ID 来自官方 Tokenizer 实测;向量柱形只表示"一组数值",不是实际向量值。
1. Tokenizer:确定怎样切分文本
**Tokenizer(分词器)**按照模型的规则,把文本切成 token。
图中的"海水呈蓝色"被切成 3 个 token:
text
海水 | 呈 | 蓝色换一套模型,切分结果可能不同。因此,估算一段文本有多少 token 时,不能只看字数,应该使用对应模型的 Tokenizer。
2. 词表:给每个 token 一个整数 ID
词表可以理解为一张"token---整数"对照表。经过查表,上面的 3 个 token 变成:
| Token | ID |
|---|---|
| 海水 | 48572 |
| 呈 | 8539 |
| 蓝色 | 30926 |
这些数字只是编号。30926 并不比 8539 含义更丰富,两个编号之间的大小也没有语义。
3. Embedding:把 ID 换成一组数值
接下来,Embedding 层根据 ID 取出对应的向量。向量就是按固定顺序排列的一组数字。数字的个数由模型设计决定,可以是几千个,本文不需要展开具体维度。
模型后面的计算都围绕这些数值展开。训练过程会调整它们,让模型能够利用文本中的规律。不同的数值组合可以承载训练中学到的特征,但不能把某一维直接读成"海水"或"颜色",它们也不是人工为每个词填写的"动作值"或"重要程度"。
到这里,文字已经变成模型可以计算的数值表示。
三、Transformer 怎样利用已经出现的文字
看这句话:
海水吸收了红光,所以它看起来是蓝色的。
"它"指什么?你联系前面的"海水",很快就能回答。模型要让"它"这个位置带上"海水"的信息,也需要一种读取前文的方法。
Transformer 是模型处理这些数值表示的一组计算方法,其中的 **Attention(注意力)**负责建立不同位置之间的联系。
图 3:注意力让当前位置能够利用相关历史位置的信息。
1. Q、K、V 分别做什么
在计算"它"这个位置时,会用到三类信息:
| 名称 | 在这句话里的作用 |
|---|---|
| Q(Query,查询) | 表示"它"这个位置需要寻找什么信息 |
| K(Key,键) | 表示"海水""红光"等位置各有什么特征,供当前位置匹配 |
| V(Value,值) | 表示匹配之后,那些位置实际传递给当前位置的内容 |
可以先记住一句话:Q 用来查找,K 用来匹配,V 提供读到的内容。
真实模型会同时处理许多 token,也会同时学习多种关系。图中只看"它"和"海水",是为了把基本作用说清楚。
2. 生成到这里时,哪些内容可以看见
假设模型刚生成到"蓝":
text
已经存在:
海水 | 会 | 吸收 | 较多
红光 | , | 蓝

尚未生成:
光 | 更容易 | 被
散射 | 回来 | ......
计算"蓝"后面的内容时,模型只能使用"已经存在"的部分,不能使用"尚未生成"的部分。否则,生成过程就提前用到了答案。
计算时会用一张标记表规定每个位置能读取哪些历史位置,这张表叫因果掩码(causal mask)。"掩码"就是允许或禁止读取的标记;"因果"在这里表示后续内容只能根据前面的内容产生。
这个名字不需要先背下来。先记住它的作用:生成某个位置时,只能看已经出现的内容。
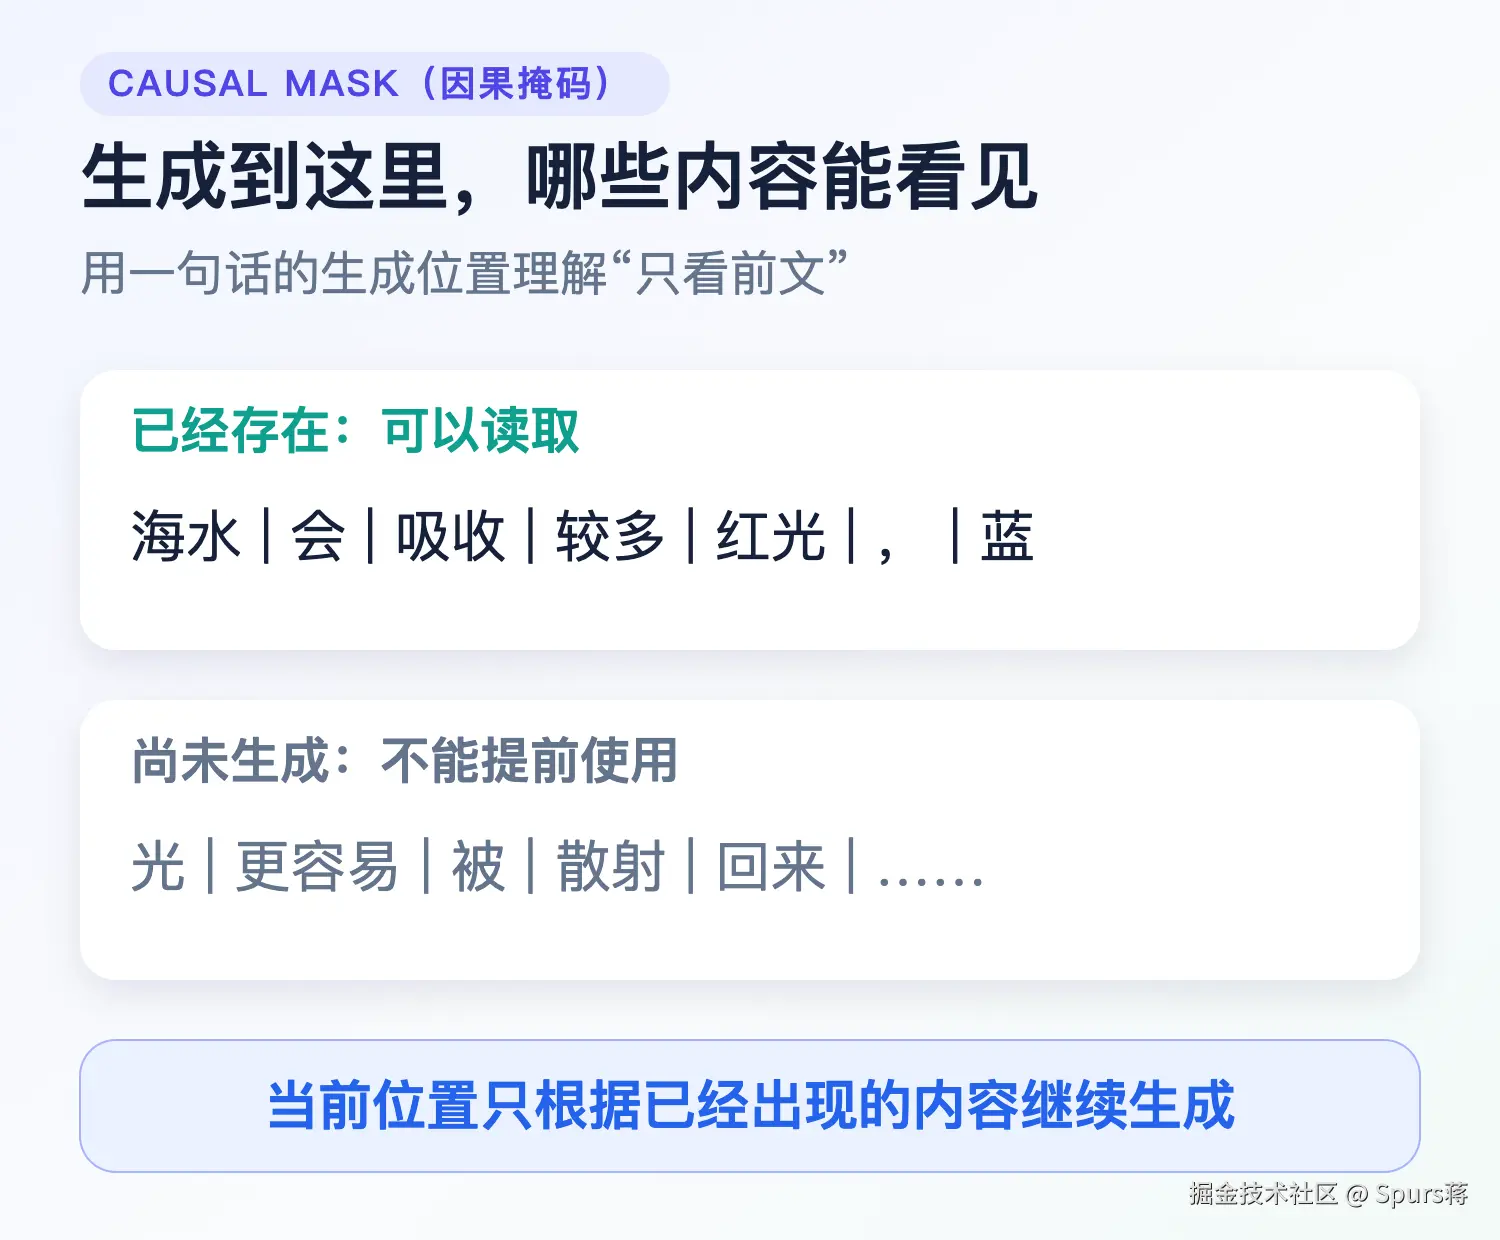
图 4:因果掩码规定的可见范围。左边是已有内容,右边是尚未生成的内容。
3. MLP 继续处理当前位置的信息
Attention 把相关位置的信息带过来之后,**MLP(多层感知机)**会继续加工每个位置自己的数值表示。它不再读取其他位置。
两者的分工可以先这样理解:
- Attention:把相关历史位置的信息带到当前位置;
- MLP:继续处理当前位置已有的信息。
第一篇不需要展开 Transformer 的所有部件。知道"注意力负责利用上下文"就已经能继续理解后面的推理过程。
四、模型怎样决定下一个 Token
经过多层计算后,模型最后会给词表里的候选 token 打分。这些分数叫 logits。图 1 每一步只保留三个候选,方便看清选择动作;真实模型的候选是整个词表。
分数还不是最终文字。生成规则决定怎样使用这些分数:
- 总是选择得分最高的 token,叫贪心解码;
- 把候选分数换算成被选中的概率,再按这个概率随机挑选,叫采样。
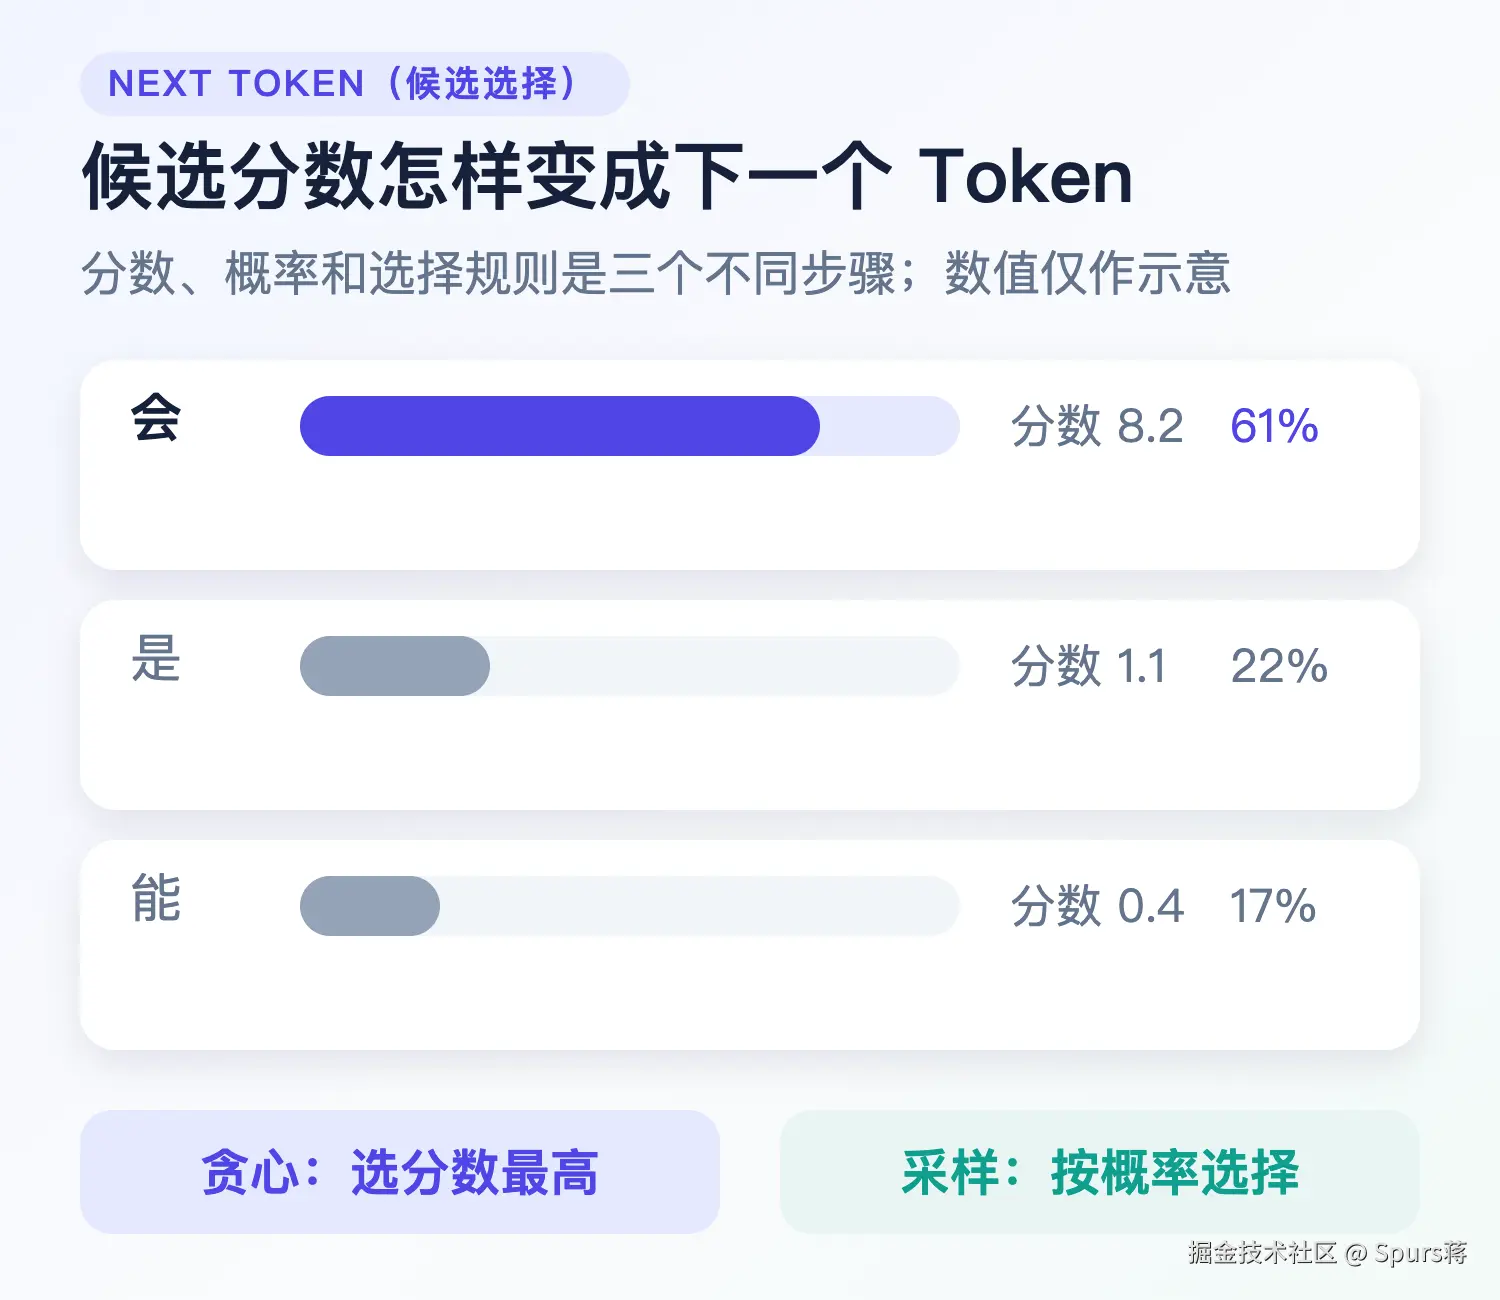
图 5:候选分数、概率和选择规则的关系。图中的分数和概率都是解释用数值,不是模型实测输出。
选出的 token 被加入当前内容,模型再根据新的内容计算下一个 token。这个过程不断重复,直到模型给出结束标记(表示回答结束的特殊 token),或达到设定的长度。
因此,"模型给候选打分"和"生成规则选出 token"是两个步骤。同一个模型使用不同生成设置,可能得到不同回复。
五、为什么已有文本可以一起处理,新回复却要逐步生成
"逐个生成"不代表模型在任何阶段都只能处理一个位置。
你的问题已经完整地放在输入里,模型可以一起处理这些已有位置,同时用刚才说的读取规则限制每个位置能看到的历史。
但新回复还不存在。第 10 个 token 没有确定之前,第 11 个 token 的输入就不完整,所以新内容只能逐步产生。
这个区别会直接引出后面的工程问题:历史位置的计算结果能不能保存下来,下一步直接复用?KV Cache 就是为了解决这个问题。
小结
| 概念 | 在本文示例中是什么意思 |
|---|---|
| Token | 模型处理文本的单位;本文这句话有 19 个,换一段文本数量会不同 |
| Embedding | 把 token 的 ID 换成一组可以参与计算的数值 |
| Attention | 让"它"能够利用"海水"等历史位置的信息 |
| 自回归生成 | 每次生成一个 token,再把它加入已有内容继续生成 |
只要理解"已经生成的内容会反复参与后续计算",就具备了继续学习 KV Cache 的基础。
参考
- DeepSeek-V4-Pro-Base 官方模型页与官方 Tokenizer 文件:本文 token 切分和 ID 的实际运行来源,可用该文件复现。
- Attention Is All You Need:Transformer 原始论文。
说明:海水颜色还会受到天空、水深、悬浮颗粒和浮游生物等因素影响。文中的简短回答只用于演示生成过程,不作为完整的物理解释。