一个 27B 模型已经放进 96GB 显存,服务却没有因此变得更快。用户仍然可能等很久才看到第一个 token,后续文字也可能出来得很慢。
"装得下"和"算得快"是两个问题。显存容量决定模型和请求状态能不能放下;数据能不能及时送到计算单元、计算单元每秒能完成多少运算,则会影响速度。
本文用一个 27B 模型和两张 GPU 的公开规格,把这几件事分开。文中的数字用于说明计算方法,不是实测结果,也不能直接当成部署承诺。
一、模型已经放进显存,为什么还要看其他指标
假设模型有 270 亿个参数,每个参数用 BF16 保存,也就是每个参数占 2 字节:
text
权重估算 = 270亿 × 2字节 = 54GB这里的 GB 按 10⁹ 字节计算,54GB 约为 50.3GiB。第二篇使用的 KiB、MiB、GiB 按 1024 进制计算,两组数字不要直接混用。
54GB 小于 96GB,单看权重,似乎还剩 42GB 可用。但这个减法还不能回答"最多能接待多少请求",因为显存里并不只有权重。
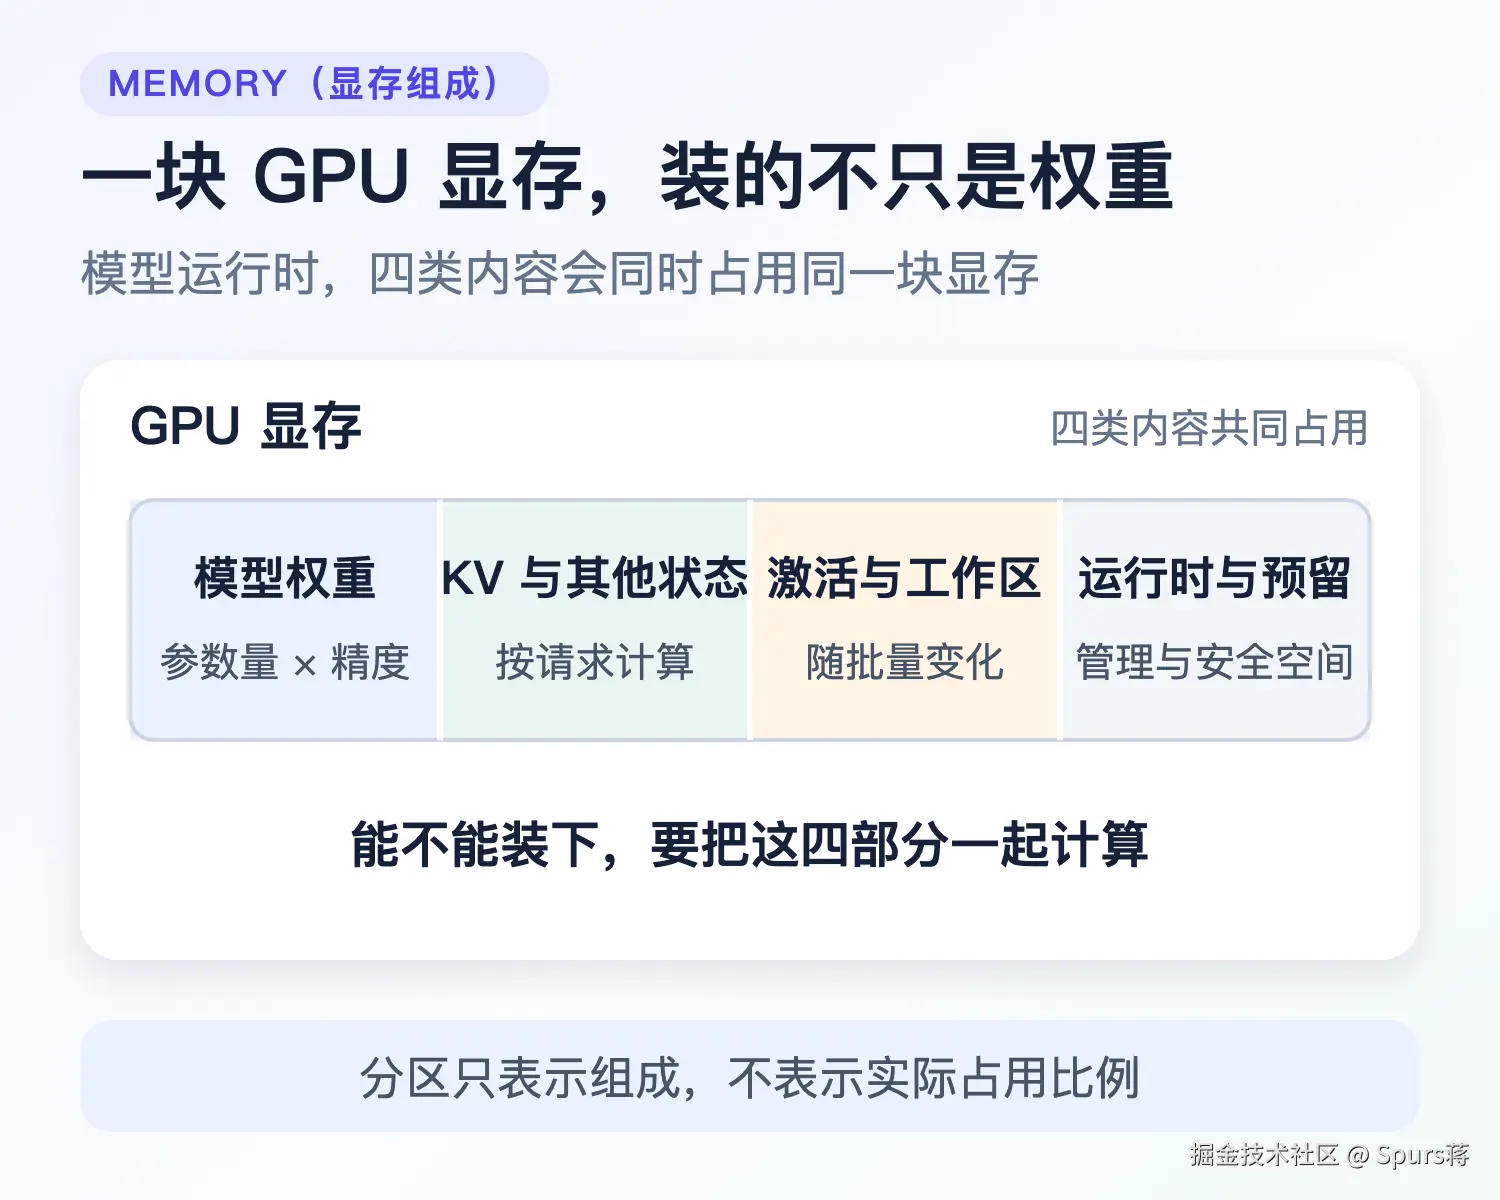
图 1:同一块显存中的四类占用。分区只表示组成,不表示实际占用比例。
一次推理服务还需要容纳:
- KV Cache 和其他模型状态:第二篇已经看到,全注意力层的 K/V 会随序列变长而增加;混合架构中的其他状态也要单独考虑。
- 激活和临时工作区:计算过程中产生的中间结果、算子需要的临时空间。它们会受批量、长度和实现方式影响。
- 运行时和预留空间:推理引擎的管理信息、内存分配策略、碎片余量,以及避免把显存用满的安全空间。
所以,正确的问题不是"96 减去 54 还剩多少",而是"在我的模型结构、精度、序列长度、并发和推理引擎下,哪些部分会占多少空间"。其中有些数字可以从配置推算,有些必须通过实际运行测量。
**显存容量不足,请求可能无法运行;显存容量足够,也不代表数据读取和计算一定很快。**接下来要看另外两项规格。
二、带宽:数据能以多快速度送到计算单元
显存带宽表示每秒最多能读取或写入多少数据。本文用 TB/s 作单位。
模型权重放在显存里,并不意味着计算单元可以零成本使用它们。本文的简化 Decode 示例假设每生成一个 token 都要把全部权重读一遍。权重很大、每步计算相对有限时,读取速度就会成为限制;实际服务还会受权重复用、KV Cache 和实现方式影响。
1. 一个简化权重读取算例
继续用刚才的 54GB 权重估算。这里的 4.0TB/s 取自 H20 的媒体公开参数,尚未完成官方规格复核,下面只用它演示计算方法。假设一张 GPU 的带宽是 4.0TB/s,并且每一步都必须把全部权重读一遍:
text
理论单步频率上限
= 4.0TB/s ÷ 54GB ≈ 74.1 次/秒
在 B = 1 的 Decode 中,每一步对应一个输出 token,所以这个频率与 tok/s 同量级。但它不是实测 tok/s,也不是服务承诺,只是在下面这些假设成立时算出的理论上限:
- 带宽一直跑满;
- 每一步确实需要读取全部 54GB;
- 不计算 KV Cache、激活和其他数据;
- 不考虑计算、调度、通信和实现损耗。
实际服务通常达不到这个上限。这个算例的价值是帮助我们看到:当计算量相对不大、但权重读取量很大时,增加峰值算力并不能解决问题,带宽才是关键。
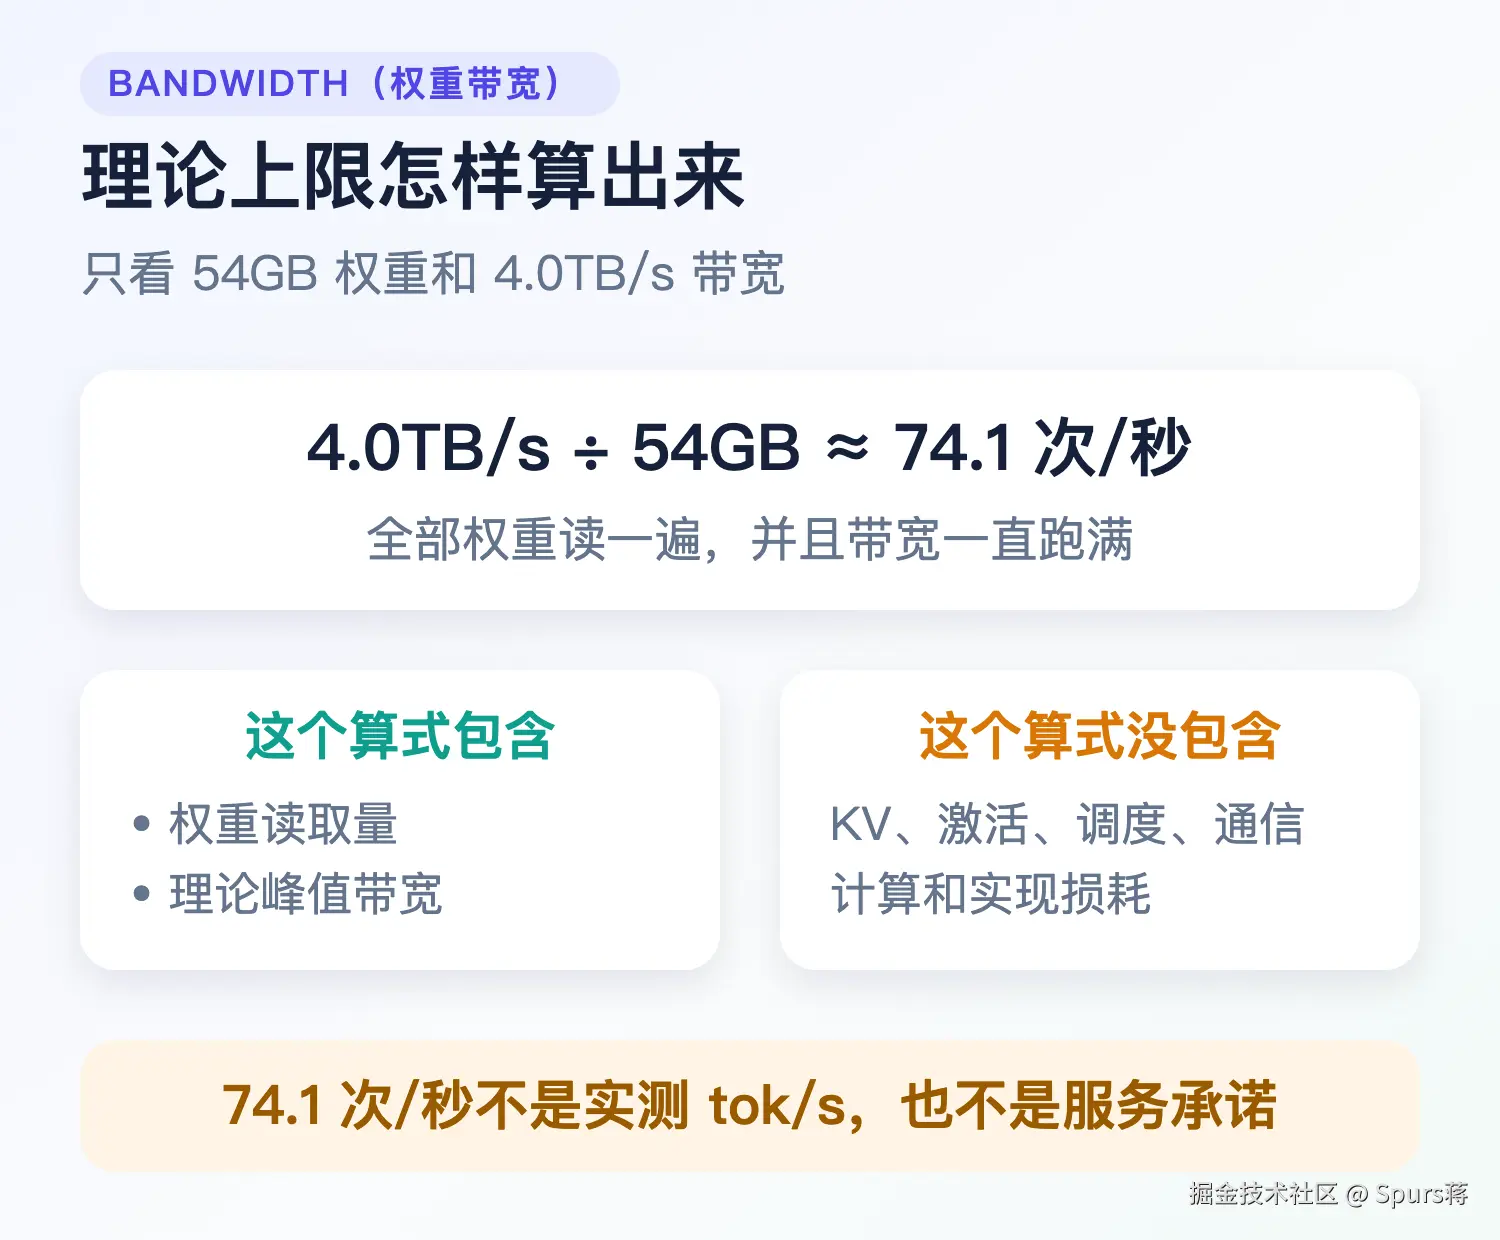
图 2:理论上限的计算条件,以及没有包含的开销。
2. 为什么多个请求可以共享一次权重读取
如果只处理一条序列,一次权重读取主要服务于这条序列的输出。如果有多个独立序列同时计算,同一份权重可以被这些序列共同使用。
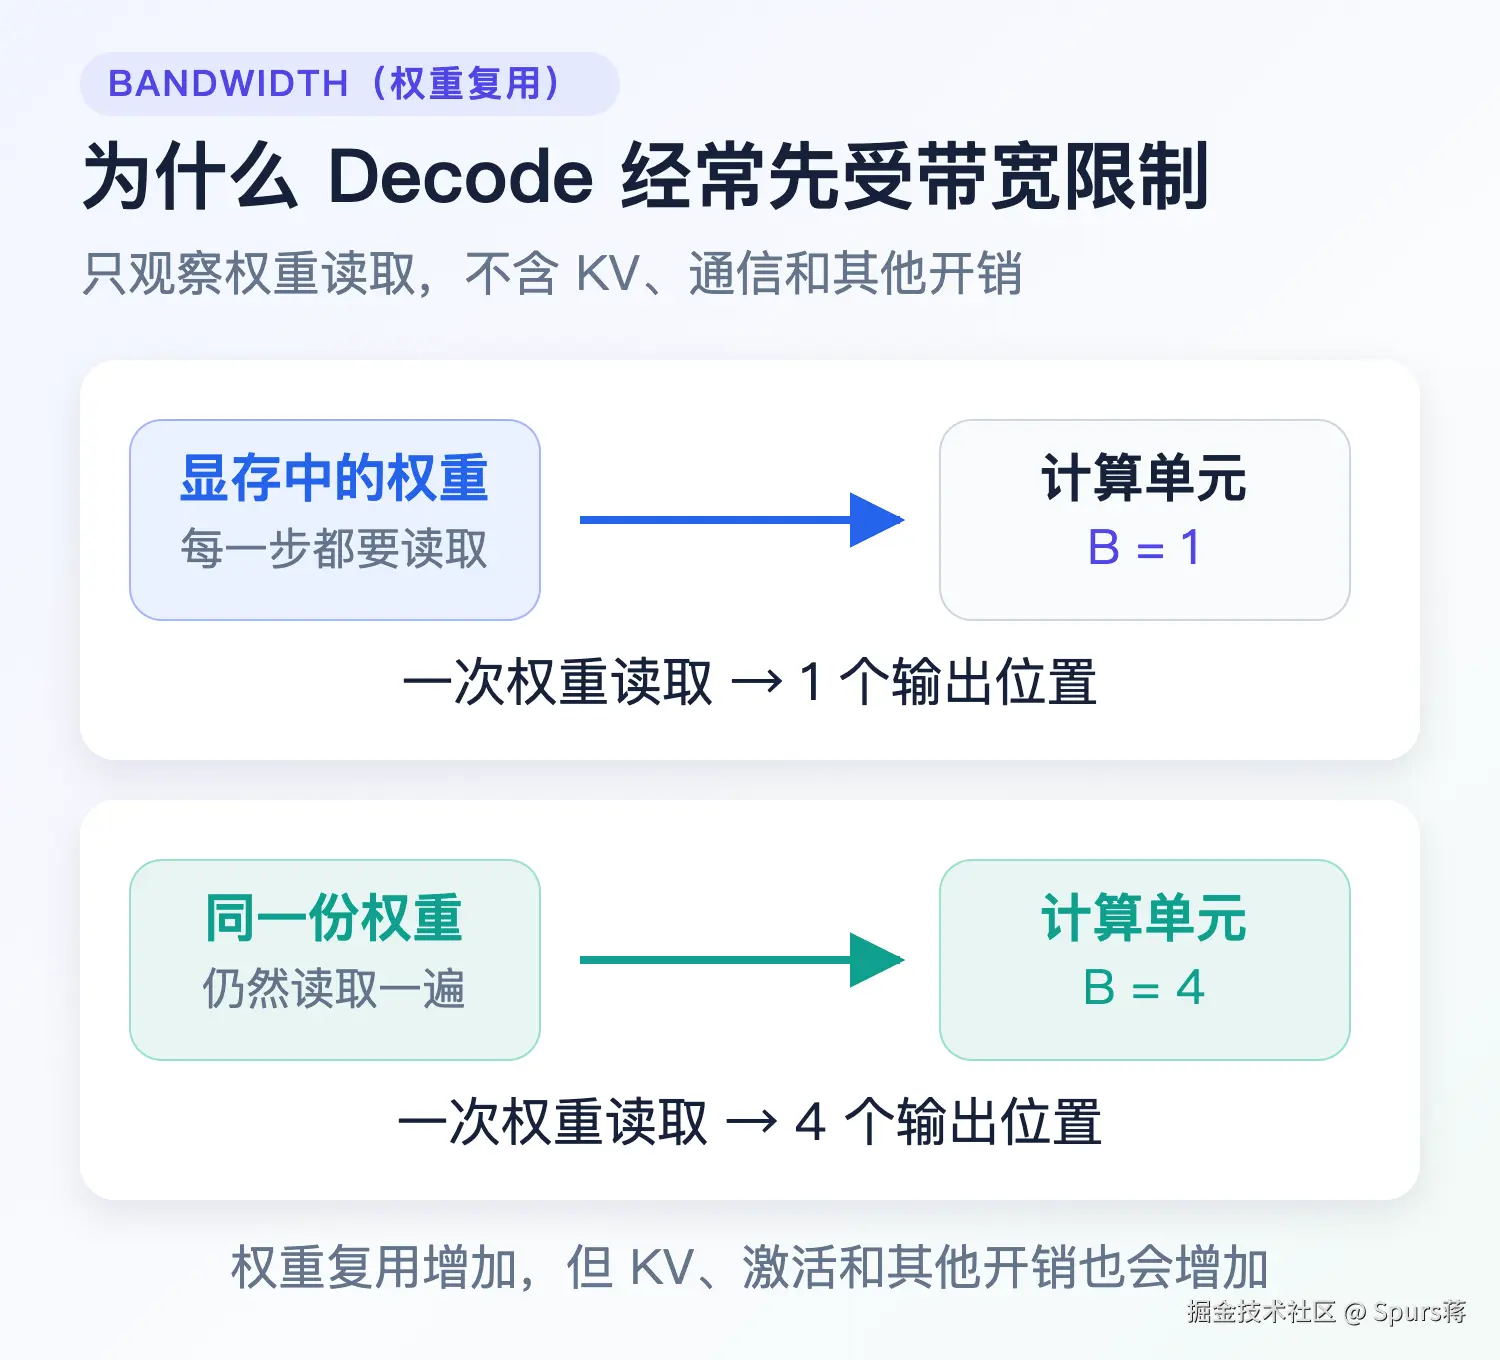
图 3:只观察权重读取。B 是同时参与这一步计算的独立序列数,不是推荐生产配置。
设同时参与这一步计算的独立序列数为 B。在简化模型里,B = 1 时,一次权重读取对应一个输出位置;B = 4 时,同一次权重读取可以对应四个输出位置。权重读取成本因此被更多工作分摊。
但不能由此得出"batch 增大四倍,速度就提升四倍"。批量增大还会增加 KV Cache、激活、调度和其他计算,延迟也会受排队影响。这里只说明权重复用这一项收益。
三、算力:每秒能完成多少数值运算
算力表示计算单元每秒能完成多少浮点运算,常用 TFLOPS 作单位。1 TFLOPS 表示每秒一万亿次浮点运算。
看到 GPU 规格表时,要先确认三个条件:
- 数值精度:FP16、BF16、FP8 的峰值不能直接混用;
- 是否带稀疏:有些宣传数字利用结构化稀疏,不能直接当成稠密计算的峰值;
- 实际工作是否适合这些计算单元:模型中的大量计算是矩阵乘法,Tensor Core 面向这类运算;采样、缓存管理等环节并不是同一种矩阵计算,不能直接用 Tensor Core 峰值估算它们。
这里的结构化稀疏,是按固定模式把一部分权重置零,例如每 4 个权重只保留 2 个非零值;支持的 Tensor Core 可以利用这种模式提高峰值吞吐。它需要模型和软件共同支持,也不等于实际速度必然翻倍。下面的换算只用于把官方"带稀疏"峰值换成稠密口径作比较。
例如,H100 SXM 官方页面列出的 FP16/BF16 Tensor Core 峰值为 1979TFLOPS,并标注带稀疏。按结构化稀疏与稠密的翻倍关系估算,稠密峰值约为:
text
1979 ÷ 2 ≈ 989.5TFLOPS这不是把官方数字"砍半"当成实测,而是为了比较时统一成稠密口径。实际模型能否接近峰值,还要看数据是否及时到达,以及计算是否足够充分。
四、算术强度:每读一个字节,要做多少计算
现在把带宽和算力联系起来。
**算术强度(Arithmetic Intensity)**就是:
text
算术强度 = 浮点运算量 ÷ 数据读取量
单位为 FLOP/Byte
如果每读 1 字节要做很多运算,计算单元更可能保持忙碌;如果每读 1 字节只做很少运算,计算单元可能更多时间都在等数据。
1. 用简化 Decode 模型理解 B
设模型参数量为 P,同时处理的独立序列数为 B。只看权重相关计算:
- 每条序列与权重相关的浮点运算量约为
2P(每个参数约对应一次乘法和一次加法); B条序列合计约为2PB;- BF16 权重约为
2P字节,被这些序列共同读取。
一次"乘后累加"通常计为 2 次浮点运算,这就是前面系数 2 的来源。
于是:
text
算术强度 ≈ 2PB ÷ 2P = B也就是说,在这个非常简化的模型里,B = 1 时算术强度约为 1,B = 4 时约为 4。这里的 B 只表示简化模型中的独立序列数;第五节会用另一组数字读取 Roofline 拐点。
真实请求还有注意力、KV 读写、采样、通信等开销,不同序列的长度也不一致,不能直接拿这个等式估算完整服务。
2. 同一份权重为什么会影响两个指标
B 增大时,一次权重读取服务更多计算,数据读取量占总工作的比例下降,算术强度提高。它同时解释了图 2 的权重复用和这里的计算方式。
但"算术强度提高"不等于"用户延迟一定下降"。服务吞吐、单请求延迟和显存占用是不同指标,不能只追求其中一个。
五、Roofline:先看限制来自带宽还是算力
Roofline 模型用两条上限描述理想情况下的可达性能:
text
可达性能上限
= min(带宽 × 算术强度,峰值算力)带宽乘以算术强度,得到"按当前数据读取效率,计算单元最多能完成多少运算";峰值算力则是硬件本身的计算上限,实际性能不能超过这两条中的较小者。单位上,(字节/秒) × (运算/字节) = 运算/秒,所以带宽与算术强度的乘积就是每秒运算量上限。
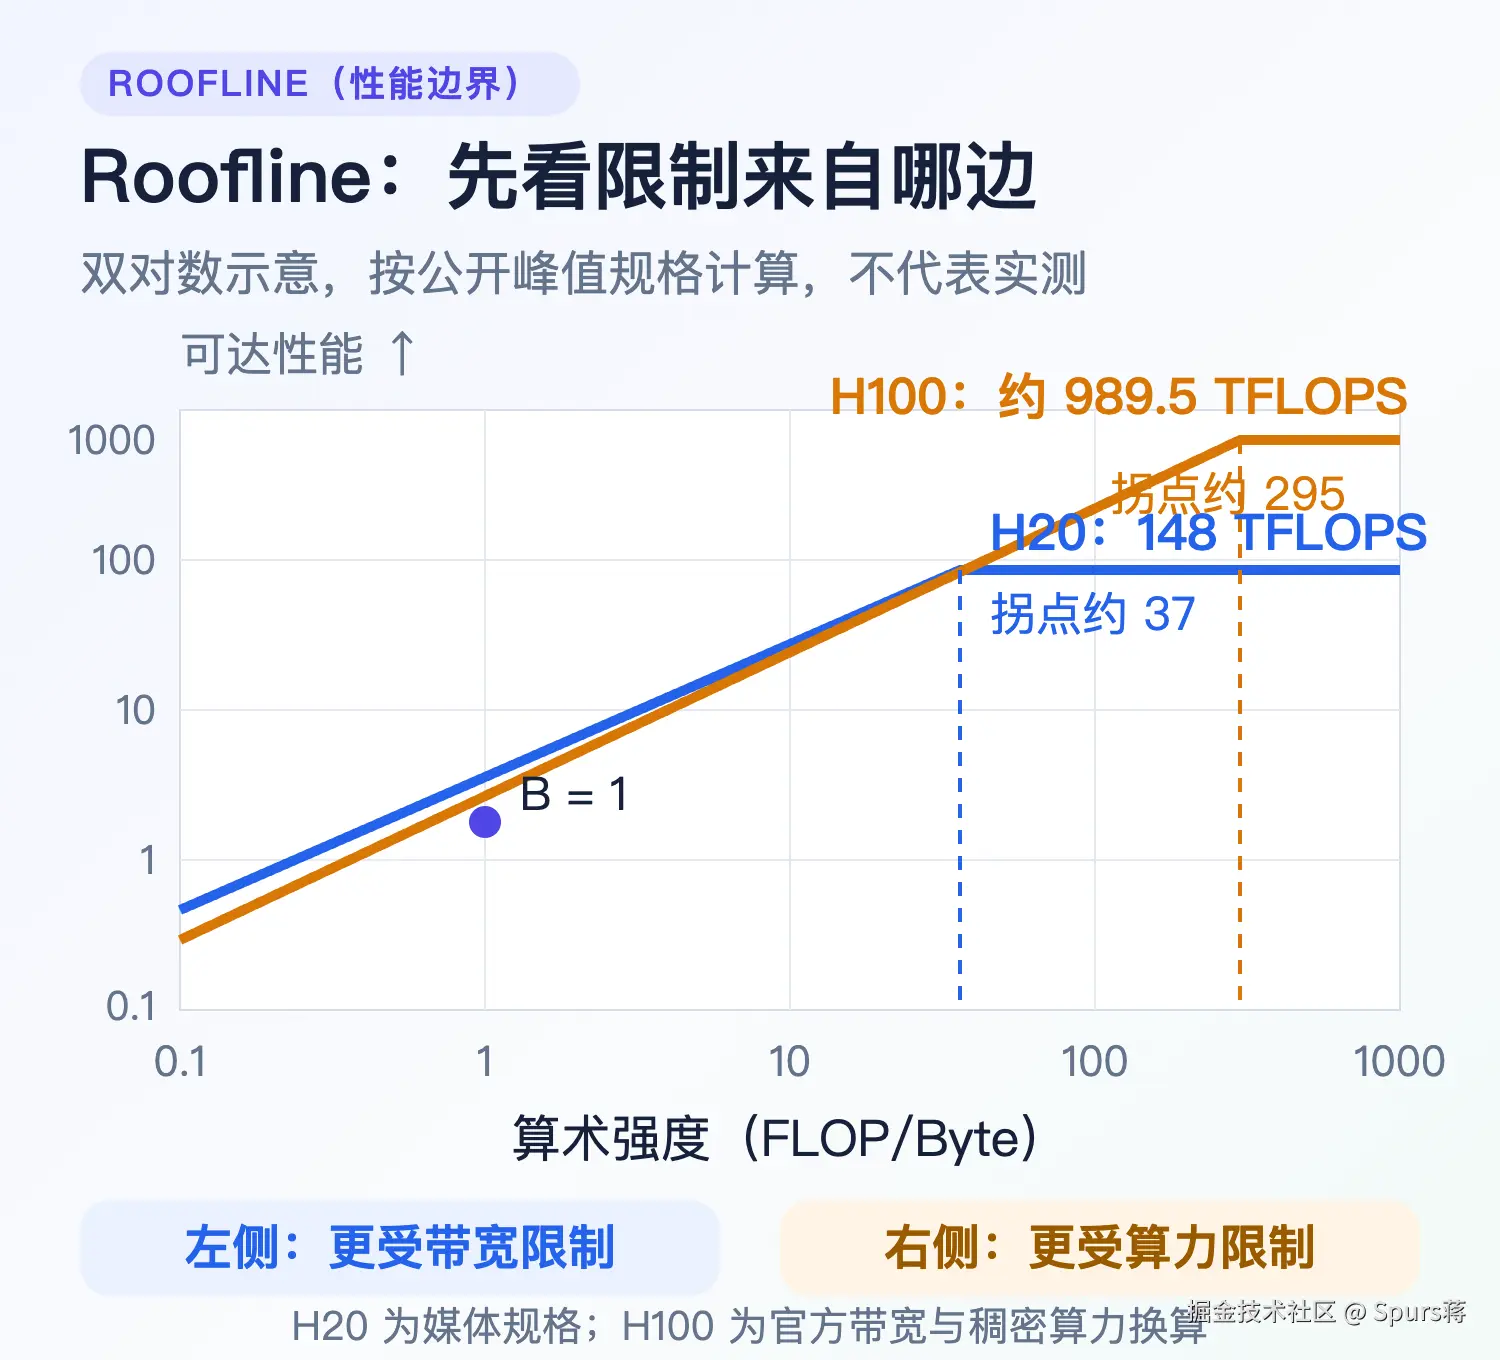
图 4:按公开峰值规格计算的双对数示意,不是实测曲线。
1. 怎样读出两条线
- 在左侧斜线区域,算术强度较低,带宽成为主要限制。提高峰值算力,理论上也不会突破这条斜线。
- 在右侧水平区域,算术强度较高,峰值算力成为主要限制。继续增加数据复用,也不能突破硬件峰值。
- 两条线的交点常叫拐点,对应的算术强度约为"峰值算力 ÷ 带宽"。
本文使用的规格为:
| GPU | 带宽 | FP16/BF16 算力口径 | 拐点估算 |
|---|---|---|---|
| H20 | 4.0TB/s | 148TFLOPS | 148 ÷ 4.0 = 37 |
| H100 SXM | 3.35TB/s | 稠密约 989.5TFLOPS | 989.5 ÷ 3.35 ≈ 295 |
H20 的 96GB、4.0TB/s 和 148TFLOPS 来自媒体报道,尚未完成官方规格复核;H100 的带宽来自 NVIDIA 官方页面,稠密算力是按官方带稀疏数字换算的估算。比较时必须保留这个证据差异。
2. 把简化 Decode 算例放上去
在简化权重读取模型中,B = 1 时算术强度约为 1,也就是每读 1 字节只做约 1 次运算,两张卡都位于左侧带宽限制区。B = 37 时,H20 到达拐点附近;H100 的拐点约为 295,在这个简化模型里仍处于带宽限制区。
这能帮助解释为什么"低算术强度时,更高的峰值算力不一定带来相同比例的推理加速"。但它不能推出"H20 在所有推理任务里都更适合",也不能推出"batch 到 37 就应该上线"。模型结构、请求长度、并发、引擎和精度都会改变实际工作。
六、实际排查时,这些概念怎样配合使用
面对一个"回复很慢"的服务,可以按下面的顺序收集信息:
- 先分时间段:用第二篇的 TTFT、ITL、TPOT 和端到端延迟,判断等待发生在首 token 前还是后续生成中。
- 记录请求条件:模型版本、精度、提示长度、输出长度、并发、batch 和推理引擎。没有这些条件,单个 tok/s 很难复现。
- 估算固定占用:权重、全注意力 KV、其他模型状态,避免把权重当成全部显存。
- 观察实际资源:GPU 利用率、显存占用、带宽利用情况和调度等待。理论 Roofline 用来解释方向,实测用来定位当前瓶颈。
- 一次只改一个主要变量:例如只调整 batch 或只修改精度,比较同一批请求的结果,避免多个变化混在一起。
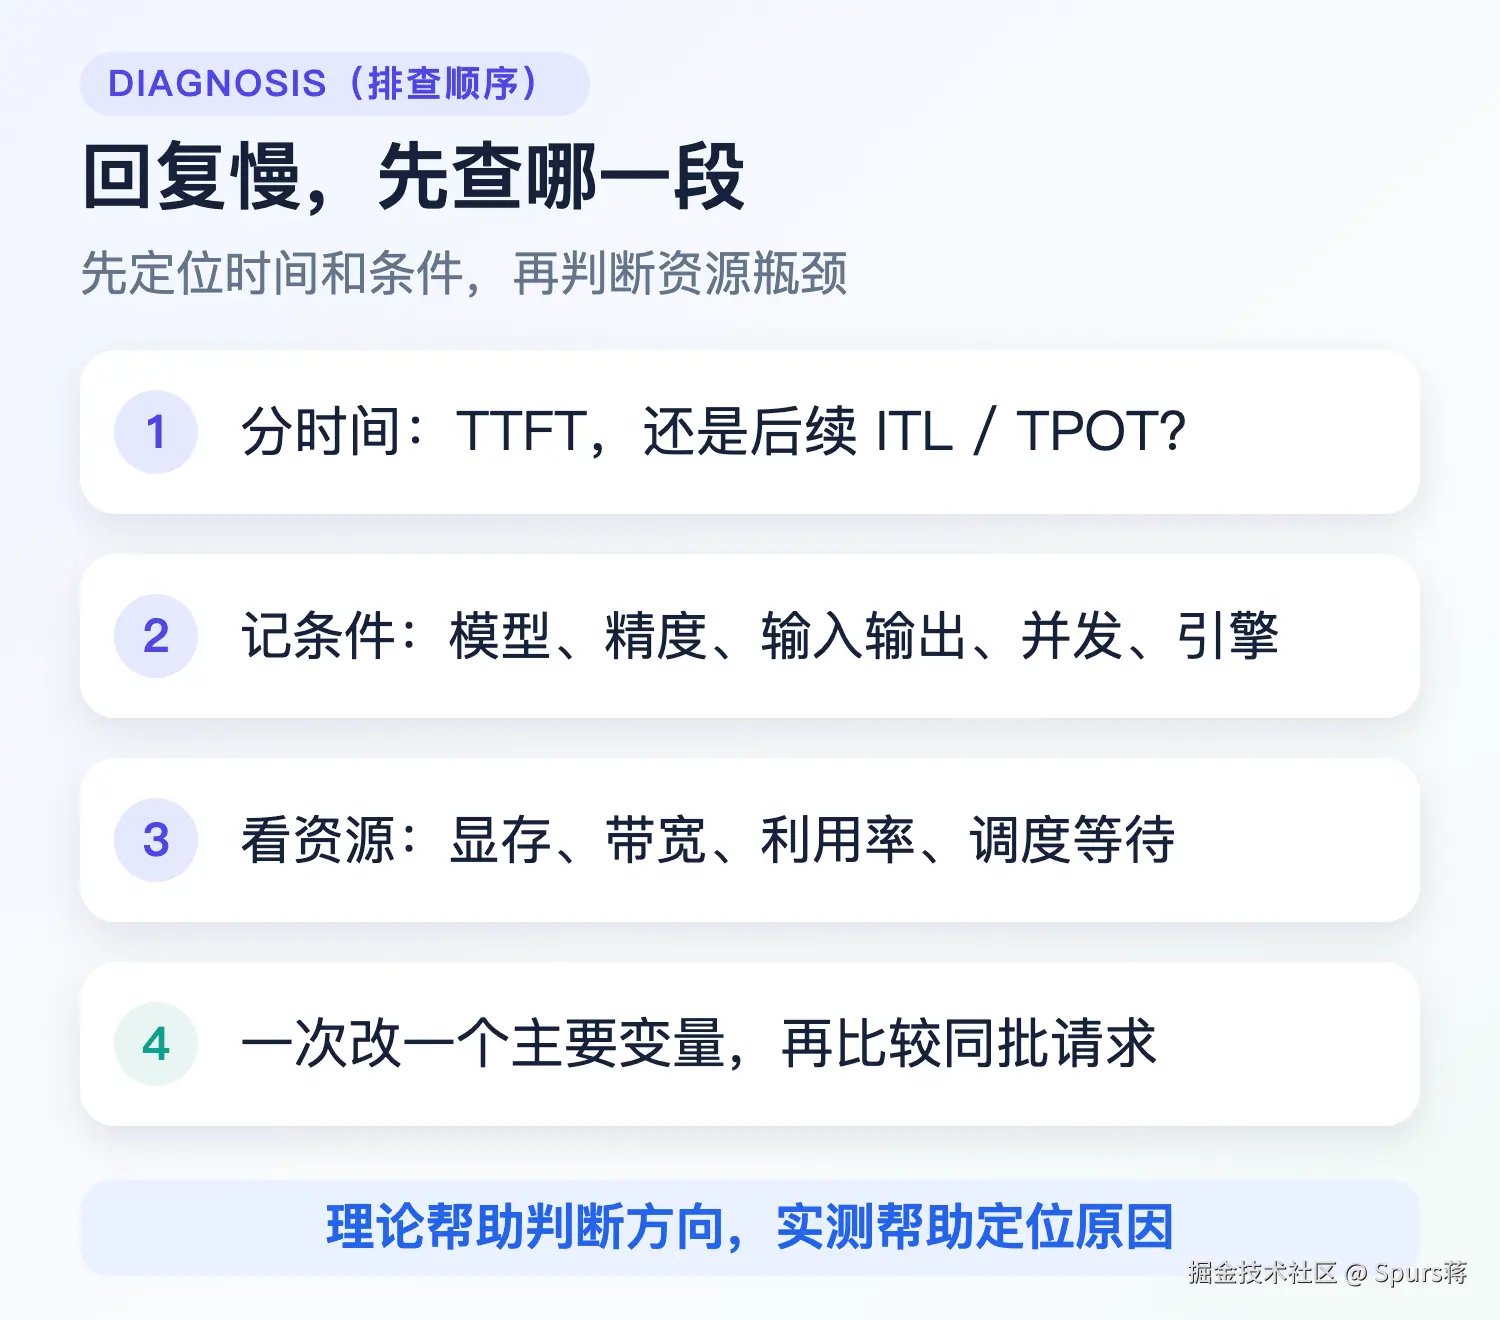
图 5:把规格和概念用于实际排查的顺序。
下面几句话不能直接从规格表得出:
- "峰值算力更高,所有推理请求就一定更快";
- "显存能装下权重,就能支持任意上下文和并发";
- "batch 越大越好";
- "理论带宽 ÷ 权重就是实际 tok/s";
- "两张卡在同一模型、同一引擎下可以直接按峰值比例换算性能"。
规格表提供的是分析起点,不是完整答案。
小结
| 概念 | 它回答的问题 | 本文要建立的判断 |
|---|---|---|
| 显存容量 | 权重和请求状态能不能放下 | 权重不是全部占用,KV、工作区和运行时也要计算或测量 |
| 显存带宽 | 数据能多快送到计算单元 | 权重反复读取时,带宽可能比峰值算力更关键 |
| 算力 | 每秒能完成多少浮点运算 | 比较前必须统一精度和稀疏口径 |
| 算术强度 | 每读一个字节做多少计算 | 简化 Decode 中约为 B,但 B 不是生产建议 |
| Roofline | 当前更接近带宽限制还是算力限制 | 用于判断方向,不代替真实服务测量 |
读完这三篇,可以把一次生成过程连成一条线:token 逐步产生,历史 K/V 被缓存复用,显存保存权重和请求状态,带宽与算力共同影响计算速度。后续讨论调度、推理引擎和多卡部署时,都需要保留这些边界。
其中,H20 的规格数字尚未完成官方复核,不能据此直接做采购或部署结论;54GB 权重、74.1 次/秒和 B 的算术强度也都是带明确假设的推算,不是实测结果。
参考
- Roofline 原始技术报告:带宽、算力与算术强度的关系。
- NVIDIA H100 官方规格:H100 SXM 带宽及带稀疏 Tensor Core 峰值。
- 英伟达 H20 AI GPU 参数曝光:本文 H20 规格来源,属于媒体报道,仍需官方资料复核。
- Qwen3.8-27B 官方模型卡:27B 模型示例;权重 54GB 为按参数量和 BF16 推算,不是权重文件实测大小。