一个月 7 个版本:三版都在补同一件事 ------ 卡片背面原来是空的
一个月,7 个版本(0.2.6 → 0.3.3)。真正的主线只有一条:这张卡的背面,原来是空的。
相对 10 月初的 0.2.6,改了三件事
- 补背面:词根词缀 25% → 48%,真人例句 0.8% → 41.6%,词源 0 → 83.5%,常见搭配 0.4% → 34.7%,同族词 24.2% → 43.3%;「背面至少有一项内容」的词 48% → 94.4%,四样全空的词 797 → 82 个(0.56%)。
- 补词表:四级离线词表 116 → 4,491 词。
- 修 bug 四个 + 加一个别人要的功能:CI 自检误判、状态行叠字、797 个「四样全空」的根因、面板被黑圆盖住;功能是「眼熟小组件」。
逐版对照:
| 版本 | 改了什么 | 关键数字 |
|---|---|---|
| 0.2.6 | 首发版。卡片建起来了,背面几乎是空的 | --- |
| 0.2.8 | 背面加「词根词缀」 | 覆盖率 25% → 48% |
| 0.2.9 | 加真人例句 + 词源追溯 | 例句 0.8% → 41.6% ,词源 0 → 83.5% ;背面至少有一项内容 48% → 94.4% |
| 0.3.0 | 常见搭配、同族词补到位;例句再接维基语料 → 94.49%;四级离线词表扩充 | 搭配 0.4% → 34.7% ,同族词 24.2% → 43.3% ;四样全空 797 → 82 个(0.56%) ;四级词表 116 → 4,491 |
| 0.3.1 | 新功能「眼熟小组件」+ 修 CI 自检误判 | 今天背过的词轮播,8 秒一个,不交互不计分 |
| 0.3.2 | 修:换词库后设置页状态行字叠字 | --- |
| 0.3.3 | 修:面板被一个巨大黑圆盖住 | 样式表没生效时 SVG 退回默认黑填充 |
一句话:这七版里三版在补卡片背面(0.2.8 词根词缀、0.2.9 例句和词源、0.3.0 搭配和同族词),一版加了眼熟小组件,两版在修渲染 bug。0.2.6 是建卡的那一版 ------ 卡建起来的时候,背面几乎是空的。
运行时依赖还是 0,体积从 2.9 MB 涨到 5.41 MB ------ 涨的全是词库和语料,不是代码。
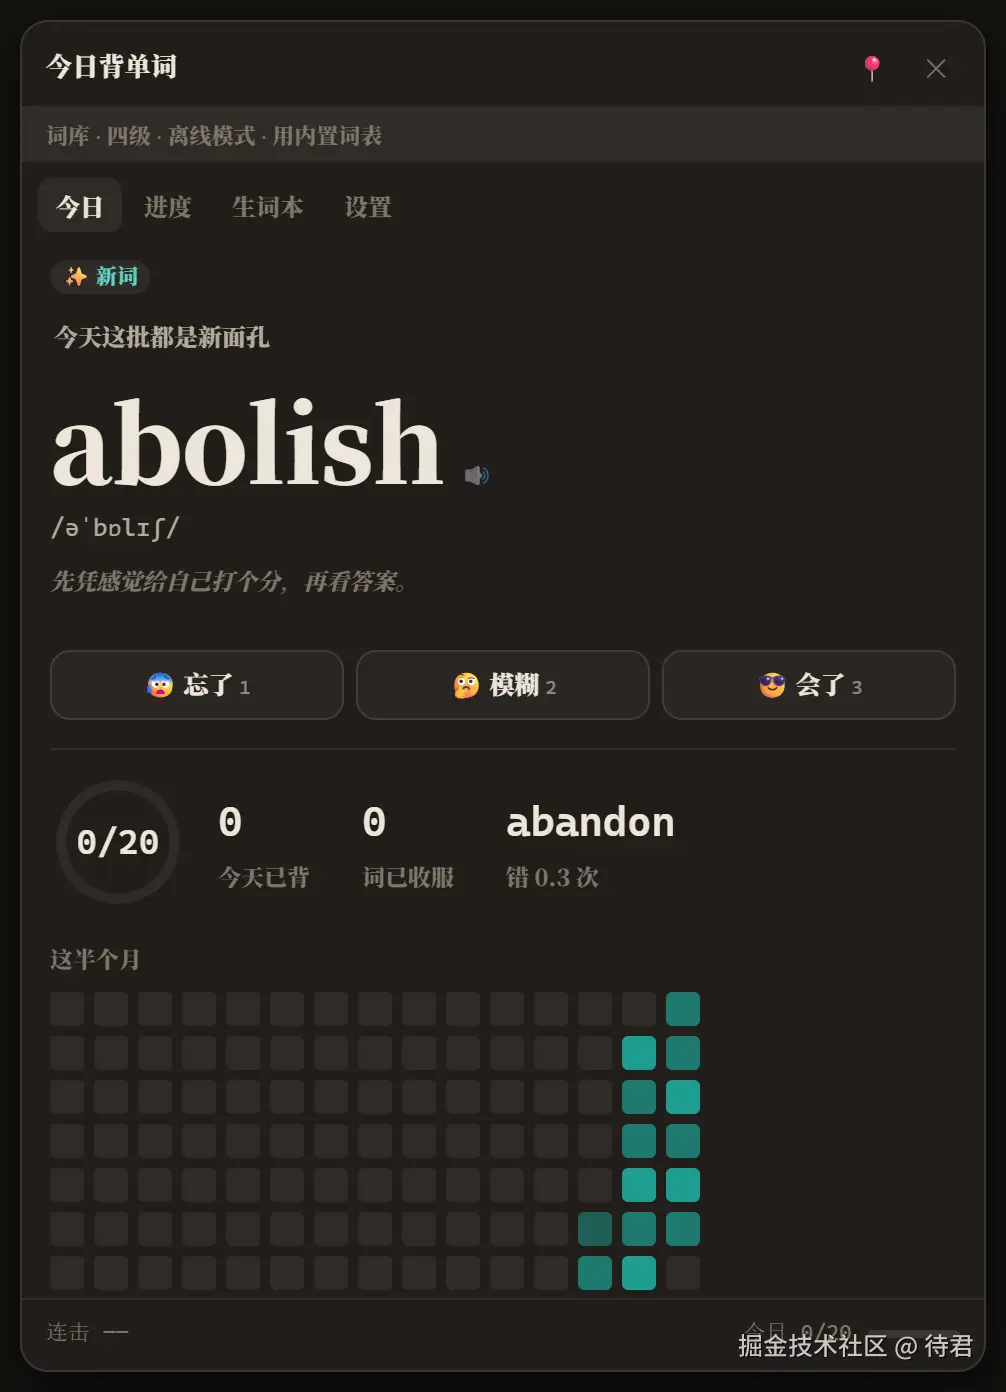
它叫 今日词汇(dsh-vocab-study) 。特别的地方不是它长什么样,而是:零运行时依赖、断网能背、数据一个字节都不出本机。 也不用另开 App ------ 它就在你等模型输出的那个界面里。
下面先讲它是什么、为什么长成这样,再讲这一个月补进去的语料和踩过的坑。
一、它到底是什么
| 项目 | 实际情况 |
|---|---|
| 形态 | DSH 客户端插件:输入框旁边一颗胶囊 + 一个侧栏标签页 |
| 页签 | 4 个:今日 / 进度 / 生词本 / 设置 |
| 词卡 | 正面单词 + 音标;翻面释义 + 例句;三档自评(键盘 1 / 2 / 3) |
| 词库 | 6 本:四级 / 六级 / 考研 / 雅思 / 托福 / GRE,共 34,216 词 |
| 离线 | 断网能开背。 六本词库各自带内置词表,取不到远程源时直接用内置 |
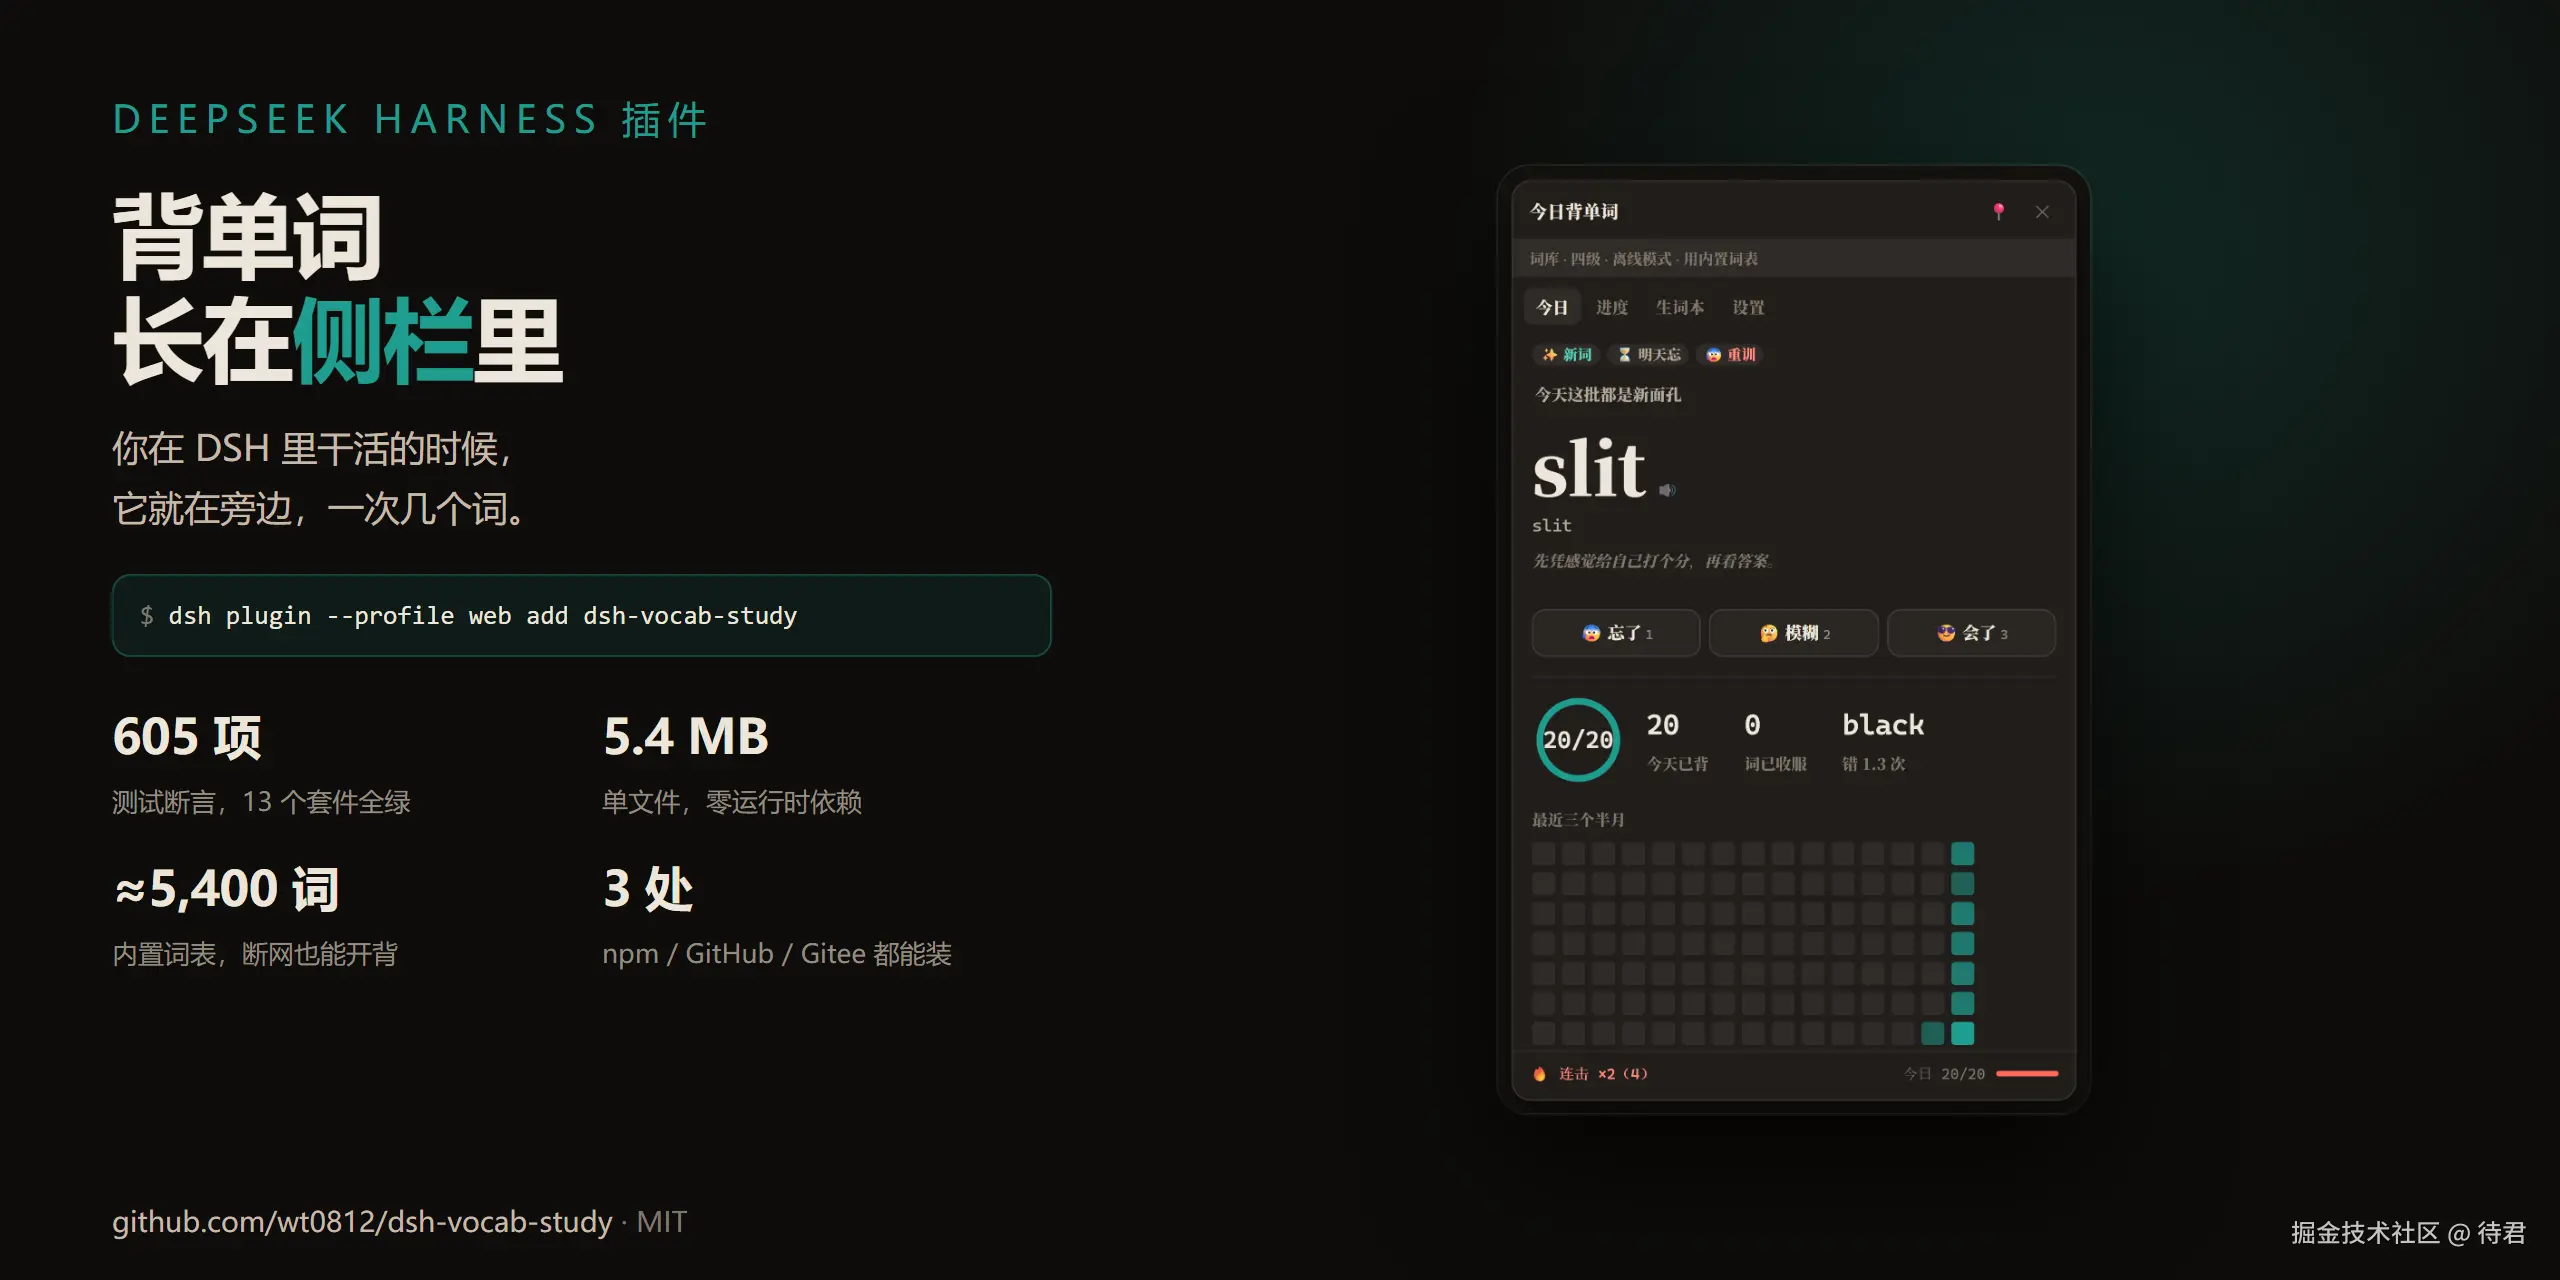
| 依赖 | 零 。dependencies 和 peerDependencies 都是空的,没有 node_modules |
| 体积 | lib/client.js 5,677,324 B ≈ 5.41 MB(六本词库占了绝大部分) |
| 网络请求 | 0(没有账号、没有服务端、没有上报) |
| 数据存放 | 只在本机浏览器 localStorage |
| 测试 | 13 个套件 / 605 条断言,全绿 |
| 许可 | MIT |
安装就一句:
csharp
dsh plugin --profile web add dsh-vocab-study卸载是 dsh plugin --profile web remove dsh-vocab-study。
二、它长什么样
四个页签,各干一件事:
| 页签 | 一句话 |
|---|---|
| 今日 | 一张词卡 + 三档评分;下方是今天这批的进度环、KPI、半月热力图 |
| 进度 | 30 天留存预测、半月热力图、顽固词榜、需要对着练的混淆对 |
| 生词本 | 从对话里收的词,自动补上音标 + 词性 + 释义,可以手改 |
| 设置 | 一轮几个词、加量步长、数据导入导出 |
sign=LY2IBmw8FJg8IWslHwYA0%2BG8Psw%3D)
左侧栏底部还挂了一个「眼熟」小组件
有人提了一条建议:把今天背过的词放到左边,让我眼熟一下。
我没有把面板搬过去 ------ 那会变成一个常驻的大块头,正好违背上面那条「不打扰」。最后做成左侧栏底部一张小卡,把今天答过的词轮流显示,8 秒换一个。
它纯展示:不能点、不计分、不动排期。看见过几次就算眼熟了,这件事不需要打分。
不用它的日子它什么都不做。面板永远不会自己弹出来 ------ 这条是刻意的,我不想让一个背单词插件在你干活时抢注意力。
三、为什么要长在 DSH 里,而不是做个独立 App
最早我做的是个独立的背单词网页。问题很快出来了:
我等 AI 输出那几十秒,通常就那么放着了。 而背单词要另开窗口、另点进去、等它加载 ------ 切来切去,就不想学了。
所以我反过来问:我要给用户的到底是个什么样的东西?
- 不另开窗口:必须在干活的那个界面里,一眼能看见、一下能点开。
- 不打断手 :评完一个词,手不该离开键盘。所以三档评分绑
123。 - 不联网:背单词这件事没有任何理由把数据发出去。
- 不打扰:不用它的时候它得消失,不能自己弹窗、不能占地方。
DSH 的插件形态刚好能同时满足这四条。最后的结构就是:输入框旁边一颗胶囊(不占地方)+ 一个标签页(点开才有) 。
好处和代价都很明显:
好处:你不用改任何习惯。开着 DSH 的时候顺手就背了。
代价:它得依赖 DSH 才能用 ------ 这不是一个能单独给所有人用的 App。如果你不用 DSH,这个插件对你没意义。
四、两个我自己比较在意的设计
1. 进度页敢回答「你变强了没有」
大部分背单词应用给你的百分比是装饰:今天背了 20 个就是 20%,明天忘了它也不知道。
这个插件的进度页会算「接下来 30 天还剩多少」,按记忆强度排期算出来。忘了的词更快回来,记牢的词拉长间隔。
还有一个判定叫「已收服」,条件挺硬:
记忆强度 ≥ 0.9,且在这个词的辨词题里答对过。
只在词卡上点过「会了」不算。没在应用场景里考过,就不算收服。
2. 两个「今天」的数字,故意分开
这里踩过坑,所以现在刻意拆成两个数:
| 数字 | 含义 | 点「再背一轮」后 |
|---|---|---|
| 进度环 | 这一轮 的进度(0/20 → 5/20) |
归零 |
| 今天已背 | 今天累计(抽空背 3 个也看得见) | 不归零 |
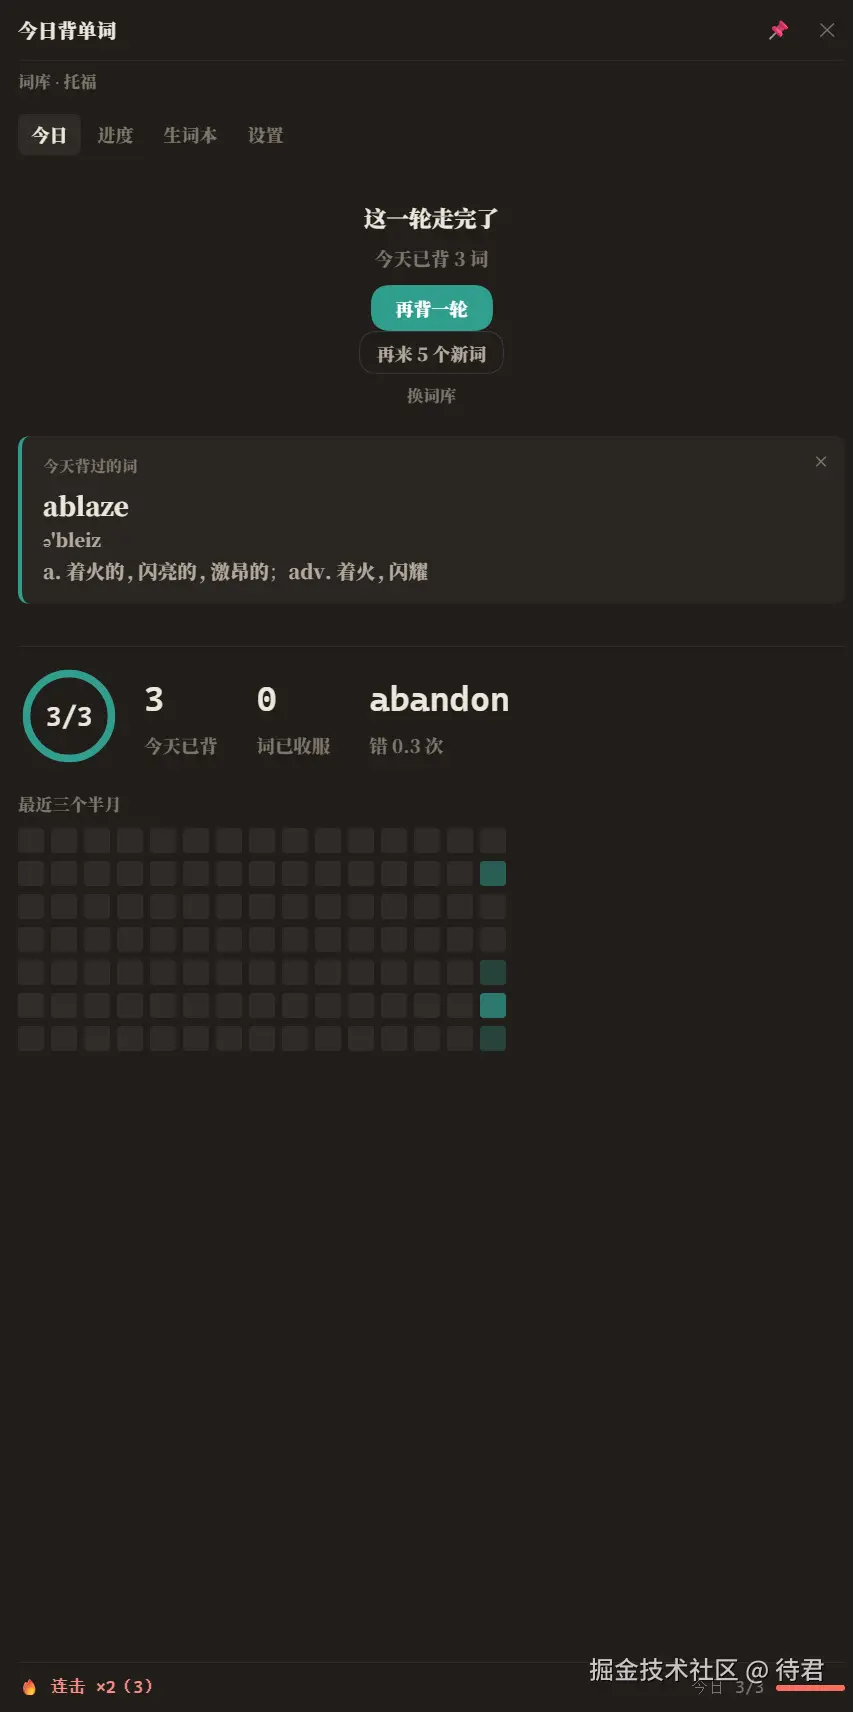
为什么拆开:一开始环用的是跨轮累加的值,点了「再背一轮」之后,环显示上一轮的数字,和「今天已背」直接矛盾(实测:环说 1,今日说 6)。用户会以为是数字坏了。
一轮走完之后也不是只剩一个「换词库」,而是给三条各自不同的出路:
- 再背一轮 ------ 刚才这批原样重来一遍,不动记忆数据
- 再来 N 个新词 ------ 往后加量,不重复(N 在设置里可调,默认 5)
- 我还是想继续 ------ 今天新词错太多时安全阀会自动关闭,这个按钮让你自己把门打开
最后一条我想单独说:加量是用户的决定,不该由插件自作主张定死一个数。 安全阀照旧自动触发,但界面给你自己开门的权力。
五、卡片背面是拿什么补上的
一条底线:摘录,不生成。 每一条内容都有出处,查不到就空着 ------ 宁可覆盖低,也不塞假数据。
1. 例句来自 Tatoeba,一个字都不改
Tatoeba 是一个多语言例句库,一共 610 万句。例句只从里面摘:挑中英对照的真句子,原文和译文都不改写。
译文只做一件归一化的事:台版用词换大陆说法。「我是义大利人」→「我是意大利人」,软体 / 网路 / 记忆体 / 萤幕 一并换掉。只动地区用词,不动句子本身。
没有配对译文的句子就不画译文行 ------ 编一句中文就是假数据。
例句覆盖率 0.8% → 41.6% 。
2. 词源来自维基词典,查不到就空着
词源取英文维基词典的词源章节:0 → 83.5% 。
剩下的就空着。我明确拒绝过一种做法:拿「词根在词里随便出现」当依据。实测 52 个候选里,africa << fric(摩擦)、winter << inter、momentum << ment(心智) 全错。往用户脑子里塞假词源,比没有更坏。
3. 同族词有两条路,分开标
- 共享词根的,标「同族词 · tract」这种
- 只有词形派生关系的(WordNet 3.0),标「同族词 · 词形派生」
后者不硬编词根 ------ 编不出来就不编。覆盖率 24.2% → 43.3% 。
4. 常见搭配:两道闸门,和一个排序 bug
这部分改动最大,从 0.4% 到 34.7% 。
第一版的做法是错的 :数「相邻两个词一起出现过几次」。go to the gym in the morning 里 gym in 出现得不少,但它不是搭配,只是两个词挨着。
重写之后只收闭类词结构:动词 + 介词、be + 形容词 + 介词、动词 + 小品词、形容词 + 名词、名词 + of + 名词......并且要求「出现次数」和「占该词总频次的比例」双达标 。accept of 在语料里出现过,但 accept 本身出现两千多次,占比太低,直接丢。
第二个语料源是 Simple English Wikipedia ,它只负责补 Tatoeba 挖不出来的词,而且加了三道闸门。最狠的一道是交叉验证 :这条搭配必须在 Tatoeba 里也出现过,两库都看到才算数 ------ abdicate in 这种只在 Wikipedia 里对得上的窗口误抓,就这么挡掉了。
然后是那个排序 bug。 老排序是「先按结构优先级分档,同档再按频次」。vote in 既算「动词 + 介词」又算「动词 + 小品词」,被两条结构各算一次,名额被 in / on / by 这几条占满 ------ 它们只出现 8 到 30 次。
结果:出现 234 次、占 vote 全部用法 48% 的 vote for,输给了一条 8 次的搭配,被挤出了名单。
改成「log(频次) × 结构权重」排序,并且同一短语先去重。
这类 bug 最阴的地方是它不报错:界面上就那么几条搭配,看着挺正常,只是对的那条不在里面。
5. 词根词缀:源数据的天花板在那里
我手上那份词根数据只有 611 条,来自一份语言学目录。spect、graph、phon、bio、chron 这几个最常见的词根,一条都没有。覆盖率停在 25%。
不是我解析漏了,是源数据就那么多。于是我手写了一份构词法表,专挑常见、但源数据里缺的前缀后缀词根补进去:25% → 48% 。那张卡也从「词根词源」改名成「词根词缀」------ 现在它是真的会拆前缀和后缀了。
六、四个 bug,三个没人报
三个是我自己查出来的;第四个用户只说了一句「插件突然崩了」------ 症状他看得见,根因他不可能知道。
1. CI 连红三天:把数据当代码(0.3.1)
红的是「守卫的自检」,不是功能本身。
自检脚本自己写了一份屏蔽器,只去注释,于是把数据里的文本 当成代码:0.3.0 新加的那句例句 A.I. won't reach singularity. 里的 A.I,被它认成「命名空间 A 的成员」,判定产物里存在悬空引用,几个 job 全红。
再往上一层更糟:构建期守卫的屏蔽器不认正则字面量 。/^[a-z][a-z'-]*$/ 里那个 ' 会被当成字符串开头,一路吞掉两千多个字符的代码 ------ 所以「照抄构建期那份」只会让自检静默失效。
修法是把「代码 / 非代码」的分离逻辑收敛成唯一一份实现(认得注释、字符串、模板串、正则字面量),构建期守卫和自检脚本都调它;打包前本机再跑一遍,不再只靠 CI。
这类 bug 最要命的地方不是它坏了,是它让「测试全绿」这四个字变成一句空话。
2. 换词库后,设置页那行状态字盖到了下一行(0.3.2)
根因是一个 min-height: 0。
那行状态文字是 flex column 的子项,面板高度紧张时被压成 0 高度,文字溢出来,正好盖住下面的「眼熟小组件」。改成 auto,再给这一行和它下面那行都加 flex-shrink: 0,让它们保住自己的高度。
看着是排版问题,其实是「这一行到底该不该有最小高度」的设计决定。
3. 「四样全空」的词,比想象的多(0.3.0)
例句、词根、词源、搭配全空的词有 797 个。我一开始以为是数据没抓到。查下去才发现:这些词根本不在词表里。
用户看到的是「这个词没有例句」,真相是「这个词不存在」。
顺着这条线又看见:四级离线词表只有 116 个词,是我早期手写的样本。也就是说断网的时候,agree、arrive、hear、spend 这种最基础的四级词,一个都不在。
把四级考纲词补进 seed:116 → 4,491 。四样全空的词,797 → 82 个(0.56%) 。
顺手也把卡片上那句点了必然失败的「暂无例句 · 可 ✨ 生成」删掉了,只写「暂无例句」。没有就说没有,不摆假按钮。
4. 整个面板被一个黑圆盖住(0.3.3)
这是这一个月最值得写的一个 bug,因为它隔了四层。
用户发来截图:面板里什么都看不见,只有一个黑色实心大圆,右侧还连着一小段弧,底部统计文字被挤到最左边,横向滚动条也冒出来。他的原话是「插件突然崩了」。
第一层,其实没崩。 那个圆是我画进度环的 SVG。
第二层,它为什么变成黑饼。 它的尺寸和填充全都只写在 CSS 里 。<svg> 没有 width / height 就会撑满父容器;<circle> 没有 fill="none" 就退回 SVG 的默认填充色 ------ 纯黑。两个一起缺,68 像素的进度环就放大成一张盖满面板的黑饼。
第三层,为什么属性会缺。 因为它本来就不该自带属性 ------ 尺寸和填充都归样式表管。真正的问题是:样式表没被应用上去。
第四层,什么情况下样式表会挂不上。 宿主热重载、面板被搬进 ShadowRoot、<style> 标签注进去只剩个空壳,都可能发生。旧代码只判断「文档里有没有这个标签」,有就直接 return,于是面板一路裸奔。我复现的时候只要把 CSS 关掉,那个黑圆就准时出现。
所以真正要修的不是这个圆,是「样式表到底有没有真的挂上」:
- 进度环和记忆曲线的 SVG 自带 尺寸与
fill="none":样式在时仍由 CSS 决定,样式不在时最差只是留个空位,不会再出黑块 - 注入函数改成按面板实际所在的那棵树注入(支持 ShadowRoot),认出「空壳 style」就移除重注入
- 每次渲染前确认一次样式,丢了当场补回来
外加一条回归测试:关掉样式表后,面板应该是「素颜但能看」,而不是一个黑饼。
用户说「崩了」,其实没崩。崩的是我「样式表一定在」这个假设。
七、零依赖是怎么做到的(顺便解释 5.41 MB)
这个插件没有运行时依赖,全部代码在一个客户端产物里。5.41 MB 里绝大部分是词库和语料,不是逻辑。
六本词库的内置词数:
| 词库 | 内置词数 |
|---|---|
| cet4 四级 | 4,491 |
| cet6 六级 | 5,406 |
| kaoyan 考研 | 4,801 |
| ielts 雅思 | 5,040 |
| toefl 托福 | 6,974 |
| gre | 7,504 |
| 合计 | 34,216 |
为什么要塞 34,216 个内置词 :远程词表取不到的时候要能降级,而且降级内容必须各不相同。以前内置词表是把同一份词换个 id 前缀 ------ 结果你切到六级,拿到的还是四级词。现在每本词库的内置词表都是各自独立的一份 ------ 六级那本是 5,406 个词,不是四级那本的复本。
雅思那本本来就没有公开的远程源,所以它一直只有内置词表。这是能力差异,不是 bug,README 里写明了。
八、关于测试,和我抓到的「假守卫」
测试是 13 个套件 / 605 条断言 ,全绿。但我想说的是另一件事:这些断言抓到过好几次我自己写的假守卫。
最典型的一次:进度环和底部是两个数在各自算「今日进度」,我加了一版断言去守它们相等。结果我把源码回退成旧写法,断言照样全绿 ------ 因为旧写法靠一个 ?? 兜底,在那种数据形状下恰好落到同一个值。
这种断言比没有更坏:它让人以为守住了。
后来改成读源码的断言,并且做反向验证 ------ 回退源码必须变红,才算这条断言有效。
14 起事故的完整记录(含证据、根因、修法)都在 docs/INCIDENTS.md 里,其中 5 起明确写着「不报错 / 毫无反应 / 无提示」:测试全绿、没有异常、界面「能看」,但功能是坏的。
九、一些诚实的话
这个插件是我给自己用着顺手做的,有些地方就是按我一个人的习惯来的。几条我自己知道的缺口:
- 它只能在 DSH 里用。 不装 DSH,这个插件对你没用。
- 词库的网络拉取我只在本机测过,没有在真实的复杂网络环境里长期验证。
- 多窗口只读锁是「尽力而为」,用的是 8 秒租约。浏览器异常退出时锁会自然过期,不会永久卡死;极端时序下仍可能出现短暂的双写。
- 雅思词库没有远程源,只有内置那 5,040 词。
十、最后
仓库和安装:
- GitHub:
https://github.com/wt0812/dsh-vocab-study - Gitee(国内更快):
https://gitee.com/wutong2005/dsh-vocab-study - npm:
https://www.npmjs.com/package/dsh-vocab-study
csharp
dsh plugin --profile web add dsh-vocab-studyprofile 是 web,写成 desktop 会报错(那个 profile 由 Electron 应用独占管理)。升级后要完全退出 DSH 再打开才会生效。
也可以从 DSH 的「设置 → 插件 → Add plugin」里搜 dsh-vocab-study 直接装。
MIT,免费,随便改。装了之后觉得哪里别扭、或者想要个什么功能,评论区说一声,我会看。
(本文数字都来自真机实测:npm test 的输出、真实字节数,以及 docs/INCIDENTS.md 里的原始证据。有说得不对的地方,欢迎在评论区指出来。)