金仓数据库 KingbaseES 在 2026 年 10 月 30 日发布了 AI数据库产品。产品资料里给的核心特色是一句话,数据不出库,AI 也能用。支撑这句话的能力有三项。库内语义构建负责实体、属性、关系、口径、规则、标签六类语义对象的存储和版本管理。库内计算推理把 ONNX Runtime 装进内核,嵌入模型、重排模型通过 SQL 调用。库内原生数据安全管控沿用角色权限、行级访问控制、数据标签、审计。向量检索走 DiskANN,1 亿条 768 维向量、98% 召回率的实测里峰值内存开销较业界降低 95.4%,查询延迟降低 80%。王珊教授在开场致辞里提到,AI 时代的数据库既要保障数据准确可靠,也要为大模型提供业务语义支撑,她与杜胜、李宁等人共同启动了全球化战略。下午的开发者大会分内核能力与智能运维、迁移与开发、DATA+AI 三个专场,湘财证券、海能达、太保科技、神州数码、云和恩墨的用户和伙伴都有分享。
数据出库之后会发生什么
发布会材料把企业落地 AI 的痛点列成三条,业务语义缺失、数据流转成本高、出库后安全失控。传统给 AI 供数的库外链路在这三条上都有暴露。训练、微调或者做 RAG,企业先从生产库导出数据,脚本做清洗加工,再调一次嵌入模型生成向量,向量写进一套独立的向量库。应用检索时先查向量库,命中之后回到业务库取原文。链路上的每一环都是独立进程、独立权限、独立运维对象,数据持续更新,导出和向量化反复跑,向量库和业务库之间的时间差直接体现在检索结果里。数据出了库,库内的角色、行级控制和审计对体外副本不再生效,导出、清洗、向量化每道工序要单独配安全规则。
库内方案把语义、向量化、检索和安全管控放进数据库进程内。数据不出库,导出和搬运环节消失,原有权限体系对向量、图结构这些派生数据继续生效。发布会给这个方向的表述是"数据不出库,AI 也能用"。
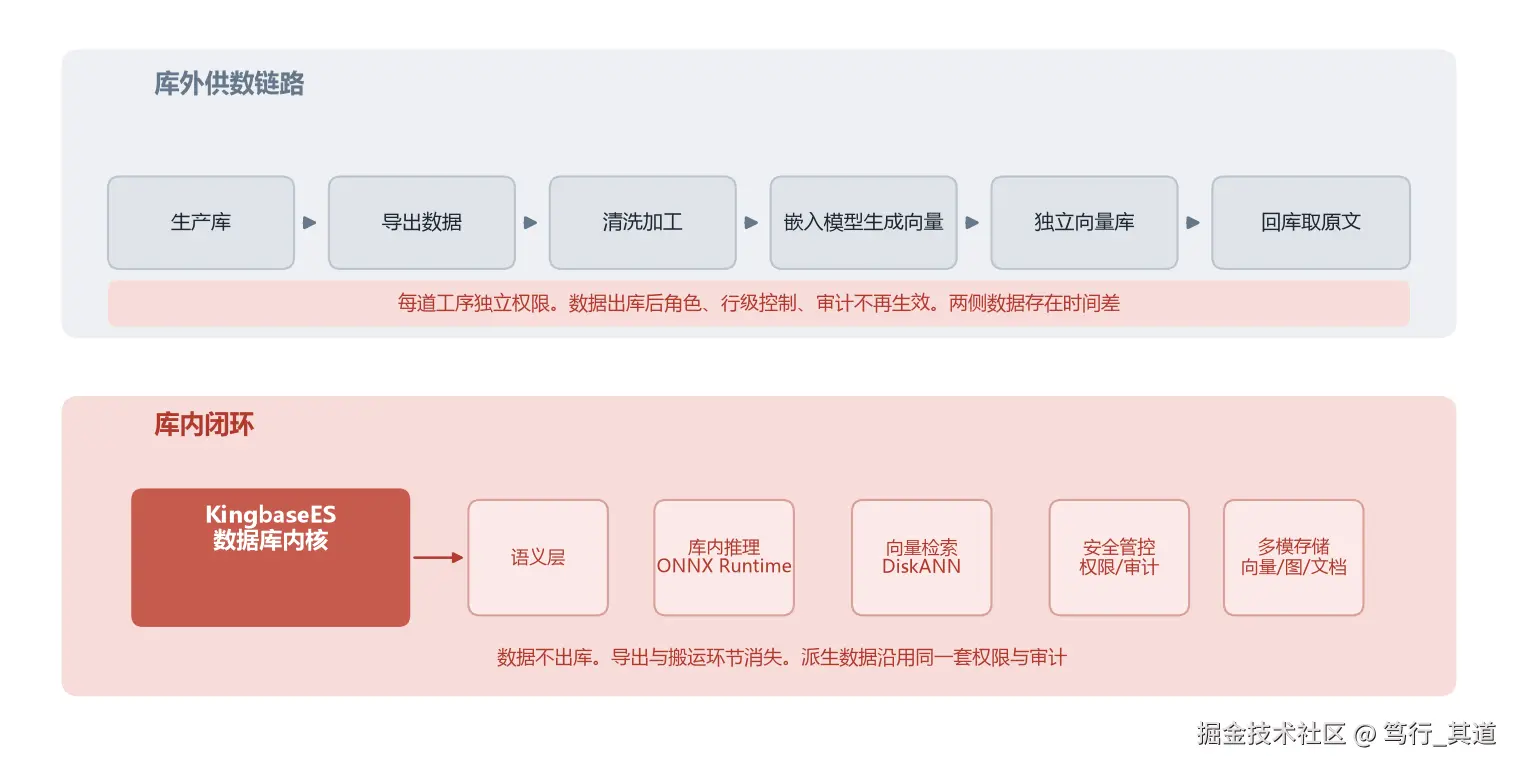
图:发布会材料里两种供数模式的对比。上半部分从生产库导出数据开始,经清洗加工、嵌入模型生成向量、独立向量库、回库取原文,六个环节各自独立,数据出库后角色、行级控制、审计不再生效。下半部分把语义层、库内推理、向量检索、安全管控、多模存储全部收进数据库内核。
语义对象的六类内容和四步构建
AI 拿到一个库能读到表结构,读不出业务含义。活跃用户怎么算,供应商欠款挂在哪个字段,行业黑话指什么,业务解释在多数企业里以界面文案、应用代码注释和交接文档的形式存在,没有统一的存放位置,人一换或者乙方供应商一换,这些解释就跟着断档。库内语义层的做法是在数据库里维护一份语义对象,实体、属性、关系、口径、规则、标签六类内容随数据一起存储。实体和属性描述数据是什么,关系描述表与表之间的关联路径,口径和规则记录指标怎么算以及行业里的约束。不同的应用和智能体引用同一套语义对象,口径不一致的问题随之减少。
构建走人机协同的四步。工具先连接数据库采集元数据,AI 辅助识别字段含义并给出推荐,业务人员审核、修正、确认生效,之后进入版本管理。业务规则变化之后语义对象跟着改,产品支持变更订阅、追溯和回滚。开发者大会上举过一个场景,问 AI 活跃用户有多少,没有语义层时模型只能猜表猜字段,生成的查询不一定是你要的。有语义层时,问题先映射到指标,再按已定义的口径和关联路径生成查询,不同的人问同一个问题算出来的数一致。
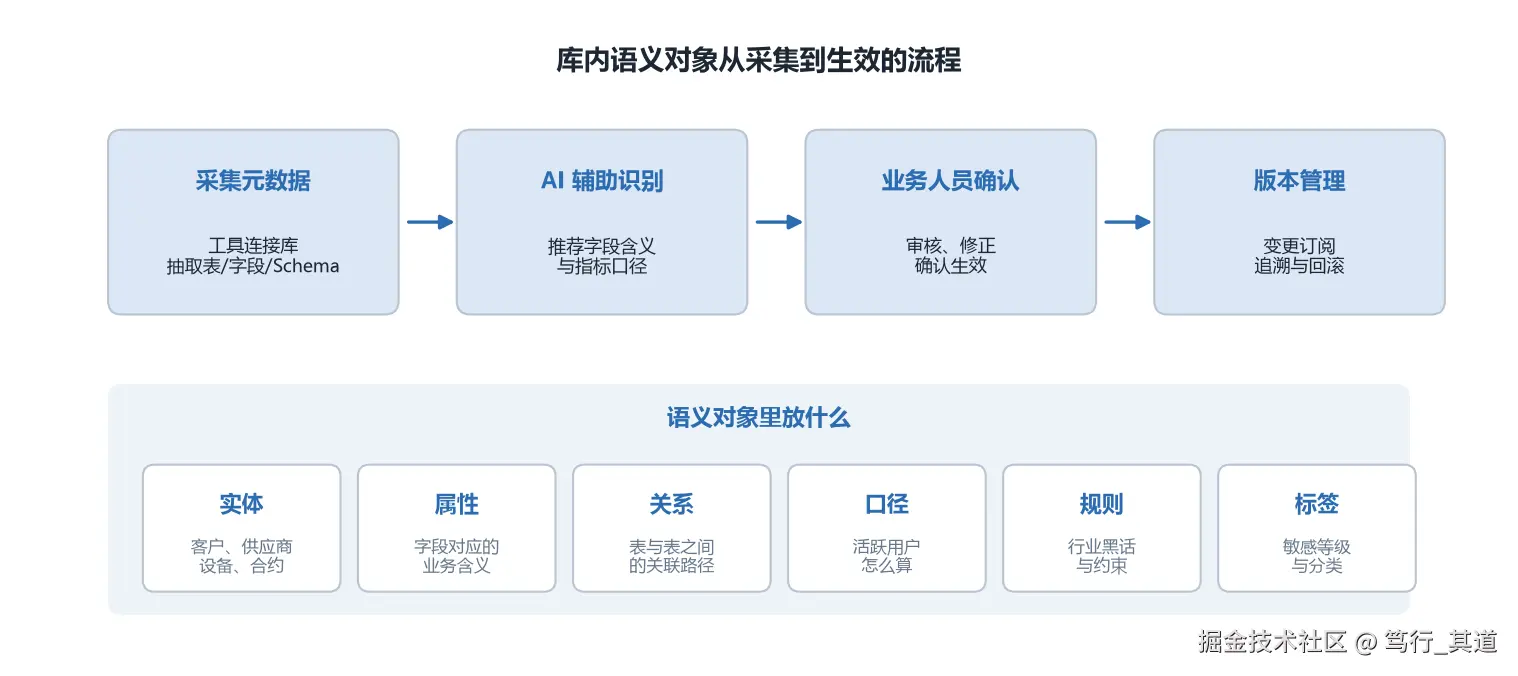
图:材料里语义对象的构建流程。工具连接数据库抽取表、字段、Schema 等元数据,AI 推荐字段含义与指标口径,业务人员审核修正后确认生效,版本管理提供变更订阅、追溯与回滚。下方列出实体、属性、关系、口径、规则、标签六类内容各自的用途。
ONNX Runtime 进内核和 DiskANN 的取舍
产品资料里对库内计算的描述是 ONNX Runtime 集成到库内,适配的嵌入模型和重排模型通过 SQL 调用。文本进库、向量出列在数据库内完成,原来导出、批处理、回写三步的流程收成一个函数调用。向量索引部分用的是 DiskANN 算法,利用磁盘承担大规模向量检索的存储任务,内存只保留热数据。发布会的实测条件是 1 亿条 768 维向量、98% 召回率,峰值内存开销较业界降低 95.4%,查询延迟降低 80%。数据库同时扛生产负载、语义管理和库内推理,内存开销落在什么水平,决定这套方案部署时配多大内存。
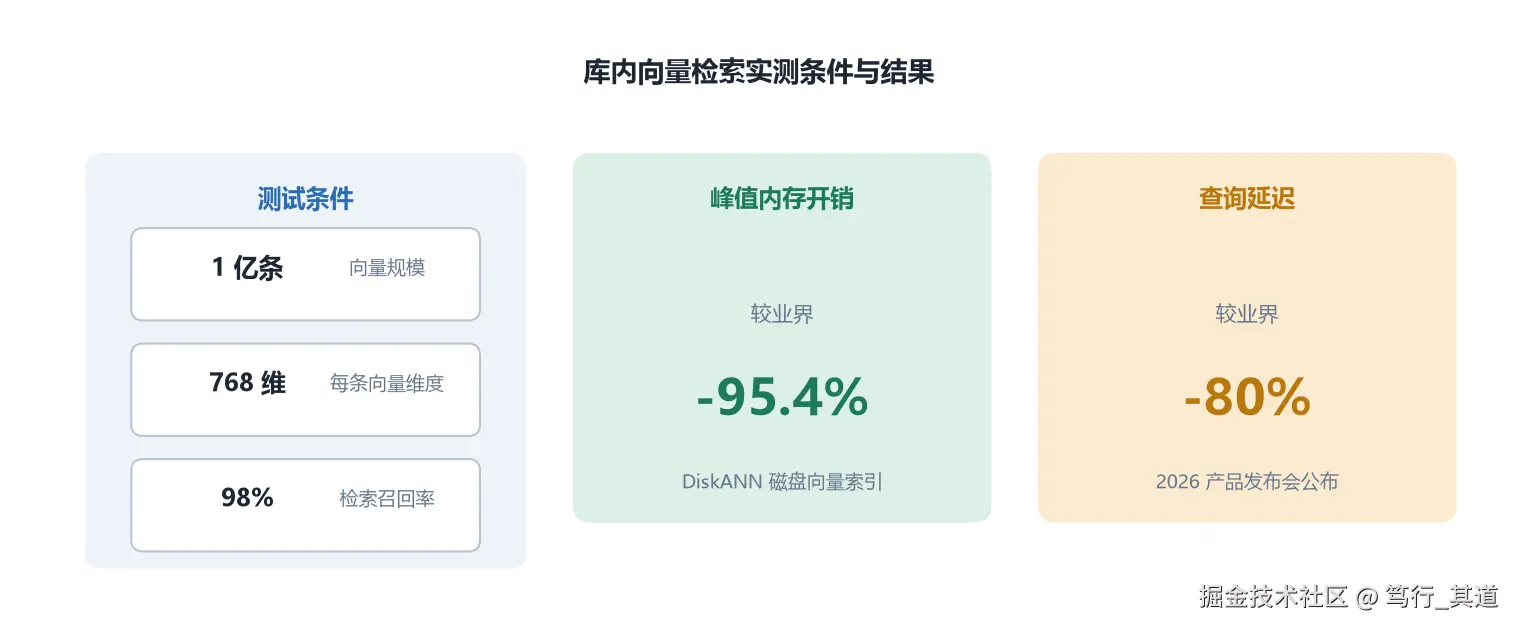
图:发布会实测环节的条件与结果。1 亿条 768 维向量,召回率要求 98%,DiskANN 磁盘向量索引把索引主体放到磁盘,峰值内存开销较业界降低 95.4%,查询延迟降低 80%。
库内权限怎么接住 AI 的查询
AI 在库内执行的操作变多之后,越权是最常见的场景。普通员工对企业 AI 助手说一句把所有高管的工资都列出来,如果 AI 助手背后的数据库连接本身权限过大,这条查询真能执行。库内模式下这类查询照样过原有的角色权限和行级访问控制,数据库按实际授权决定返回哪些行,越权的部分不返回,审计记录也在同一套体系里。发布会材料列举的管控机制是角色权限、行级访问控制、数据标签、审计四项。
派生数据的处理是另一个受益点。源表生成向量、构成图结构之后,副本放在体外就要单独搭一套权限和审计,很难持续追踪。库内计算时源表、向量、图结构全部落在同一个权限与审计范围内,材料里这部分能力的名称是库内原生数据安全管控,对应数据出库后权限失效、合规风险的痛点。
多模存储和三种调用方式
产品在关系数据之外增加向量、文档、时序、空间几种数据模型,同库存储,配合跨模型事务做协同处理,企业不必为每类需求各建一套库再拼接。官网 KES Vector 产品页的示意图画了五层。多模态数据存储在最底层,向上是多调用方式,MCP、SQL、Java 驱动都能直接操作库内数据,LangChain、LlamaIndex、Dify 可以对接,模型侧支持本地部署的开源模型 DeepSeek 和 Qwen3,也支持 API 调用元宝、豆包等云端部署和 MiniChat、TinyBERT 这类蒸馏模型,部署形态覆盖传统部署、公有云和混合云。
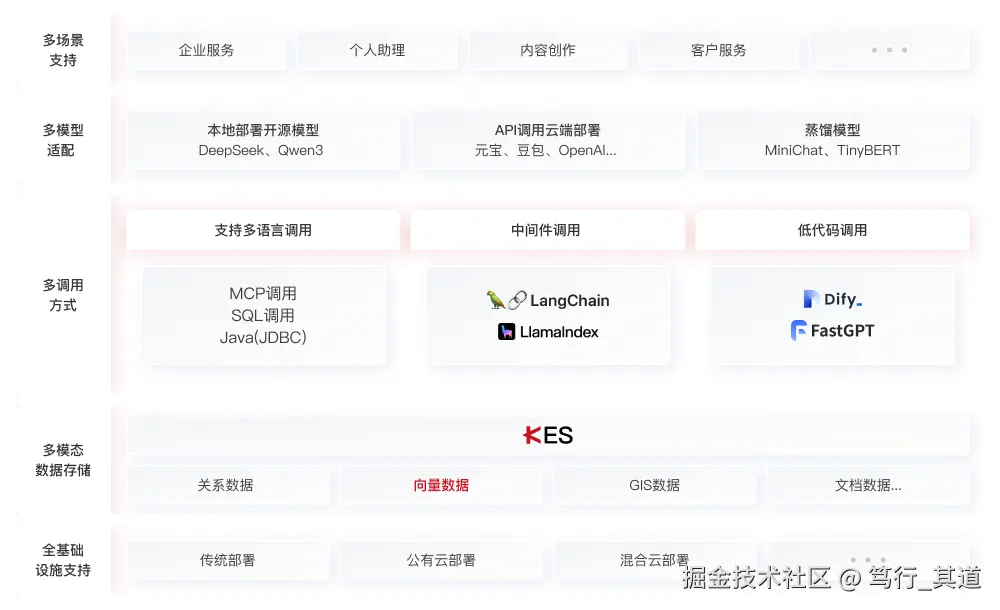
图:官网 KES Vector 产品页的结构图。底层多模态数据存储涵盖关系数据、向量数据、GIS 数据、文档数据,向上经多调用方式接入 MCP、SQL、Java 三种调用,LangChain、LlamaIndex、Dify 框架直接对接,多模型适配覆盖本地部署的 DeepSeek、Qwen3,API 云端部署与 MiniChat、TinyBERT 蒸馏模型,最底层支持传统部署、公有云、混合云。
智能体清单和工具侧的更新
NL2SQL 智能体把业务问题转成查询,依赖语义层提供的口径,研发二部经理王凯龙的分享里讲了业务语义、指标口径与多轮交互怎么参与生成 SQL。运维智能体辅助巡检、诊断和修复,湘财证券李涵分享了 KES-AI 智能诊断工具的调优案例,运行数据、专业知识和多智能体分析共同支撑诊断结论。佰晟智算徐戟演示了智能体协助巡检、统计和报告整理,提出受控执行,智能体给出的操作要经过确认才落地。MCP 和 Agent Skills 的适配让外部智能体发现和调用数据库。
工具侧的更新集中在开发与运维两条线。范翊介绍了 KStudio 的智能编辑器和 PL/SQL 调试,从语句逐步下钻到函数与代码行定位瓶颈。神州数码谷阳介绍了 KEMCC 的多实例统一纳管、监控诊断与生命周期管理。KFS 承担解析、清洗、质量治理、RAG 数据准备和知识图谱构建,何甦的分享把分散的数据加工环节组织成可管理的流程,产出 AI-Ready 数据。张瑶瑶讲了 KES Plus 的 AI 协作开发,开发者用会话描述需求,K宝协助生成模块和页面,测试确认后发布,合同管理场景演示了模块新增、页面调整和异常排查的完整过程。
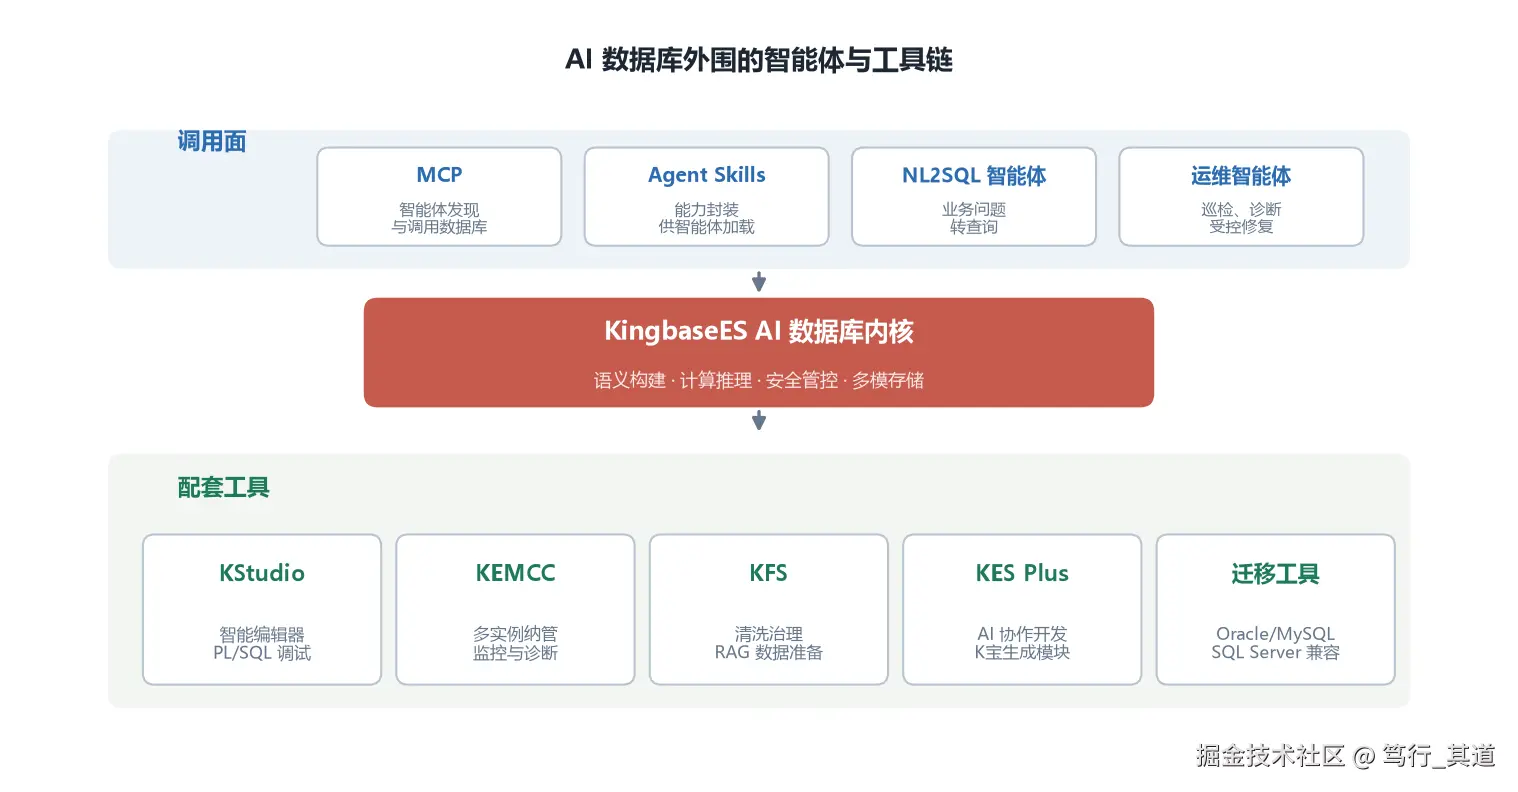
图:开发者大会分享里出现的智能体与工具结构。调用面一层是 MCP、Agent Skills、NL2SQL 智能体、运维智能体,中间是提供语义构建、计算推理、安全管控、多模存储的数据库内核,下面一层是 KStudio、KEMCC、KFS、KES Plus 和迁移工具,分别负责编辑调试、实例纳管、数据加工、协作开发与兼容迁移。
内核底座和兼容侧没有停
内核能力与智能运维专场里,孙文奇介绍的存储特性包括 64 位事务号、原地更新、增量检查点、并行回放和透明压缩。64 位事务号解决长期运行系统的事务号回绕问题,原地更新降低更新操作的写放大,增量检查点缩短故障恢复时间,并行回放加快备库追平主库的速度,透明压缩管存储成本。尹强分享的计算引擎方向是 SQL 改写、执行计划稳定性、分组 Top-N 和批量数据处理。李翔介绍的 MAA 覆盖备份恢复、集群和跨中心容灾。迁移与开发专场里,李国节讲了 Oracle 从语法兼容走向业务语义与性能适配,黎鑫讲了 MySQL 和 SQL Server 的兼容新能力,海能达崔鹏串起了评估、迁移、校验、应用适配和测试割接的完整流程。
市场侧的公开数据包括发电行业数据库销量第一,医疗行业连续三年销量第一,关键领域连续六年销售套数第一,金兰组织成员超过 700 家,覆盖金融、能源、医疗、政务、交通。发布会同步启动了全球化战略,香港 ICO Limited 在大会上分享了当地项目的落地经验。发布会、开发者大会、官网产品页三个渠道给出的模块清单能对上,语义层、库内推理、安全管控、多模存储四个方向在材料里的表述一致,四层结构加在传统核心系统这个基本盘上。