作者:来自 Elastic Tommaso Teofili
Elasticsearch 现在在成本模型中将文档位数的权重提高至原来的三倍,因此 DiskBBQ 会先尝试预处理和更深层的重排序,再增加一个比特,使量化向量在保持相同召回率的同时维持较小的体积。
通过这个面向搜索 人工智能 的自主进度实践课程,亲自体验向量搜索。你现在就可以开始免费云试用,或在你的本地计算机上试用 Elastic。
Elasticsearch 中的自动校准现在能够在相同的召回率目标下,为 DiskBBQ 选择成本更低的向量量化方案。在我们的 11 个基准测试数据集中,没有任何分段最终采用 4 位对称编码。此外,其中三个数据集选择了预处理,而此前几乎从未出现过这种情况。还有几个之前需要两个文档比特的数据集,现在只需要一个。前 10 个结果的召回率变化保持在三个百分点以内;当查询扫描的聚类更少时,召回率保持不变或有所提高,其中一项基准测试最多提高了 11 个百分点。每次合并时,校准仍然只需一到两秒。
我们通过将成本模型中文档位数的权重提高至原来的三倍,并将预处理移入内层循环,实现了这一效果。这样,预处理会在扫描的每一步参与竞争,而不再作为后备方案在外层等待。召回率模型从未负责作出这一决策。它告诉我们哪些配置达到了要求。成本模型则从中选出最终采用的配置,因此,仅调整一个系数,就改变了我们 11 个数据集中多个数据集所选的编码,并彻底淘汰了 4 位编码。
召回率模型来自我们的第一篇博文,合并时的扫描流程则来自我们的第二篇博文。
DiskBBQ 的自动校准此前如何选择量化位数
简单回顾一下,每个候选配置都包含三个部分:
- 编码 ,表示为
(查询位数,文档位数):可以是(1,1)、(4,1)、(4, 2)、(4, 4) 或(7,7)。 - 重排序深度 (过采样因子):1.25、1.5、1.75、2.0、2.5 或
3.0。 - 是否在量化前对向量进行预处理。
之前的扫描流程会按照以下公式,对 30 种(编码,重排序深度/encoding, rerank depth)组合进行排序:
go
`成本 = 文档位数 + 1.3 × 重排序深度`AI代码解释1.3 这个权重是根据经验设定的。它让重排序深度的成本高于一个文档比特,因为过采样是每次查询都会产生的持续成本(每次搜索都要获取更多全精度向量并重新评分),而一个文档比特的成本主要在建立索引时支付一次。
该扫描流程会先关闭预处理,遍历整个排序列表。只有在没有任何配置达到召回率目标时,才会开启预处理,再次遍历该列表。
这带来了两个我们不太满意的副作用:
- 不同位数档位交错出现 。当文档位数的权重为 1,重排序深度范围为 1.25--3.0 时,重排序项最多可使成本相差
1.3 × 1.75 ≈ 2.3,超过一个文档比特的成本。因此,扫描流程会先尝试采用较浅重排序的 2 位编码,再尝试采用较深重排序的 1 位编码:
| Order | Encoding (q,d) | Rerank depth | Cost |
|---|---|---|---|
| ... | (·,1) | 2.0 | 3.600 |
| next | (4,2) | 1.25 | 3.625 |
| next | (4,2) | 1.5 | 3.950 |
| next | (·,1) | 2.5 | 4.250 |
| next | (4,2) | 1.75 | 4.275 |
| ... | (·,1) | 3.0 | 4.900 |
只要采用较浅重排序的 2 位编码足以达到要求,我们就会直接采用文档位数翻倍的方案,而没有先检查使用一个比特并稍微加深重排序是否也能达到要求。
- 预处理是最后的手段。由于预处理位于外层循环,只有在所有未经预处理的配置(最高包括重排序深度为 3.0 倍的
(7,7))_都无法_达到目标时,分段才会采用预处理。实际上,这种情况很少发生,因此预处理几乎从未被选中。即使预处理本可以让 1 位编码达到目标,扫描流程仍会选择体积大得多的未经预处理的编码,有时甚至是 4 位对称编码。
有何变化:最后才增加文档位数的扫描流程
新的扫描流程遵循一条规则:_在尝试完所有成本更低的方案之前,不增加每个文档的位数。_这意味着先尝试所有成本较低的非对称编码,遍历每种重排序深度_以及_开启和关闭预处理两种选项,然后再考虑成本更高的 4 位和 7 位对称编码。
只需两处小改动,就能实现这一点。
提高成本模型中文档位数的权重
成本函数现在为文档位数设置了明确的权重:
go
`成本 = 3.0 × 文档位数 + 1.3 × 重排序深度`AI代码解释可缩放矢量图形
为了避免不同位数档位交错出现,增加一个文档比特的成本必须高于重排序项可能产生的最大成本差:
markdown
`

1.  文档位数权重 > 重排序成本权重 ×(最大重排序深度 − 最小重排序深度)
2.               = 1.3 × (3.0 − 1.25) ≈ 2.28

4.  DOC_BITS_WEIGHT > RERANK_COST_WEIGHT × (max_rerank − min_rerank)
5.                 = 1.3 × (3.0 − 1.25) ≈ 2.28

`AI代码解释
可缩放矢量图形
现在,成本排序会按文档位数划分档位,而且这一顺序由公式本身保证;也就是说,所有 1 位配置都排在所有 2 位配置之前,所有 2 位配置都排在任何 4 位配置之前,依此类推。
将向量量化预处理移入内层循环
现在,我们不再完整执行两遍扫描,而是针对每个(编码,重排序深度)组合,分别尝试关闭和开启预处理,然后再尝试下一个成本更高的组合:
kotlin
`

1.  for (encoding, rerank_depth) in cost order:      # tiered by document bits
2.      for precondition in [false, true]:
3.          if predicted_recall@10 >= 0.9:
4.              return (encoding, rerank_depth, precondition)

`AI代码解释
现在,预处理会在扫描的每一步平等参与竞争。如果经过预处理的 1 位编码能够达到目标,我们就会选择它,而不是先增加位数。
下图展示了改动前后的完整扫描流程。每个单元格代表一个候选配置,按从左到右的顺序评估,第一个预测能够达到目标的配置胜出。改动前,2 位和 4 位候选配置穿插在 1 位候选配置之间,第一个经过预处理的候选配置直到第 31 步才出现。改动后,扫描流程会按顺序遍历各个位数档位,并从第 2 步开始尝试预处理:
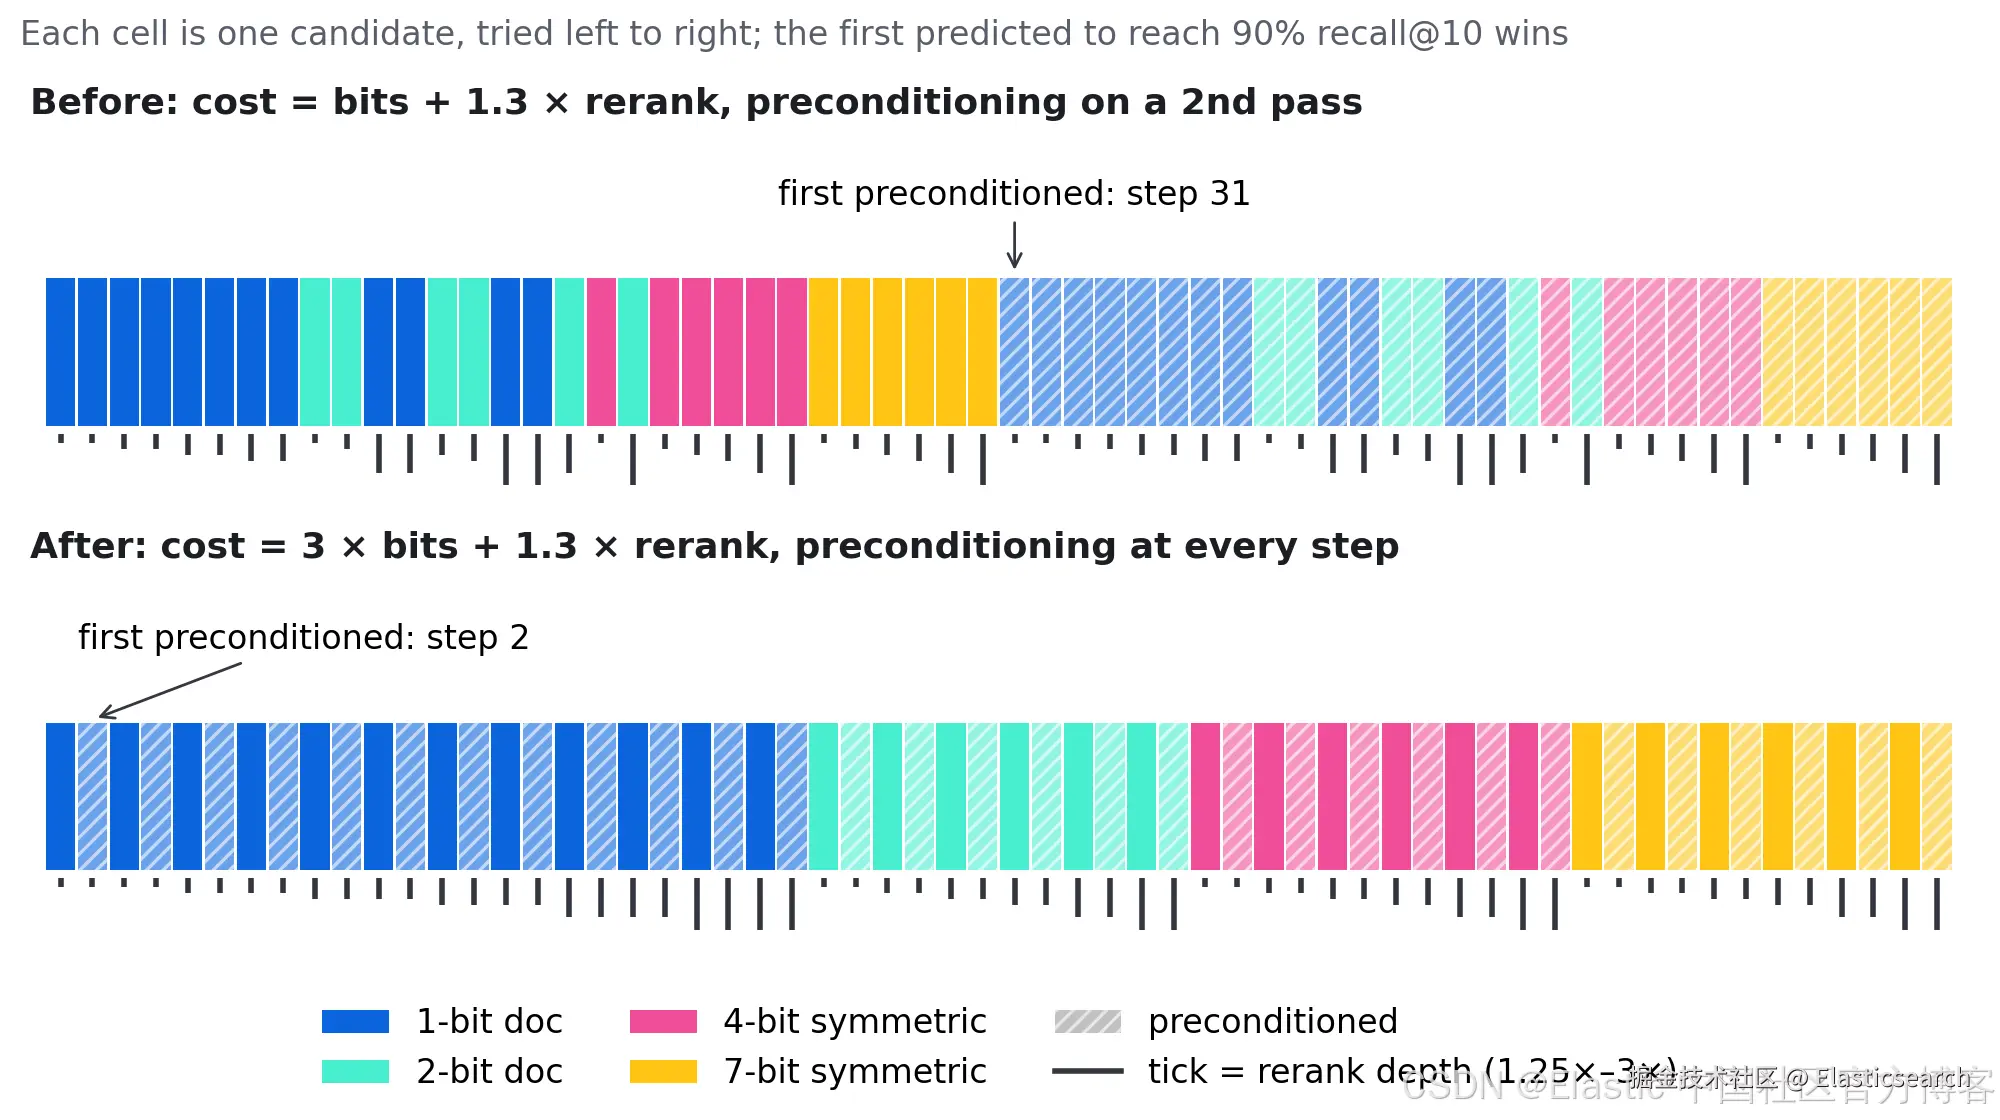
扫描流程可评估的候选配置总数保持不变(30 种组合 × 2 种预处理选项),因此最坏情况下的校准成本没有变化。由于现在更常能在成本较低的档位中找到满足要求的配置,扫描流程往往会更早停止。
为什么增加量化位数的成本高于加深重排序?
在上一篇文章中,我们认为重排序深度的成本权重应该高于一个文档比特,因为重排序是每次查询都会产生的持续成本,而比特的成本主要在建立索引时支付一次。这个观点在同一档位_内_仍然成立;对于给定的编码,扫描流程仍会先尝试最浅的重排序。我们重新考量的是不同档位_之间_的相对成本。
文档位数是每个分段持续承担的成本。它决定了量化向量在磁盘上的大小,而对 DiskBBQ 更重要的是,它还决定了将扫描涉及的倒排列表保留在页缓存中所需的内存量。理论上,对于分段中的每个向量,在分段的整个存续期间,文档位数从一位增加到两位会使这部分占用翻倍,改用 4 位对称编码则会使其增至四倍。(不过,实际成本增幅更有限;例如,每个维度从一位增加到两位时,磁盘占用约增加 7%,内存占用约增至 1.8 倍。)稍微加深重排序,或增加一个成本较低的预处理步骤,就能达到相同的召回率,无须永久增大索引。
尤其是预处理,性价比很高。它通过将方差更均匀地分散到各个维度来减少量化误差。它不会改变量化向量的大小,查询时的成本也只是对查询向量进行一次变换。将它作为最后的手段,让这部分优化空间一直未得到利用。
自动校准现在为 11 个基准测试数据集选择了哪些配置
我们在基准测试套件上重新运行了校准,并将之前选出的配置与新扫描流程选出的配置进行了比较:
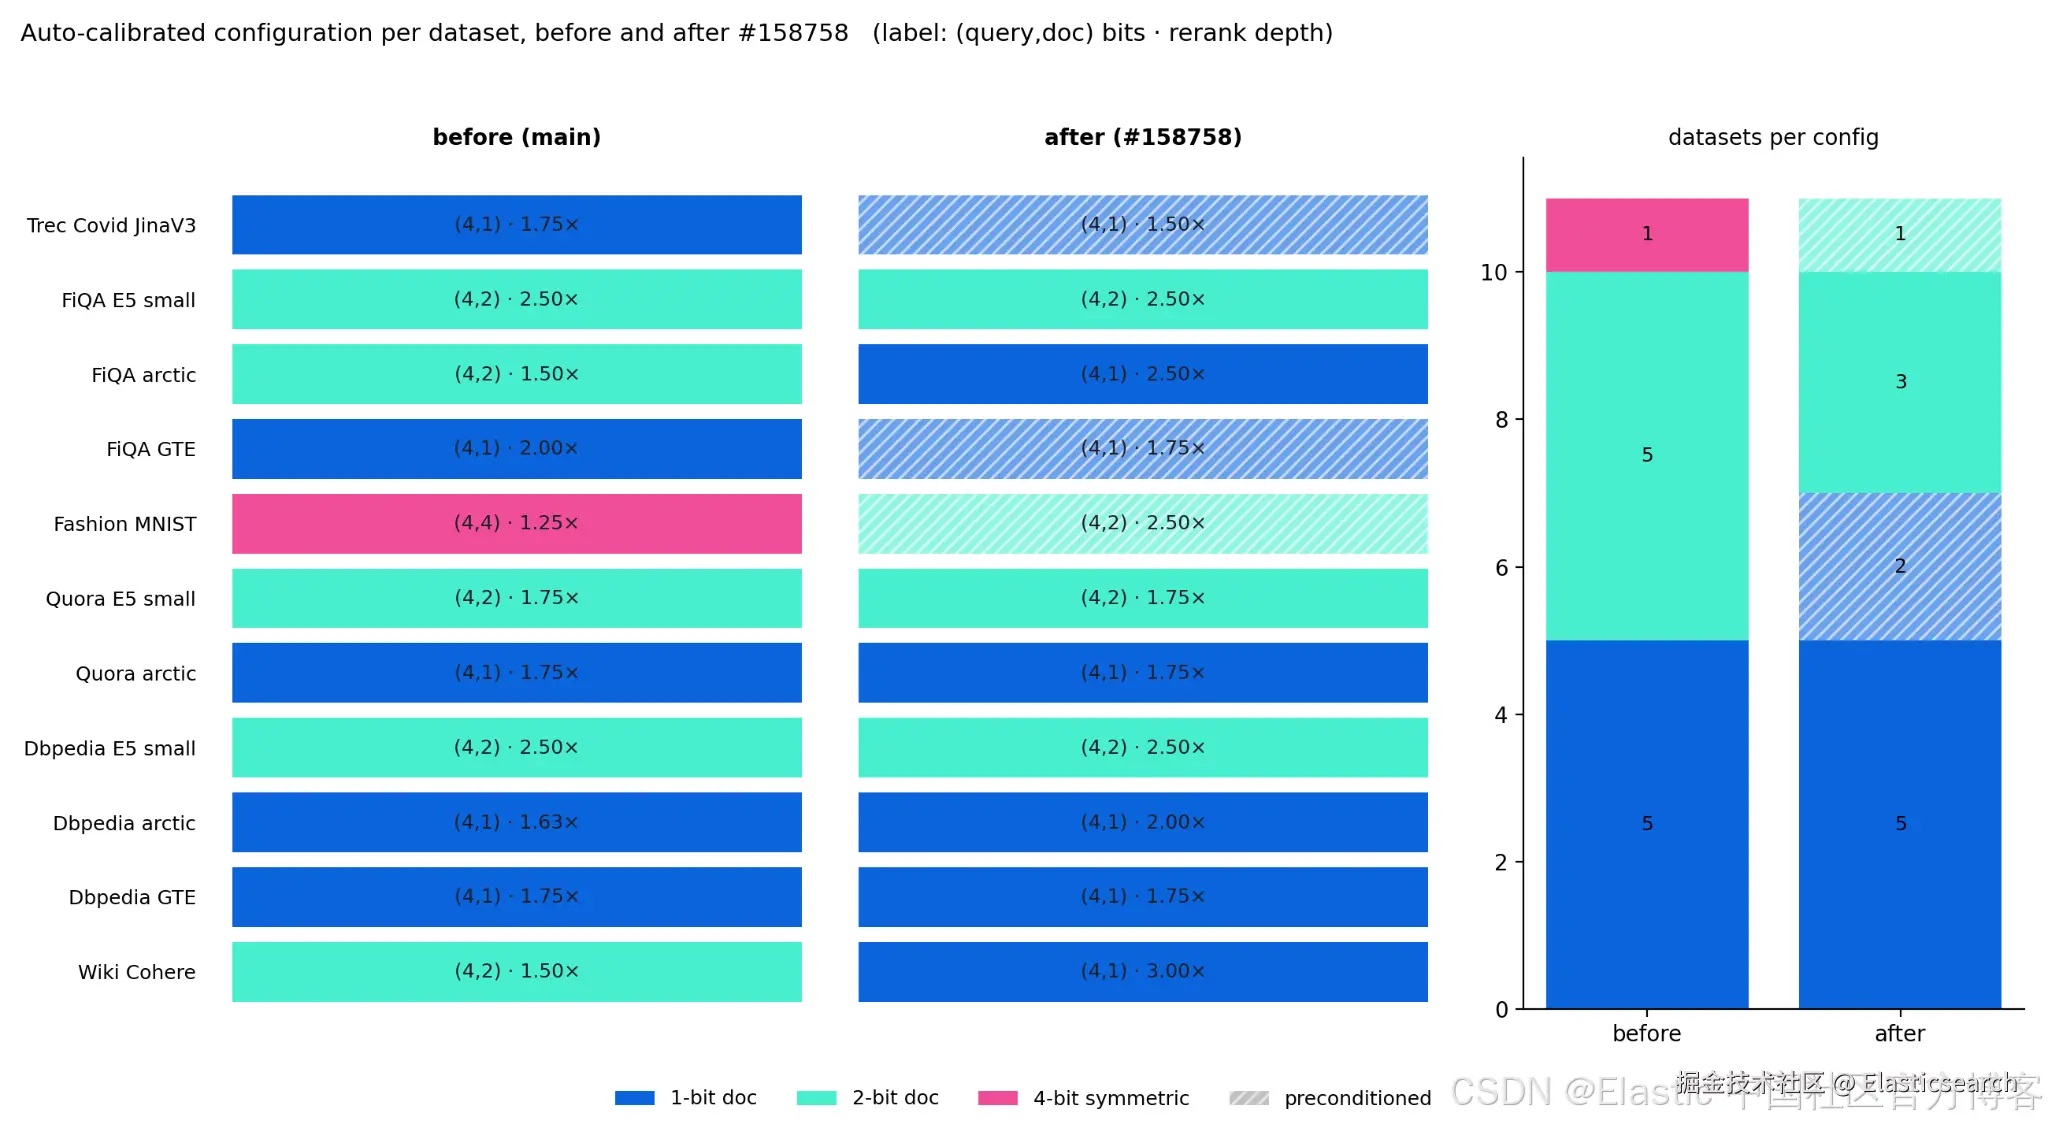
变化很明显:
- 预处理开始被选中。现在,11 个数据集中有三个选择了预处理,而此前几乎从未选中过。
- 不再采用 4 位对称编码 。引入预处理后,之前需要
(4,4)的数据集现在用更少的文档位数就能达到目标。 - 2 位编码减少,1 位编码增多 。之前采用
(4,2)的几个数据集,现在采用了结合预处理和/或更深重排序的 1 位非对称编码。
这些变化都缩小了量化向量的体积;文档位数从两位降至一位,体积就减半;从 (4,4) 改为 1 位编码,体积则缩小至原来的四分之一。
自动校准会拖慢合并吗?
新的扫描流程在确定配置前会评估更多候选配置,但各项指标几乎没有变化:
- 校准时间。**每次合并仍然只需一到两秒。新增工作耗时不到一秒。
- 索引构建和合并时间。没有可测量的变化。
- 配置保持不变时的召回率(涵盖大多数基准测试)。保持不变。
- 配置发生变化时的召回率。遍历所有聚类时,前 10 个结果的召回率升降幅度均不超过三个百分点。
- 访问预算较低时的召回率。保持不变或有所提高,其中一项基准测试最多提高了 11 个百分点。
如何在 bbq_disk 字段上启用自动校准
无须进行任何更改。如果你已经在 bbq_disk 字段上启用了自动校准,新合并生成的分段就会自动采用新的扫描流程。所选编码、重排序深度和预处理标志仍会像以前一样存储在每个分段的元数据中,因此现有分段会保留原有配置,直到参与合并。
auto_calibrate 默认设置的下一步
这次代码改动很小,却体现了我们对自动配置的思考方式。召回率模型告诉我们哪些配置_足以满足要求_。成本模型则体现了我们在这些满足要求的选项中_看重什么_。当这种偏好被明确表达出来时,就更容易理解和改进。
更保守的扫描流程,是迈向默认启用 auto_calibrate 的一步。
原文:Vector quantization: Zero 4-bit encodings across 11 datasets | Elasticsearch Labs