美团正式开源 LongCat-2.5,采用MIT协议,支持商用推理部署与二次训练,无需额外授权。
模型开源 :huggingface.co/meituan-lon...
LongCat-2.5是面向长程智能体任务的原生多模态模型,在复杂代码库开发、完整项目构建、Visual Coding 与专业办公场景中,端到端交付能力均有明显提升。模型总参数 1.6 万亿,每个 token 激活约 480 亿参数,支持一百万上下文。针对显存与带宽受限的国产算力芯片,我们在模型架构、芯片适配与部署策略上也进行了深度协同优化。
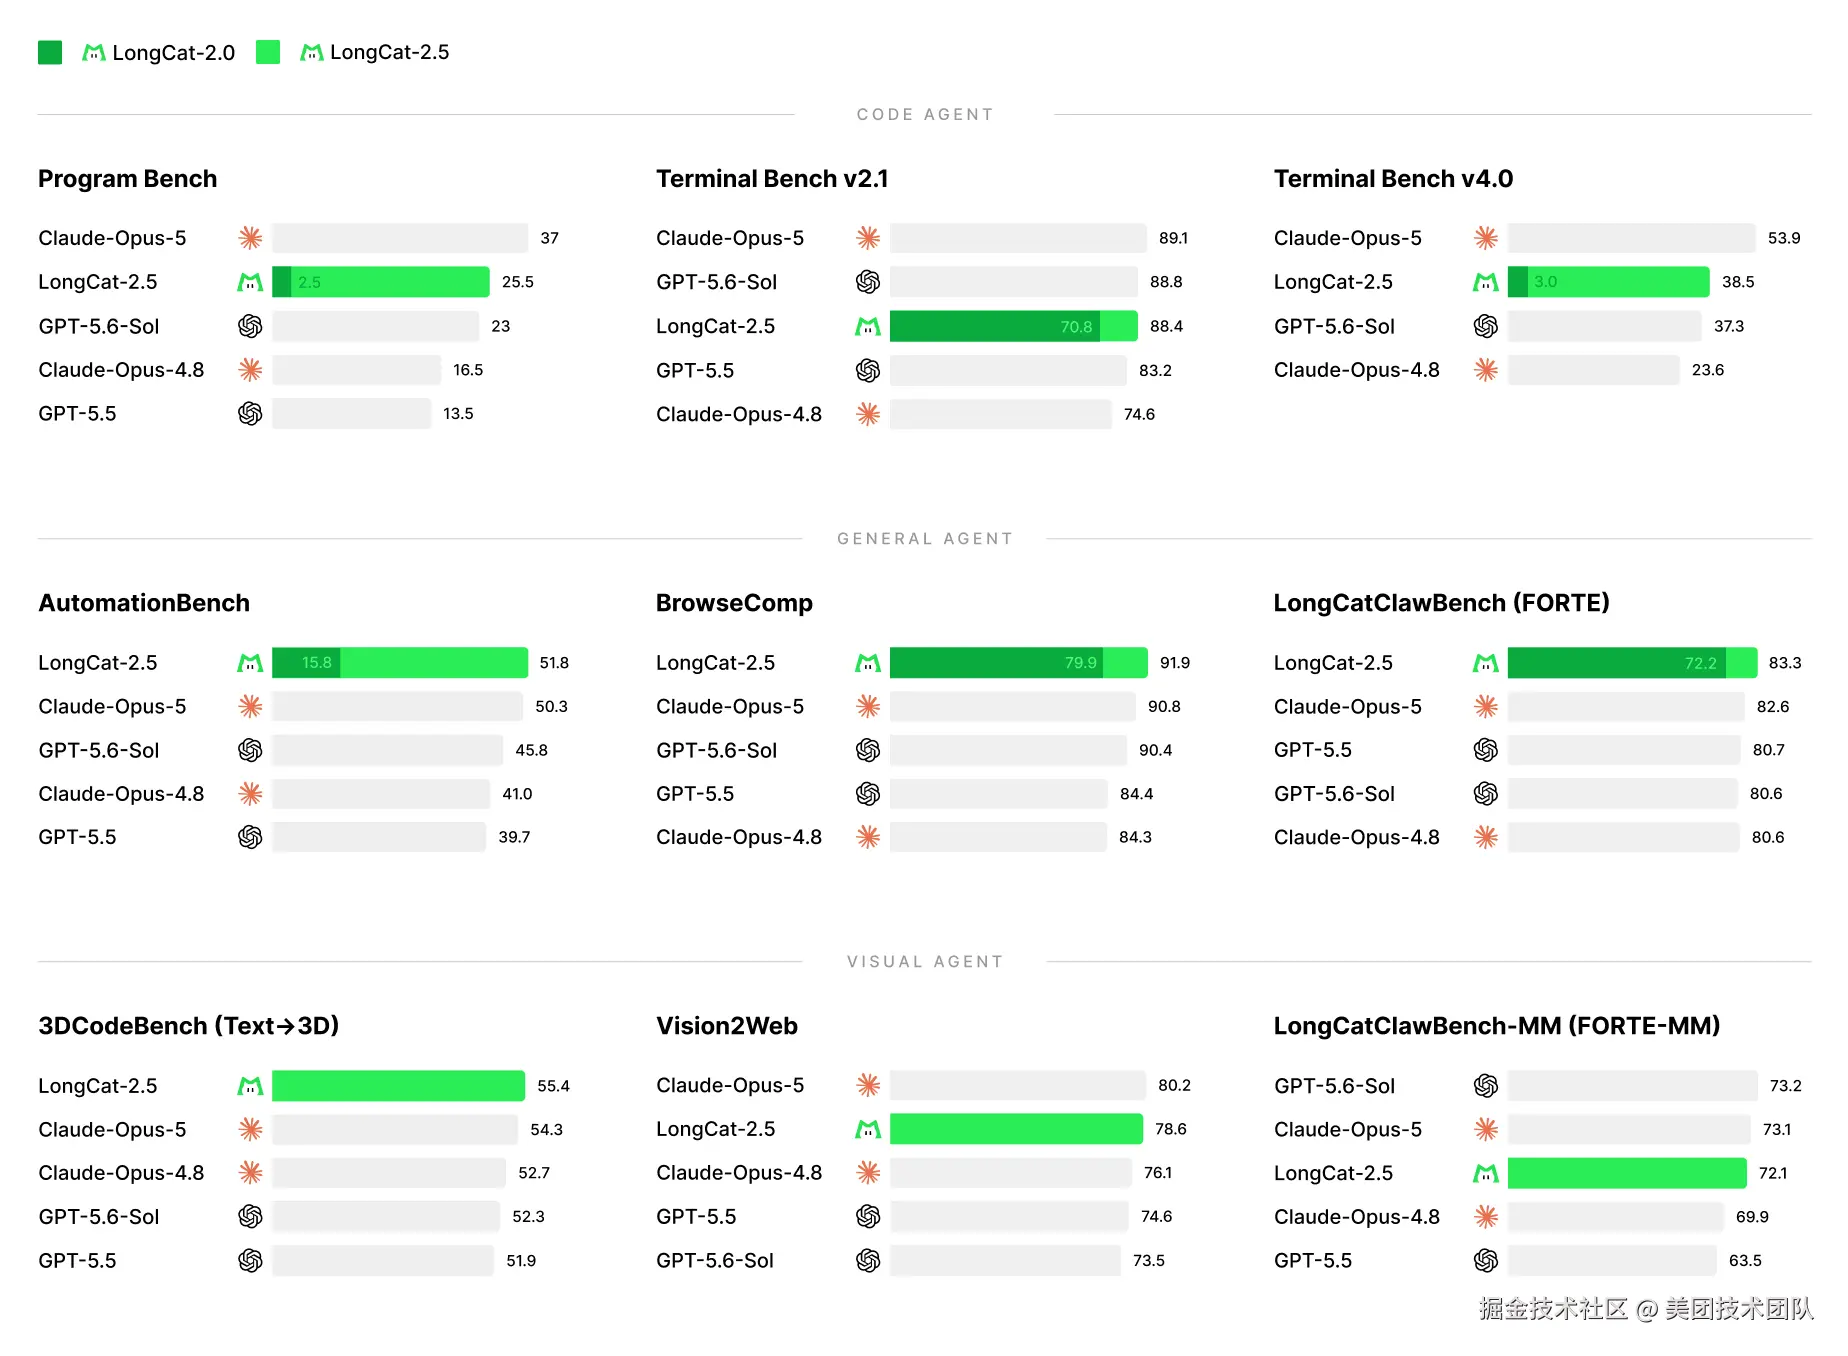
完整分数与评测条件参见技术博客
01 代码与长程智能体
LongCat-2.5 的长程能力提升,来自一整条训练链路的扩展,而非单点改动。这些设计不改变模型能力的定义,但让能力在长任务中稳定发挥。
第一,更贴近真实长程任务的训练数据。加入更多长程轨迹,并把真实 Agent 的失败轨迹转为可复现、可验证的训练任务。
第二,更适配长任务节奏的强化学习。采用partial rollout 异步训练,让未跑完的长任务保存后续跑;过采样率按通过率动态调整,过滤全对全错的样本组;对跨 checkpoint 的旧轨迹做梯度校正,降低陈旧偏差。
第三,更有效减少"钻空子"的训练约束。任务环境断网、清除 git 历史与文件缓存,以 LLM judge 监督轨迹;对重复思考、重复工具调用、过度思考施加约束,让模型专注完成任务。
查看开发者们的端到端测评示例,可帮助大家观察模型在真实使用流程中的表现。
02 Visual Coding 与 3D
LongCat-2.5 在 Visual Coding 上表现出色,支持创意设计、3D 等任务。这些能力提升来自视觉表征层的改造:模型将视觉信号表示为多层级离散 token,与文本一样由主干模型统一处理,而非外挂视觉模块。具体而言,模型对原生分辨率视觉特征做残差向量量化,逐级补足细节;视觉 token 可离线预计算并缓存,减少在线计算量,也让分布式训练负载更均衡;视觉码本与主干联合训练,视觉与文本共享同一套主干参数,在同一语义空间内协同完成视觉理解与代码生成。
查看开发者们的端到端测评示例,可帮助大家观察模型在真实使用流程中的表现。
03 专业办公与商业分析
专业办公场景对模型的要求,不是单点问答,而是同时完成几件事:读得多份材料,抓得住关键信息,形成专业判断,并把判断转化为规范、可用的交付物。LongCat-2.5 在这个场景的提升也围绕这条链路展开:材料处理更稳,专业判断更贴近分析人员,报告、演示文稿和办公工具能够端到端交付,多轮任务执行更可靠。目标不是为每个场景单独建模,而是让主线模型具备端到端完成专业办公任务的能力。
支撑这些提升的,是一组相互配合的技术设计。多专家在线教学负责将领域能力融入主线模型:学生先自主作答,专家再通过全词表 KL 散度纠正其概率分布;教师回复按固定长度切分以控制分布偏移;采样时共享 prefill 与 KV cache;训练时使用 Tree Attention,通过单次前传和反传处理同组样本。大规模智能体强化学习提升长程执行与工具调用能力,跨任务、跨 Scaffold 的混合训练增强泛化;原生视觉理解支撑 PPT 与报告中的视觉内容生成,长上下文 rollout 优化支撑长程强化学习的高效运行。
点击查看 LongCat-2.5 端到端生成的真实演示。
04 高效推理
推理效率是模型能否真正落地的关键。LongCat-2.5 采用 W4A4 高效推理方案,将专家权重与激活同时量化到 4 bit,并通过原生 INT4 矩阵乘法单元执行计算。
精度方面,我们以 FlatQuant 的可学习等价变换为基础优化 MoE 量化精度,已评测的下游任务表现与量化前保持相当。算子与数据路径方面,专家共享输入变换,在 token 复制与分发前完成量化,使同一份 INT4 表示贯穿专家通信与计算;变换、尺度计算、量化与打包融合为专用算子,并结合权重布局与转置访问优化,减少数据搬运与转换开销。系统层面,针对 Prefill 偏重批量计算、Decode 偏重逐 token 推进与通信的特点,分别优化计算与通信的流水重叠,减少互相等待。W4A4让 LongCat-2.5 在保持下游任务表现的同时降低推理成本,为 1.6 万亿级 MoE 模型的开源部署提供了可用的效率基础。
05 国产算力
LongCat-2.5 在训练与监督微调阶段均采用长序列训练。国产算力环境下,单卡显存不足 80GB,是长序列训练与微调必须面对的现实约束。
我们以分片将显存压力分散至超节点内多卡,以拓扑感知的并行策略降低跨节点通信开销,并让通信与计算尽可能重叠。具体而言,FSDP 双重分片与扁平化缓冲区降低常驻显存与峰值显存;混合词表并行进一步压缩显存占用;参数 AllGather、专家 token AllToAll 与 KV AllGather 尽量在超节点内高带宽互联域完成;MoonEP 动态专家复制仅在负载不均衡达到阈值时启用,避免额外通信开销超过收益;零拷贝通信、参数预取与 ScMoE 则使通信与计算重叠执行。
这套方案的工程价值在于:在单卡显存不足 80 GB 的国产 AI 加速器上实现了长序列训练与微调;多卡扩展时,通信开销与负载不均衡也有对应机制支撑。该 FSDP 配置在长序列 SFT 任务中的单卡吞吐量较 DDP 基线提升 86%,表明长序列训练在国产算力上不仅可行,而且高效,为社区复现与二次开发提供了一条可参考的基础设施路径。
06 开源开放
LongCat-2.5 以 MIT 协议开源,支持商用推理部署与二次训练,无需额外授权。我们之所以选择这一协议,是因为希望模型能被自由使用、修改与再分发,也便于社区在此基础上继续工作。
国产算力是我们长期投入的方向,也是持续创新的现场。显存与带宽的边界实际存在,我们能改变的只有架构、算子与并行策略,改动在细处,进展在实处。在单卡显存不足 80GB 的条件下承载万亿参数 MoE,需要在架构、量化、并行与通信之间反复取舍。这些取舍是与产业伙伴一同完成的,也让我们对这条路径有了更具体的判断。
生态的成熟,很少来自单点的突破。它需要真实负载的持续检验,需要芯片、框架与应用在同一处磨合,也需要有人愿意把最难的任务先放上去。我们会继续开放模型与工程经验,与同行一起,把这条路走宽。
- 模型开源 :huggingface.co/meituan-lon...
- 技术博客 :longcat.ai/blog/longca...
- API平台 :longcat.chat/platform/pr...
| 关注「美团技术团队」微信公众号(meituantech)或访问:tech.meituan.com/,阅读更多技术干货!
| 本文系美团技术团队出品,著作权归属美团。欢迎出于分享和交流等非商业目的转载或使用本文内容,敬请注明"内容转载自美团技术团队"。本文未经许可,不得进行商业性转载或者使用。任何商用行为,请发送邮件至 tech@meituan.com 申请授权。