你的 AI 知识库为什么答非所问?问题出在"切块"这一刀
 你有没有遇到过这种情况?
公司花了大力气搭知识库,接上大模型。结果一问具体问题,AI 要么答非所问,要么说"没找到"。
文档明明就在库里。
Anthropic 的工程团队最近公开了一套方法,叫 Contextual Retrieval(上下文检索) 。他们的实测结果是:检索失败率最多可降低67%。
下面用大白话讲清楚。
↗一、先说个前提:不一定非要 RAG
Anthropic 先给了个很实在的建议。
如果你的知识库小于20万 token(约500页材料),直接把全部内容塞进提示词就行,不用 RAG。
配合 Claude 的提示缓存(prompt caching),延迟可降低2倍以上,成本最多降低90%。
只有知识库大到塞不下,才需要 RAG。
↗二、传统 RAG,问题出在哪?
先快速回顾 RAG 的做法:
1→
把文档切成小块(通常几百 token)
2→
用嵌入模型把每块转成向量
3→
存进向量数据库
4→
用户提问时,找出语义最相近的块,喂给大模型
很多团队还会加上 BM25。它是一种关键词匹配算法,擅长找精确词。
比如用户搜"Error code TS-999",向量检索可能只找到一堆"错误码"相关内容,而 BM25 能精准命中"TS-999"这个字符串。
两者结合,效果比单用向量更好。
但有个老毛病,谁也绕不开:切块会丢掉上下文。
↗三、一个典型的翻车现场
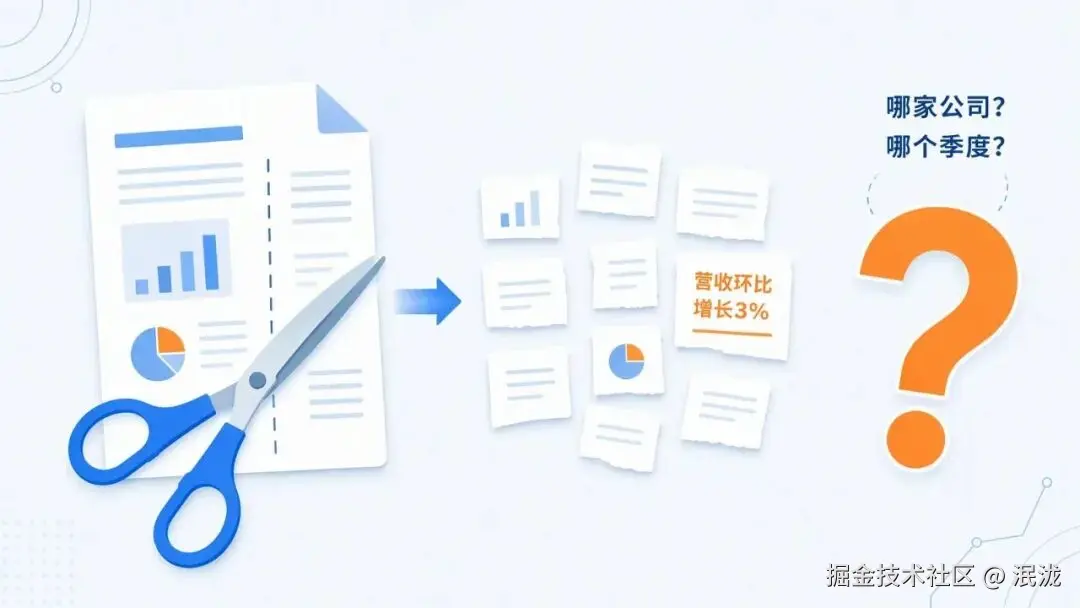 假设知识库里存的是一堆公司财报。用户问:
"ACME 公司2023年第二季度的营收增长是多少?"
库里有这样一个文本块:
"公司营收环比增长了3%。"
问题来了:哪家公司?哪个季度?
这个块自己根本没说。检索系统很难判断它是不是你要的答案。就算检索到了,模型也不敢用。
这就是"上下文被切没了"的代价。
↗四、解法:给每个块,先补一句"背景介绍"
Contextual Retrieval 的思路简单到有点朴素:
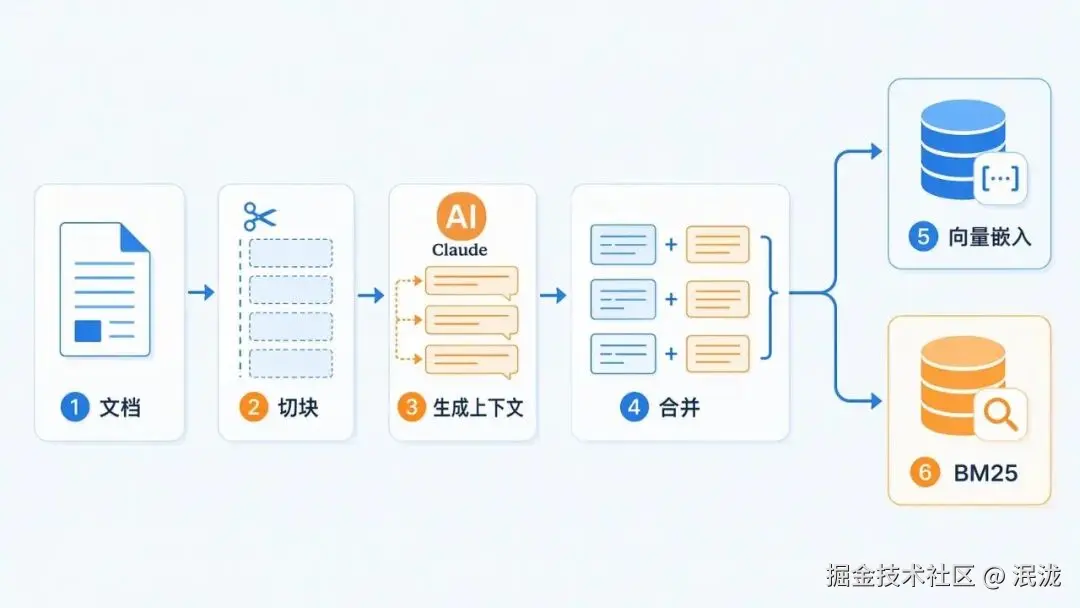
在切块之后、做嵌入之前,先给每个块前面加上一小段说明,交代它来自哪里、讲什么。
比如上面那个块,会变成类似这样:
"这段来自 ACME 公司2023年 Q2的 SEC 财报;上一季度营收为3.14亿美元。公司营收环比增长了3%。"
(这里是对原文示例的意译,仅作说明。)
这样一来,无论是向量检索还是关键词检索,这个块都带上了"身份信息"。
对应两个子技术:
→
Contextual Embeddings:带背景的向量嵌入
→
Contextual BM25:带背景的关键词索引
↗五、几千万个块,谁来写背景?
当然不可能人工去写。
Anthropic 的做法是让 Claude(文中用的是 Claude 3 Haiku)来写。给它整篇文档和当前这个块,让它生成一段简短的、针对该块的背景说明。
每段背景通常只有 50~100 个 token。
你可能会问:每个块都要把整篇文档喂一遍,不是很贵?
这里提示缓存就派上用场了。文档只需要加载进缓存一次,后面每个块直接引用。
按文中的假设(800 token 的块、8k token 的文档),一次性生成上下文的成本约为每百万文档 token 1.02 美元。
对于一次预处理、长期受益的事,这个价格相当友好。
↗六、效果到底怎么样?
Anthropic 在代码库、小说、ArXiv 论文、科学论文等多个领域做了测试,指标是 1 减去 recall@20,也就是"前20个块里没能捞出相关内容的比例"。
结论很清晰:
→
上下文嵌入 + 上下文 BM25:失败率降低 49%
→
再加上重排序(Reranking) :失败率降低 67%(从 5.7% 降到 1.9%)
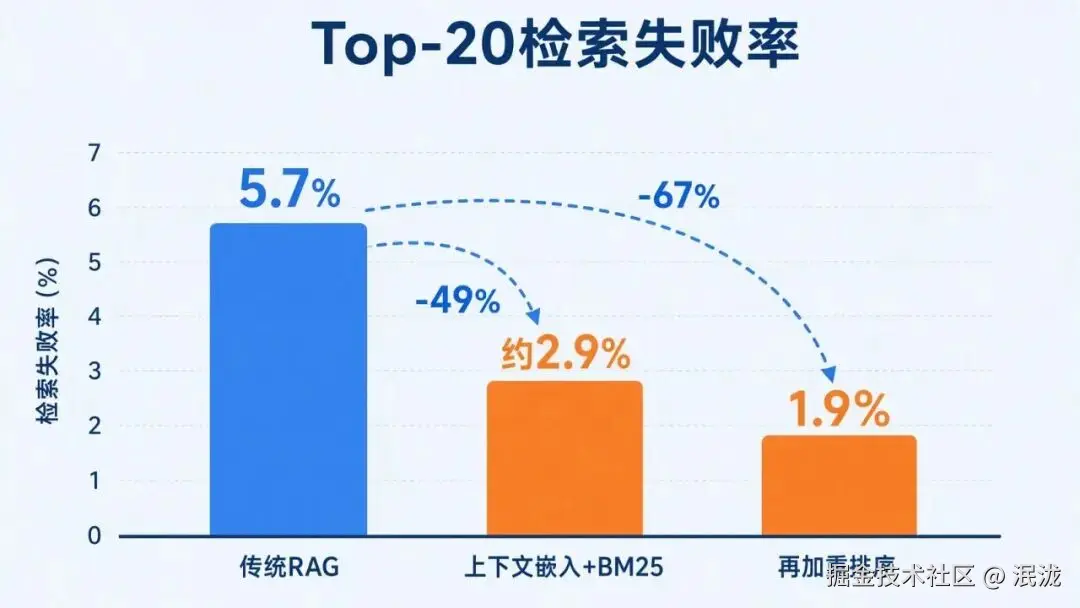 注:图中"约2.9%"由 5.7% 与 49% 的降幅推算得出,为估算值,非原文直接给出的数字。
重排序是什么?
初步检索会返回很多块(文中取前150个),质量参差不齐。重排序模型会根据与问题的相关度给每个块打分,再挑出最好的20个交给大模型。
好处是回答更准,同时因为模型要读的内容更少,成本和延迟也会降下来。不过它会多一步运行时开销,需要自己权衡。
↗七、落地时要注意这4点
Anthropic 也给了几条实践建议:
1→
块怎么切很重要:块大小、边界、重叠,都会影响效果
2→
嵌入模型要选:他们测试中 Gemini 和 Voyage 表现最好
3→
可以定制背景提示词:比如针对你的领域,加入专业术语表
4→
块的数量:他们试了5、10、20个,20个效果最好,但要结合自己场景测试
还有一句话值得记住:Always run evals(一定要跑评测)。
别人的结论,不等于你的数据上的结论。
↗八、一句话总结
Anthropic 实验总结的几条结论,可以直接当作清单:
→
嵌入 + BM25,比单用嵌入好
→
给块加上下文,提升很大
→
加重排序,效果更好
→
传给模型20个块,比10个、5个更有效
→
以上收益可以叠加
如果你正在做企业知识库、客服机器人或法律、财务问答,别急着换模型、调参数。
先看看你的文本块,是不是"没头没尾"。
· · ·
互动一下: 你的 RAG 系统,遇到过哪些"明明有却搜不到"的情况?欢迎留言聊聊。觉得有用,点个"在看"转给做 AI 应用的朋友。
原文来源:Anthropic Engineering,《Contextual Retrieval》,作者 Daniel Ford. www.anthropic.com/engineering...