一、背景:我在做什么
目标是在单节点集群(kubeadm 部署,节点名 k8s-master)上做一次完整的 etcd 快照备份与恢复演练,流程如下:
- 创建测试命名空间和资源
etcdctl snapshot save做快照- 删除测试资源模拟故障
- 停掉 etcd
etcdctl snapshot restore恢复- 验证数据回来
演练顺利走到了第 3 步,然后卡死在了第 4 步------etcd 停不下来。
二、现象:三个诡异的问题
现象 1:docker stop 之后,etcd 自己又活了
js
docker stop <etcd-container-id>
# 等 30 秒
docker ps | grep etcd   # 又出现了,而且容器 ID 变了
现象 2:把 etcd.yaml 移走,容器依然存活
js
mv /etc/kubernetes/manifests/etcd.yaml /etc/kubernetes/manifests/etcd.yaml.bak
sleep 30
docker ps | grep etcd   # 还在跑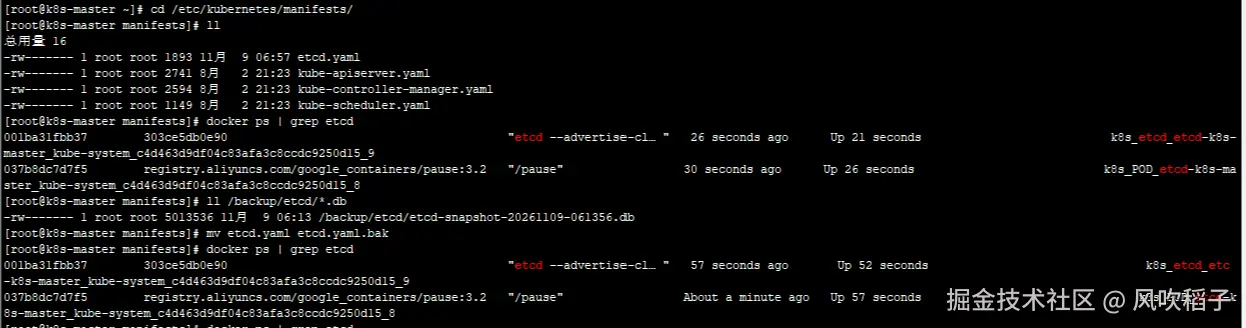
按官方文档,静态 Pod 的清单文件删除后,kubelet 应该自动清理对应的 Pod。但这里没有。
现象 3:改用 rm 之后,日志开始疯狂爆炸
js
rm /etc/kubernetes/manifests/etcd.yaml
journalctl -u kubelet -f
输出刷屏:
js
E1109 06:59:01 kubelet[36304] mirror_client.go:132]
Failed deleting a mirror pod "etcd-k8s-master_kube-system":
Delete https://192.168.10.100:6443/api/v1/namespaces/kube-system/pods/etcd-k8s-master:
read tcp 192.168.10.100:36152->192.168.10.100:6443: use of closed network connection
每隔 10 秒一条,无限循环。
三、逐个击破
问题 1 解释:静态 Pod 的自动重启是设计行为
这个最简单,先排除掉。
静态 Pod 的 RestartPolicy 固定为 Always 且不可修改 。容器非正常退出后,kubelet 的 podSync 循环会检测到"容器状态与期望不符",于是重新 CreateContainer。
所以链路是:
js
docker stop → 容器退出 → CRI 上报事件
→ kubelet podSync 发现容器非预期终止
→ 查内存 staticPods 里还有 etcd-k8s-master
→ 重新创建容器
结论:这不是 bug,docker stop 只能"临时"停掉静态 Pod。
验证手段:
js
# 看重启计数
docker ps -a | grep etcd

# 看 kubelet 的重建记录
journalctl -u kubelet --since "5 min ago" | grep -i -E "etcd|static"
问题 2 解释:mv 和 rm 触发的文件事件不一样
这是第一个真正的坑。
kubelet 的静态 Pod 管理器通过 fsnotify(inotify) 监听 staticPodPath 目录,代码里处理的事件是:
| 文件事件 | kubelet 动作 |
|---|---|
fsnotify.Create |
podAdd |
fsnotify.Write |
podModify |
fsnotify.Remove |
podDelete |
而 mv a.yaml a.yaml.bak 触发的是 IN_MOVED_FROM / rename 事件 ,不是 IN_DELETE。在某些版本/环境下,这个事件不会被翻译成 podDelete。
所以 kubelet 根本没意识到"这个 Pod 该被删了",容器自然继续跑。
经验 :想通过清单文件停掉静态 Pod,必须用
rm,不能用mv做"备份式移走"。
顺带排查掉的两个伪原因:
js
# 1. 监听目录对不对
grep -i -E "staticPodPath|fileCheckFrequency" /var/lib/kubelet/config.yaml

# 2. 检查频率是不是被改大了
systemctl cat kubelet | grep -i "file-check"第二条命令没有输出 ------但这不是原因。没显式设置意味着使用默认值 --file-check-frequency=20s,等了 30 秒以上早该生效了。
踩坑提醒 :
systemctl cat没输出 ≠ 参数没生效,很可能是走了默认值。别把"没配置"当成"配置有问题"。
问题 3 解释:这才是真正的死锁
rm 之后日志爆炸,说明 kubelet 已经检测到文件删除了 (它进入了 Failed deleting a mirror pod 这一步),但删不掉。
为什么删不掉?因为静态 Pod 在 API Server 里有一个对应的 mirror pod(镜像 Pod) 。kubelet 清理静态 Pod 的完整流程是:
js
检测到清单文件删除
→ 调用 API Server: DELETE /api/v1/namespaces/kube-system/pods/etcd-k8s-master
→ 等 API Server 确认删除
→ 才停止本地容器
而错误信息是:
js
read tcp 192.168.10.100:36152->192.168.10.100:6443: use of closed network connection注意是 use of closed network connection,不是 connection refused。区别在于:
connection refused:端口没人监听,服务没起来use of closed network connection:连接已经被对端主动关闭,说明 API Server 在响应过程中崩溃/退出了
API Server 为什么挂? 因为 API Server 强依赖 etcd 存储数据。前面反复 docker stop etcd、mv 清单文件,导致 etcd 状态异常,API Server 连不上 etcd 就崩了。
于是形成死锁闭环:
js
删 etcd.yaml
→ kubelet 要删 mirror pod
→ 需要调 API Server
→ API Server 因为 etcd 异常已崩溃
→ 删除失败,10 秒后重试
→ 日志风暴,容器停不下来
核心结论:不是 inotify 坏了,不是 kubelet 没感知,而是控制面组件互相依赖导致的循环阻塞。
四、破局方法
死锁的破局思路只有一条:先恢复通信,再执行删除。
第一步:放回清单文件,解开 kubelet 的删除执念
js
mv /etc/kubernetes/manifests/etcd.yaml.bak /etc/kubernetes/manifests/etcd.yamlkubelet 发现文件又在了,立刻停止重试删除,日志风暴停止。
第二步:重启 kubelet,重建状态机
js
systemctl restart kubelet补充一个之前踩过的坑:如果重启后看到
pods "etcd-k8s-master" already exists,说明 API Server 里残留着旧的 mirror pod 对象,而磁盘上清单文件当时不存在。这条日志反而证明 kubelet 已经不再认为 etcd 该存在,方向是对的。
第三步:验证控制面恢复
js
sleep 30
kubectl get ns
kubectl get pods -n kube-system | grep -E "etcd|apiserver"
能正常返回,说明死锁已破。
附:本次涉及的排查命令速查
js
# 静态 Pod 清单目录与检查频率
grep -i -E "staticPodPath|fileCheckFrequency" /var/lib/kubelet/config.yaml
systemctl cat kubelet | grep -i -E "ExecStart|file-check"

# inotify 资源与 watch 状态
cat /proc/sys/fs/inotify/max_user_watches
cat /proc/sys/inotify/max_user_instances
ls -l /proc/$(pgrep -x kubelet)/fd 2>/dev/null | grep -i manifest

# 容器与重启计数
docker ps -a | grep etcd

# kubelet 日志定向过滤
journalctl -u kubelet --since "10 min ago" | grep -i etcd | tail -30

# API Server 健康度
docker ps -a | grep apiserver
docker logs $(docker ps -aqf name=apiserver) --tail 20
总结原因:
-
mv etcd.yaml etcd.yaml.bak容器还在跑,触发的是IN_MOVED_FROM/ rename 事件 ,不是IN_DELETE。在某些版本/环境下,这个事件不会被翻译成podDelete。 所以 kubelet 根本没意识到"这个 Pod 该被删了",容器自然继续跑 -
删了
rm etcd.yaml容器还在跑,不是因为 kubelet 没看见,而是因为它看见了、想删、但 API Server 挂了删不掉------这是控制面循环依赖导致的死锁,破局的关键是"先恢复通信,再执行删除"
总结解决方案:
本次是在尝试rm etcd.yaml后,出现apiServer日志爆炸(文中有描述),然后又立马做了mv /backup/etcd/etcd.yaml /etc/kubernetes/manifests/etcd.yaml处理,之后日志爆炸停止,待检查集群状态都正常后,再次直接使用docker stop <container_id>,最终停止了etcd。
js
# 解决`docker stop`直接停止etcd,而不是再去折腾文件
使用 `docker stop etcd_container_id` 代替 `mv etcd.yaml etcd.yanl.bak`
使用 `docker stop etcd_container_id` 代替 `rm etcd.yaml`