技术栈:React + TypeScript + Tailwind / FastAPI + SQLite,前后端同仓,本地部署,数据不出校。
一、先看效果:从"通宵批卷"到"几分钟出一个班"
不铺垫,先看这套系统跑起来是什么样子,再讲为什么这么做。
登录后是工作台,一条完整的批改流水线被组织成左侧的几个模块: 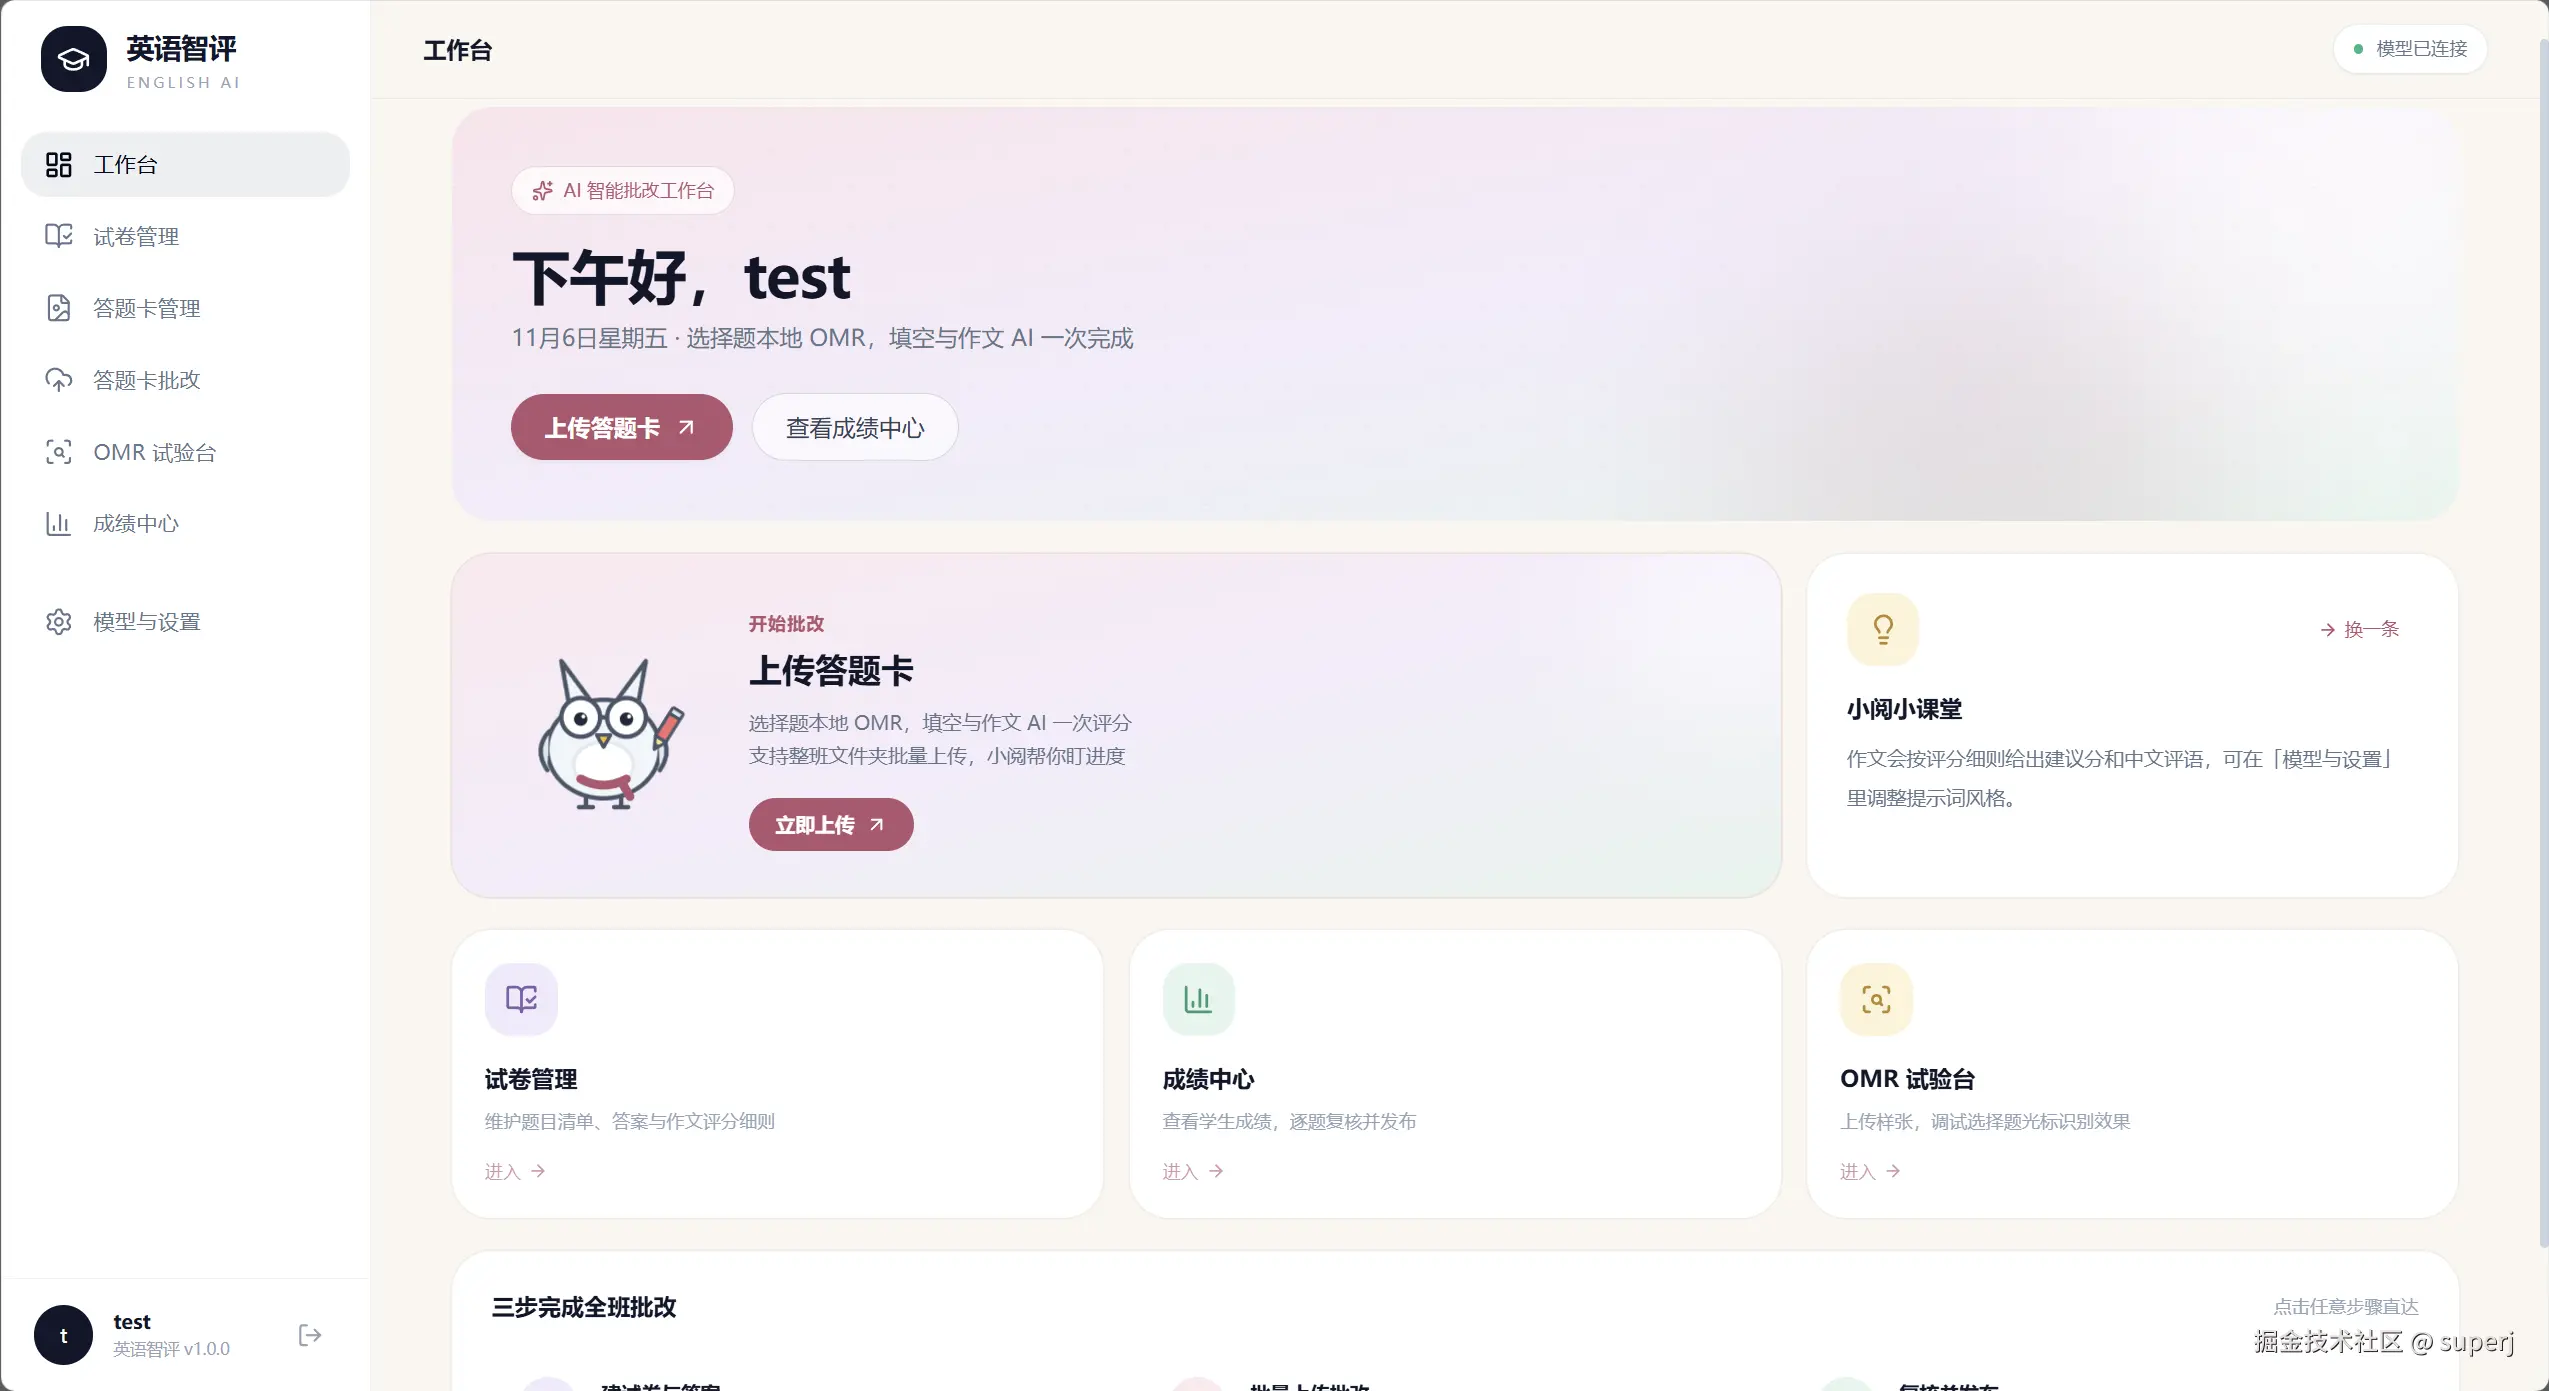 每个模块的职责一句话讲清:
- 试卷管理------录入题目清单(题号、题型、分值)、选择题标准答案、作文评分细则,也支持从文本文件宽松导入;
- 答题卡管理------导入答题卡模板(PDF/图片),自动检测四角定位标与气泡网格,可视化标定坐标,一个模板适配任意印刷版式;
- 答题卡批改------每位学生一个文件夹(文件夹名即姓名),整班拖入即自动归档、逐份逐页识别;
- OMR 试验台------上传样张单独调试选择题的光标识别参数,调准了再投入正式批改;
- 成绩中心------复核、发布成绩、导出 CSV;
- 模型与设置------AI 服务商、密钥、提示词全部在线配置,换服务商不改代码。
识别效果:重点看这张图
自动批改完成后进入成绩中心的复核视图,这是最能体现识别效果的一屏: 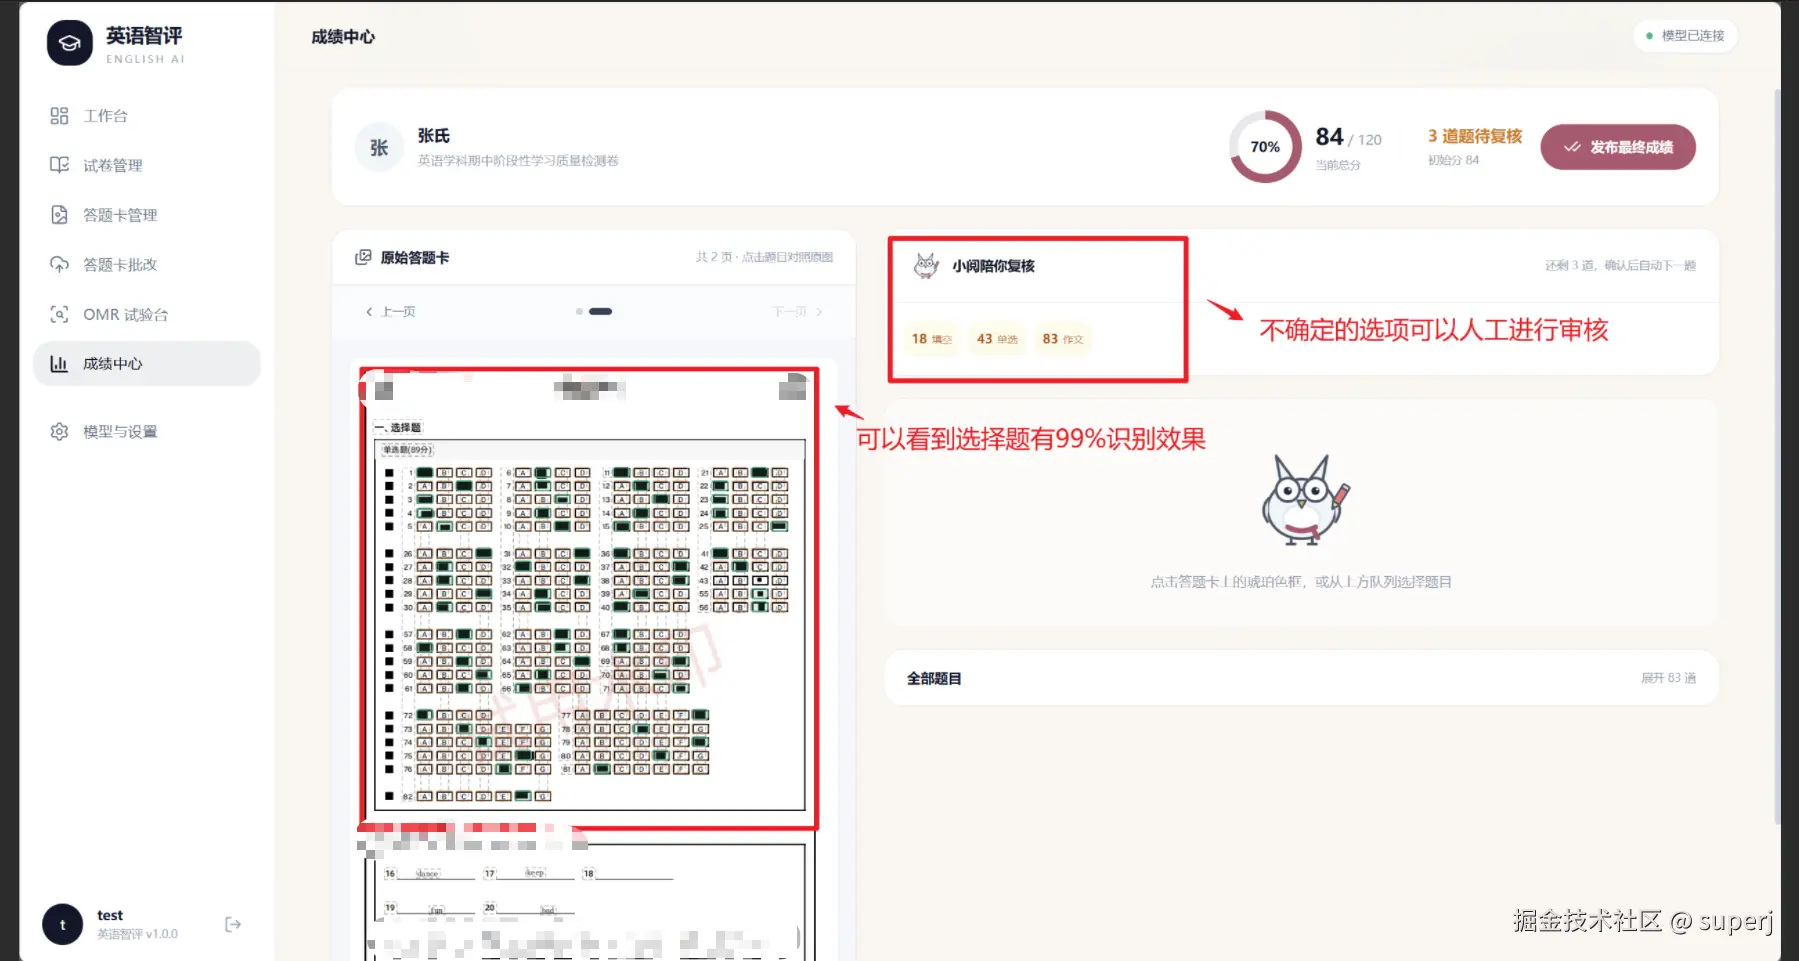 左半边是学生的答题卡原图,上面逐框叠加了每道选择题的判定标记------填涂、未填涂、存疑,一目了然。实测选择题识别准确率约 99%:图中这份卷子 84/120,整张卡 66 道选择题,系统只把 3 道题标记为"待复核"。而且这 3 道不是识别错了,而是它"知道自己不确定"------置信度不足、疑似改答案的双填涂、空答案,都会被诚实地举出来,而不是给出一个自信的错误答案。
右半边是复核队列:机器拿不准的题才需要人看,确认一道自动跳下一道。老师的注意力只花在那 3 道题上,而不是 66 道题上------这就是整套系统的价值:**机械判断零成本交给本地 OMR(整班几秒出结果,无 API 费用),模糊判断一次多模态调用交给大模型,最终判断留给人。**所有数据本地存储,不出校。
主观题:AI 作文批改同样可查可改
复核视图往下滑就是主观题部分。作文题由多模态大模型完成三件事:把学生手写原文忠实转写 成文字、按评分细则给出分数 、逐条列出扣分点 (哪里拼错了、哪里语法不对、怎么改): 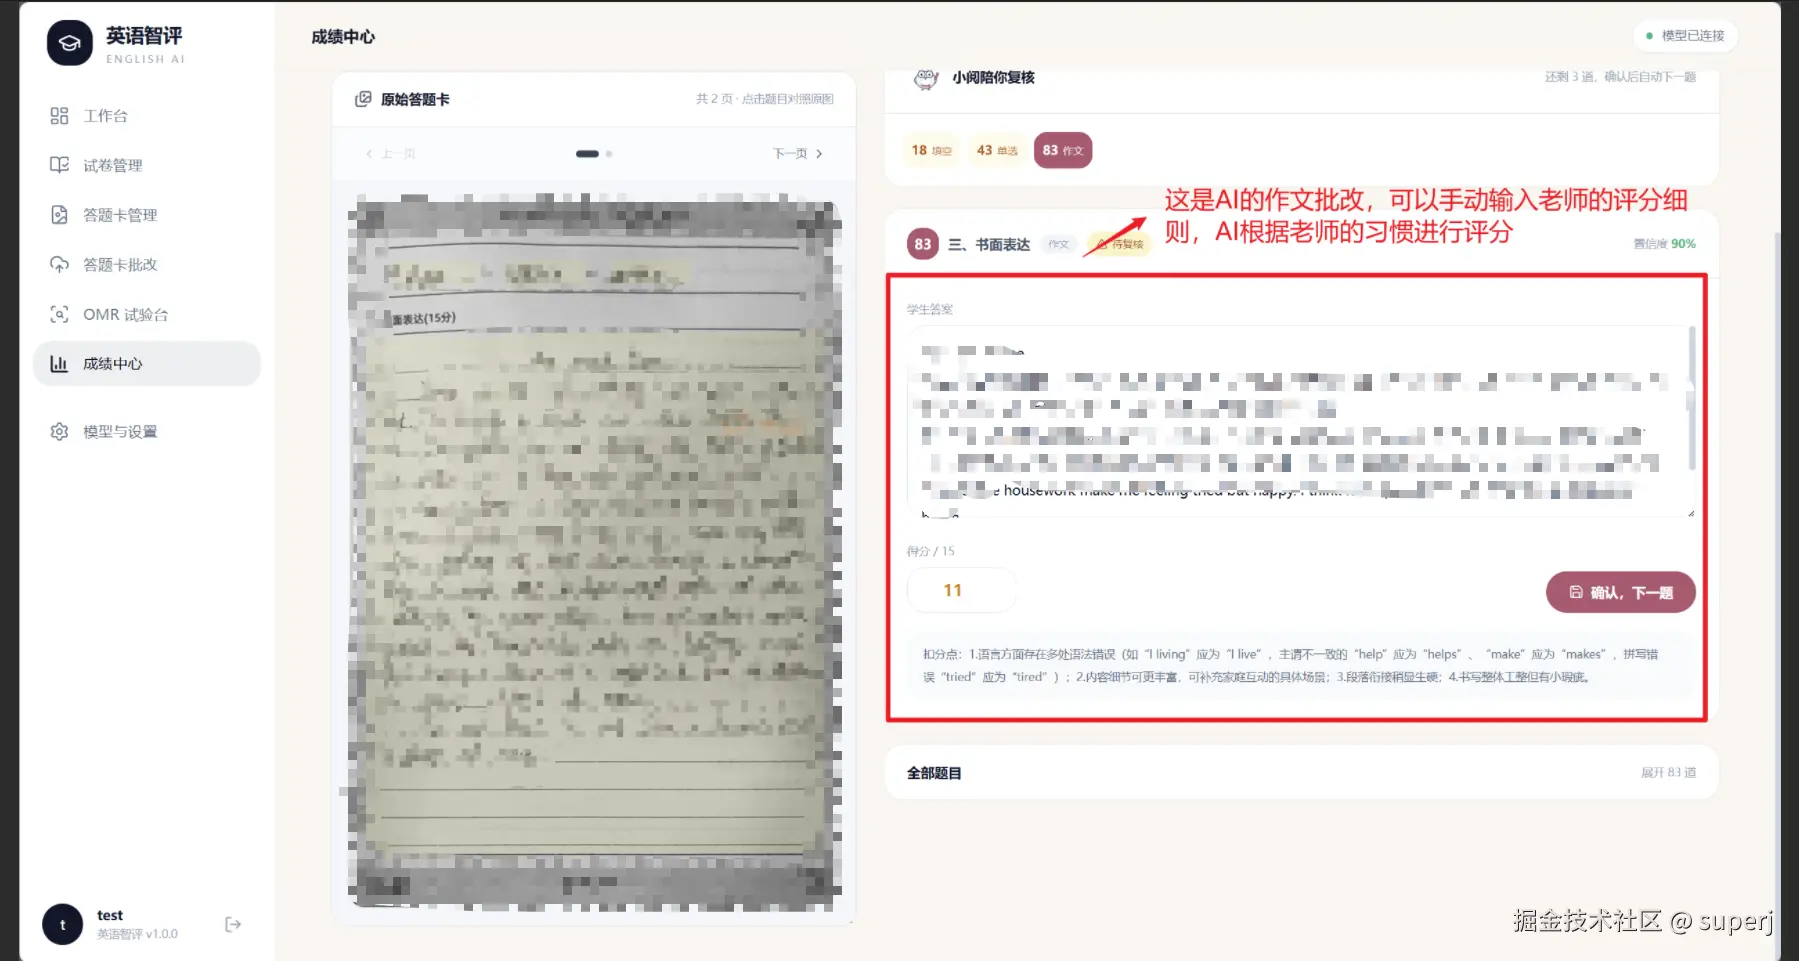
值得强调的是,评分的"习惯"来自老师:作文题在试卷管理里挂上评分细则(rubric),AI 按老师的标准评,而不是它自己的感觉;转写文本、得分、评语全部可以人工修改,改完实时重算总分。
至于为什么要做它、每条流水线背后有哪些设计考量,下面慢慢展开。
二、从真实痛点说起
每次阶段测试之后,老师的批改流程大概是这样的:抱着几十份答题卡,先对着答案册一题一题圈选择题,再把填空和作文逐份看完、打分、写评语,最后把成绩誊到表格里。一份 100 分的卷子认真批下来要十几分钟,两个班的量就是一个通宵。
更难受的是这个过程中的大把时间是机械劳动------选择题的判断根本不需要"理解",只是比对涂点位置;真正值得老师花脑力的,是作文的立意和语言,是那些机器拿不准的答案。
所以这个系统的设计目标很明确:
- 机械判断交给机器------选择题在本地几秒内完成,不花一分钱模型调用;
- 模糊判断交给模型------填空转写、作文评分合并成一次多模态调用;
- 最终判断留给人------所有低置信度结果进复核队列,老师确认后才发布成绩。
三、完整的工作流:五步走完一个班
系统不只是一个"识别脚本",而是一条完整的批改流水线:
① 建试卷------录入题目清单(题号、题型、分值),选择题/多选题填标准答案(多选支持备选答案集合),作文题挂上评分细则。也支持从文本文件导入答案,格式宽松。
② 上传答题卡------每位学生一个文件夹(文件夹名即学生姓名),可以一次拖入整班的文件夹。系统自动按姓名归档,逐份逐页处理。
③ 自动批改------后台流水线:选择题走本地 OMR 即时出分;填空与作文合并成一次视觉大模型调用;两路结果按题号合并成一份完整答卷记录。
④ 人工复核------批改完成后自动进入成绩中心的复核视图:左边是答题卡原图,上面叠加了每道选择题的判定标记(绿框 = 已通过、琥珀框 = 待复核),点击标记或复核队列直接定位题目;右边是题目面板,可以修改学生答案、手动打分。确认一道自动跳下一道,像流水线一样滑完整个班。
⑤ 发布成绩------全部确认后一键发布,进入成绩中心按试卷查看全班成绩,支持导出 CSV。发布前随时可以撤回修改。
四、OMR 详解:用传统图像处理把选择题做"死"
OMR(Optical Mark Recognition,光学标记识别)在这里不需要任何神经网络------因为标准答题卡的涂点位置在印制时就是已知的几何坐标,这是一个确定性的模板匹配问题。整个流程分四步:
4.1 基准定位标(fiducial markers)与仿射校正
扫描、拍照得到的答题卡普遍存在平移、旋转甚至轻微的透视变形,直接按"印刷坐标"去采样必然错位。解决办法是在答题卡四角印制基准定位标------实心黑方块,它们的位置是全局已知常量。
处理时先做二值化 (binarization),再在图像中检测这些实心黑块,得到它们在当前扫描件中的实际坐标。利用四角定位标计算出仿射变换矩阵 (affine transform),对整页图像做仿射校正,把歪掉的答题卡"掰正"回标准坐标系。这一步之后,所有气泡的印刷坐标都可以直接当采样坐标用。
4.2 感兴趣区域(ROI)与填充率统计
校正后,每个选项气泡对应一个小矩形感兴趣区域 (Region of Interest, ROI)。对每个 ROI 统计暗像素占比(dark pixel ratio)------即区域内灰度低于阈值的像素比例。学生用铅笔、水笔涂出的区域,暗像素占比会显著高于空白气泡;轻涂、半涂则落在中间地带。
arduino
填充率 ≥ 涂抹阈值        → 判定为"已填涂"(marked)
填充率 < 涂抹阈值        → 判定为"未填涂"(blank)
填充率处于边界灰区        → 判定为"存疑"(ambiguous)
4.3 判定逻辑与歧义检测
单选题的判定规则:取填充率最高的选项,若其值达标且明显领先第二名 ,判定该选项;若出现双峰(两个选项填充率接近且都达标),大概率是学生改答案没涂干净,标记为 ambiguous。多选题(multiple)则取所有达标选项的集合,再与"该题允许的选项数"做校验。
所有判定都附带一个基于填充率分布的置信度(confidence),它决定了这道题的走向:
- 高置信度 → 直接计分,前端渲染绿色标记;
- 低置信度 / 歧义 → 不猜,进复核队列,渲染琥珀色标记。
4.4 坐标回传:让机器的判断"看得见"
这是 OMR 模块里我觉得最值钱的设计:每个气泡的 bbox(bounding box,外接矩形) 连同判定状态一起存进数据库。前端复核时直接把标记叠加渲染在答题卡原图上,老师看到的不是一串数字,而是"这张卷子上第 7 题被圈出来了"------点一下就能跳到对应题目。机器的每个判断都可追溯、可推翻。
这一步纯本地计算:整班的选择题在几秒内出结果,API 成本为零,而且它"知道自己不确定"------所有拿不准的答案都会诚实地举手,而不是给出一个自信的错误答案。
五、LLM 批改:一次多模态调用管所有主观题
5.1 为什么填空和作文合并成一次调用
两者都是"看手写图、输出结构化结果",分开调用纯粹浪费。系统把本次需要识别的全部主观题(题目清单 + 各页图片)打包进同一次 chat completions 请求,指定模型输出统一的 JSON 协议,一次往返拿到整份卷子的主观题结果。
5.2 提示词的结构化组装
提示词不是一大段自由文本,而是分层拼装:
typescript
全局角色设定(同一学生的连续多页,跨页读取;只允许清单内题号)
+ 各题型提取规则(按需挂载:填空规则 / 作文规则)
+ 题目清单 JSON(number / section / type / score)
+ 评分细则(作文题的 rubric 原文)
+ 输出协议(仅返回 {"results":[...]},字段与取值范围固定)
+ 逐页图片(base64 内联,标注页码)
其中几条是实测踩坑后加上的硬约束:
- 题号防漂移:明确禁止模型"按视觉顺序重新编号、连续补号或根据上一题推算下一题"。答题卡的题号经常跨列、跳号、不按视觉顺序排,不锁死这条,模型会好心地把结果重排成连续序号,导致与标准答案全部错位------这是最隐蔽也最致命的错法;
- 忠实转写:填空题要求照抄学生原文,不纠正拼写语法,有划改取最终保留内容,忽略红叉绿框等批改痕迹;
- 评分锚定:作文分数被限制在"不超过该题分值"内,评语要求指出扣分点,避免模型给出"人人 90 分"的客气分。
5.3 图片预处理与输出校验
调用前每页图片统一走一道预处理管线:按 EXIF 信息转正方向 → 宽度归一到 1600--2400px(太小看不清涂写,太大浪费 token)→ 自动对比度增强 → JPEG 质量 92 重压缩。实测对手机拍照件尤其有效。
返回侧同样不信任模型:强制 response_format: json_object、temperature=0;解析后做结构校验------题号必须存在于清单、每题最多出现一次、字段类型正确,任何越界直接判为本次识别失败并提示重试,绝不把半可信的数据静默写库。
5.4 成本账
一份 8 页答题卡,模型调用次数 = 1 。max_tokens 按配置截断,图片经压缩后单页 token 可控。以整班 40 人计,主观题部分就是 40 次调用;而如果选择题也走模型,这个数字会膨胀到 40 × 题目页数,且每次都是整图的高分辨率输入------成本差一个数量级,还更慢。
六、通用性:这套系统本来就不依赖"英语"
设计时刻意把"科目知识"从代码里剥离了出去:
- OMR 只关心几何:它认的是定位标和气泡网格,不关心涂点旁边印的是 A/B/C/D 还是 ①②③④,也不关心题目内容是英语、数学还是理综。换一张标准答题卡模板,选择题照样跑;
- 评分细则随卷走:作文/主观题的评分依据来自试卷上挂载的 rubric 字段,是数据而不是代码------语文作文、文综论述题,换一份细则就是换一个科目;
- 提示词可在界面调整:提取规则(全局规则 + 各题型规则)在「模型与设置」页在线编辑、即时生效,改科目不需要碰代码;
- 题目清单驱动:整条批改流水线以录入的题目清单为准绳,识别、判分、复核、统计全部围绕这份清单展开,题型扩展只需要新增题型枚举。
换句话说,"英语智评"只是当前的一套预设;把它当作一个可配置的答题卡批改平台来看更准确。
七、复核闭环与成绩管理:价值落地的最后一公里
再准的自动批改,落地场景里也必须回答一个问题:**老师敢直接用吗?**系统的答案是构建信任闭环:
- 可见------每道选择题的判定都以标记形式叠加在原图上,对错一眼可查;
- 可改------复核面板支持改学生答案(选择题点选项、主观题直接编辑转写文本)、改分数,修改后实时重算总分;
- 可控------低置信度答案强制进入复核队列,未复核完的记录不能发布,杜绝"AI 分数直接进成绩单";
- 可追溯------每份答卷记录保留 AI 初评分(ai_score)与发布分(score),谁改过、改了多少有据可查。
发布后的成绩在成绩中心按试卷分组查看,支持 CSV 导出接回学校现有的成绩管理流程。
八、模型接入:换服务商不改代码
模型的 Base URL、API Key、模型名、超时全部在设置页配置,存入数据库,环境变量作为兜底。接口对密钥只回显末四位掩码,任何保存操作传入掩码值都视为"保持不变"。内置连接测试会真的发一张测试图走一次多模态请求,验证接口连通性与图片输入能力,配置错了当场暴露。
九、小结
这个系统想证明的事情其实很简单:AI 批改的正确姿势不是"把卷子整个扔给大模型",而是按确定性分层------
- 涂点位置是确定性的,用 OMR 的几何方法做,快、准、零成本;
- 手写内容是模糊的,用一次多模态调用做,锁协议、强校验;
- 成绩的公信力是人的责任,用复核闭环做,机器标记、老师裁决。
代码结构(前后端同仓):
bash
app/
├── backend/              # FastAPI 服务端
│   ├── omr_service.py        # 定位标检测、仿射校正、ROI 填充率判定
│   ├── ai_service.py         # 提示词组装、多模态调用、结果校验
│   ├── grading.py            # 客观题判分与作文分数约束
│   └── main.py               # 试卷/上传/复核/发布/设置 API
└── src/                  # React 前端
    ├── pages/Upload.tsx      # 整班文件夹上传与批改进度
    ├── pages/Results.tsx     # 成绩中心(列表 + 复核详情)
    └── components/           # 答题卡标记叠加等组件
如果说还有下一步,是把 OMR 的答题卡模板做成可视化标定工具------上传一张样张、框选定位标和气泡网格,就能接入任意印刷模板,让"换科目"变成"换模板"。
代码地址
完整代码已开源于 GitHub(前后端同仓,README 含本地部署步骤):