作者:来自 Elastic Erik Currin
你的索引中有这条告警,但解释它的 Slack 讨论串、 GitHub 拉取请求、Confluence 文档和 PagerDuty 时间线却分散在其他地方。人工智能连接器让你的 agent 能在推理过程中读取这四处的信息。
Agent 构建器现已正式发布。通过 Elastic Cloud Trial(Elastic 云试用)开始使用,并在这里(here)查看 agent 构建器的文档。
Kibana 内置了超过 90 个 人工智能 连接器,其中包括 Slack、GitHub、Confluence 和 PagerDuty,以及 Gmail、云端硬盘、Jira、Salesforce 和 Snowflake。为你的 agent 添加一个连接器,它就能在推理过程中将相应服务作为工具调用。你无需编写集成代码,数据也保留在原来的位置。你的 Elasticsearch 索引告诉 agent 发生了什么,连接器则告诉它为什么会发生。原因可能藏在更改了权限范围的 拉取 请求中、介绍已知回归问题的 Confluence 页面上,或是某人最先提出该问题的 Slack 讨论串里。处理故障时,这可以节省通常用于搜寻背景信息的最初 30 分钟。
包含 90 多个人工智能连接器的资源库
Kibana 内置了超过 90 个连接器规范,涵盖 Gmail、谷歌云端硬盘、谷歌日历、Slack、GitHub、Confluence、PagerDuty、Jira、Salesforce、Datadog 和 Snowflake:
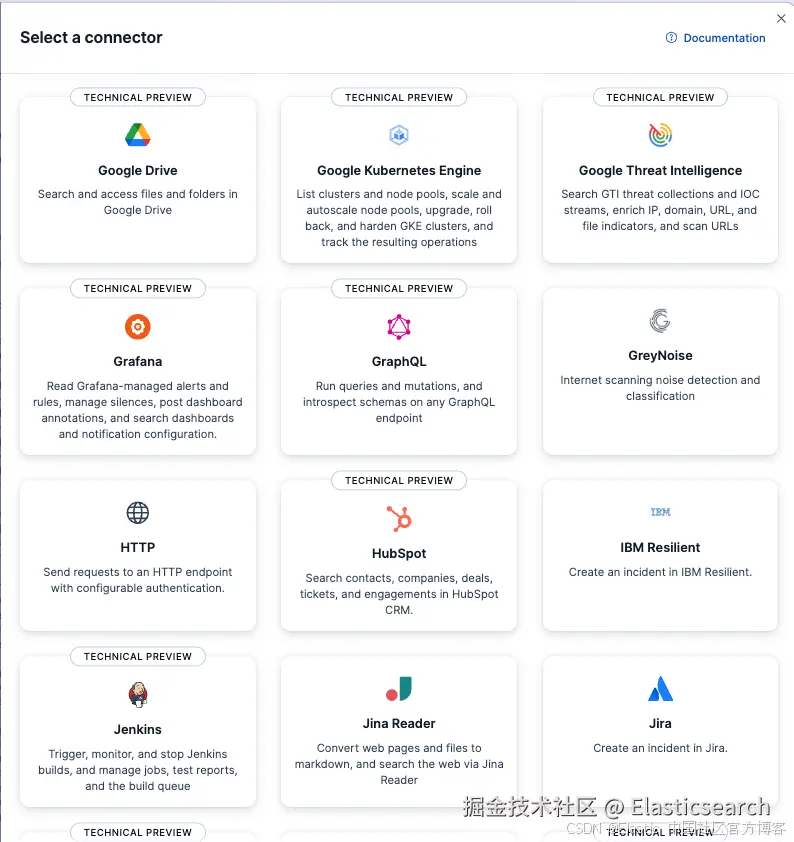
每个规范都声明了连接器可以访问哪些数据、如何进行 身份验证 、支持哪些操作,以及 agent 可以将其中哪些操作作为工具调用:
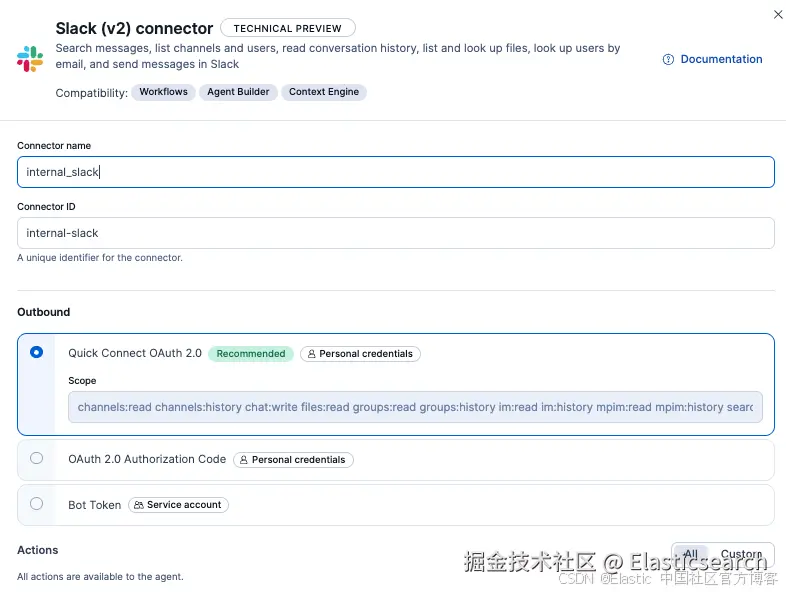
最后这一点让它真正实用起来。agent 在 推理 过程中调用连接器操作,就像调用其他任何工具一样。无需编写集成代码,也无需维护单独的流水线。
人工智能连接器如何进行身份验证
Kibana 连接器负责处理开放授权、应用程序编程接口 密钥 以及持有者令牌。借助 Elastic 的身份验证中继服务,用户可以通过谷歌或 Slack 授权,而无需向 Kibana 提供自己的凭据。agent 看到的是带有类型定义的操作,底层的一切都由规范处理。
人工智能 agent 如何从索引之外获取背景信息
例如,一位产品分析师向 agent 询问客户参与度。 Elasticsearch 索引中有事件、会话、用户群组和转化指标,而 agent 擅长查询索引并编写 Elasticsearch 查询语言(ES|QL)。
问题是 发生了什么?/What happened? ,而不是 这些数字说明了什么?/What do the numbers show? 分析师想知道,为什么企业客户群组的参与度在第二季度下降,以及应该如何应对。索引数据无法给出答案。答案分散在四个地方:
- 一封邮件讨论串,其中一家大客户指出了使用入门流程中的问题
- 一份谷歌文档,描述了第二季度初发布的一项功能变更
- 一段 Slack 讨论,增长团队在其中争论某个假设,却始终没有定论
- 一份产品评审会议的日历邀请,有人在会上决定推迟修复
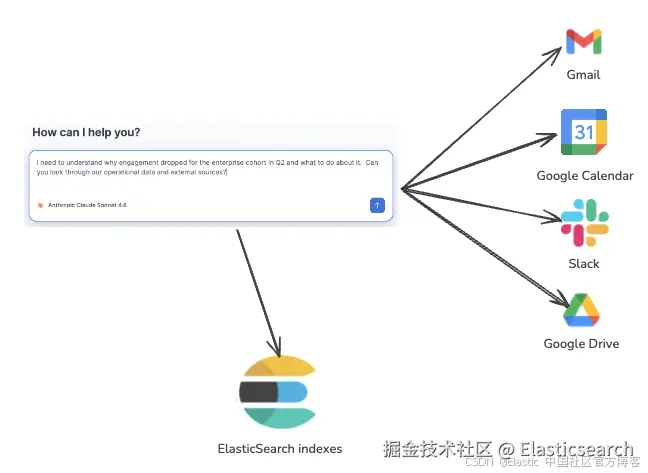
借助 Kibana 连接器,agent 可以访问所有这些信息。它搜索邮件,从云端硬盘中获取规范,阅读 Slack 讨论串,并查看会议记录,了解做出了什么决定以及何时做出的。分析师只需提问一次,剩下的就交给 agent。
人工智能事件响应:更快找到根本原因
现在,让我们考虑一条安全告警。安全信息与事件管理系统标记了异常的凭据使用和横向移动行为,同时发现某个内部服务账户的身份验证失败次数激增。原始遥测数据存储在 Elasticsearch 中,因此 agent 可以查询这些数据并关联事件,也能找出受影响的主机。
找到数据是容易的部分,难的是弄清楚究竟发生了什么。哪次代码变更导致了这个问题?异常发生前是否刚进行过部署?最初的设计对身份验证流程有什么预期?值班工程师何时介入,又已经排除了哪些可能的原因?
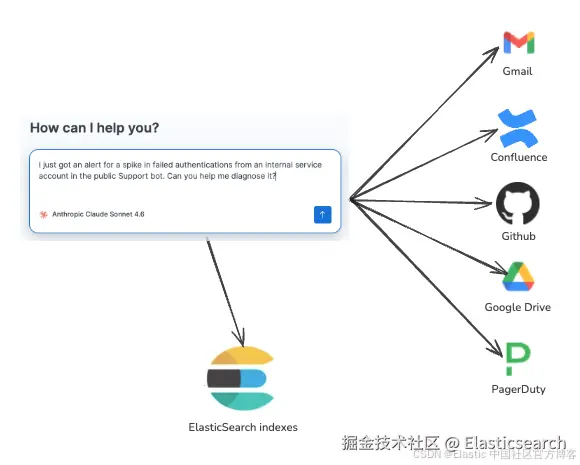
Elasticsearch 存储遥测数据,其余记录则分散在另外四个地方:
- 添加了权限范围的拉取请求位于 GitHub 中
- 说明这是缺陷还是预期行为的设计文档位于 Confluence 中
- 事件时间线位于 PagerDuty 中
- 团队当前的推测位于 Slack 讨论串中
借助 Kibana 连接器,工程师还在阅读告警时,agent 就能收集这些资料。这可以节省事件发生后通常用于搜寻背景信息的最初 30 分钟。
人工智能连接器应该使用哪种身份?
一旦离开 Elastic,身份问题就会变得复杂。Kibana 用户和谷歌云端硬盘登录账户是不同的身份,即使它们使用相同的电子邮件地址。当连接器调用外部服务时,必须确定自己代表谁执行操作。正确的选择取决于 agent 正在访问谁的数据。
个人数据:以用户身份连接
个人数据(例如 Gmail 收件箱、Slack 私信或云端硬盘文件夹)需要使用个人自己的身份。这正是 agent 发挥作用的关键:它能查看该用户的私人对话,而不会看到其他人的私人对话。支持个人开放授权的连接器允许每位用户单独授权,因此 agent 会在各自的权限范围内执行操作。
组织数据:以系统账户身份连接
组织数据(例如 PagerDuty 时间线、Confluence 设计文档或共享的 GitHub 代码仓库)通常更适合使用系统账户或应用程序编程接口密钥。管理员只需配置一次身份验证,其他人无需逐一进行身份验证。
| Personal data(个人数据) | Organizational data(组织数据) | |
|---|---|---|
| 示例 | Gmail 收件箱、Slack 私信、云端硬盘文件夹 | PagerDuty 时间线、Confluence 设计文档、共享的 GitHub 代码仓库 |
| 身份验证 | 个人开放授权 | 系统账户或应用程序编程接口密钥 |
| 配置者 | 每位用户分别配置 | 管理员配置一次 |
| agent 能看到的内容 | 仅限该用户能看到的内容 | 服务账户能看到的所有内容 |
大多数 agent 最终都会混合使用这两种方式。
在 Kibana 中设置人工智能连接器
你添加的每个人工智能连接器都会成为 agent 可调用的工具,因此只需一次性配置,无需开展集成项目。
在 Kibana 中打开你的 agent,进入工具配置。浏览连接器库,设置你需要的数据源。你添加的任何连接器都可供该 agent 在推理过程中调用。
如果你从零开始,Elastic Cloud trial(Elastic 云试用)可以让你在托管环境中使用完整的连接器库。相关文档请参阅 Kibana Connectors reference(Kibana 连接器参考文档)。
原文:AI connectors in Kibana: 90+ data sources for your agent | Elasticsearch Labs