本文源自火山引擎知识引擎 VeKnow 业务实践思考,火山引擎知识引擎 VeKnow 作为企业级 AI 知识底座,依托大模型与大数据技术,提供从知识接入、加工处理、知识建模到智能问答的全链路知识管理与应用能力,让企业知识真正流动起来,在业务中持续创造价值。
如何让AI智能体更可用、更可信、更懂业务?围绕这一目标,本文将详细解读VeKnow 的设计理念与产品功能。
VeKnow 的核心使命
知识引擎VeKnow不是在数据库、知识管理系统、数据中台之后又一套类似的工具,而是一次服务范式的转变:过去,数据服务把数据加工好交给"人"去判断;现在,它把知识加工好交给"智能体"去判断。
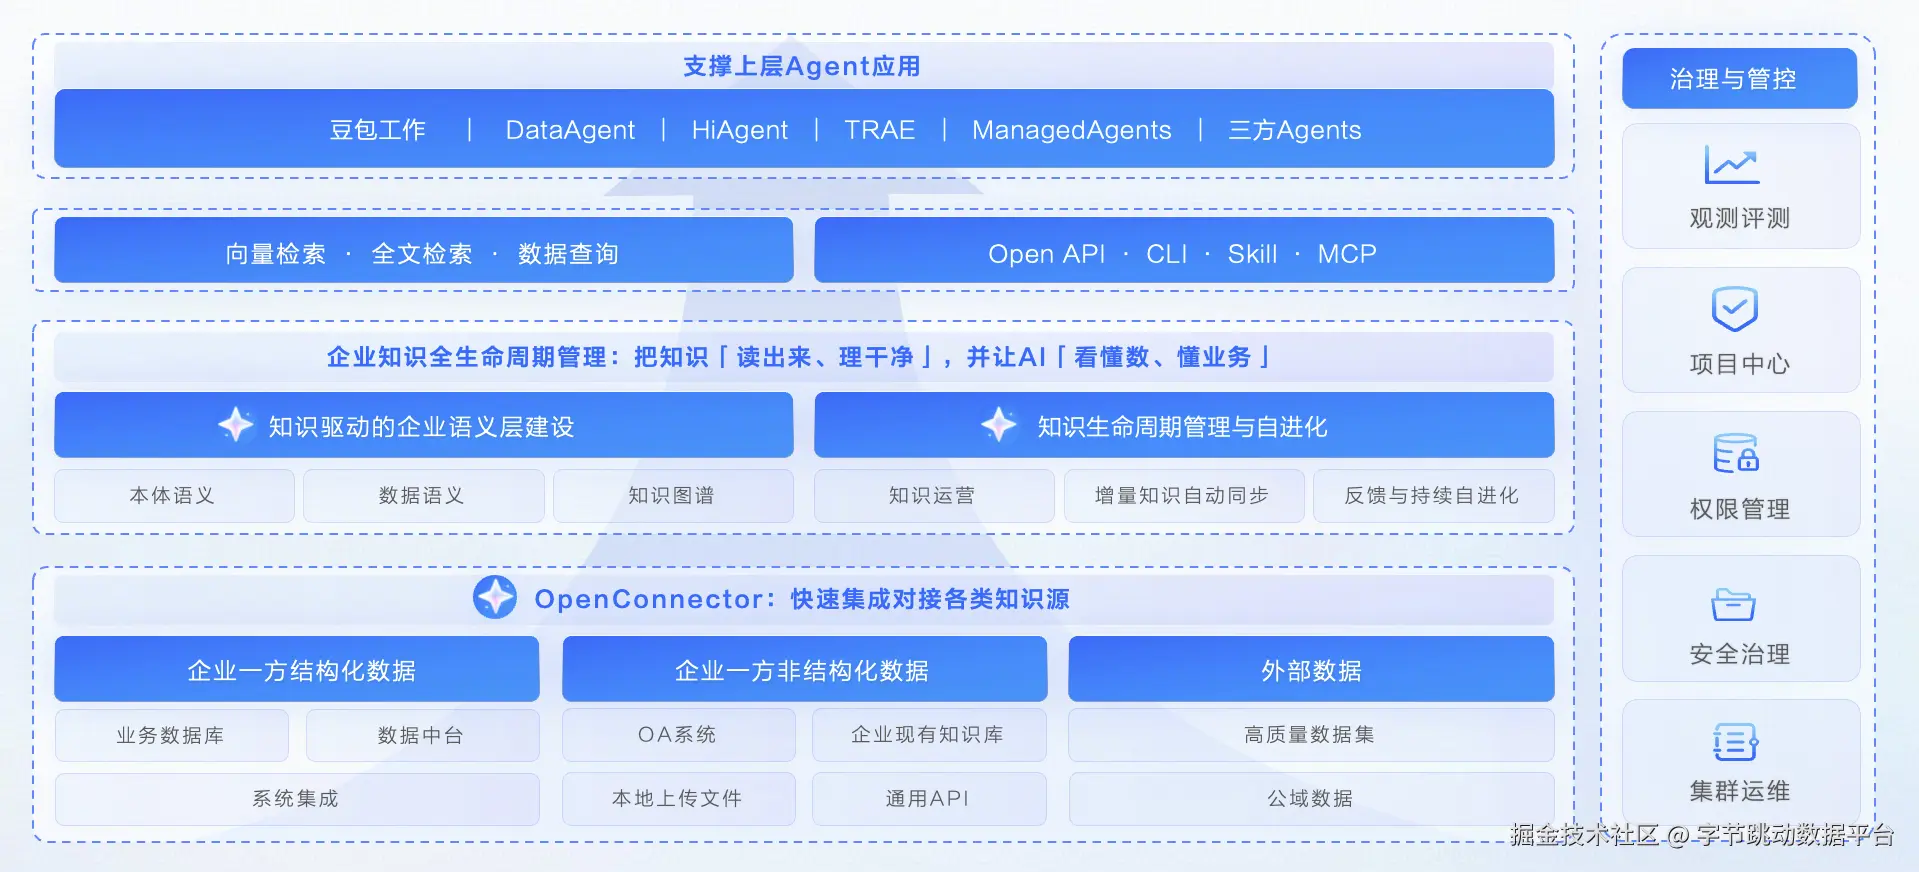
模型决定 AI 的下限,企业上下文决定 AI 在企业应用中的上限。知识引擎VeKnow 承接结构化数据治理的成熟成果,补齐非结构化数据理解及AI可消费语义的缺口,串联知识生产到消费的全链路,汇聚为面向AI的企业级知识基座。
企业上下文管理原则
知识引擎VeKnow的设计理念:企业上下文管理的核心原则。
场景牵引,小步快跑
以场景需求为牵引,先看清业务真正要什么,再决定知识怎么建。让知识资产从"够用"走向"好用",从单场景沉淀走向跨场景复用。
环境适配,开放调用
向下承接企业数据中台治理成果,兼容多模态多源头数据,融入企业数据环境;向上以标准化、技能化方式供给,支撑多个企业 Agents 并行调用。
以终为始,策略适配
向量检索做相关性匹配,解决"答案在文档里"的事实型问答(如"年假制度规定几天");语义建设解决推理逻辑,适配"答案要靠跨源聚合"的复杂场景(如"哪些供应商合同明年到期且履约评分低于 80"、"口径不一的毛利核算")。不同场景需求不同,单一路径无法解决所有问题。
治理优先,运营为大
未经治理的知识一旦混入上下文,将放大幻觉风险。权限、审批、溯源与保鲜是知识进入 AI 调用链路前的强制关卡,从源头保障输出持续可信。
知识全生命周期功能
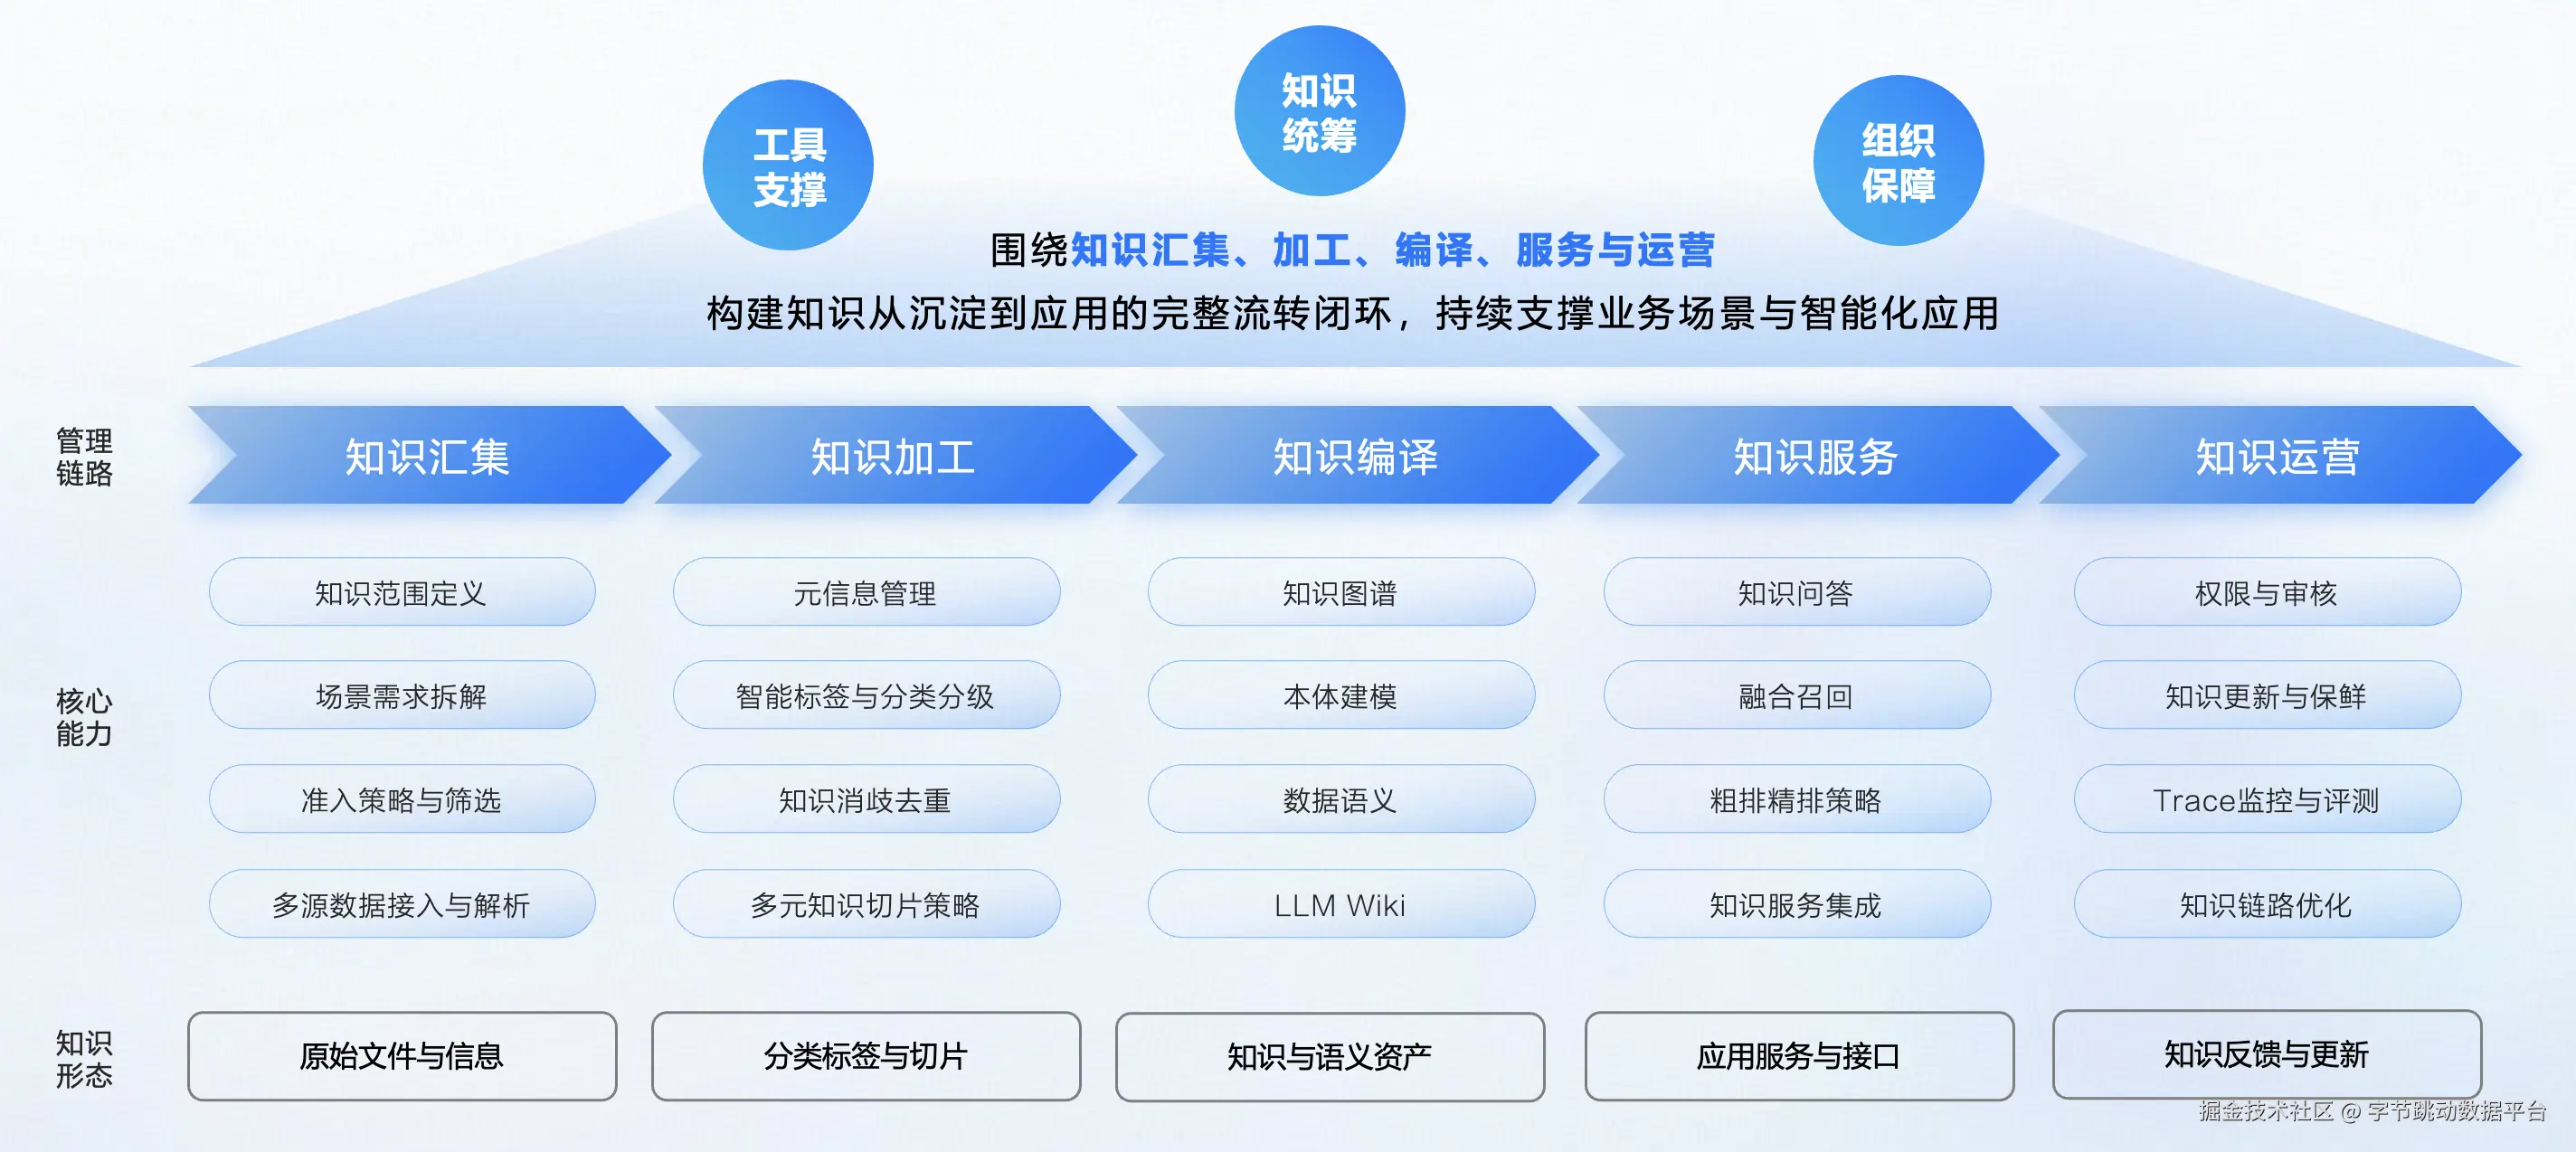
产品落地:贯穿知识全生命周期的功能集合。
知识工程
**把散乱物料变成知识。**提供超过 50 种数据源的快速配置接入,预置RestAPI/Auth 等多种方式对接源端系统;内置超过 40 种预置算子,通过可视化拖拉拽即可低门槛完成复杂知识处理;支持非结构化数据智能打标、会话质量评估与情感分析等场景化能力,可高并发大批量完成知识打标落仓。
知识管理
**让知识变成有价值的资产。**个人知识库面向企业员工,可快速收集本地内容,并自动编译生成 Wiki、直连开箱即用的智能问答;企业知识库面向核心资产管理,支持分类分级、智能标签等能力完成知识资产化;面向智能应用消费,为保障消费质量,能深度解析复杂文本与表格,支持多元策略切片,并由大模型丰富检索元信息,让检索更快更准。
知识编译
**为复杂场景提供更强上下文。**以智能体方式自动完成知识编译与建模,把企业分散的原始文档、数据与经验加工为大模型可直接消费的结构化知识资产,并以技能化方式交付给各类智能体应用;同时支持知识图谱(GraphRAG)、本体建模(Ontology)、LLM Wiki、数据语义等编译路径,满足不同场景需求。
知识运营
**集成管理与安全管控。**支持 SSO、租户与用户管理;功能级/文档级权限、入库审批、使用日志与敏感词识别,守住安全底线;资产统计与检索排行,沉淀运营洞察;OpenAPI、MCP、Skill 开放接口与 Token 鉴权,易于集成;会话管理、Trace 监控与 Agent 评测,让知识效果可衡量、可迭代;会话Trace回流、自动归档、自动编译,让知识可自进化更新。
企业数据服务的下一站
从"人有数可用"到"AI有智可循",企业数据服务的下一站。
AI正以前所未有的速度迭代,技术热点层出不穷:提示词工程是大模型应用的第一课,RAG把企业知识接进模型,模型高频迭代牵动业界神经,养虾热潮曾火爆全网,Agent与Harness编排框架让智能体自主执行任务,递归式智能体又把"自我进化"推到聚光灯下。
对企业而言,什么才是AI时代企业的基本功与必修课?答案或许并不在某个模型或框架里,而在以企业数据为基础的AI认知基座。无论应用如何演进,企业数据始终是应用生长的根本。只有把分散的数据和知识持续治理、关联并转化为可信、可理解、可调用的上下文,AI 才能从"有答案"走向"懂业务、能办事"。
从"人有数可用"到"AI有智可循",知识引擎 VeKnow 要做的,正是帮助企业夯实数据与知识基础,持续构建面向 AI 的企业上下文,让每一次应用创新都有可信可靠的知识基座做支撑。
毕竟AI的每一次判断,终将影响企业的未来。