为什么会有本系列
本系列是手搓 Agent 教学项目 Teernage/powercode 的 Python 重实现版本;为什么要做这个系列呢?是因为当我在掘金社区刷到 @不一样的少年_ 大佬的【不用框架,手搓 AI Agent】系列时,感觉写得很好,但是想深入学习时,发现代码都是 Node/TS 实现。想掌握技术细节,但看得似懂非懂,如果先学习 Node/TS,又感觉成本太高。于是就想着实现一个 Python 版本的手搓 Agent 系列,以便让自己能更深入学习 Agent 的相关技术细节。整理成博客,以便那些熟悉 Python 但不熟 Node/TS 的小伙伴能一起进步成长;当然如果你已有 Node/TS 基础,强烈建议去学习 【不用框架,手搓 AI Agent】系列,真的很棒。再次感谢 Teernage 大佬的开源分享。
本系列的源码 powercode-py,本篇对应 commit 3dbd64f + 97941cb;如果你觉得对你有帮助,请点个 star ⭐。
上篇回顾:上一篇我们把项目跑起来了,AI 能在终端里"一问一答",但它看不见你的项目,全靠脑补。
本篇目标 :给它配上第一个工具
read_file,让它想看文件时"点菜",读完真实内容再回答。
一、上一期那个 AI,其实一直在"不懂装懂"
上一篇我们搭好了一个能"一问一答"的 AI。你问它"这个项目是干什么的",它张口就来,答得有鼻子有眼。但它其实一个字都没看。为此我专门做了个实验:建了个项目,README 里只写一句------"帮楼下王姐记清楚,这个月赊了多少张煎饼没结账",然后给它起了个特别唬人的名字「煎饼侠调度系统」。切回那个只会问答的旧版本,敲:
bash
powercode "「煎饼侠调度系统」是我负责的项目,帮我写一段项目介绍"结果它脸不红心不跳,当场给我交出一份正儿八经的项目述职:
"煎饼侠调度系统"是我负责的智能调度平台项目。项目面向订单/任务快速增长、人工分配效率低、资源利用不均衡和异常响应慢等问题,建设了集任务接入、调度策略配置、智能分派、负载均衡、实时监控和异常告警于一体的调度系统......稳定支撑日均【X】万级任务/订单调度......
最绝的是,它最后还贴心地补了一句:"使用时把【X】替换为真实数据即可。"
我盯着这堆【X】乐了半天。它把"订单分配、负载均衡、实时监控"说得越专业,就越像个笑话------因为真实答案就躺在那句 README 里,跟"调度""平台"半毛钱关系没有,就是给煎饼摊记个赊账。
一个连项目里到底有什么都看不到的 AI,凭什么这么笃定?答案就一个字:猜。它手上没有任何工具,只能靠"调度系统"四个字疯狂联想,再用训练时见过的一堆述职模板把空填满。
所以这一期,我们要干一件关键的事:让 AI 别再空口说白话,学会去"查资料"。
具体点说,就是给它配第一个工具------read_file,让它能真的打开你项目里的 README.md,看完再回答。
这也是"普通对话机器人"和"Agent"的分水岭:前者只会聊,后者会动手(或者说,会叫人帮它动手)。
二、先把丑话说前面:AI 自己,是读不了文件的
先说个最容易被绕进去的点:
AI 是个"只动嘴、不动手"的客人。它不能自己溜进你的硬盘翻文件,它只能"点菜"。
把整个流程想象成一家餐厅:
- 你是老板 ,AI 是客人 ,Python 程序是后厨。
- 客人(AI)不会做饭,也进不了后厨。它只能照着菜单下单:"来一份 README.md"。
- 后厨(程序)收到单子,真的把文件读出来,"端"回给客人。
- 客人(AI)吃上这口真实内容,才能给出靠谱的评价。
这一整套,画出来就是下面这张图:
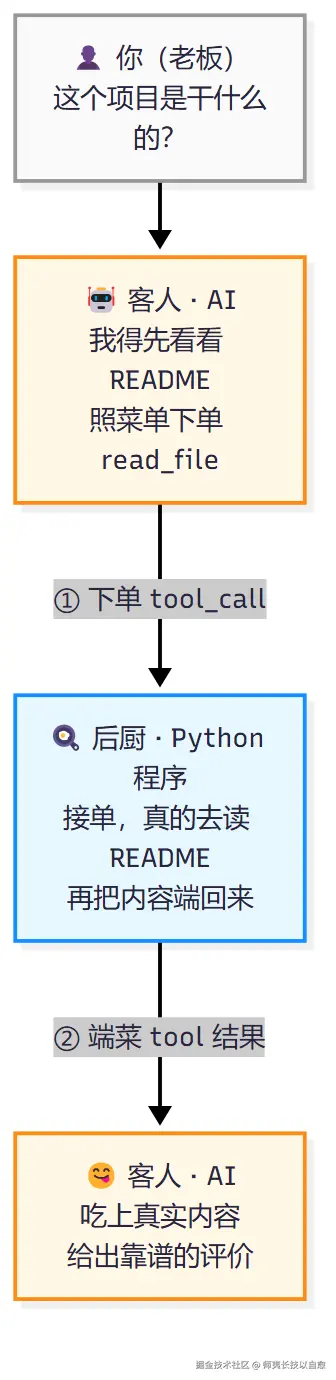
看这张图就明白了:AI 从头到尾只动了两下嘴------下单、点评;中间真正读文件那一下,是后厨(程序)干的。 这就是"工具调用"(function-calling)------说白了,AI 下单,程序干活。
菜单也不是随便写的,它是一份结构化说明,告诉 AI:"本店有这几道菜,点单要说清楚参数。"这份"菜单"的正式名字,叫 JSON Schema。
三、先看效果
写完这期代码,你在终端敲:
bash
powercode "帮我读一下 README.md,这个项目是做什么的?"会看到类似这样的输出:
text
AI 正在思考...

AI 想读文件:{"path": "README.md"}

AI:这是一个名为 powercode-py 的教学项目......
别看最后那段回答,真正有信息量的是中间这一行:
text
AI 想读文件:{"path": "README.md"}这说明 AI 没有瞎编,而是真的先"下了单",让程序去读了文件。
⚠️ 免责:最后那段回答是 LLM 生成的,每次可能措辞不一样,你跑出来跟我这里不一样是正常的。我们要盯的是"它到底有没有去读文件"这个动作,而不是背下某句话。
⚠️ 避坑 :如果你用的是 DeepSeek 的 thinking 模型(新版deepseek-v4-flash等),跑到"二次调用"那一步会报reasoning_content ... 400。原因是 DeepSeek 要求把上一次回复里的reasoning_content原样传回,而咱们在answer_after_read_file里重建 assistant 消息时,只抄了content和tool_calls。解法就一行------重建时把reasoning_content也带上(本系列最终源码里已经这么修了)。你在中间某篇撞到这个错,补一行即可,不影响理解主线。
为了跑出上面这个效果,接下来的四、五、六三节要分别写三块代码,串起来是这样一条流水线:
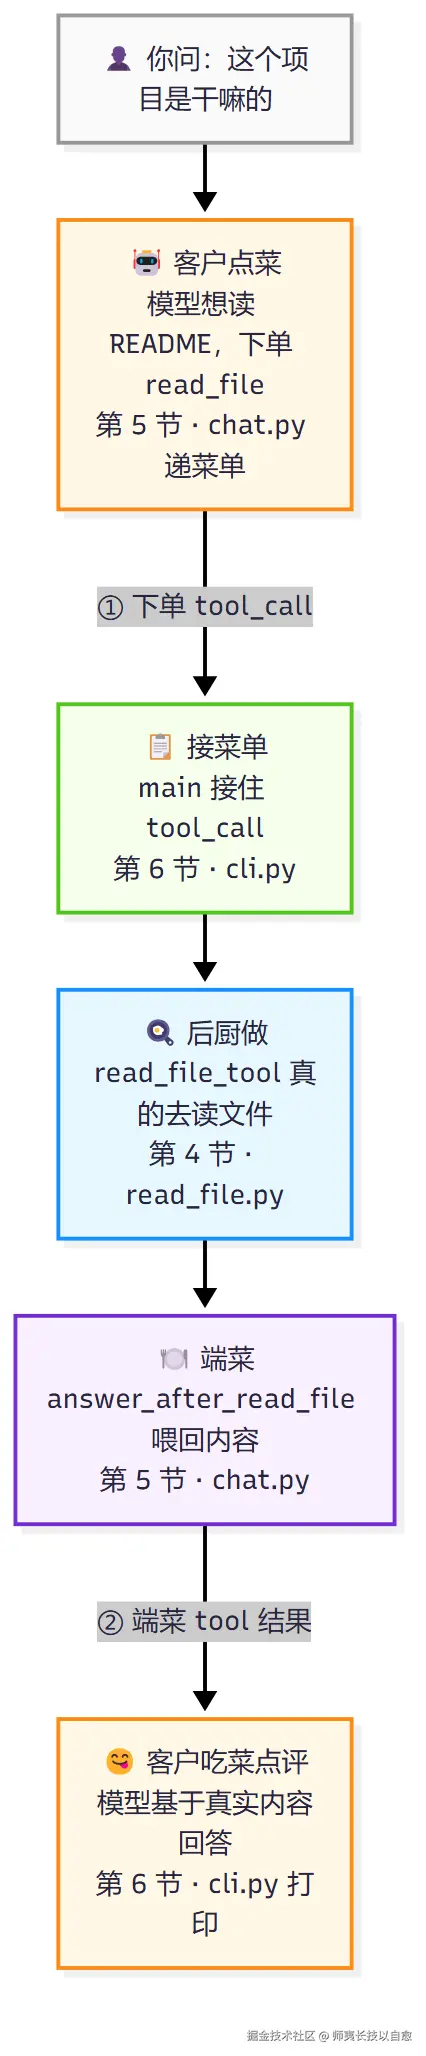
一句话记图:第四节写后厨(read_file.py,真的去读文件),第五节写递菜单和端菜(chat.py,两次调用模型),第六节写服务员(cli.py,接单、调度、打印)。 下面三节就按这个顺序动手。
四、第一步:写"菜单"和"后厨"
新建 powercode_py/read_file.py。这份代码虽然不长,但它同时干了两件事,分开看:
4.1 第一件:给 AI 的菜单(JSON Schema)
python
MAX_BYTES = 8_000  # 最大字节数

READ_FILE_TOOL = {
    "type": "function",
    "function": {
        "name": "read_file",
        "description": "读取当前项目中的文本文件内容。",
        "parameters": {
            "type": "object",
            "properties": {
                "path": {
                    "type": "string",
                    "description": "文件路径,比如 README.md",
                },
            },
            "required": ["path"],
            "additionalProperties": False,
        },
    },
}
这堆括号用大白话讲就三句:
我这有道菜叫
read_file,能读文本文件;想点它,必须传一个字符串参数path。
AI 看完这份菜单,就知道:哦,我想看 README 的话,可以这样"下单":
json
{"path": "README.md"}4.2 第二件:真正干活的后厨
菜单只是"告示",真正读文件的是下面这段:
python
def read_file_tool(arguments_json: str) -> str:
    """读取当前项目内的文本文件,返回内容。"""
    relative_path = _get_path(arguments_json)

    work_dir = Path.cwd().resolve()
    target_path = (work_dir / relative_path).resolve()

    if work_dir != target_path and work_dir not in target_path.parents:
        raise ReadFileError("只能读取当前项目里的文件。")

    if not target_path.exists():
        raise ReadFileError(f"文件不存在:{relative_path}")

    if target_path.is_dir():
        raise ReadFileError(f"这是一个目录,不是文件:{relative_path}")

    data = target_path.read_bytes()

    if len(data) > MAX_BYTES:
        head = data[:MAX_BYTES].decode("utf-8", errors="replace")
        return f"{head}\n\n...[文件太长了,只返回前 {MAX_BYTES} 个字节]..."

return data.decode("utf-8", errors="replace")(_get_path 负责把 AI 传来的 JSON 解析成合法的 path 字符串,这里不展开。)
AI 只负责说"我要读哪个文件",read_file_tool 负责真去读。
五、第二步:把菜单递给 AI
光有菜单不行,得让 AI 看到菜单。打开 powercode_py/chat.py,关键是这一处:
python
def ask_with_tools(self, prompt: str):
    """向模型提问并声明 read_file 工具,返回首个消息(可能带 tool_calls)。"""
    completion = self._create(
        model=self.config.model,
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": prompt},
        ],
        tools=[READ_FILE_TOOL],   # ← 就是这一行,把菜单递给了 AI
    )
    ...
上一篇我们只告诉 AI"用户问了什么";这一篇多告诉它一句:"你现在有 read_file 这个工具,想读文件就申请。"
注意,是"申请"------它不能自己读,得先把单子交给咱们的程序。
接着还要补一个方法,负责"端菜":
python
def answer_after_read_file(self, prompt: str, tool_call, file_content: str) -> str:
    """把读取到的文件内容喂回模型,返回最终回答文本。"""
    ...
    completion = self._create(
        model=self.config.model,
        messages=[
            {"role": "system", "content": ANSWER_SYSTEM_PROMPT},
            {"role": "user", "content": prompt},
            {"role": "assistant", "content": None, "tool_calls": [assistant_tool_call]},
            {"role": "tool", "tool_call_id": tool_call.id, "content": file_content},
        ],
    )
...这一步特别容易漏。AI 第一次只说"我想读 README";你读完得把内容发回去,它才能说"我看了,这项目是干嘛的"。就像客人点完菜,后厨炒好了不端上去,客人永远不知道菜长啥样。
六、第三步:接单 → 端菜
最后改 powercode_py/cli.py,把整条流水线串起来。主流程就三步:
python
# 1. 先问 AI:直接回答,还是要"点菜"?
first_message = client.ask_with_tools(args.prompt)
tool_call = (
    first_message.tool_calls[0]
    if first_message and first_message.tool_calls
    else None
)

# 不需要读文件,直接打印答案
if not tool_call:
    print(f"AI:{first_message.content or '模型没有返回内容。'}")
    return 0

# 2. 打印"下单"内容,后厨开工
print(f"AI 想读文件:{tool_call.function.arguments}\n")
file_content = read_file_tool(tool_call.function.arguments)

# 3. 把读到的内容端回给 AI,得到最终回答
answer = client.answer_after_read_file(args.prompt, tool_call, file_content)
print(f"AI:{answer}")
七、为什么不能让 AI 随便点菜?
注意到 read_file_tool 里那串"看起来多余的校验"了吗:
python
# work_dir:项目根目录;target_path:模型要读的文件(已 .resolve() 成真实绝对路径)。
# target_path.parents:这个文件的所有上级目录列表。
# 越界 = target 既不是项目根目录本身(work_dir != target_path),
#       项目根目录也不是它的上级(work_dir not in target_path.parents)。
if work_dir != target_path and work_dir not in target_path.parents:
    raise ReadFileError("只能读取当前项目里的文件。")
光看这行可能还是有点绕,咱们走两个具体例子。假设项目根目录是 D:\my-project:
- 模型老实读
README.md:target_path算出来是D:\my-project\README.md,它的上级列表里有D:\my-project,所以work_dir在列表里 → 放行。 - 模型使坏读
../secret.txt:.resolve()把路径抬成D:\secret.txt,上级列表里没有D:\my-project→ 越界,拒绝。
至于 work_dir != target_path 这半句,是兜住"模型读 .(项目根目录自己)"这种边角:这时 target 就是项目根目录,不算越界,放它过去,后面那句 is_dir() 自然会拦下"这是目录"。
这不是过度设计,是保命。
比如你让 AI 读个 README,它万一"抽风"下单 {"path": "../../../etc/passwd"},或者给你个绝对路径 /Users/你/.ssh/id_rsa,后厨要是不设防,真就把你私钥读出来端给模型了。
所以规则很朴素:项目里的文件随便读,项目外面的,一律拒绝。(本系列后面所有会"碰文件"的工具,都会沿用这条边界。)
另外还限了大小:
python
MAX_BYTES = 8_000原因也实在:日志文件、打包产物、几十万行的数据,全塞给 AI,又慢又费 Token。先截到 8000 字节,不够了你自己调。
八、这期到底干成了啥?
以前 AI 靠脑补,现在它会先查资料了。
完整链路是这样:
json
你问问题
  → AI 觉得"我得看 README" → 按菜单下单 {"path": "README.md"}
  → 程序读文件
  → 内容端回 AI
  → AI 基于真实内容回答
到这里,它终于有那么点"Agent"的意思了。
九、下集预告:一次读够不够?
这期咱们故意只让它读一次。
不是偷懒,而是先把"工具调用"这一件事彻底搞明白。你会不会也好奇一个问题:
AI 读完 README 之后,要是还想再读一眼
pyproject.toml呢?
下一期,咱们就把"一次"升级成"循环"------让 AI 能连着读好几个文件,直到它自己觉得"够了"。这才是真正的 Agent Loop。