目录
- 一、它要解决什么问题
- 二、文件头注释:协议总纲(12-86 行)
- 三、类型与字段(87-126 行)
- 四、计数运算三件套(128-149 行)
- 五、溢出的存取协议(151-203 行)
- 六、newProfBuf:2 的幂强制(205-233 行)
- 七、canWriteRecord / canWriteTwoRecords(235-296 行)
- 八、write:写路径全解(298-390 行)
- 九、close 与 wakeupExtra(392-417 行)
- 十、read:读路径全解(429-557 行)
一、它要解决什么问题
第 03 篇里,cpuprof.add 在信号处理器 里被调用------那是全进程最恶劣的执行环境:没有 g、不能分配、不能拿普通锁、栈只有几 KB。而消费数据的是 runtime/pprof 里的普通用户 goroutine。两者之间需要一个满足全部约束的通道:
| 约束 | profBuf 的对策 |
|---|---|
| 写者可能在任何指令间打断任何人 | 写路径只用原子 store/CAS,无锁 |
| 恰好 1 写者(信号串行)× 1 读者 | 不需要多写者仲裁,索引协议足够 |
| 记录变长(栈 0~64 帧) | 长度字 + 定长头 + 变长栈的 framing |
| 缓冲会满 | 满则丢弃 + 溢出计数,事后合成"丢失记录" |
| 无数据时读者要睡,来数据要被叫醒 | profReaderSleeping 标志位 + runtime note |
| 环形缓冲回绕 | 总读写次数 mod 2^n 与 mod len 对齐(长度取 2 的幂) |
CPU profile 用它,runtime/pprof 的 profileWriter 是它的唯一读者(经 readProfile)。
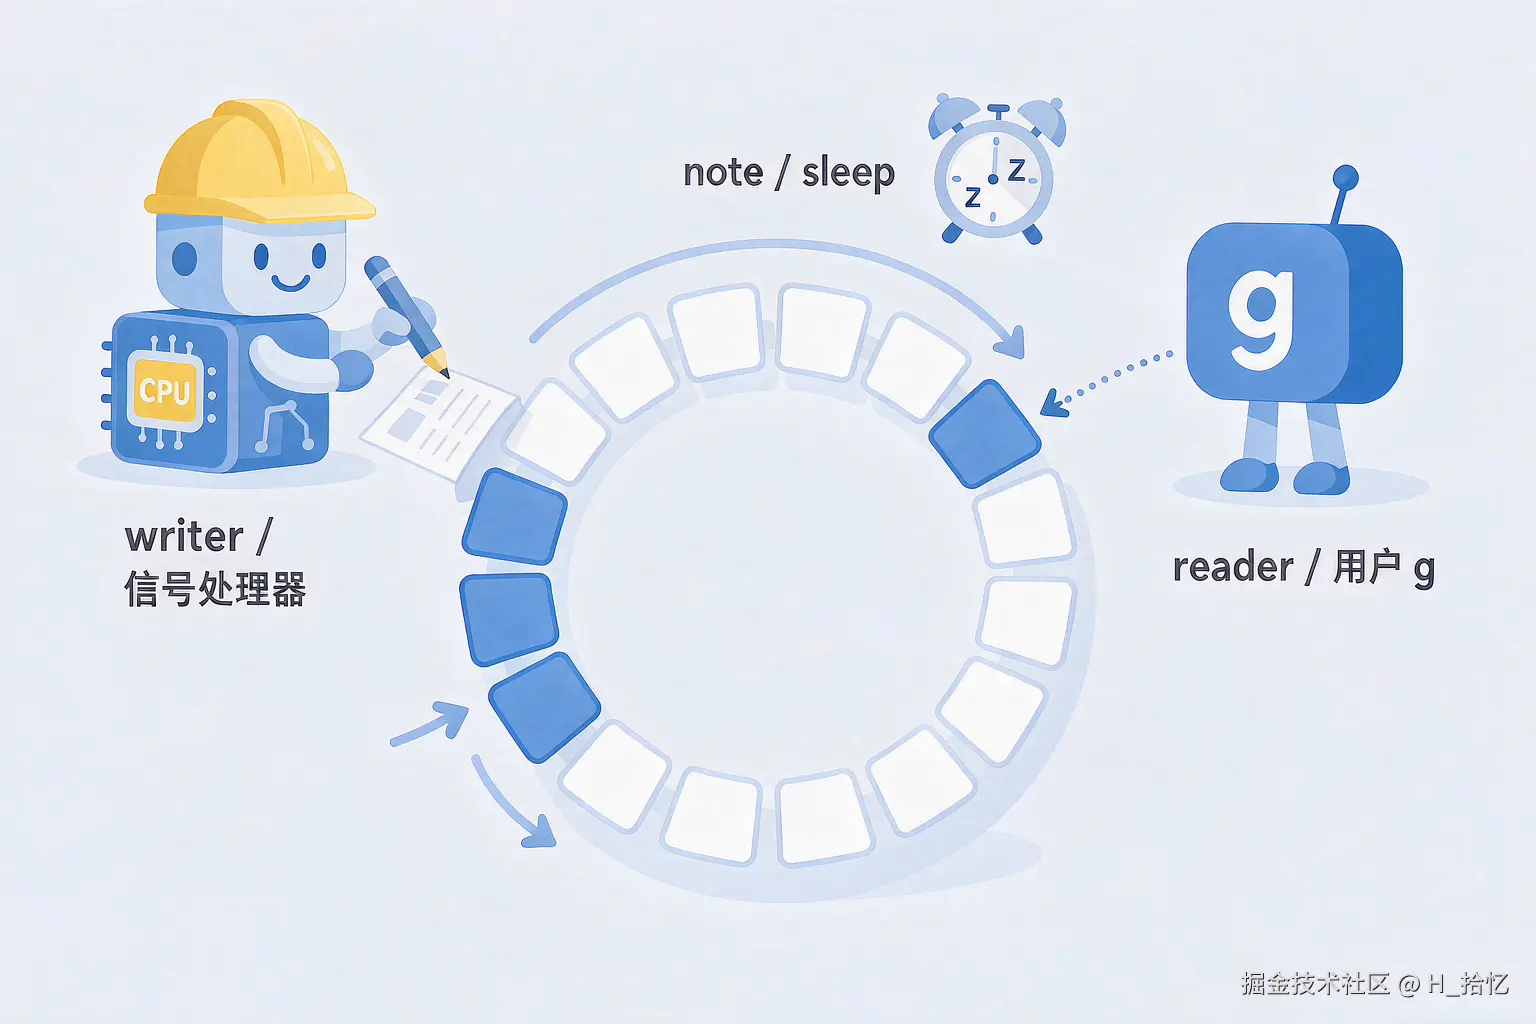 图 4-1 角色与环境约束:信号处理器是无 g 的写者,用户 goroutine 是读者,二者通过 data / tags 两个环共享数据。
二、文件头注释:协议总纲(12-86 行)
文件头 75 行注释是协议的"合同文本",分六段,逐段翻译:
① 角色定义(12-15 行) :"profBuf 是剖析事件的无锁缓冲,并发安全限于一个读者 + 一个写者;写者可以是无 g 的信号处理器;读者假定是用户 g。"------超出这个并发度的使用是未定义行为。
② 记录格式(17-24 行) :每条事件 = 定长头(hdrsize 字)+ uintptr 列表(栈)+ 恰好 1 个 unsafe.Pointer 标签。在 data 环里占 2+hdrsize+len(stk) 字,布局:
scss
┌─────────┬──────────┬───────────────┬────────────────┐
│ 长度字 │ 时间戳 │ hdr(定长,1字) │ stk(变长 0..64) │ data 环
│ 2+h+n │ uint64 │ 零填充 │ PC,PC,PC... │
└─────────┴──────────┴───────────────┴────────────────┘
↕ 一一对应
┌────────────────────────┐
│ tag: *unsafe.Pointer │ tags 环
└────────────────────────┘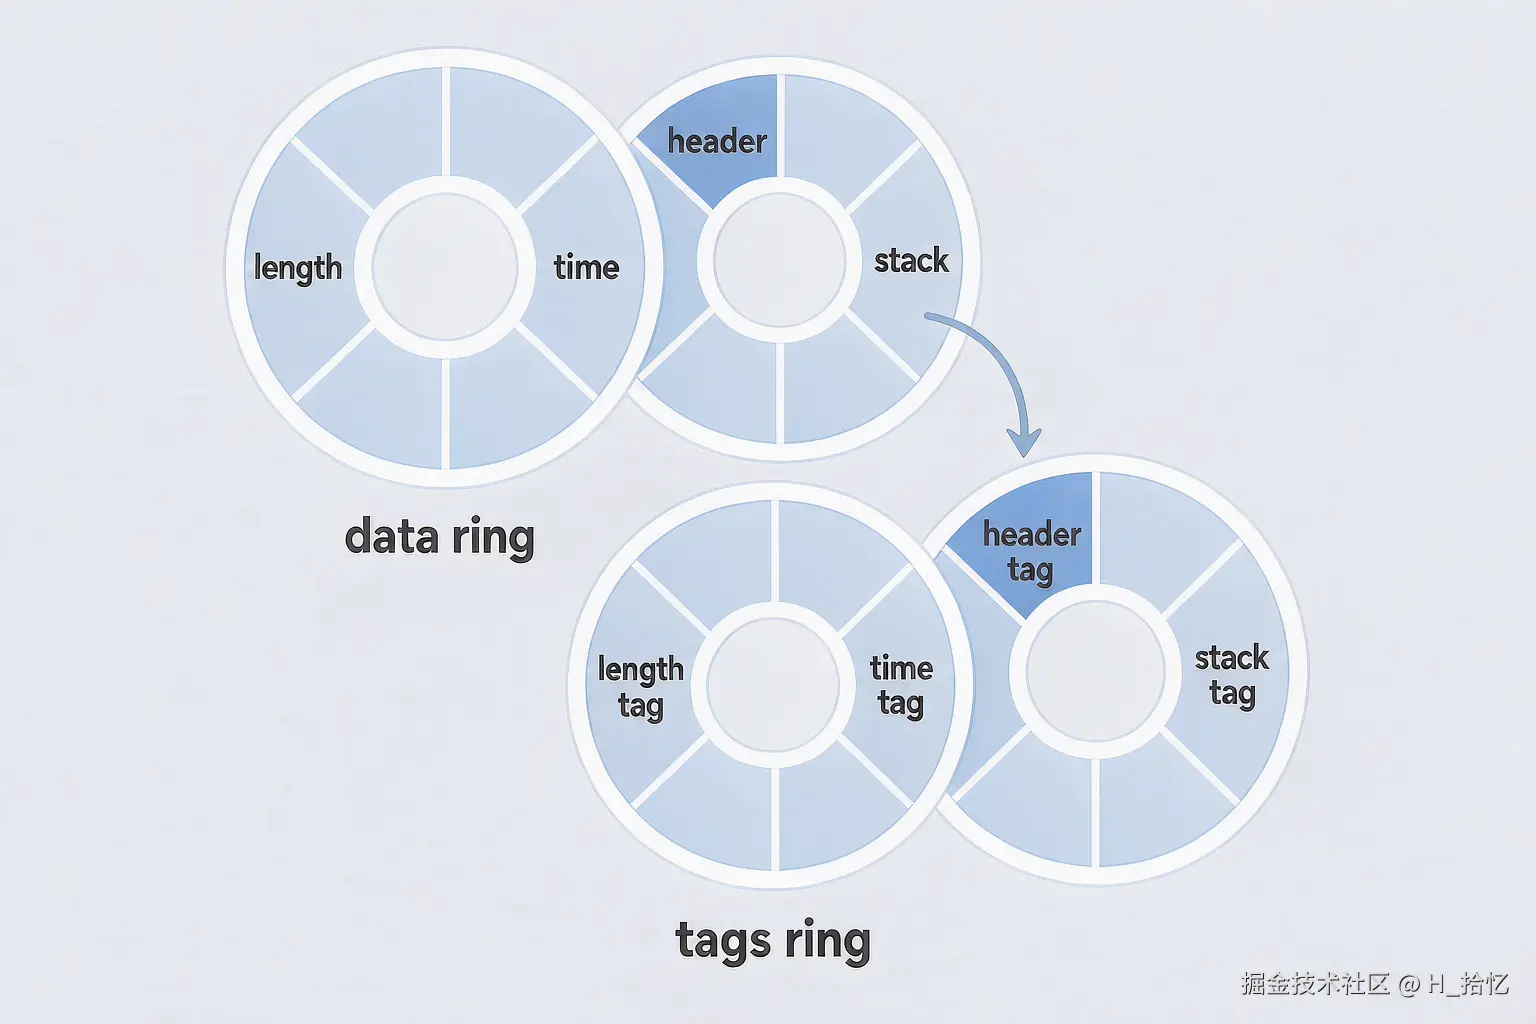 图 4-2 记录格式:data 环的每个槽 = 长度字 + 时间戳 + 定长头 + 变长栈;tags 环每记录一格,与 data 记录一一对应。
③ 读写索引的打包(26-32 行) :"tags 与 data 两个环的有效 读写偏移,打包存进 r、w 两个 64 位字的高 30 位和低 32 位。"有效偏移 = 历史总读/写次数(不取模)。定位下标 = 有效偏移 mod 环长。"为让 mod 2^length 的回绕与 mod 环长的回绕一致,环长必须是 2 的幂。"
63        34 33   32 31              0
┌──────────┬───────┬──────────────────┐
│ tagCount │ flags │    dataCount     │
└──────────┴───────┴──────────────────┘
   30 位      2 位        32 位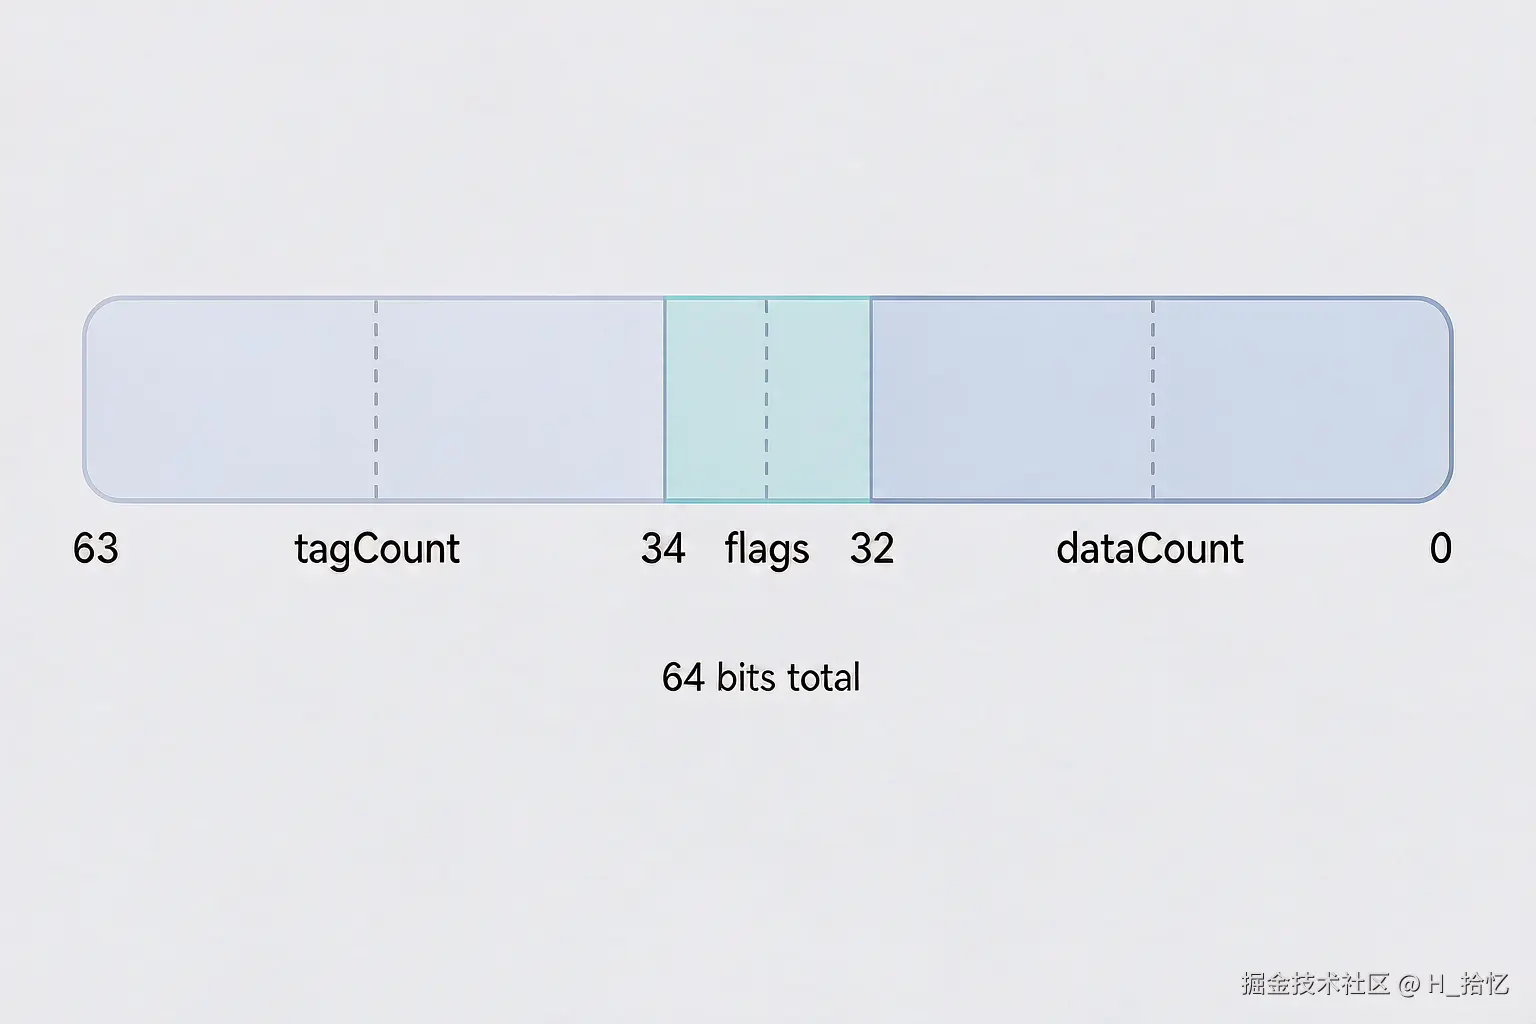
图 4-3 64 位打包索引:高 30 位 tagCount + 中间 2 位 flags + 低 32 位 dataCount,三段互不浪费。
④ 读者进度(34-39 行) :追上写者时,read 可选阻塞;rNext 记录"下次 read 将返回的偏移",恒有 r ≤ rNext ≤ w,只被读者碰,无需原子。
⑤ 溢出记录(41-57 行) :写者超前导致环满 → 后续写入被丢弃并聚合成一条溢出记录 :大小 2+hdrsize+1、时间为首个被丢事件的时间、头全零、"栈"是 1 个字 = 丢弃条数。溢出记录先"挂起"(pending)在 overflow/overflowTime 字段里,写者或读者谁先腾出地方谁负责把它落成真实记录。
⑥ ABA 防护(59-86 行) :overflow 的低 32 位 是被丢条数,高 32 位是代数(generation) :每次低 32 位从 0 变非 0(或反向)代数 +1。读者用"CAS 清零成功 = 我抢到了这条溢出"来裁决,代数保证 CAS 比较的 old 不会"恰好又变回原值"(经典 ABA)。注释 72-86 行给出了读者取走溢出的参考循环------就是后面 takeOverflow 的原文。
三、类型与字段(87-126 行)
go
type profBuf struct {
	// accessed atomically
	r, w         profAtomic  // ← 打包索引:读者已提交位 / 写者已发布位
	overflow     atomic.Uint64  // ← 低32:待上报丢弃数;高32:代数
	overflowTime atomic.Uint64  // ← 首个被丢事件的时间(仅低32为0时可写)
	eof          atomic.Uint32  // ← close() 置 1

	// immutable (excluding slice content)
	hdrsize uintptr
	data    []uint64          // ← 主环:头+时间+栈
	tags    []unsafe.Pointer  // ← 标签环:每记录 1 格,与 data 记录一一对应

	// owned by reader
	rNext       profIndex   // ← 读者的私有进度(见协议④)
	overflowBuf []uint64    // ← 读者合成溢出记录用的工作区
	wait        note        // ← runtime note:读者睡觉/被唤醒的原语
}

type profAtomic uint64   // ← 对原子访问的 profIndex 的包装
type profIndex uint64    // ← 打包索引本身(值类型)

const (
	profReaderSleeping profIndex = 1 << 32 // ← 读者已睡,写者发布后要唤醒
	profWriteExtra     profIndex = 1 << 33 // ← 有"额外信息"(溢出/EOF)待读者注意
)

func (x *profAtomic) load() profIndex { return profIndex(atomic.Load64(...)) }
func (x *profAtomic) store(new profIndex) { atomic.Store64(...) }
func (x *profAtomic) cas(old, new profIndex) bool { return atomic.Cas64(...) }
//  ↑ 三个瘦封装:语义化 + 防止误用普通读写。
注意 flags 的位置:1<<32、1<<33 恰好挤在 dataCount(低 32 位)与 tagCount(34 位起)之间的"夹缝"里------64 位被切成了 32+2+30 三段,一格不浪费。
四、计数运算三件套(128-149 行)
go
func (x profIndex) dataCount() uint32 { return uint32(x) }         // 取低 32 位
func (x profIndex) tagCount() uint32  { return uint32(x >> 34) }    // 取 34 位起

// countSub:x-y,要求差值 < 2^29。
// tagCount 在 2^30 处回绕、dataCount 在 2^32 处回绕,
// "(x-y) 的低 30 位符号扩展"对两种回绕同时成立:
func countSub(x, y uint32) int {
	return int(int32(x-y) << 2 >> 2)
//       └─ 低30位有符号数:×4 再算术右移 2 = 保留低 30 位的符号
}
为什么要"差值 < 2^29"这个前提?因为环长被限制在 2^28 以内(newProfBuf 的 throw),r 与 w 的距离不可能超过环长,所以差值天然有界,30 位够放。
go
// addCountsAndClearFlags:x + (data,tag) 个事件,同时抹掉两个 flag 位。
// 写者提交新记录时用它原子地"推进 w 并清 flags":
func (x profIndex) addCountsAndClearFlags(data, tag int) profIndex {
	return profIndex((uint64(x)>>34+uint64(uint32(tag)<<2>>2))<<34 | uint64(uint32(x)+uint32(data)))
}
读法:右半 uint32(x)+uint32(data) ------ dataCount 原地加(dataCount 本来就在低 32 位,flag 位被加法"顺带"清掉了吗?不------flag 在 32、33 位,加 data 只动低 32 位,flag 仍在!)。再看左半:tagCount 部分 >>34 取出后加 tag 再放回 34 位以上。flag 位既没被右半清(加法不进位到 32 位,因为 dataCount 距回绕极远)也没被左半动(>>34 丢掉了 32、33 位,重打包时它们天然变 0)------"ClearFlags"就是这么免费实现的。
五、溢出的存取协议(151-203 行)
go
func (b *profBuf) hasOverflow() bool {
	return uint32(b.overflow.Load()) > 0     // 低 32 位非 0 = 有挂起的溢出
}

// takeOverflow:读者侧取走挂起的溢出(写者也可能来抢着落盘)
func (b *profBuf) takeOverflow() (count uint32, time uint64) {
	overflow := b.overflow.Load()
	time = b.overflowTime.Load()      // ← 先取时间(可能读到旧值,见下)
	for {
		count = uint32(overflow)
		if count == 0 { time = 0; break }
		// CAS:清空低 32 位计数、代数 +1 ------ 谁 CAS 成功谁取走
		if b.overflow.CompareAndSwap(overflow, ((overflow>>32)+1)<<32) {
			break
		}
		overflow = b.overflow.Load()  // ← CAS 失败 = 有并发,重读再来
		time = b.overflowTime.Load()
	}
	return uint32(overflow), time
}

// incrementOverflow:写者侧记一笔丢弃(与读者竞争)
func (b *profBuf) incrementOverflow(now int64) {
	for {
		overflow := b.overflow.Load()
		if uint32(overflow) == 0 {
			// 当前无挂起溢出 → 我是"从 0 变非 0"的那个:
			b.overflowTime.Store(uint64(now))  // ① 先写时间
			b.overflow.Store((((overflow>>32)+1)<<32) + 1) // ② 再立起新代+计数1
			// 顺序保证:计数非 0 时时间一定已就位(incrementOverflow
			// 单写者,store 顺序即可见顺序)
			break
		}
		if int32(overflow) == -1 { break }
		// ↑ 低32位全是1:粘性饱和值,防极端情况下回绕(字面意思的 paranoid)
		if b.overflow.CompareAndSwap(overflow, overflow+1) { break }
		// ↑ 与读者的"取走"(清零+换代)竞争,输了重试
	}
}
代数(generation)在这里的价值:读者 CAS 的比较值包含高 32 位。假设没有代数,读者看到 count=5 → 被写者改成 6 → 又变回 5,读者的 CAS 会错误成功(ABA),导致同一批丢弃被上报两次。有了代数,"5 → 0 → 5"实际是 (gen,5) → (gen+1,0) → (gen+2,5),比较永不通过。
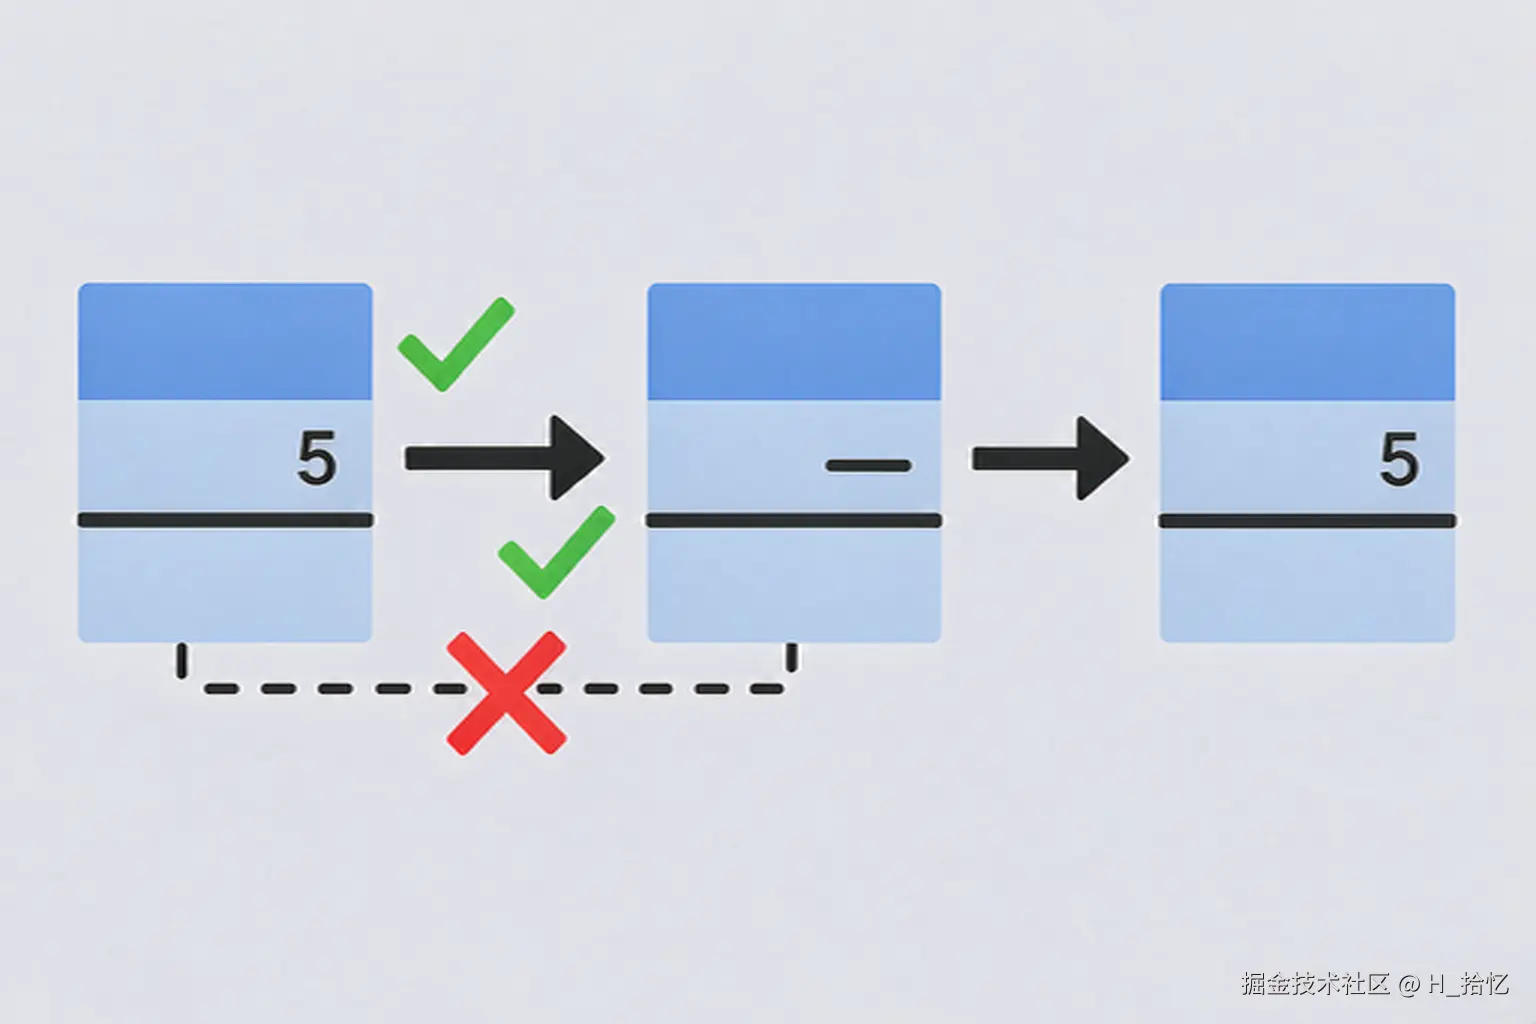
图 4-4 溢出计数的 ABA 防护:低 32 位计数的每一次"0↔非0"翻转都让高 32 位代数 +1,使读者的 CAS 比较值永不"恰好变回原值"。
六、newProfBuf:2 的幂强制(205-233 行)
go
func newProfBuf(hdrsize, bufwords, tags int) *profBuf {
	if min := 2 + hdrsize + 1; bufwords < min {
		bufwords = min   // ← 至少放得下一条最小记录(长度+时间+头+1字栈)
	}
	if bufwords >= 1<<28 || tags >= 1<<28 {
		throw("newProfBuf: buffer too large")
		// ↑ 2^28 上限:给 countSub 的 2^29 差值假设留裕量
	}
	var i int
	for i = 1; i < bufwords; i <<= 1 { }
	bufwords = i          // ← 向上取 2 的幂(协议③的要求)
	for i = 1; i < tags; i <<= 1 { }
	tags = i

	b := new(profBuf)
	b.hdrsize = uintptr(hdrsize)
	b.data = make([]uint64, bufwords)
	b.tags = make([]unsafe.Pointer, tags)
	b.overflowBuf = make([]uint64, 2+b.hdrsize+1) // ← 恰好一条溢出记录的容量
	return b
}
CPU 剖析传入 (1, 1<<17, 1<<14) ------已经都是 2 的幂,循环是空转,但 API 层面不假设调用者守规矩。
七、canWriteRecord / canWriteTwoRecords(235-296 行)
go
// 环里还放不放得下一条"栈长 nstk"的连续记录?
func (b *profBuf) canWriteRecord(nstk int) bool {
	br := b.r.load()
	bw := b.w.load()

	if countSub(br.tagCount(), bw.tagCount())+len(b.tags) < 1 {
		return false       // ← 标签环满(tags 是"已写-已读"的差)
	}

	nd := countSub(br.dataCount(), bw.dataCount()) + len(b.data)
	                     // ↑ data 环的剩余字数
	want := 2 + int(b.hdrsize) + nstk
	i := int(bw.dataCount() % uint32(len(b.data)))
	if i+want > len(b.data) {
		// 记录必须连续。尾部放不下 → 只能跳到环头,尾部作废:
		nd -= len(b.data) - i
	}
	return nd >= want
}canWriteTwoRecords(258-296 行)是它的双记录版:先按 nstk1 走一遍(放不下尾部则归零重来),再按 nstk2 走一遍,两条各自连续 但不必彼此连续 。它只服务一个调用点:write 里"溢出记录 + 新记录"能否一起写。
八、write:写路径全解(298-390 行)
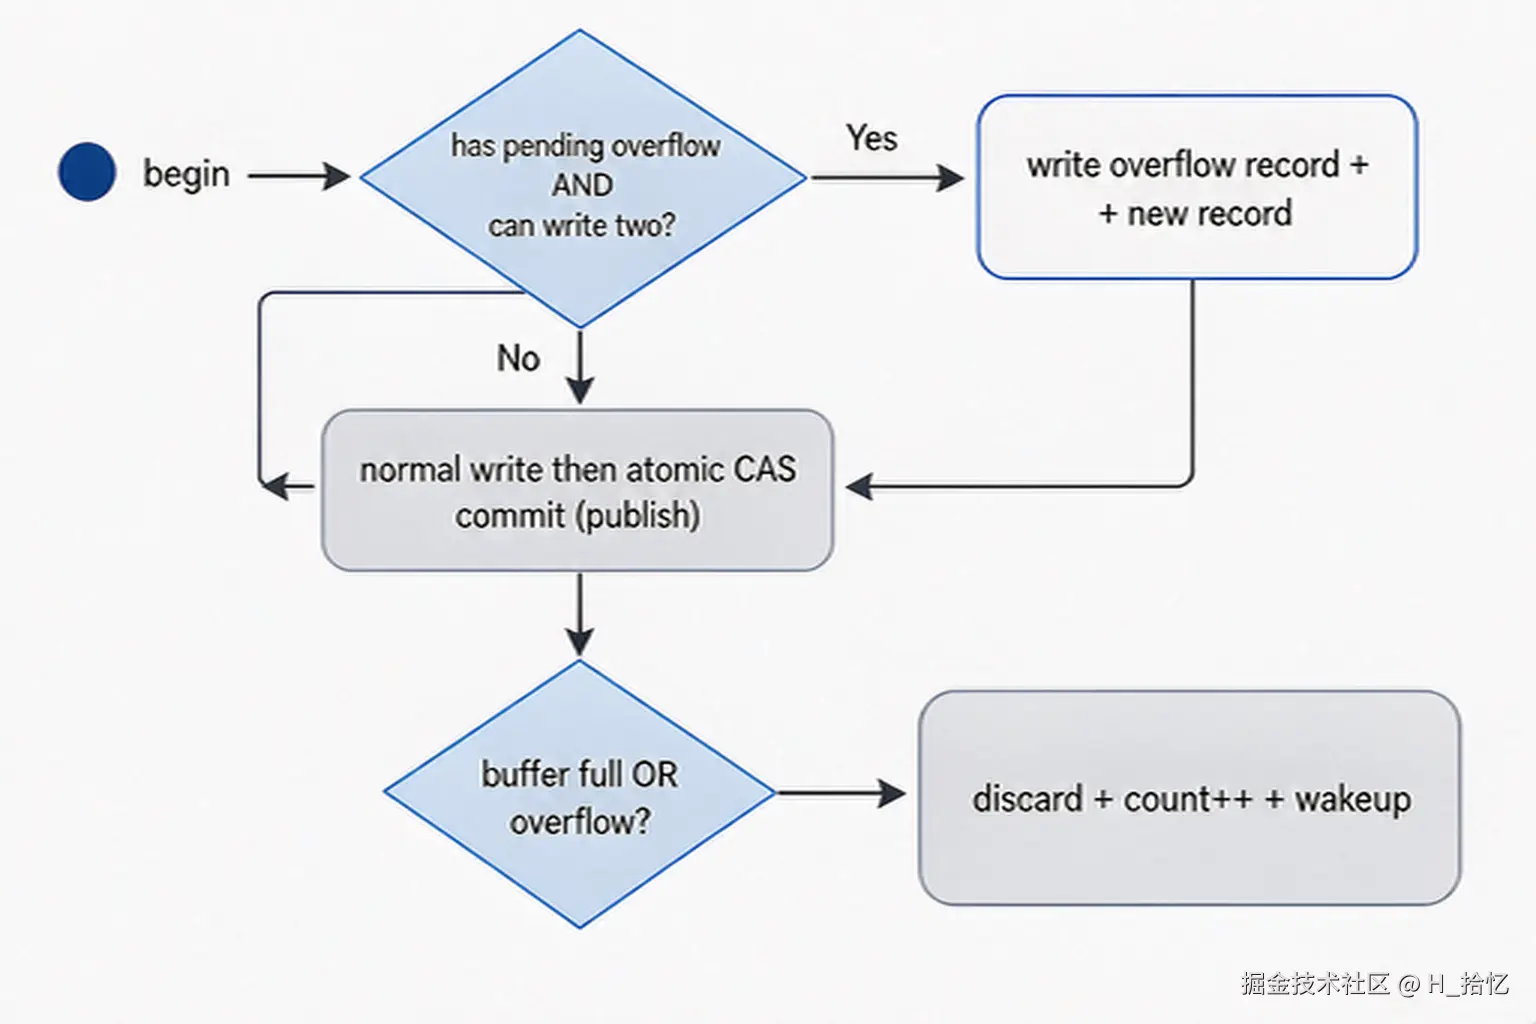
图 4-5 write 三分支全景:① 有挂起溢出且放得下两条→替读者落盘;② 环满或仍有溢出→本条丢弃并计数;③ 正常写入→先写数据、最后一次 CAS 原子提交。
go
func (b *profBuf) write(tagPtr *unsafe.Pointer, now int64, hdr []uint64, stk []uintptr) {
	if b == nil { return }                 // ← nil 安全:关闭后 add 仍可能被叫
	if len(hdr) > int(b.hdrsize) {
		throw("misuse of profBuf.write")   // ← 头超长是编程错误,直接崩
	}

	if hasOverflow := b.hasOverflow(); hasOverflow && b.canWriteTwoRecords(1, len(stk)) {
		// 分支一:有挂起溢出,且放得下"溢出+新记录"两条 → 顺手替读者落盘
		count, time := b.takeOverflow()
		if count > 0 {
			var stk [1]uintptr
			stk[0] = uintptr(count)
			b.write(nil, int64(time), nil, stk[:])
			// ↑ 递归写溢出记录:头传 nil(零填充)、栈 = [丢弃数]。
			//   递归深度恒为 1:这条记录自身不会再触发溢出路径
			//   (hasOverflow 已被 takeOverflow 清掉)。
		}
	} else if hasOverflow || !b.canWriteRecord(len(stk)) {
		// 分支二:有溢出但腾不出地方,或环满 → 本条丢弃,计数 +1
		b.incrementOverflow(now)
		b.wakeupExtra()          // ← 唤醒读者("有 extra 信息了")
		return
	}

	// ===== 分支三:正常写入 =====
	br := b.r.load()
	bw := b.w.load()

	// -- 标签:339-348 行的注释是写屏障安全性的论证,要点:
	//   信号处理器"代替"被中断的 g 执行,gp.labels 在此期间无人能改;
	//   未来任何 GC 扫描 b.tags(堆对象)都能看到这个指针;
	//   且写者保证只在 nil 槽上写 → 无需删除屏障。
	wt := int(bw.tagCount() % uint32(len(b.tags)))
	if tagPtr != nil {
		*(*uintptr)(unsafe.Pointer(&b.tags[wt])) = uintptr(*tagPtr)
		// ↑ 裸指针直写绕过写屏障(信号环境禁屏障);
		//   读回时 readProfile 侧再 unsafe.Pointer 还原
	}

	// -- 主记录:
	wd := int(bw.dataCount() % uint32(len(b.data)))  // 写下标
	nd := countSub(br.dataCount(), bw.dataCount()) + len(b.data)
	skip := 0
	if wd+2+int(b.hdrsize)+len(stk) > len(b.data) {
		b.data[wd] = 0            // ← rewind 标记:0 永不可能是合法长度字
		skip = len(b.data) - wd   // ← 尾部作废的字数
		nd -= skip
		wd = 0                    // ← 跳回环头
	}
	data := b.data[wd:]
	data[0] = uint64(2 + b.hdrsize + uintptr(len(stk)))  // 长度字
	data[1] = uint64(now)                                // 时间戳
	i := copy(data[2:2+b.hdrsize], hdr)                  // 头(可能不足)
	clear(data[2+i : 2+b.hdrsize])                       // 头零填充
	for i, pc := range stk {
		data[2+b.hdrsize+uintptr(i)] = uint64(pc)        // 栈逐字写入
	}

	for {
		// -- 原子提交:推进 w(data += skip+2+h+n,tag += 1),同时清 flags
		old := b.w.load()
		new := old.addCountsAndClearFlags(skip+2+len(stk)+int(b.hdrsize), 1)
		if !b.w.cas(old, new) { continue }
		// ↑ 与读者改 flag 位竞争:读者可能置 profReaderSleeping。
		//   CAS 失败重试,保证"读者刚标了睡觉"不会被这次发布漏掉唤醒
		if old&profReaderSleeping != 0 {
			notewakeup(&b.wait)   // ← 只有读者在睡才唤醒(否则 note 白敲)
		}
		break
	}
}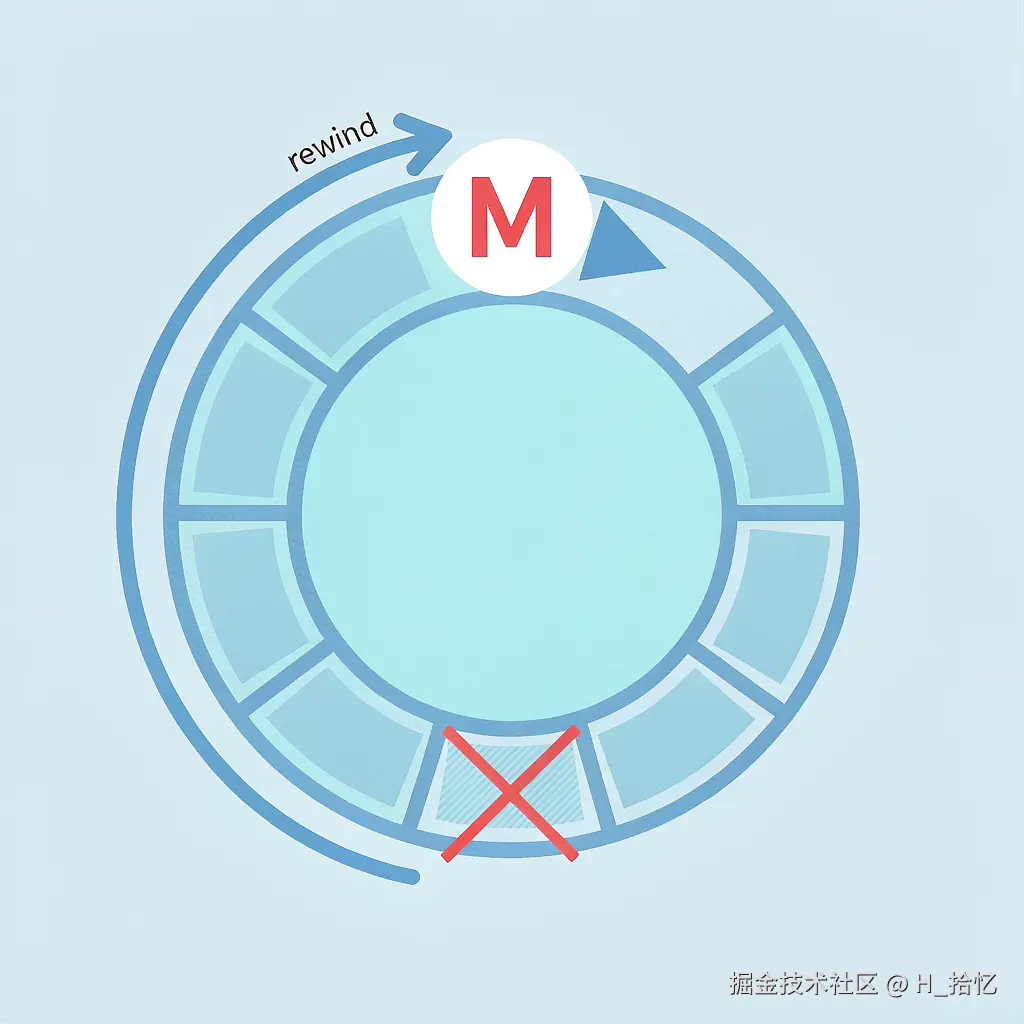
图 4-6 rewind 回绕标记:当一条记录尾部放不下时,在 datawd 写 0(0 不可能是合法长度字),尾部作废并跳回环头。
先写数据、后原子提交 是整个结构的灵魂:数据落盘阶段读者根本看不见(它只认 w 的计数),提交一字 CAS 后整条记录瞬间"存在"。这给了我们一个重要推论:read 拿到的任意区间必然由若干条完整记录组成,绝无半条------不需要任何额外的"部分写"处理。
九、close 与 wakeupExtra(392-417 行)
go
func (b *profBuf) close() {
	if b.eof.Load() > 0 { throw("runtime: profBuf already closed") }
	b.eof.Store(1)
	b.wakeupExtra()      // ← EOF 是一种"extra 信息",同样要唤醒读者
}

// wakeupExtra:置好 overflow/eof 后必调。
// 用 CAS 把 profWriteExtra 标志打进 w:
//  · 不直接 notewakeup ------ 因为标志和唤醒必须原子成对,
//    否则"置标志后、唤醒前"读者恰好检查过 w 就会睡死(丢唤醒)。
func (b *profBuf) wakeupExtra() {
	for {
		old := b.w.load()
		new := old | profWriteExtra
		if !b.w.cas(old, new) { continue }
		if old&profReaderSleeping != 0 { notewakeup(&b.wait) }
		break
	}
}
十、read:读路径全解(429-557 行)
go
type profBufReadMode int
const (
	profBufBlocking profBufReadMode = iota  // 无数据就睡
	profBufNonBlocking                       // 无数据就返回(darwin 专用)
)
var overflowTag [1]unsafe.Pointer // 溢出记录的标签:恒 nil

func (b *profBuf) read(mode profBufReadMode) (data []uint64, tags []unsafe.Pointer, eof bool) {
	if b == nil { return nil, nil, true }

	br := b.rNext   // ← 读者私有进度:上次答应给、还没提交的起点

	// ===== 第 1 步:提交上一轮的读(441-452 行)=====
	// 把上一轮返回的数据区间还给写者:
	rPrev := b.r.load()
	if rPrev != br {
		ntag := countSub(br.tagCount(), rPrev.tagCount())
		ti := int(rPrev.tagCount() % uint32(len(b.tags)))
		for i := 0; i < ntag; i++ {
			b.tags[ti] = nil      // ← 先清标签:
			if ti++; ti == len(b.tags) { ti = 0 }
			                     //   1) 别替 GC 钉住 label 指针
			                     //   2) 成全 write 的"只在 nil 上写"假设
		}
		b.r.store(br)            // ← 一次原子 store 交还全部区间
	}
"两次调用"协议 是理解 read 的钥匙:read 返回的切片指向环内部,在下次 read 前有效 。读者用完再调 read,才把空间还回去。这也解释了 runtime_pprof_readProfile 的注释"调用者必须先保存 data 和 tags 再调下一次"(第 03 篇第八节)。
go
	// ===== 第 2 步:尽力取数(454-500 行)=====
Read:
	bw := b.w.load()
	numData := countSub(bw.dataCount(), br.dataCount())
	if numData == 0 {
		if b.hasOverflow() {
			// 环空但有挂起溢出 → 读者自己合成溢出记录返回
			count, time := b.takeOverflow()
			if count == 0 { goto Read }      // 与写者抢输了,重试
			dst := b.overflowBuf
			dst[0] = uint64(2 + b.hdrsize + 1)  // 长度字
			dst[1] = time                        // 首丢时间
			clear(dst[2 : 2+b.hdrsize])          // 头全零
			dst[2+b.hdrsize] = uint64(count)     // "栈" = 丢弃数
			return dst[:2+b.hdrsize+1], overflowTag[:1], false
		}
		if b.eof.Load() > 0 { return nil, nil, true }   // 真正的 EOF
		if bw&profWriteExtra != 0 {
			b.w.cas(bw, bw&^profWriteExtra)  // 写者说有 extra:清标志重查
			goto Read
		}
		if mode == profBufNonBlocking { return nil, nil, false }
			// ↑ darwin 分支:notetsleepg 在信号处理器不安全(#61768)
		if !b.w.cas(bw, bw|profReaderSleeping) { goto Read }
			// ↑ 挂"我要睡"牌子;失败说明 w 又变了,重看
		notetsleepg(&b.wait, -1)   // ← 无限期睡;被 notewakeup 敲醒
		noteclear(&b.wait)
		goto Read                  // 醒来重查
	}

	// ===== 第 3 步:切出可返回的区间(501-524 行)=====
	data = b.data[br.dataCount()%uint32(len(b.data)):]
	if len(data) > numData {
		data = data[:numData]       // 限制在已提交范围内
	} else {
		numData -= len(data)        // 环尾截断 → 剩余量记下(回绕用)
	}
	skip := 0
	if data[0] == 0 {
		// 撞到 write 留下的 rewind 标记:整段尾部作废,跳回环头
		skip = len(data)
		data = b.data
		if len(data) > numData { data = data[:numData] }
	}

	ntag := countSub(bw.tagCount(), br.tagCount())
	if ntag == 0 {
		throw("runtime: malformed profBuf buffer - tag and data out of sync")
	}
	tags = b.tags[br.tagCount()%uint32(len(b.tags)):]
	if len(tags) > ntag { tags = tags[:ntag] }

	// ===== 第 4 步:按记录框架对齐(526-541 行)=====
	di := 0; ti := 0
	for di < len(data) && data[di] != 0 && ti < len(tags) {
		if uintptr(di)+uintptr(data[di]) > uintptr(len(data)) {
			throw("runtime: malformed profBuf buffer - invalid size")
		}
		di += int(data[di])   // ← 跳过一整条记录
		ti++                  // ← 对应消费一个标签
	}
	// 循环条件三选一停下:到尾 / 到 rewind / 标签先用完
	// (标签先用完 = 环尾装不下整条记录被截断的情况,余量下次返回)

	b.rNext = br.addCountsAndClearFlags(skip+di, ti)
	// ← 记住"已切出但未提交"的进度,等下一次 read 的第 1 步提交

	if raceenabled { raceacquire(unsafe.Pointer(&labelSync)) }
	// ↑ 仅竞态检测器:与 setProfLabel 的 releasemerge 配对,
	//   给 race detector 一个"名义同步点"(真实同步全靠原子索引)

	return data[:di], tags[:ti], false
}
一张图总结 read 的四种结局:
| 环状态 | read 的行为 |
|---|---|
| 有整条记录 | 切出 1..n 条返回(第 3、4 步) |
| 空但有挂起溢出 | 合成溢出记录返回(overflowBuf) |
| 空、无溢出、EOF | eof=true(读干,允许下一轮剖析) |
| 空、无溢出、无 EOF | 挂 sleeping 睡觉,等 notewakeup |
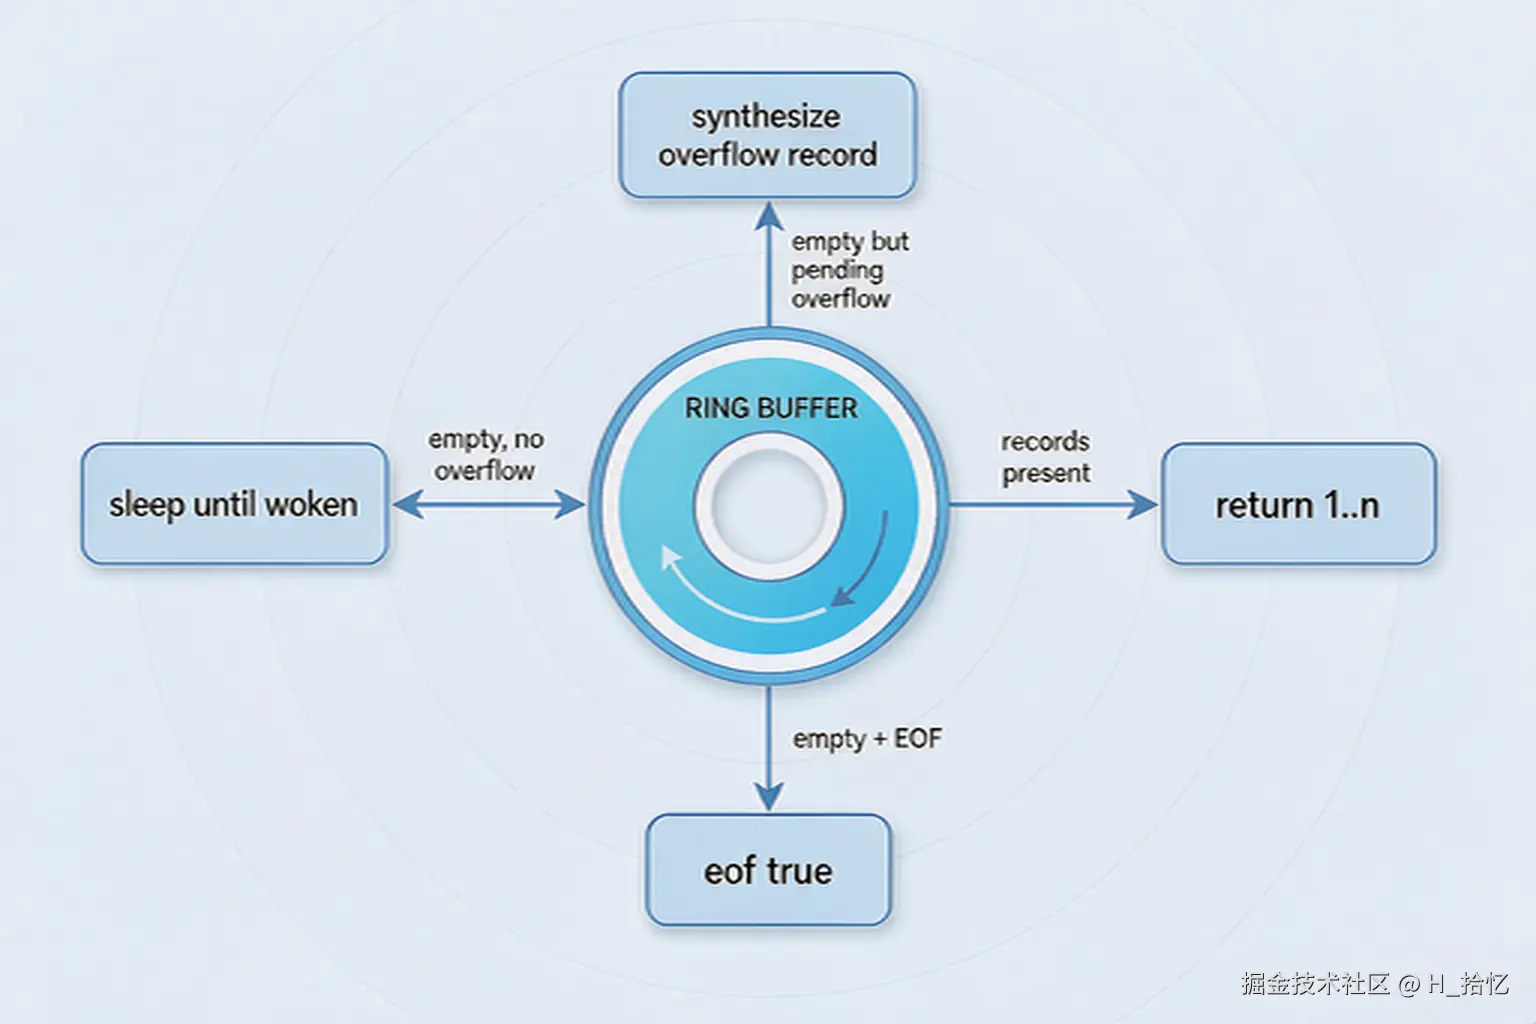
图 4-7 read 的四种结局:有整条记录则切出返回、空但有挂起溢出则合成溢出记录、空且 EOF 则结束、空且无溢出则挂 sleeping 睡觉。