流萤简历是我做的一个 AI 简历与求职资料工作台。这是技术专栏第 1 篇,先聊它最有意思的一件事:让你常用的 AI,通过 CLI 真正操作简历和文档。
产品特写:聊完之后,结果已经在工作台里
你可以把一份岗位要求和自己的经历交给 AI,让它整理适合这个岗位的表达、复制一份岗位版简历,再把准备资料写成可编辑的文档。回到流萤,看到的是可以继续修改的简历和资料页面,后续还可以调整模板、排版和导出文件。文字建议在这里进入了实际的工作对象。
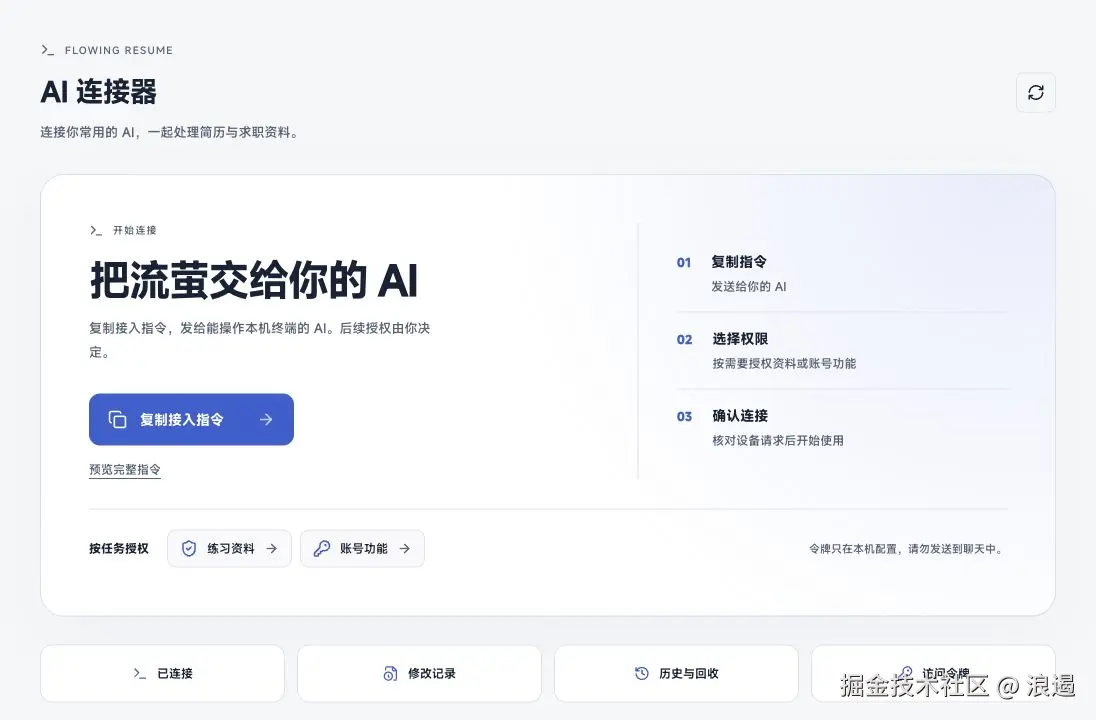
图里的接入入口做了三件事:告诉 AI 去哪里找能力,由用户选择权限,再把连接交给用户管理。底部的"练习资料"和"账号功能"对应两套不同的授权方式。这是整条自动化链路需要先讲明白的地方。
我很喜欢这种产品形态。用户已经在一个 AI 里讨论过自己的经历,再要求他把答案复制回来、逐项找输入框、重新排版,最后一公里还是手工。CLI,也就是可从终端执行的命令行接口,把这些已经存在的业务操作变成 AI 能调用的工具,让讨论直接落到产品里的资源上。
这里的"全部 CLI 化"有一个准确范围:当前对外开放的简历、练习、面试、投递、页面、分享等个人 OpenAPI 操作,可以通过通用 CLI 调用;范围受限的资料操作另外走设备连接和修改集。管理员接口、设备审批和未开放的网页行为不因为装了 CLI 就变成机器权限。把这条边界说清楚,读者才知道自动化究竟做到了哪里。
自动化得先有一个可靠的业务接口
一种直接办法是让 AI 模拟鼠标,点开简历,滚到工作经历,找到富文本输入框,再粘贴。对于没有开放协议的网站,这可能有用。但当产品由自己维护时,页面布局不应该成为 AI 操作数据的唯一入口。
按钮位置、工具提示和抽屉层级都会迭代。AI 如果依赖这些细节,用户看到的改版就可能变成自动化任务的故障。更棘手的是,模拟输入很难明确表达"我基于哪一版简历生成了这次修改",也不容易把十个文档操作放在同一事务里处理。
流萤把能力留在服务端业务层,再为机器提供协议入口。OpenAPI 是一份机器可读的 HTTP 接口说明,包含路径、方法与请求格式;CLI 负责站点选择、凭证、网络与输出。外部 AI 负责理解用户需求并组织这些调用。
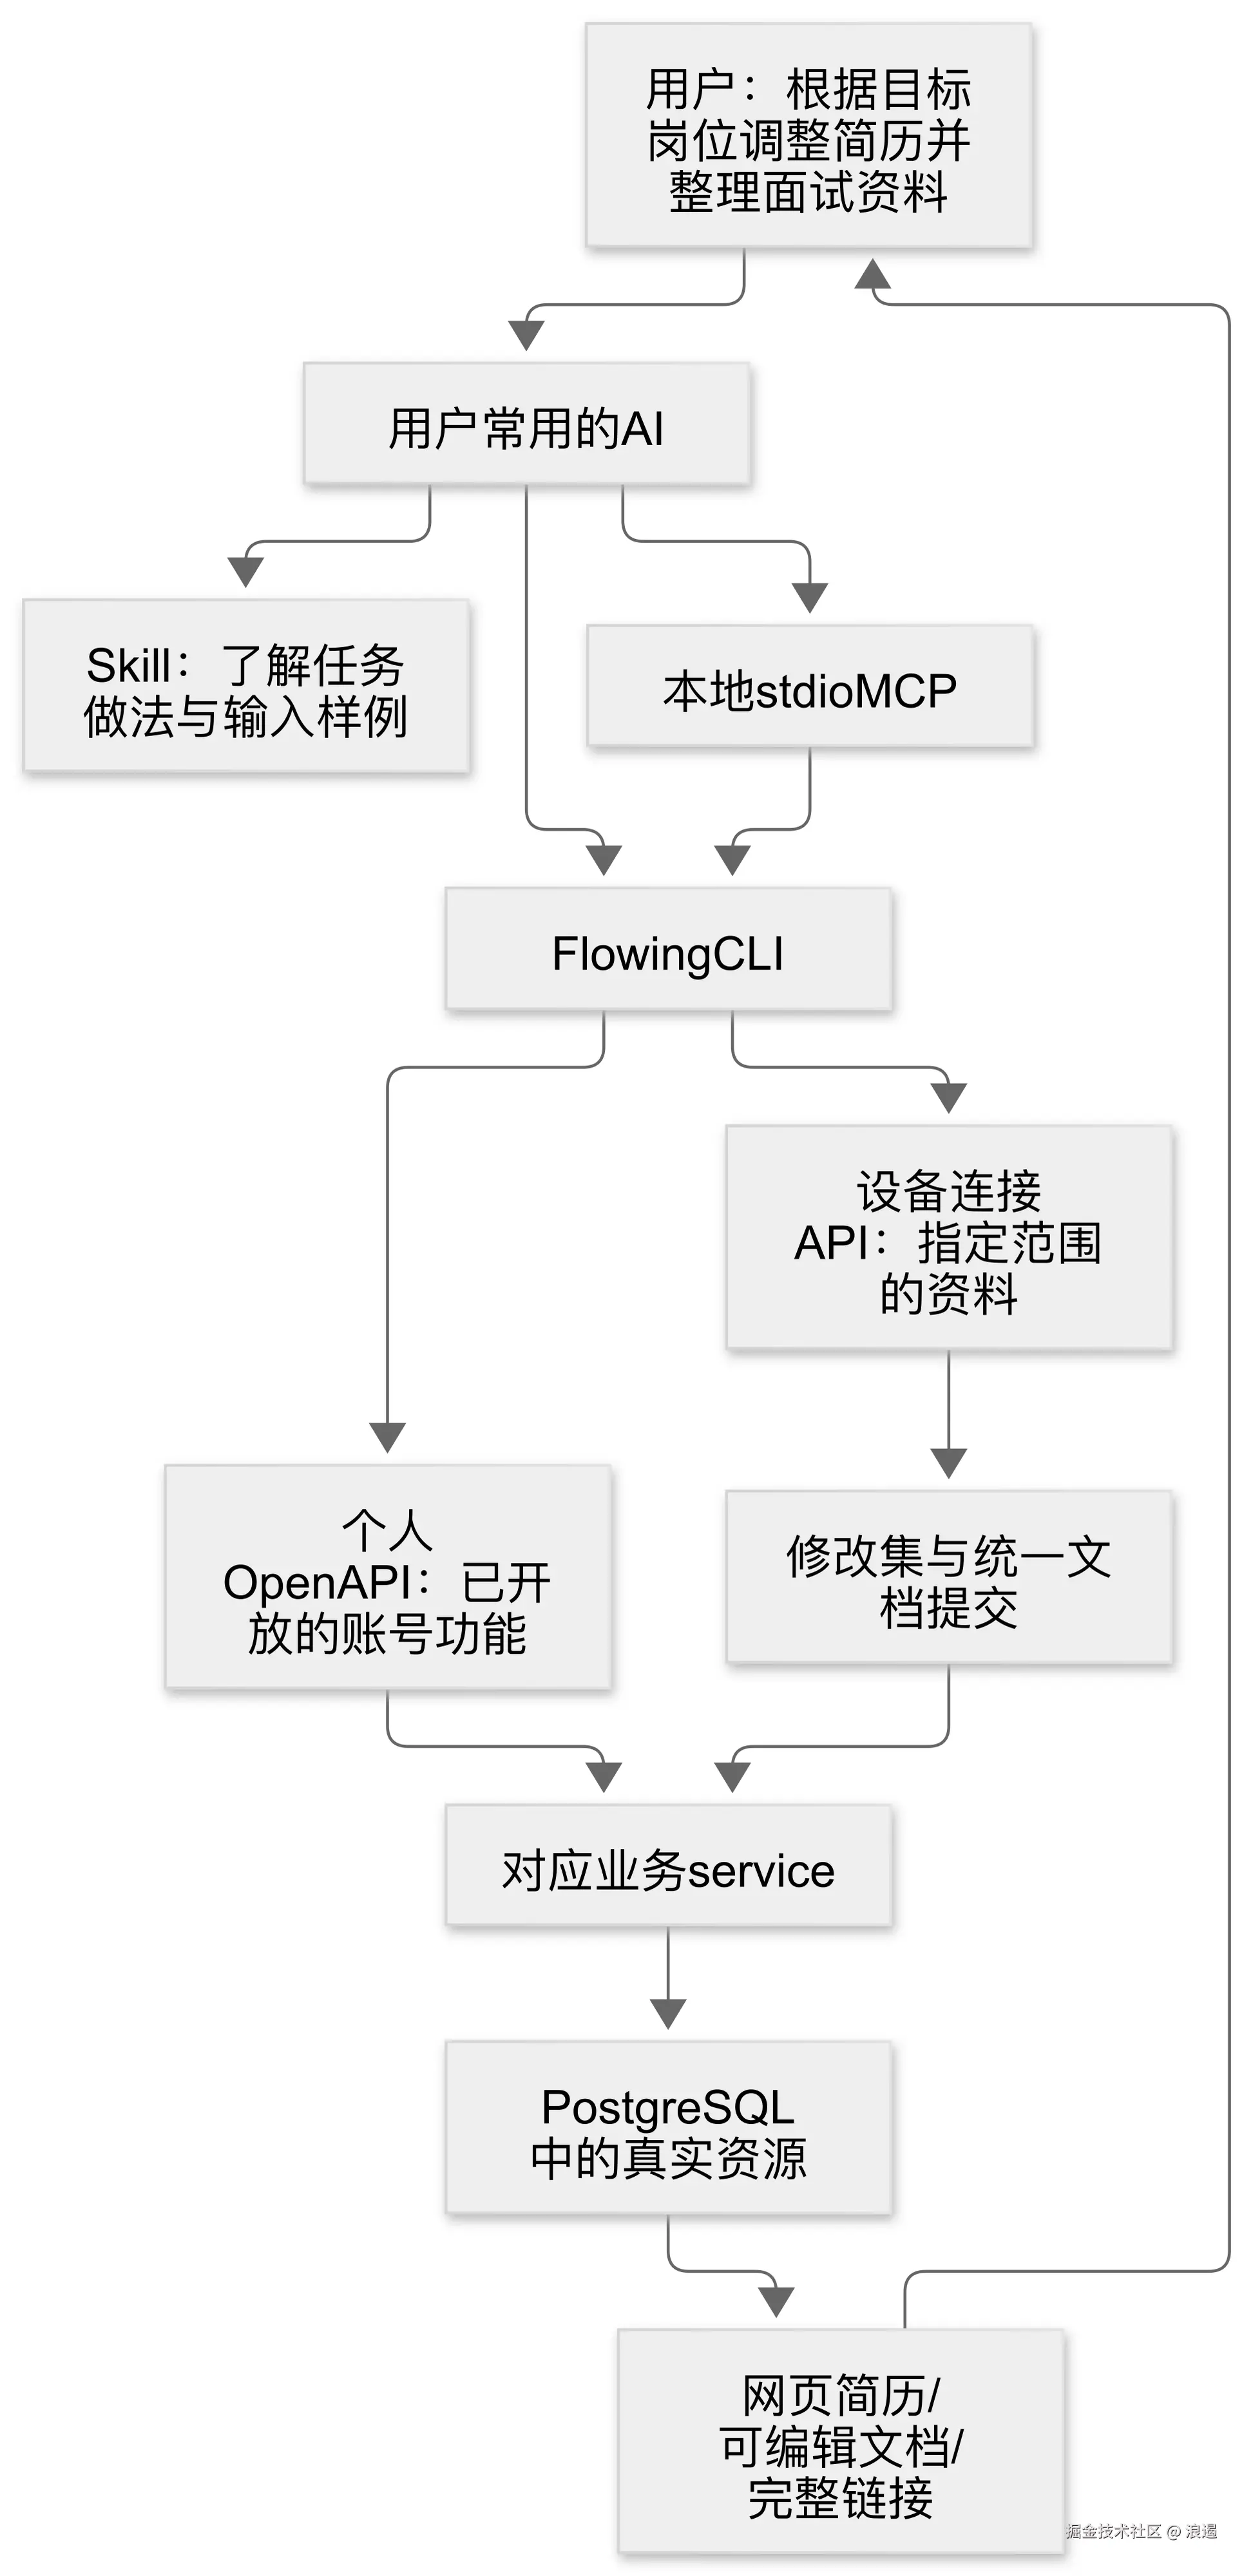
图里有一个容易混淆的箭头:CLI 不负责替用户思考内容,它也不会自行读取其他聊天。模型在哪个宿主里运行、拿到哪些对话材料,由那个 AI 的运行环境决定。Flowing CLI 接受明确的业务输入,把操作送到流萤服务端。
如果 AI 直接改已有事实,不需要每次都调用流萤的平台模型;如果任务明确要求"一键生成简历"或其他平台 AI 功能,才会进入相应的计次流程。这让"用自己的 AI 操作产品"和"消费产品内的 AI 服务"有了清楚的分工。
能发现能力,AI 才能正确使用能力
给模型一句"有一个 CLI,自己看着办",它很容易猜出不存在的命令。比如 flowing resume optimize 听起来像那么回事,仓库里却没有这个入口。命令是否合理,与命令是否真实存在,是两回事。
因此,接入内容也要跟着客户端交付。流萤随 CLI 分发统一的 flowing-platform Skill。Skill 可以理解为提供给 Agent 的操作指南:它先说明产品能力、授权方式和工作流,再把详细协议、样例和脚本放在参考资料里,按任务读取。
三种接入方式复用同一份资料。支持原生 Skill 的宿主读取文件目录;只有终端能力的 AI 运行命令读取;支持 MCP 的宿主通过 flowing_skill 获取指南。MCP 在这里是模型与工具交互的协议,本地 stdio 模式通过标准输入输出传递请求。
sh
flowing --version
flowing update check
flowing skill platform
flowing skill read references/resumes.md --json
flowing api schema
这几条命令的责任不同。版本检查确认本地客户端,Skill 解释怎么完成任务,实时 OpenAPI 确认当前站点开放了什么。服务端能力版本不能替代本地版本,随包文档也不能替代当前服务的契约。
安装 Skill 只解决"AI 是否有机会看见说明"。宿主可能尚未刷新,也可能禁用了自动加载;远端 Agent 和本机终端还可能根本不在一个运行环境里。判断接入是否成功,应该看实际会话有没有读到指南并完成授权后的只读请求,而不是只看文件是否已复制。
这也是为什么首页的"复制接入指令"有产品价值:用户不需要先弄懂安装目录和协议,入口把开始任务所需的材料交给 AI。底层仍保留可观察的步骤,出了问题才能定位究竟卡在安装、发现、认证还是业务调用。
两种授权,分别解决两类任务
个人 OpenAPI 令牌代表账号本人,适合处理账号下已开放的简历、求职和分享功能。设备连接则让用户挑选资料根节点、是否包含后代、读写方式与期限,适合把一个专题交给 AI 整理。
| 项目 | 个人 OpenAPI | 资料设备连接 |
|---|---|---|
| 常见入口 | flowing api、flowing scripts run resumes |
flowing documents、flowing changes |
| 凭证来源 | 用户在网页创建个人令牌并在本机导入 | 终端发起设备请求,用户在网页授权 |
| 范围 | 已开放接口及账号当前业务权限 | 选定资料范围与当前成员权限的交集 |
| 写入约束 | 所属业务的版本、额度及权限检查 | revision、固定修改集及必要的审核 |
| 典型用途 | 创建岗位版简历、修改经历、管理分享 | 整理专题、追加解答、批量组织页面 |
这张表里的"交集"很关键。一个用户原来拥有资料编辑权限,后来被所有者撤销,CLI 不能凭旧连接继续写。个人令牌同样要执行业务的实时资源检查;拿到一段字符串不等于永久保留创建时的全部权利。
用户需要在自己的运行环境里导入个人令牌。文章无需展示任何真实令牌,也不应该让读者把它发进公开评论区。可以先用下面的只读命令判断接入,再开始写入:
sh
flowing api token status
flowing api GET me
flowing api GET resumes
flowing capabilities
前两类 api 命令与最后一条 capabilities 可能使用不同凭证。个人令牌配置好,不代表资料设备连接也已完成;设备授权成功,也不代表已经拥有个人 OpenAPI 令牌。把它们统称"登录成功",会让排障变得很痛苦。
一个岗位版简历任务,怎样真正落地
设想用户说:"根据这份岗位要求,帮我调整项目经历,但保留原简历,另建一份岗位版。"下面沿着当前实现,把这个任务拆开。
AI 先读取完整来源简历和版本,确认用户指定的对象。标题只适合展示,真正定位资源要使用 ID。随后调用随包的 resumes 预制脚本复制,脚本会读取完整对象,生成新 ID 和时间,并以 revision: 0 创建副本。源简历不会因为复制而变成空白骨架。
输入文件的形式很克制:
json
{
  "action": "copy",
  "sourceId": "替换为本次读取的真实简历ID",
  "title": "AI 应用工程师|岗位版"
}
sh
flowing scripts run resumes --file resume-copy.json这里选脚本,是因为复制需要保留整份 ResumeData,包含模板、样式、章节与自定义数据。让模型从记忆里重建几十个字段,既增加出错机会,也容易丢失用户之前调整的内容。脚本把确定的机械步骤固定下来,AI 专注于语义修改。
接下来读取副本,保留原始对象为 baseResume,在副本上修改用户授权的字段,再将基础版本与完整候选一起交给更新脚本。baseResume 是生成这次修改时看到的内容,不能在冲突后偷偷替换成最新快照,否则系统就无法判断哪些变化来自 AI,哪些来自人。
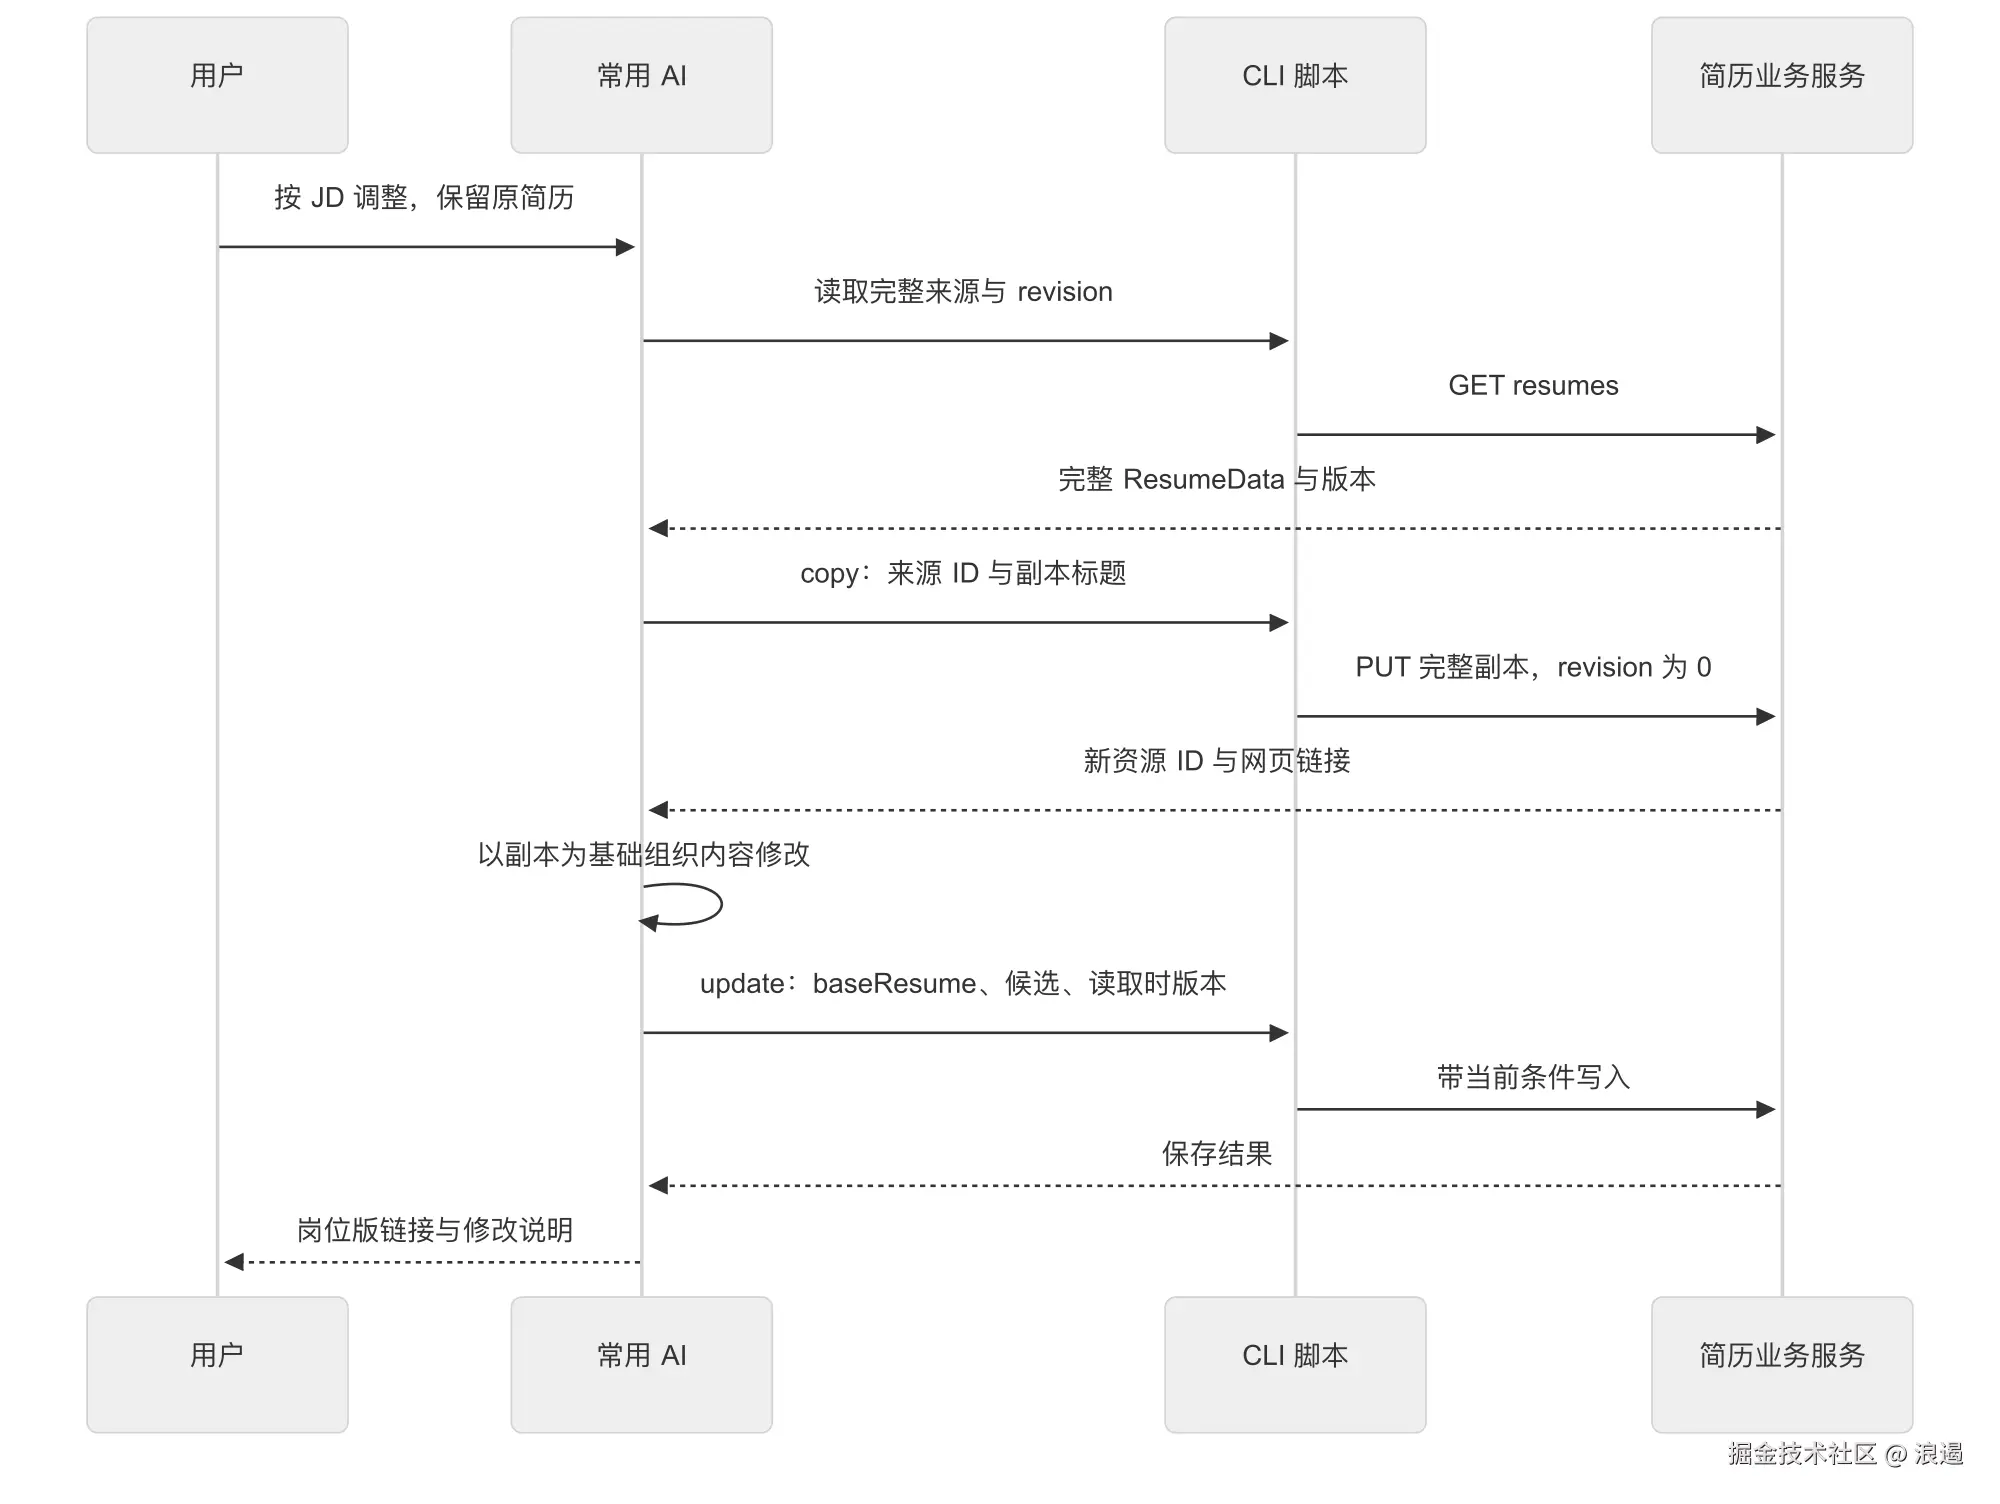
这条链路的最后一步也属于功能:把完整网页链接交回用户。只返回一个 UUID,技术上资源可能已经创建,用户却还得自己找。CLI 的结果链接装配会为简历补工作台地址,为资料补页面地址;有审核要求时返回审核地址。自动化的交付对象应当能直接打开。
人和 AI 同时修改,不能靠"再保存一次"
复制任务相对容易,更新任务才会碰到并发。假设 AI 读取副本时版本为 12,准备修改项目描述;用户在网页把手机号改好,保存到版本 13。AI 如果直接带版本 12 写入,服务端会拒绝旧版本。
错误做法是重新查一个版本号,然后用 13 包装原来的完整候选。这样做虽然通过版本条件,却把用户新改的手机号覆盖回去了。版本号必须对应生成候选时读取的内容,不能当作随时刷新的通行证。
更新脚本保留三份数据:基础 baseResume、AI 候选和当前远端。手机号只在远端变化,保留远端;项目描述只在候选变化,保留候选;不同 ID 的经历条目分别合并。形成新候选后,再以当前远端版本写入。
双方同时改同一个标量时,这条 CLI 路径选择本次 AI 候选。网页保存路径则优先自己的未保存草稿。它们表达的是各自提交时的产品选择,不能据此承诺"所有并发修改都能无损合并"。这套实现是带规则的三方合并,字符级共同编辑和任意网络顺序下的收敛需要更多机制。
删除也要考虑版本。预制脚本发现简历从读取后又发生修改时,会取消旧删除并返回 CONCURRENT_EDIT_PRESERVED。这个结果比"为了自动化成功而删除最新内容"更符合用户意图:用户要求删除的是自己刚才看到的对象状态,新变化值得重新确认。
通用 API 和预制脚本,各自保留价值
既然已经有 flowing api <METHOD> <path>,为什么还要脚本?因为接口提供单步能力,用户给出的通常是多步任务。
例如个人 API 客户端只允许请求落在当前站点的开放前缀里。下面摘自 personalApiUrl(),省略导入;这是把工具能力限定在明确协议边界的一步:
js
export function personalApiUrl(server, path) {
  const url = new URL(String(path).replace(/^\//, ""), `${server}/api/open/v1/`);
  if (url.origin !== server ||
      !url.pathname.startsWith("/api/open/v1/") ||
      url.username || url.password || url.hash) {
    throw new CliError("API 路径必须位于 /api/open/v1/ 下。");
  }
  return url;
}
它防止把个人令牌发往另一个 origin 或非开放接口路径。这个检查属于客户端的出站边界,服务端仍独立认证和授权。
通用 api 脚本每次读取当前站点的 OpenAPI,通过 operationId 找到真实方法和路径,不额外维护一份容易漂移的接口表。resumes 固定完整对象复制、版本读取和合并流程;ai-documents 固定范围检查、revision 与修改集准备流程。它们复用同一 HTTP 客户端与凭证存储,避免每个业务脚本重新实现认证。
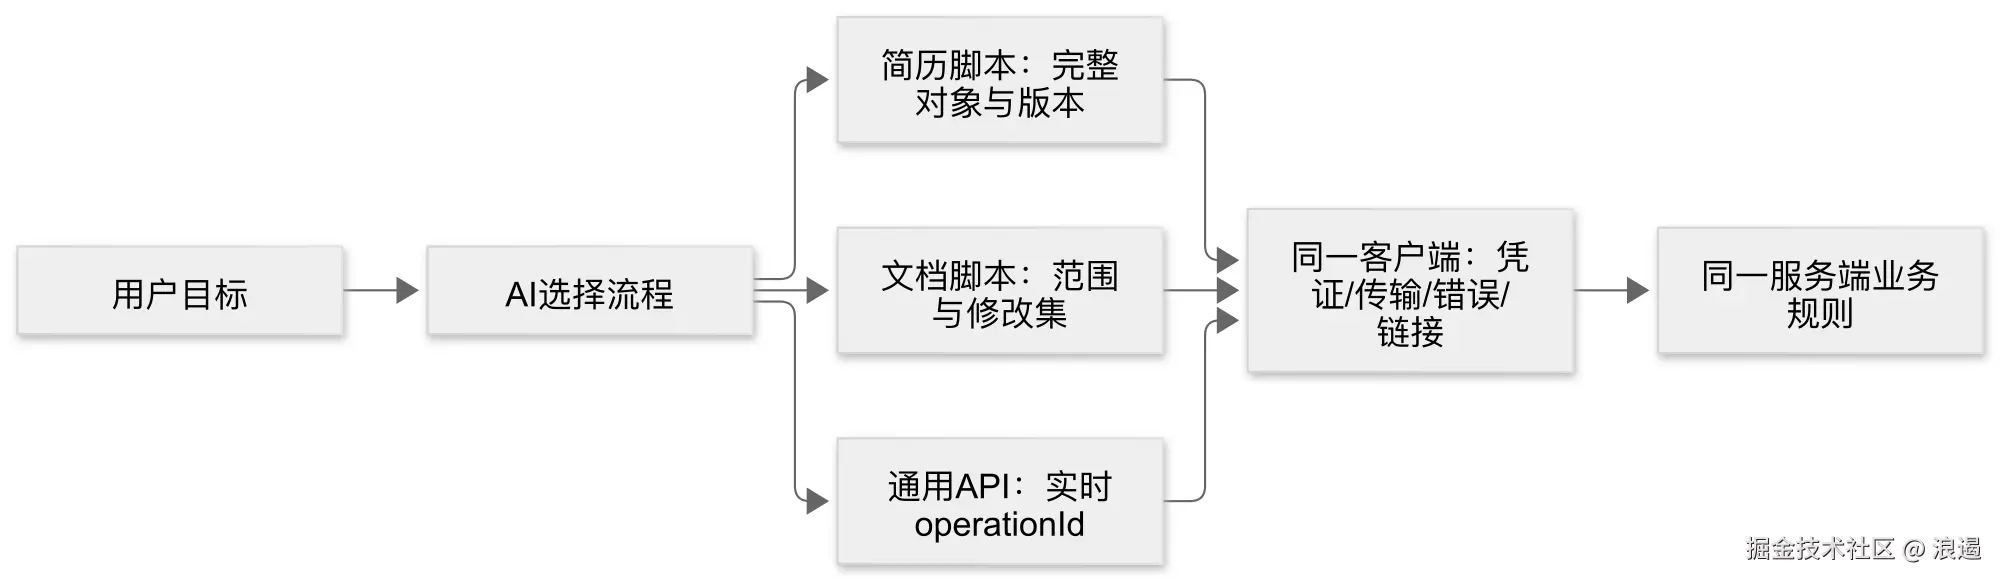
自动化还需要机器能判断的输出。CLI 默认业务结果是 JSON,提示与错误走标准错误输出;显式 --output json 时提供成功或失败 envelope,也就是统一的结果外壳。模型可以据错误码区分版本冲突、范围不足和审核等待,不需要从一句"出了点问题"里猜原因。
但同一个错误码也不能机械重试。VERSION_CONFLICT 要重新读取并形成新候选;SCOPE_DENIED 要停止越权;REVIEW_REQUIRED 要把原候选链接交给用户。换一个幂等键、换一个连接或反复点击,不是这些错误的恢复方法。
怎样判断这项自动化真的做成了
我会用一个可以回看的产品任务检验它:读一份占位简历,创建岗位版副本,只改指定项目,再打开网页检查内容、模板和来源是否正确。然后在人为插入远端修改的情况下重跑更新,观察独立字段是否保留、冲突是否遵循已说明规则。
资料任务另外测试:只授权一个专题,尝试读取另一个专题应被拒绝;审核模式先准备候选,在批准前提交应失败;用户改了正文以后,旧候选应因版本变化而停止。这些结果能证明业务边界,单纯"命令退出码是 0"不够。
还应检查交付形式。返回链接是否完整,失败是否在正确的输出通道,PDF 是否按 --out 写文件,敏感凭证是否没有混进结果。真实模型可以换,稳定的协议和恢复流程会继续发挥作用。
你可以从流萤简历的 AI 连接器开始,先让自己的 AI 查询资料,再做一份可回看的岗位版简历。这个功能最打动我的地方,是对话结束后,成果能够留在一个继续可编辑的工作台里。下一篇接着看,支撑网页、CLI 和平台 AI 的代码,怎样按业务组织到一起。